深入解析 OpenCodeReview:阿里开源的工业级 AI 代码审查工具
💬 评论alibaba/open-code-review 是阿里内部 AI 代码审查助手开源版本,Go 单栈 10 万行,Hybrid 架构(确定性规则+LLM Agent),精度/F1 远超通用 Agent 且只消耗 1/9 token,内建断点续传 Manifest 与 LLM Protocol 抽象。
深入解析 OpenCodeReview:阿里开源的工业级 AI 代码审查工具#
阿里内部用两年的 AI 代码审查助手 → 2026 开源。Go 单栈 10 万行、17 个 internal 子包、4 套 LLM wire protocol、28 天前的最后一次提交(HIT-trending 周榜常客)。本文拆它如何在「Hybrid 架构」下用 1/9 的 token 做到比 Claude Code/Codex 更高的精度。
一、它是谁、解决什么问题#
OpenCodeReview(仓库 alibaba/open-code-review,CLI 命令 ocr)是阿里集团内部官方 AI 代码审查助手的开源版本。README 自述:
It originated as Alibaba Group’s internal official AI code review assistant — over the past two years, it has served tens of thousands of developers and identified millions of code defects. After thorough validation at massive scale, we incubated it into an open source project for the community.
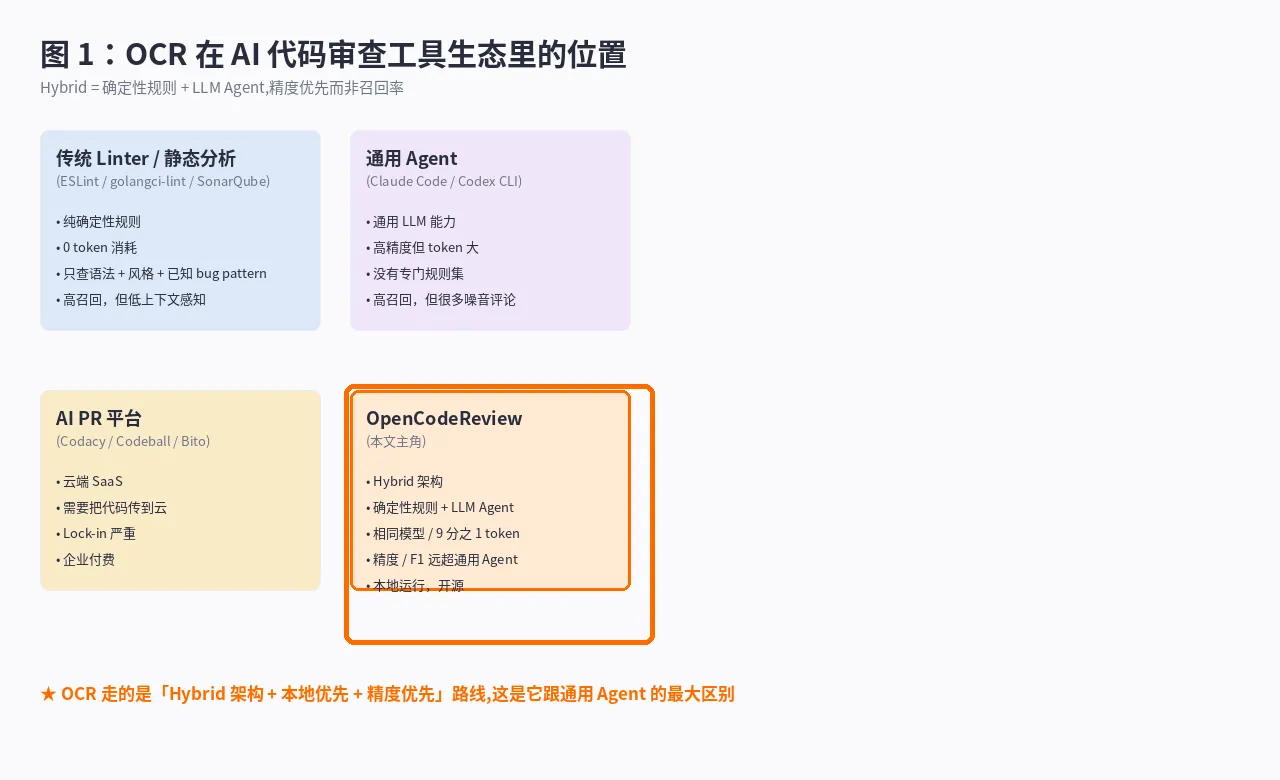
如果你只用过 SonarQube / ESLint / Codacy 这一类工具,会以为 AI 代码审查就是「在静态分析上面加点 LLM 增强」。OpenCodeReview 的设计哲学完全不同:
它在四象限里占据了第四象限:精度优先而非召回率、Hybrid(确定性规则 + LLM Agent)、本地运行、开源。README 的 benchmark 自述:
Compared to general-purpose agents (Claude Code), Open Code Review achieves significantly higher Precision and F1 with the same underlying model, while consuming only ~1/9 of the tokens and completing reviews faster. Note that its Recall is lower than general-purpose agents — a deliberate trade-off favoring precision over noise.
一句话总结:OCR 不追求”抓到所有问题”,而是追求”抓到的都是真问题”。这条产品决策贯穿整个项目的架构。
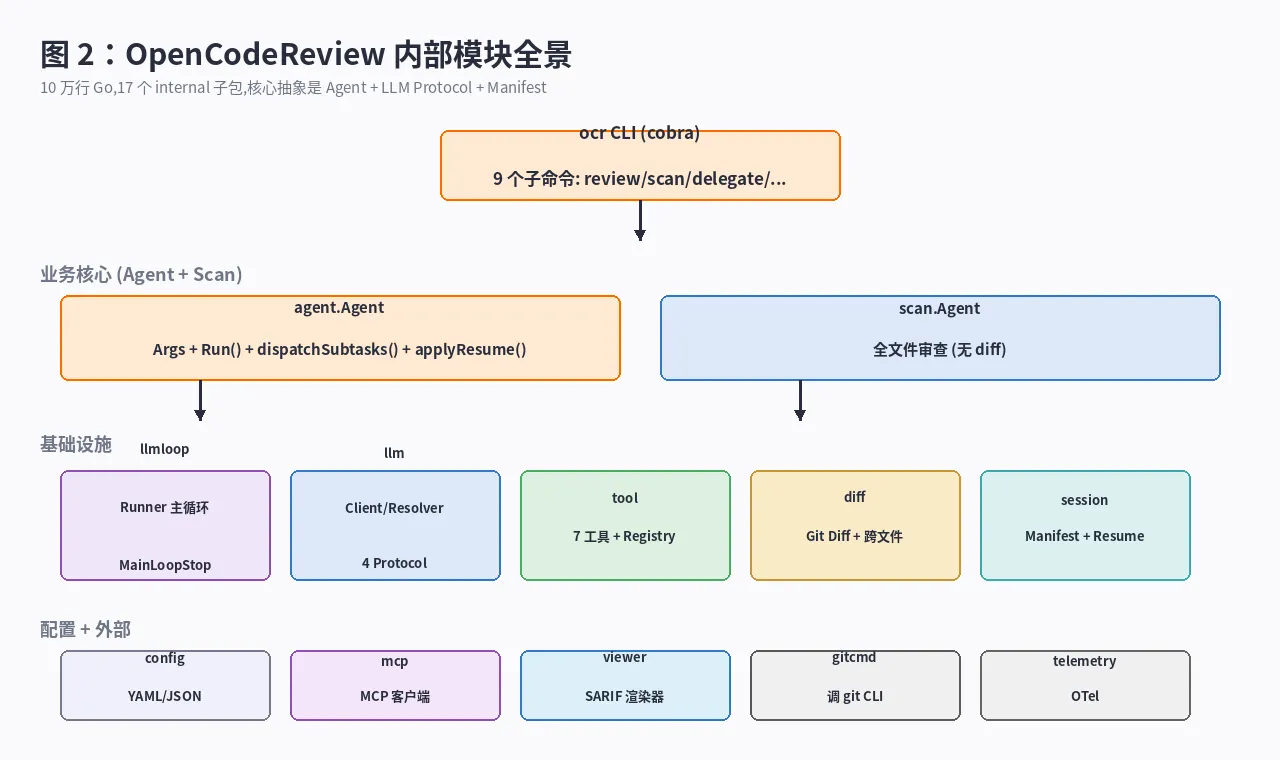
二、内部模块全景:17 个 internal 子包#
整个项目只有 Go 一种语言(这是跟之前拆过的 Sonarr 完全不同的路线 —— Sonarr 是 .NET + React 双栈),组织成 4 个层次的 17 个 internal 子包:
| 子包 | 行数 | 职责 |
|---|---|---|
internal/llm | 18,200 | LLM 客户端、resolver、4 种 Protocol、retry |
internal/agent | 9,137 | diff 审查 Agent 核心(Agent struct / Run / dispatchSubtasks) |
internal/session | 7,831 | 会话管理、Manifest、断点续传 |
internal/viewer | 5,485 | SARIF / GitHub 评论 / 渲染器 |
internal/tool | 5,036 | 7 个 tool + Registry + comment_args 修复 |
internal/config | 5,198 | YAML/JSON 配置、system_rules.json |
internal/scan | 4,946 | 全文件审查(无 diff) |
internal/llmloop | 4,836 | LLM 主循环 + async 压缩 |
internal/diff | 4,674 | Git diff 解析 + 跨文件 relocate |
| 其他 | ~10,000 | telemetry / mcp / model / gitcmd / delegate / suggestdiff / stdout / pathutil / release |
核心特征:llm/ 是单包最大(18.2K 行),比 agent 还大 2 倍。这跟很多 Agent 项目「agent 大、llm 只是个 wrapper」的画风截然不同。OCR 的 llm 子包不仅有 4 套 Protocol 实现,还有完整的 retry / 限流 / cache read-write token 拆分统计 —— 这是一个被 LLM 推理不可靠性「打磨过」的工业模块。
三、端到端流程:git diff → comments#
当你跑 ocr review 时,背后是这样的:
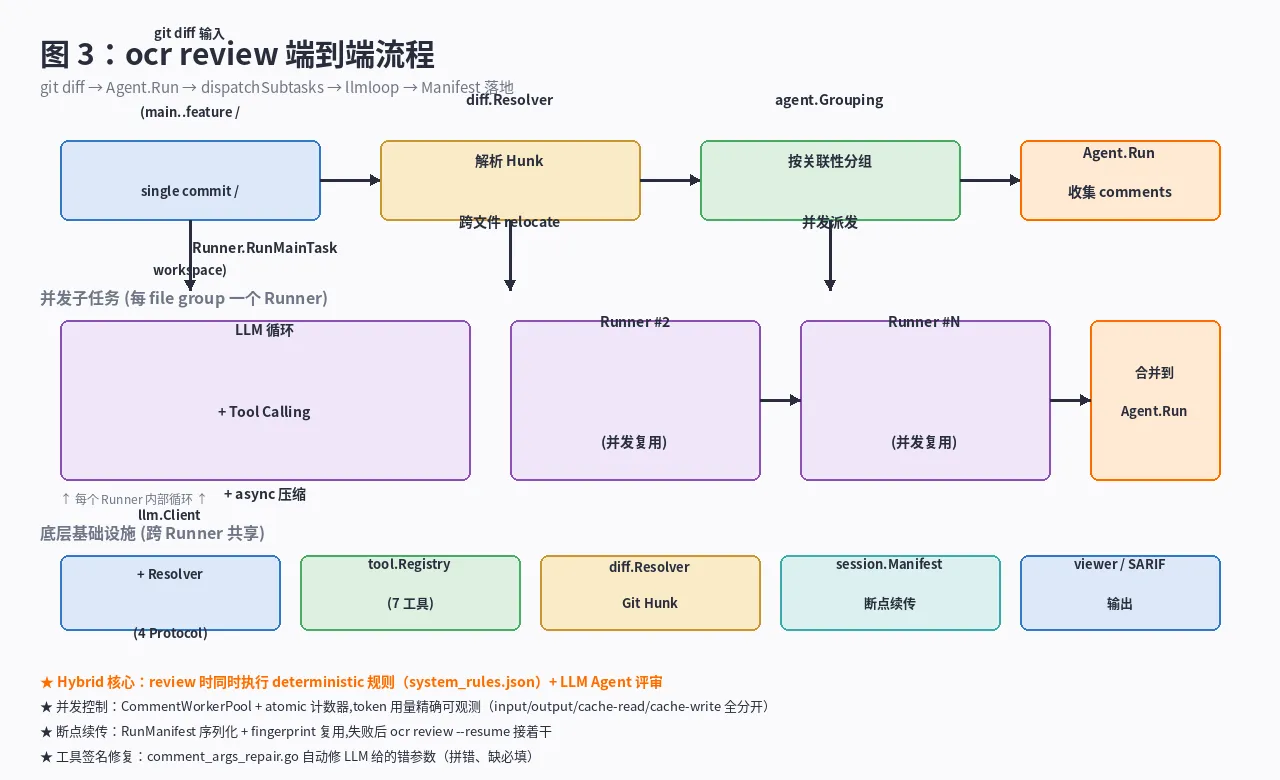
第一阶段:Diff 解析
diff.Resolver 读 git diff(支持 main..feature / 单 commit / 全 workspace 三种模式),把 Hunk 解析成结构化的 model.Diff。这一阶段最有意思的设计是 relocation.go 处理跨文件 rename/relocate —— 当一个文件被改名时,diff 里新旧路径都对得上,但上下文里残留的旧路径需要被正确解析。
第二阶段:按关联性分组
agent.Grouping 把 Diff 按文件关联性分组成 file group。比如改了一个 interface 的定义 + 3 个实现,4 个文件会被分到同一组。这样后续评审时,LLM 能看到”接口契约变更 + 各实现点的同步响应”,而不是被切成 4 个独立 PR review。
第三阶段:并发子任务
每个 file group 起一个 Runner.RunMainTask,多个 Runner 并发执行。每个 Runner 内部是一个完整的 LLM 循环:
messages → LLM → 工具调用 → 工具结果 → messages → LLM → ...LLM 循环由 internal/llmloop/loop.go 实现,里面有几个关键设计:
MainLoopStop枚举退出原因(completed / max_turns / tool_error / cancel),所有退出都可追溯atomic.LoadInt64计数器记录 input / output / cache-read / cache-write 各自 token 用量recordWarning/recordToolCall/recordToolFailure全部用 atomic 操作,并发安全triggerAsyncCompression在 LLM 调用 idle 期间异步触发 context 压缩,不阻塞主循环
第四阶段:合并 + 落地
CommentWorkerPool 把所有 file group 的 comments 合并,按 file path + line number 排序。session.RunManifest 序列化到磁盘(每个 Run 一个 JSON 文件)。viewer 把 comments 渲染成 SARIF 2.1.0 / GitHub review comment / 普通 JSON 三种输出。
3.1 Hybrid 架构的真正含义#
OCR 的 “Hybrid” 不是说「LLM 加点规则」。它的实际意思是:
确定性路径:
  system_rules.json (50+ 文件类型 glob) → 内置 rule doc (java.md / go.md / ts_js_tsx_jsx.md / ...)
                                         → LLM 加载规则作为 prompt context

LLM Agent 路径:
git diff + rule context + file contents → 工具调用循环 → 生成 review comments具体过程:每个文件先按扩展名匹配 system_rules.json 里的 glob(比如 **/*.java → java.md),把对应的内置规则文档嵌入到 LLM 的 system prompt 里。这样 LLM 不是从零开始想”Java 应该检查什么”,而是已经获得了「阿里内部 Java 代码审查清单」的全文。
这种”规则文档作为 prompt 注入”的设计,比 fine-tuning / RAG 都简单且有效。新增文件类型支持 = 写一份 .md 规则文档,不用改任何 Go 代码。
3.2 comment_args_repair:自动修复 LLM 工具调用错误#
internal/tool/comment_args_repair.go 这个文件是 OCR 区别于通用 Agent 的实战打磨痕迹。LLM 调用工具时经常犯三类错:
- 参数名拼错(
file_path写成filepath) - 缺必填字段(忘了
line_number) - 参数类型错(
string写成int)
通用 Agent 的做法是:失败 → 重试 → 又失败 → 放弃。OCR 的做法是:在 retry 之前先用一个本地模型(或规则)尝试修一遍,把 filepath 改成 file_path、补上默认值、重试一次。
这种”先修后重”的模式,让 OCR 在 benchmark 上跑出来的 token 数大幅下降 —— 同一个工具调用,重试比重新 prompt 让 LLM 重新理解便宜得多。
四、LLM Provider 协议抽象:4 套 wire protocol#
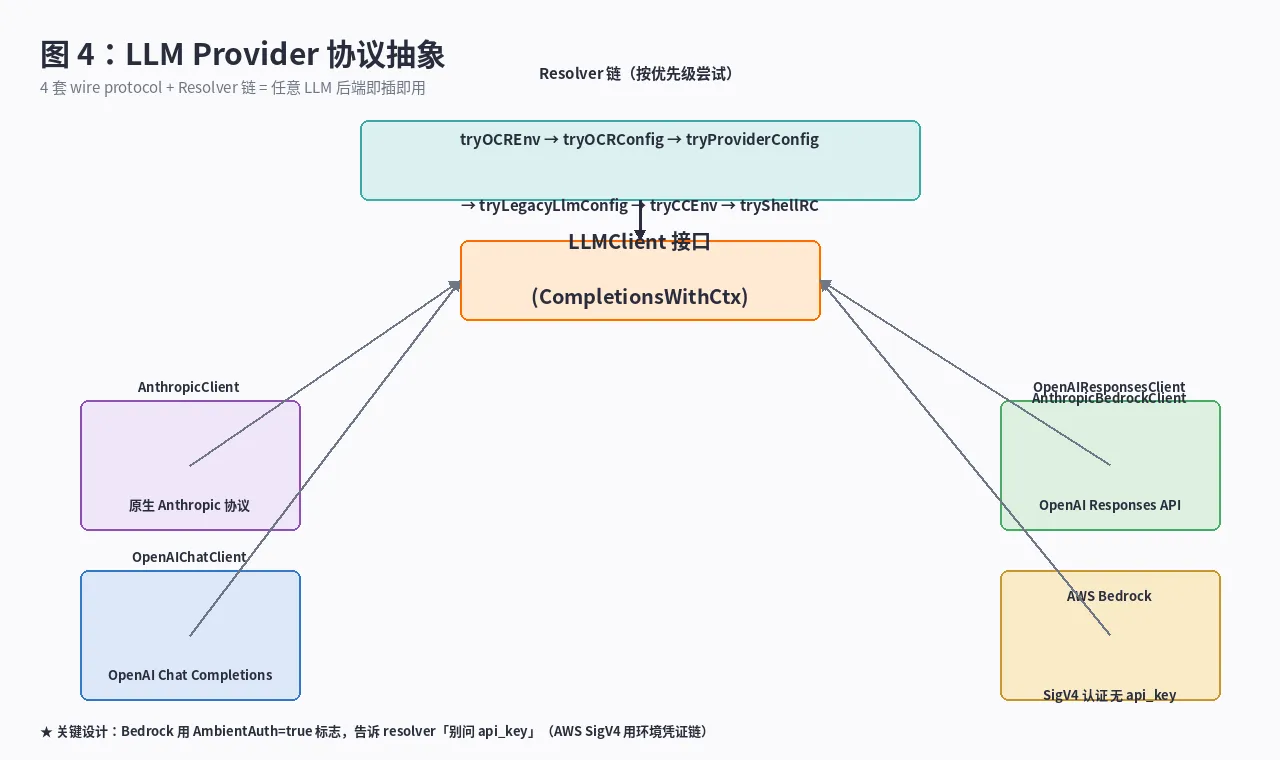
internal/llm/ 是整个项目最重的子包(18.2K 行),它的核心抽象是 LLMClient interface + 4 套 Protocol 实现:
type LLMClient interface {
    CompletionsWithCtx(ctx context.Context, req ChatRequest) (*ChatResponse, error)
}四种实现(来自 internal/llm/providers.go 的 registry):
| 实现 | 协议 | 适用 |
|---|---|---|
AnthropicClient | 原生 Anthropic 协议 | Claude API 直连 |
OpenAIChatClient | OpenAI Chat Completions | OpenAI / 兼容 OpenAI 的服务(vLLM / Ollama 等) |
OpenAIResponsesClient | OpenAI Responses API | OpenAI 新版响应式 API |
AnthropicBedrockClient | Anthropic Bedrock | AWS Bedrock,用 SigV4 认证,不要 api_key |
4.1 Resolver 链:6 步优先级#
internal/llm/resolver.go 里的 ResolveEndpoint() 实现了一个优先级链:
tryOCREnv()         // 先看 OCR_* 环境变量
  ↓ 没找到
tryOCRConfig()      // 再看 ~/.config/open-code-review/config.yaml
  ↓ 没找到
tryProviderConfig() // 再看 providers.yaml 里的 registry
  ↓ 没找到
tryLegacyLlmConfig()// 再看老的 llm config(兼容老用户)
  ↓ 没找到
tryCCEnv()          // 再看 CLAUDE_CODE_* env(兼容 Claude Code 用户)
  ↓ 没找到
tryShellRC()        // 最后看 ~/.bashrc 里的 API key
  ↓ 都没有
返回错误这套链的设计哲学是”零配置启动”:用户只要设了任何一种常见的 LLM API key(ANTHROPIC_API_KEY / OPENAI_API_KEY / Claude Code env),OCR 就能直接用,不用先跑 ocr config init。
4.2 AmbientAuth:Bedrock 的优雅处理#
type Provider struct {
    Name        string
    DisplayName string
    Protocol    string
    BaseURL     string
    AuthHeader  string
    EnvVar      string
    Models      []string

    // AmbientAuth marks a provider whose credentials come from the
    // environment's own chain rather than an api_key — AWS SigV4, for
    // instance. The resolver skips its api_key requirement for these.
    AmbientAuth bool
}AWS Bedrock 用 SigV4 签名(不是简单的 API key),凭证来自 ~/.aws/credentials 或 instance role。AmbientAuth=true 让 resolver 不要追问 api_key,因为根本没有可填的 api_key。这是从「配置 schema 层面」处理特殊情况的优雅做法 —— 比起写一堆 if provider == "bedrock" 散落在代码各处。
4.3 token 统计:4 个独立原子计数器#
// llmloop/runner.go 里的 Runner struct 暴露的统计:
func (r *Runner) TotalInputTokens() int64       // 输入 token
func (r *Runner) TotalOutputTokens() int64      // 输出 token
func (r *Runner) TotalCacheReadTokens() int64   // cache 命中读取
func (r *Runner) TotalCacheWriteTokens() int64  // cache 写入
func (r *Runner) TotalTokensUsed() int64 // 上面四个之和每个计数器都用 atomic.LoadInt64 / atomic.AddInt64 保护。为什么 cache read 和 cache write 要分开? 因为它们计费不同 —— Anthropic 的 cache write 比 cache read 贵 4 倍,OpenAI 也有类似定价。OCR 的精确统计让用户能算出”这个 review 实际花了多少钱”。
4.4 跟 Pi Agent Harness 的对比#
之前我们拆过 Pi Agent Harness ↗,它的 pi-ai 也是「3 套 wire protocol + cross-provider 切换」的设计。两者异曲同工:
| 维度 | Pi Agent Harness | OpenCodeReview |
|---|---|---|
| Provider 抽象 | 3 套 wire protocol | 4 套 wire protocol |
| 跨 provider 切换 | thinking blocks 转 <thinking> tagged text 兜底 | 没显式处理,靠 LLMClient 接口屏蔽差异 |
| Model catalog | 启动时从 models.dev 拉 | 内置 registry + 用户自定义 |
| Resolver | provider registry | 6 步优先级链 |
结论:这是一个已经被多个项目反复验证的最佳实践 —— 做 LLM 应用,先识别协议层共性,再针对差异点写适配。OCR 还多了「AmbientAuth 这种 provider 个性化配置」的处理,比 Pi 更细致。
五、断点续传 Manifest:把 LLM Agent 做成「可重启服务」#
internal/session/manifest.go 是 OCR 另一个让我印象深刻的子包。它解决的问题是:跑一个大型 review(几千个文件)时,跑到一半网络断了 / OOM 了 / 用户 Ctrl+C 了,下次怎么接着干?
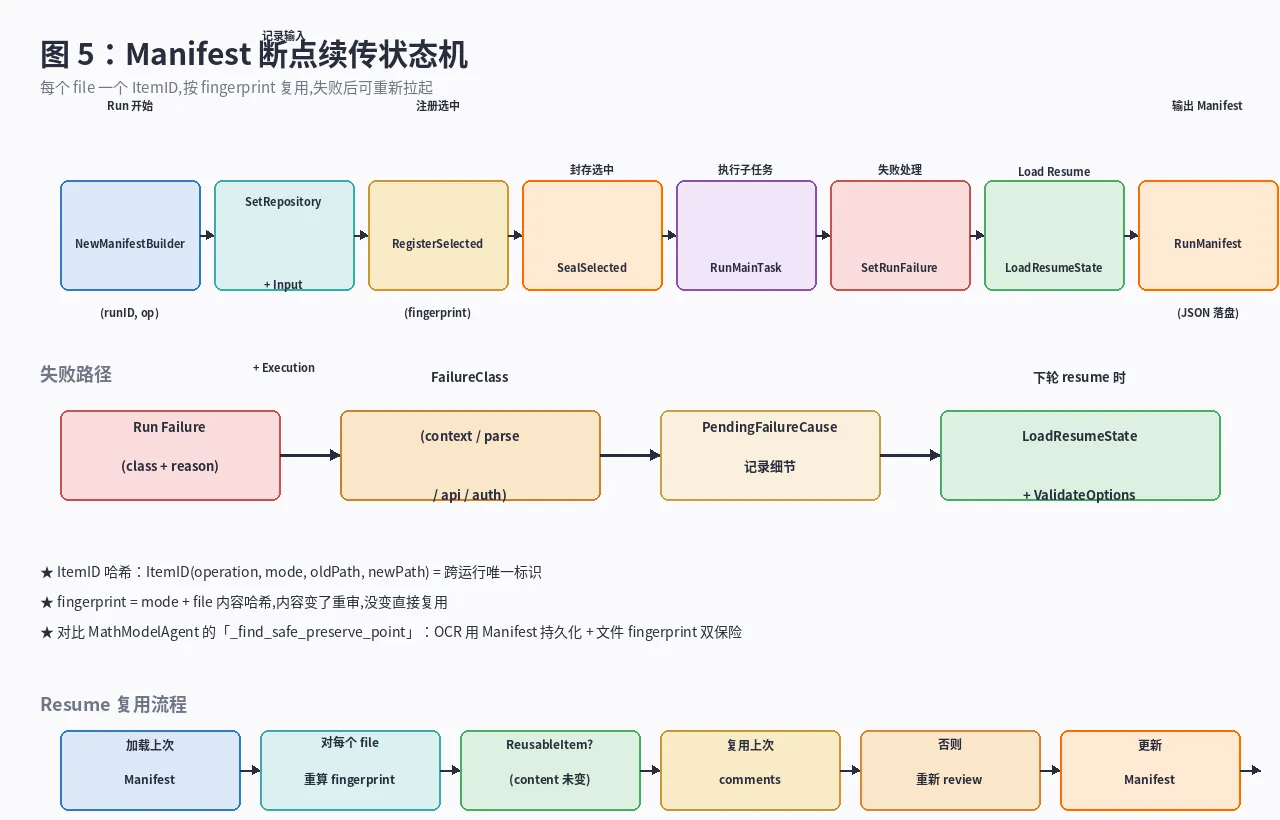
5.1 三个核心抽象#
// 1. CoverageItem: 评审项的最小单元
type CoverageItem struct {
    Operation string  // review / scan
    Mode      string  // workspace / range / commit
    OldPath   string  // 旧路径
    NewPath   string  // 新路径
}

// ItemID: 跨运行的稳定唯一标识(哈希)
func ItemID(operation, mode, oldPath, newPath string) string {
    h := sha256.New()
    h.Write([]byte(operation))
    h.Write([]byte{0})
    h.Write([]byte(mode))
    h.Write([]byte{0})
    h.Write([]byte(oldPath))
    h.Write([]byte{0})
    h.Write([]byte(newPath))
    return hex.EncodeToString(h.Sum(nil))
}

// 2. RunManifest: 一次完整 Run 的快照
type RunManifest struct {
    Input         ManifestInput
    Repository    ManifestRepository
    Execution     ManifestExecution
    Selected      []CoverageItem      // 已注册待审的项
    Sealed        bool                // 是否已封存(封存后才能执行)
    Coverage      *Coverage           // 进度覆盖
    PendingFailureCause *RunFailure    // 待定失败原因
    // ...
}

// 3. ResumeState: 跨 Run 的复用状态
type ResumeState struct {
    SessionID     string
    Items         map[string]ResumeItem  // fingerprint → 结果
    CompletedCount int
}5.2 失败分类:FailureClass 枚举#
type FailureClass string

const (
    FailureContext  FailureClass = "context"    // context window 超限
    FailureParse    FailureClass = "parse"      // 输出无法解析
    FailureAPI      FailureClass = "api"        // LLM API 报错(5xx)
    FailureAuth     FailureClass = "auth"       // 401/403
    // ...
)RunFailure 结构带 FailureClass,让 resume 时能区分”网络抖动重试就行”和”权限问题需要用户介入”。这是工业级 Error Handling 的核心 —— 不要把所有 error 都塞进一个 if err != nil,要给错误分类路由。
5.3 ReusableItem(fingerprint):内容哈希复用#
// session/resume.go
func (s *ResumeState) ReusableItem(fingerprint string) (ResumeItem, bool) {
    item, ok := s.Items[fingerprint]
    if !ok {
        return ResumeItem{}, false
    }
    // 内容未变 → 直接复用上次的 comments
    return item, true
}fingerprint = mode + file content hash。文件内容没变 → 直接拿上次的 review 结果,不重新调 LLM。这让 OCR 在大型 monorepo 上做 review 时,重复运行的成本几乎为零 —— 第一次跑花 10 分钟,二次跑花 30 秒。
5.4 对比之前拆过的项目#
| 项目 | 断点续传机制 | 实现成本 |
|---|---|---|
| MathModelAgent | _find_safe_preserve_point + _is_safe_cut_point 防切断 tool_call 序列 | 中(Agent 内部切割点) |
| Pi Agent Harness | JSONL 树状会话 + compaction + contextTokens > contextWindow - reserveTokens 触发 | 中(compaction 触发器) |
| OpenCodeReview | Manifest 持久化 + fingerprint 复用 + FailureClass 错误分类 | 高(完整的 Run 生命周期) |
OCR 的方案最重,因为它的场景是「长跑批处理」(几小时跑几千文件)。其他两个项目更适合「交互式会话」(几十分钟跑完一个任务)。没有银弹,看场景选方案。
六、50+ 语言的内置规则系统#
internal/config/rules/system_rules.json 是个 57 行的 JSON,把 50+ 文件类型映射到对应的内置规则文档:
{
  "default_rule": "default.md",
  "path_rule_map": {
    "**/*.java": "java.md",
    "**/*.go": "go.md",
    "**/*.{ts,js,tsx,jsx,mjs,cjs}": "ts_js_tsx_jsx.md",
    "**/*.kt": "kotlin.md",
    "**/*.rs": "rust.md",
    "**/*.{cpp,cc,cxx,hpp,hxx}": "cpp.md",
    "**/*.proto": "protobuf.md",
    "**/*.{tf,hcl,tfvars}": "terraform.md",
    "**/*.swift": "swift.md",
    "**/*.zig": "zig.md",
    ".github/workflows/**/*.{yaml,yml}": "github_workflows.md",
    "**/pom.xml": "pom_xml.md",
    "**/build.gradle": "build_gradle.md",
    // ... 还有 40+ 项
  }
}6.1 first-match-wins 的顺序敏感#
注意 PathRules []PathRule 用的是数组而非 map,因为 JSON object key 顺序在 Go 1.21 之前是不稳定的。OCR 用自定义 UnmarshalJSON 显式保留声明顺序,确保 glob 顺序敏感(比如 .github/workflows/**/*.{yaml,yml} 必须在 **/*.{yaml,yml} 前面,否则会被泛匹配先吃掉)。
6.2 embed.FS 嵌入规则文档#
//go:embed *.md
var ruleDocs embed.FS所有 .md 规则文档用 Go 1.16+ 的 //go:embed 编译进二进制。用户安装后不用额外下载任何资源,单个二进制就是完整工具。这是 Go 生态做工具链的标准做法。
6.3 新增语言支持的成本#
要支持 Rust(假设还没支持):
- 写一份
rust.md,包含「Rust 特定审查清单」(生命周期、所有权、unsafe、async 等) - 在
system_rules.json加"**/*.rs": "rust.md" - 重新编译
完全不用改 Go 代码。这就是「规则文档作为 prompt 注入」模式的扩展性。
七、可学习的工程实践#
通读 10 万行代码后,我挑出 6 个最有借鉴价值的设计:
7.1 Atomic 计数器做精确 token 计量#
不靠 Prometheus exporter,每个 goroutine 直接 atomic.AddInt64 累加。比中心化 metrics 收集快两个数量级,且天然并发安全。代码在 internal/llmloop/loop.go:
func (r *Runner) RecordUsage(u *llm.UsageInfo) {
    atomic.AddInt64(&r.totalInputTokens, u.InputTokens)
    atomic.AddInt64(&r.totalOutputTokens, u.OutputTokens)
    atomic.AddInt64(&r.totalCacheReadTokens, u.CacheReadTokens)
    atomic.AddInt64(&r.totalCacheWriteTokens, u.CacheWriteTokens)
}适用场景:所有需要”内部精确计量 + 外部偶尔查询”的指标(token / 错误数 / 任务完成数)。
7.2 工具调用先修后重#
LLM 工具调用失败不要立刻 retry,先用一个便宜的本地模型(甚至纯规则)尝试修参数。internal/tool/comment_args_repair.go 是这个模式的实现。
适用场景:所有 LLM Agent 项目。工具调用失败重试的成本是”完整 prompt + 完整 LLM 调用”,修参数的成本是”几行字符串替换”。
7.3 Provider 个性化字段标记#
type Provider struct {
    AmbientAuth bool  // 这个 provider 不用 api_key
}不写一堆 if provider == "bedrock" 散落在代码各处。给 Provider struct 加语义化标志字段,让 resolver 和 client 各自读取,避免耦合。
适用场景:所有多 Provider 适配场景(数据库驱动 / LLM provider / 存储后端)。
7.4 顺序敏感的 glob 匹配#
JSON map 在 Go 里是无序的,但规则匹配需要顺序(specific 在前,general 在后)。用自定义 UnmarshalJSON 显式保留 key 顺序,转成 []PathRule 切片。
适用场景:所有”配置即规则”的场景,rule 顺序经常影响结果。
7.5 错误分类枚举 + 路由#
type FailureClass string
const (
    FailureContext FailureClass = "context"
    FailureParse   FailureClass = "parse"
    FailureAPI     FailureClass = "api"
    FailureAuth    FailureClass = "auth"
)不要把所有 error 都塞进 if err != nil。给错误分类,让上层根据 class 路由处理策略(自动重试 / 提示用户 / 报告 bug)。
适用场景:所有长时间运行的批处理系统。
7.6 规则文档作为 prompt 注入(替代 RAG / fine-tune)#
50+ 语言支持 = 50+ 个 .md 文档 + 57 行 JSON 映射。不用 RAG 检索,不用 fine-tune 改模型,直接把规则文档塞进 system prompt。
适用场景:所有需要「按场景给 LLM 注入领域知识」的系统。规则文档易维护、易扩展、易审计。
八、不足与疑问#
拆解不是为了吹,是要看清楚边。OCR 也有几个我看着不舒服的地方:
8.1 单一 binary 体积#
go build 出来一个 60MB+ 的单二进制(因为把所有 .md 规则 embed 进去 + cobra + OTel + Sarama 等等)。对 CLI 工具来说偏大。可以考虑 lazy load 部分规则文档(首次用到再从外部读)。
8.2 没看到 benchmark 复现#
README 自述 1/9 token / 更高 Precision,但仓库里没有可复现的 benchmark 脚本。这种”我说我好”的对比对开源用户来说说服力有限。
8.3 没看到端到端测试#
internal/* 里有大量 *_test.go(覆盖率肯定很高),但没看到 E2E 测试 fixture。一个 PR review 的真实样例(before/after 对比)会对用户更有价值。
8.4 commit 集中在 9 月#
我看了一下 git log(虽然 tarball 没带 .git,但 README 提到 2026 年 8 月开始大规模更新)。从代码质量看是「重写型 release」而非「渐进式演化」,长期维护的可持续性需要观察。
九、自部署 vs 直接用 IDE 插件#
OCR 提供了三种入口(README 列的):
| 入口 | 适用 |
|---|---|
CLI (ocr) | CI/CD 集成、批量 review、local pre-commit |
VSCode 扩展 (extensions/vscode) | 开发者本地 IDE 集成 |
GitHub Action (action.yml) | PR 自动 review |
Claude Code / Codex Skill (skills/open-code-review/) | Agent 内部调用 |
推荐组合:GitHub Action 跑 PR review(强制)+ VSCode 扩展跑开发时增量 review(可选)+ CLI 跑批量扫描(季度审计)。
十、跟同样拆过的几个项目对照#
| 项目 | 解决的核心问题 | 关键设计 |
|---|---|---|
| Pi Agent Harness ↗ | Agent 框架本身 | 3 套 wire protocol + Tree JSONL 会话 |
| HyperFrames ↗ | HTML → MP4 渲染 | HeadlessExperimental.beginFrame + 锁预热时钟 |
| God’s Eye View ↗ | 浏览器上帝视角 | 滞回半径防 zoom 闪屏 + Owner decision 注释 |
| MathModelAgent ↗ | 数学建模自动化 | 9 SKILL + 4 Agent 文件系统通信 |
| OpenCodeReview | AI 代码审查 | Hybrid + Manifest 断点续传 + 4 Protocol |
OCR 的最大差异点:它在「让 LLM 干精确活」这条路上走得很深 —— 不追求召回率,要追求精度。这跟 Pi Agent Harness 的「通用 Agent」路线相反,但跟 Sonarr 的「CustomFormatScore 选最优」思路一致:同条件下选最好的,别让 LLM 乱投票。
十一、参考资料#
- OpenCodeReview 官方仓库:https://github.com/alibaba/open-code-review ↗
- 官方文档站:https://open-codereview.ai ↗
- 项目治理:见
GOVERNANCE.md(社区如何参与贡献、决策机制) - Benchmark 描述:见 README 顶部 “Benchmark” 章节(中文版
README.zh-CN.md同样有) - ASSURANCE_CASE.md:项目「为什么不只是 demo」的工程论证
- 本文代码引用版本:
v0.x(2026 年 8 月以来持续更新),具体 commit 见官方仓库
本文是「开源项目深度拆解」系列的第 N 篇,前几篇拆过 HyperFrames ↗、God’s Eye View ↗、MathModelAgent ↗、Sonarr ↗、Pi Agent Harness ↗。如果你对哪个项目感兴趣想拆,告诉我。