Anthropic Skills 深挖:一套把经验做成文件夹的方法论
💬 评论Anthropic 把 20 个 Claude 技能开源了。真正值得学的不是技能本身,而是「渐进式披露」怎么设计、description 怎么写、文档四件套怎么共用一套坑清单。
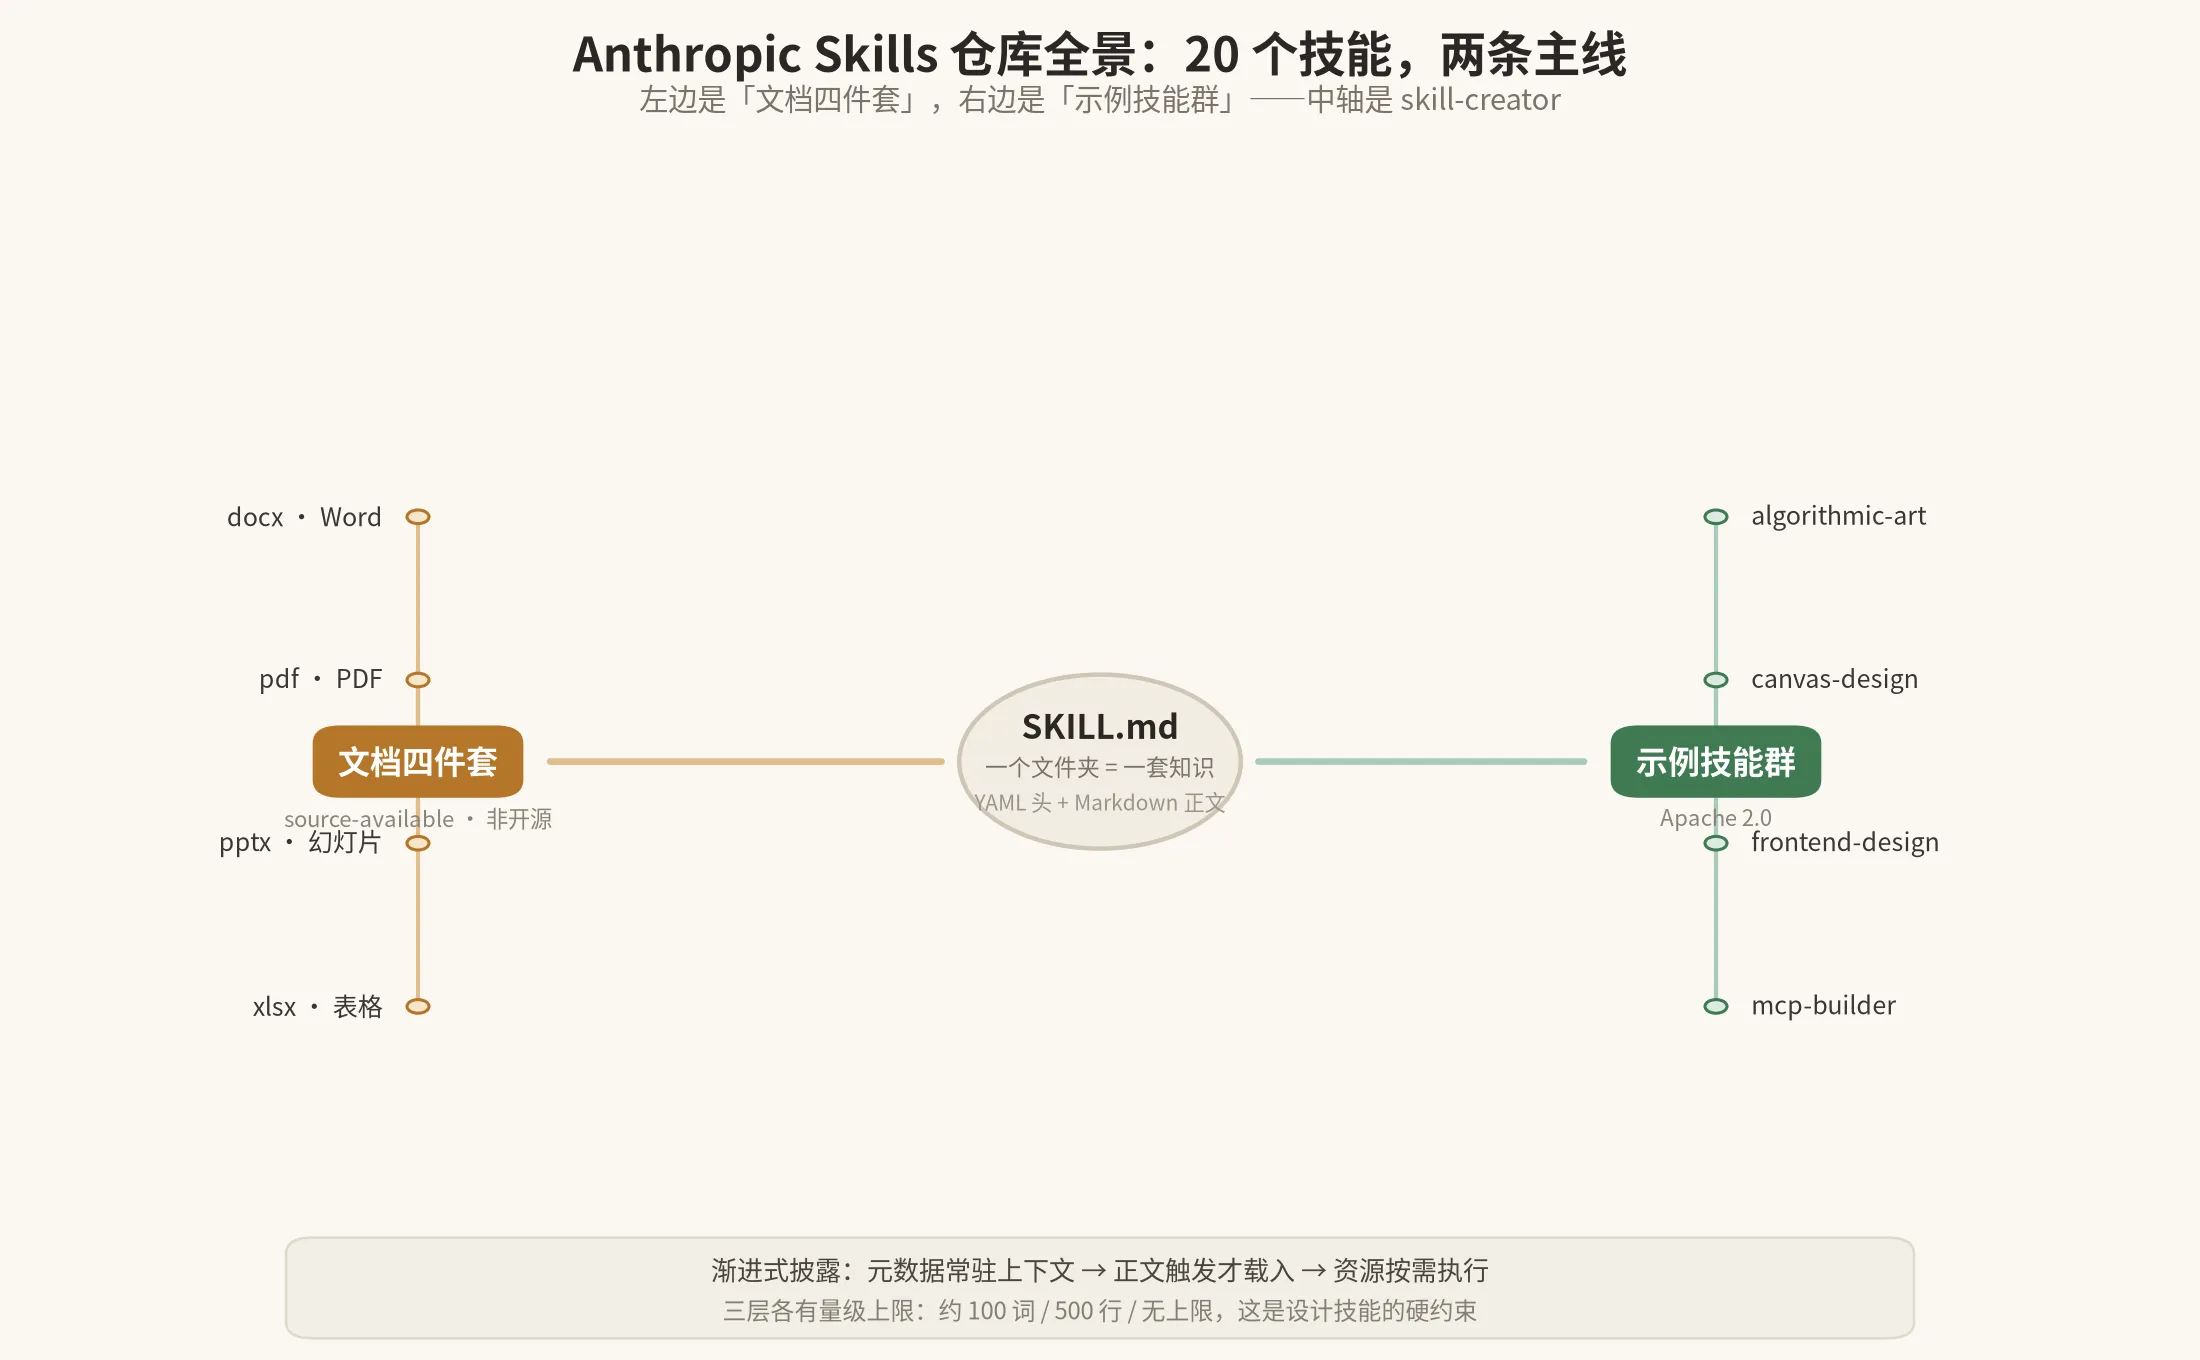
仓库:anthropics/skills ↗ · 规范:agentskills.io ↗ 20 个技能 / 446 个文件 / 约 3.2 万行 Markdown · Apache 2.0 + 部分 source-available
第一次看到 anthropics/skills 这个仓库的时候,我的反应是「这不就是一堆 prompt 模板吗」。
然后我点开了 skills/docx/SKILL.md,看到里面写着「表格要同时设 columnWidths 和每个 cell 的 width,都用 DXA,百分比会让 Google Docs 挂掉」「表格底纹用 ShadingType.CLEAR,用 SOLID 会渲染成黑色」——
这明显不是 prompt 模板能写出来的东西。这是踩过坑之后才知道的坑。
再往后翻,skills/xlsx/SKILL.md 里有一句我觉得应该被抄下来的话:
A green recalc proves your formulas evaluate, not that they are right. An off-by-one range or a reference to the wrong row yields a clean, error-free file with wrong numbers.
翻译过来就是:文件跑通了不代表算对了。引用范围差一行,得到的是一个「干净、无错误、但数字全错」的表格。
这个仓库真正的价值在这里。它不是「送你 20 个技能用」,而是把 Anthropic 内部怎么组织专业知识,完整摊开给你看。
先把结构看清楚#
仓库比想象中小,find 一遍就 446 个文件:
anthropics/skills/
├── skills/          # 20 个技能,各一个文件夹
├── spec/            # 规范 —— 但这里只有 3 行
├── template/        # 技能模板 —— 只有 6 行
├── .claude-plugin/  # marketplace.json,打包成 Claude Code 插件
└── README.md注意 spec/ 和 template/ 这两个目录。它们加起来 9 行,内容分别是:
# spec/agent-skills-spec.md
The spec is now located at <https://agentskills.io/specification># template/SKILL.md
---
name: template-skill
description: Replace with description of the skill and when Claude should use it.
---
# Insert instructions below规范被搬走了,模板被掏空了。
这件事本身挺有意思的,透露出两个信号。第一,Skills 已经从「Anthropic 的私有特性」变成了「一个跨厂商的标准」——所以规范要放在中立的地方(agentskills.io),不能锁在自家仓库里。第二,模板被掏空说明他们认为模板没有价值:给你一个填空题框架,不如给你 20 个真实样本,让你自己看出该长什么样。
我更认同后面这种做法。看 20 个真实技能,比看一个空模板有用得多。
20 个技能分成三堆#
| 分组 | 成员 | 许可 |
|---|---|---|
| 文档四件套 | docx pdf pptx xlsx | source-available(非开源) |
| 示例技能群 | algorithmic-art canvas-design frontend-design mcp-builder webapp-testing internal-comms brand-guidelines doc-coauthoring slack-gif-creator theme-factory web-artifacts-builder academic-guide | Apache 2.0 |
| 独苗 | skill-creator claude-api discernment-nudge | Apache 2.0 |
skill-creator 单独拎出来是对的——它是唯一一个「生产工具」而不是「示例产物」的技能。其他技能是它造出来的,它是元技能。
discernment-nudge 也很有意思,后面单独说。
最核心的设计:渐进式披露#
如果这个仓库只让我记住一件事,我会记住这个。
Anthropic 官方博客那篇《Equipping agents for the real world with Agent Skills》里,把 Skill 的加载拆成三层:
| 层级 | 内容 | 何时进上下文 | 体量上限 |
|---|---|---|---|
| 第 1 层 | name + description | 永远都在 | ~100 词 |
| 第 2 层 | SKILL.md 正文 | 技能被触发时 | 建议 < 500 行 |
| 第 3 层 | scripts/ references/ assets/ | 按需读取或直接执行 | 无上限 |
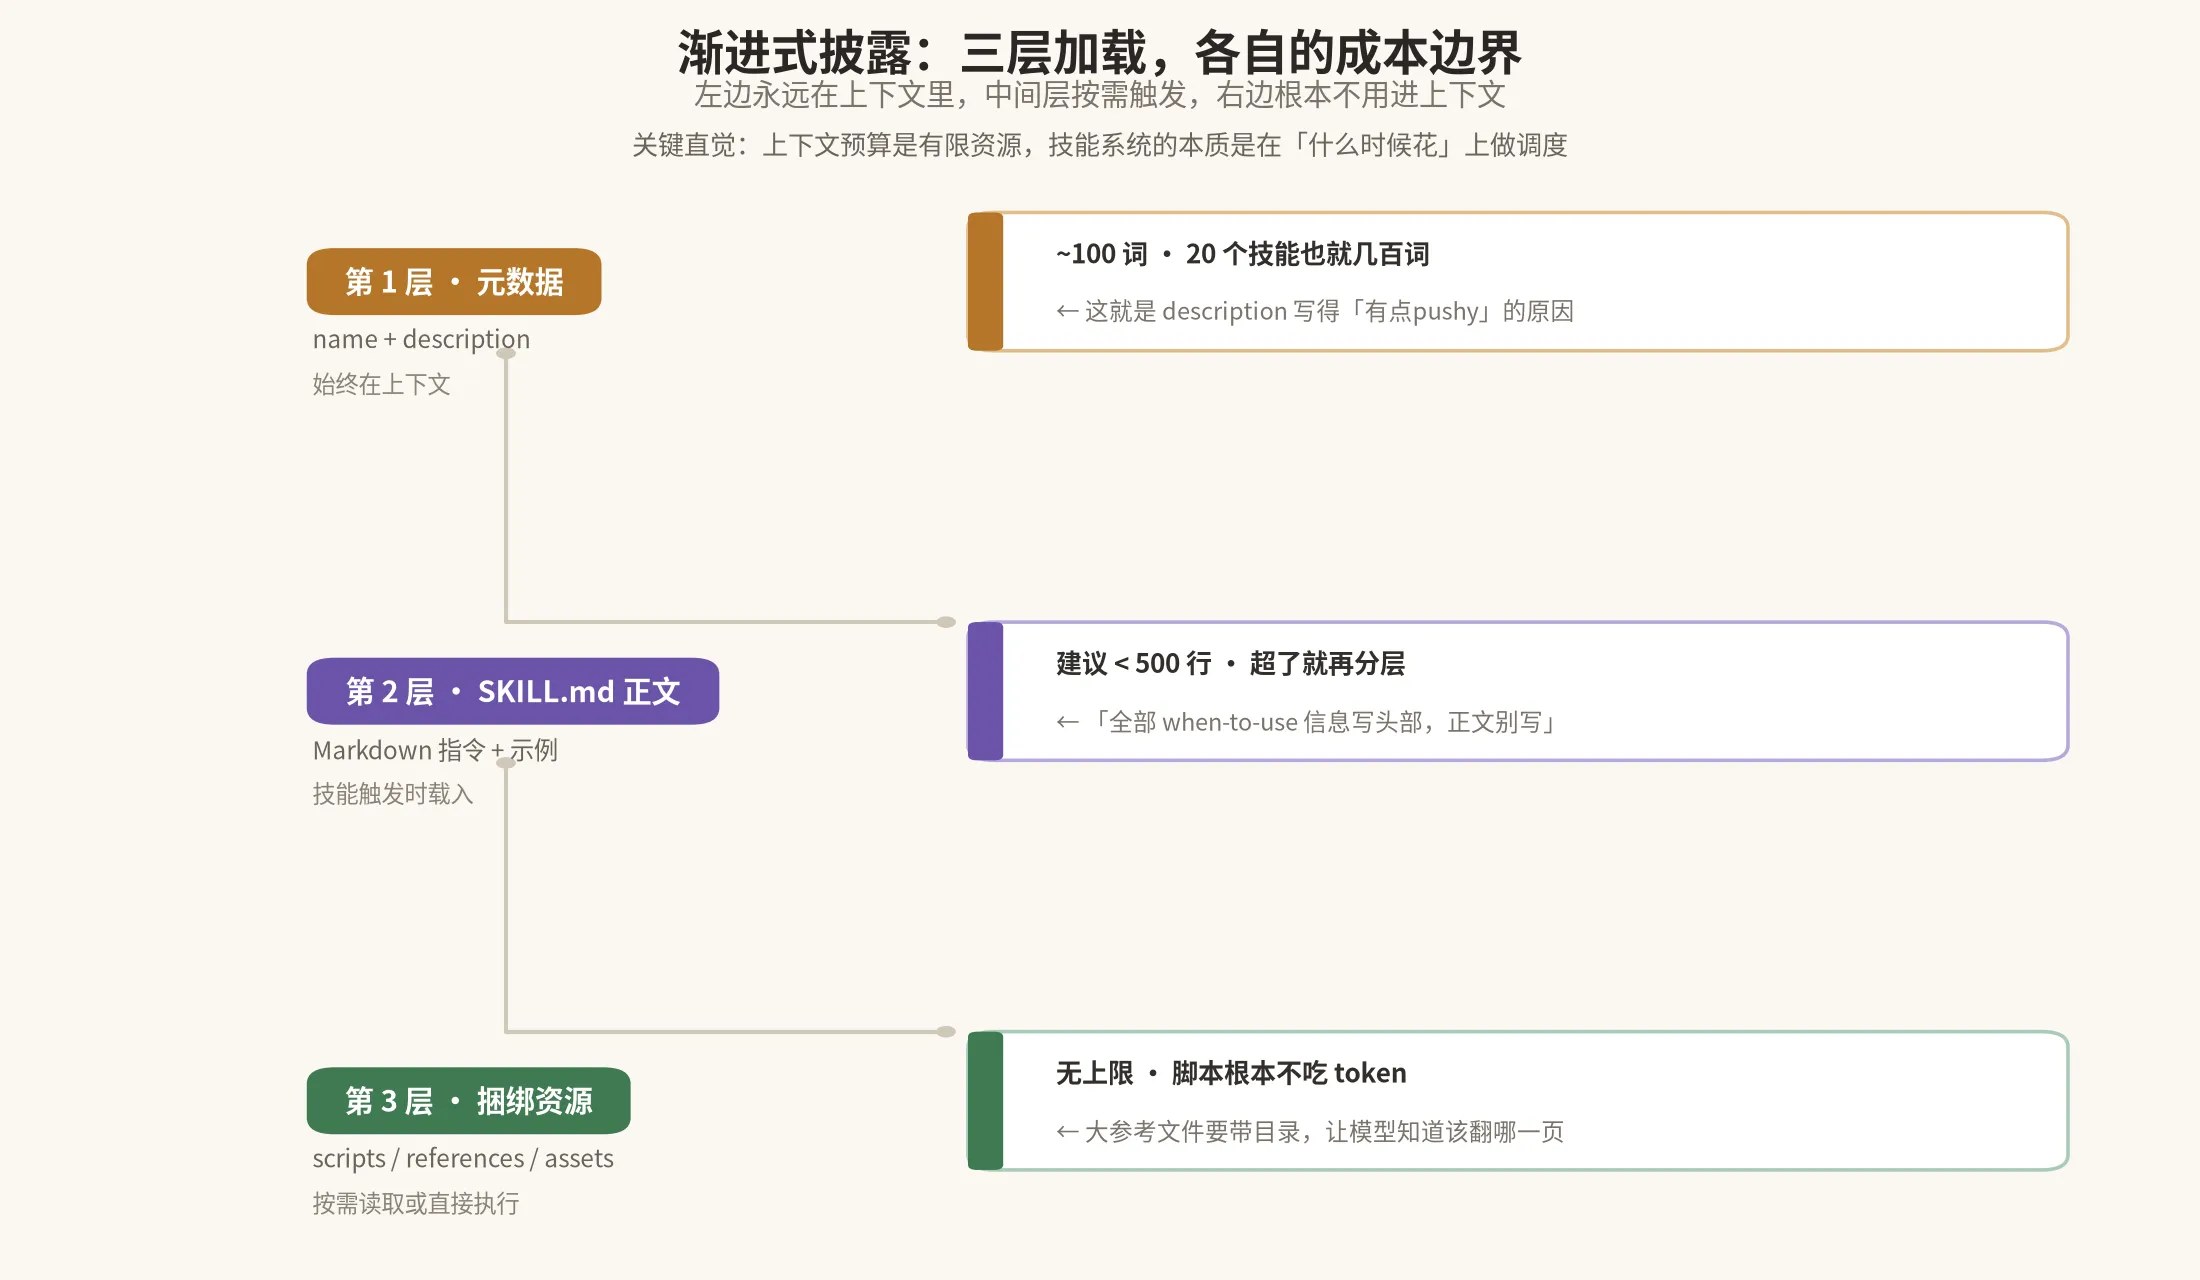
这个设计的直觉很朴素:上下文预算是有限资源,技能系统的本质是在「什么时候花」上做调度。
第 1 层为什么要永远常驻?因为模型得先知道「有这么个东西存在」,才可能去触发它。这就意味着,装 20 个技能,光是元数据就得占掉几百词。这个成本是固定的,你用不用它都在。
第 3 层为什么可以无限?因为脚本执行根本不吃 token。skills/docx/scripts/ 下面有 72 个 Python 文件,还有 117 个 XSD schema 文件——这些是给 validate.py 用的,模型不需要读它们,只需要在正确的时机 python scripts/office/validate.py out.docx 跑一下。
这里有个我觉得非常漂亮的细节。docx 技能里提到了一个叫 merge_runs.py 的脚本,它解决的是这么个问题:
Word splits text across many
<w:r>runs (revision ids, spell-check markers), so a phrase you can see in the document often doesn’t exist as a contiguous string in the XML.
翻译一下:Word 会把一段文字拆成好几个 run 存在 XML 里(因为有修订 ID、有拼写检查标记)。所以你在文档里看到的那句话,在 XML 里往往搜不到。
这个坑只有真正改过 .docx 的人才知道。而它的解法不是写进 prompt 反复叮嘱模型「记得先合并 run」,而是直接给一个脚本。模型只要在流程里加一步 python scripts/merge_runs.py unpacked/ 就完事了。
这就是技能系统和普通 prompt 的分水岭:能变成脚本的,就别写成叮嘱。叮嘱是软的,脚本是硬的。
description 决定一个技能的生死#
仓库里有句话,我觉得是整个 Anthropic Skills 体系里最反直觉的一条。
skill-creator/SKILL.md 里写:
Note: currently Claude has a tendency to “undertrigger” skills — to not use them when they’d be useful. To combat this, please make the skill descriptions a little bit “pushy”.
Claude 有「触发不足」的倾向:该用技能的时候不用。
所以他们给的建议是——description 要写得有点pushy。原文举了个例子:
弱版本:
How to build a simple fast dashboard to display internal Anthropic data.
强版本:
How to build a simple fast dashboard to display internal Anthropic data. Make sure to use this skill whenever the user mentions dashboards, data visualization, internal metrics, or wants to display any kind of company data, even if they don’t explicitly ask for a “dashboard.”
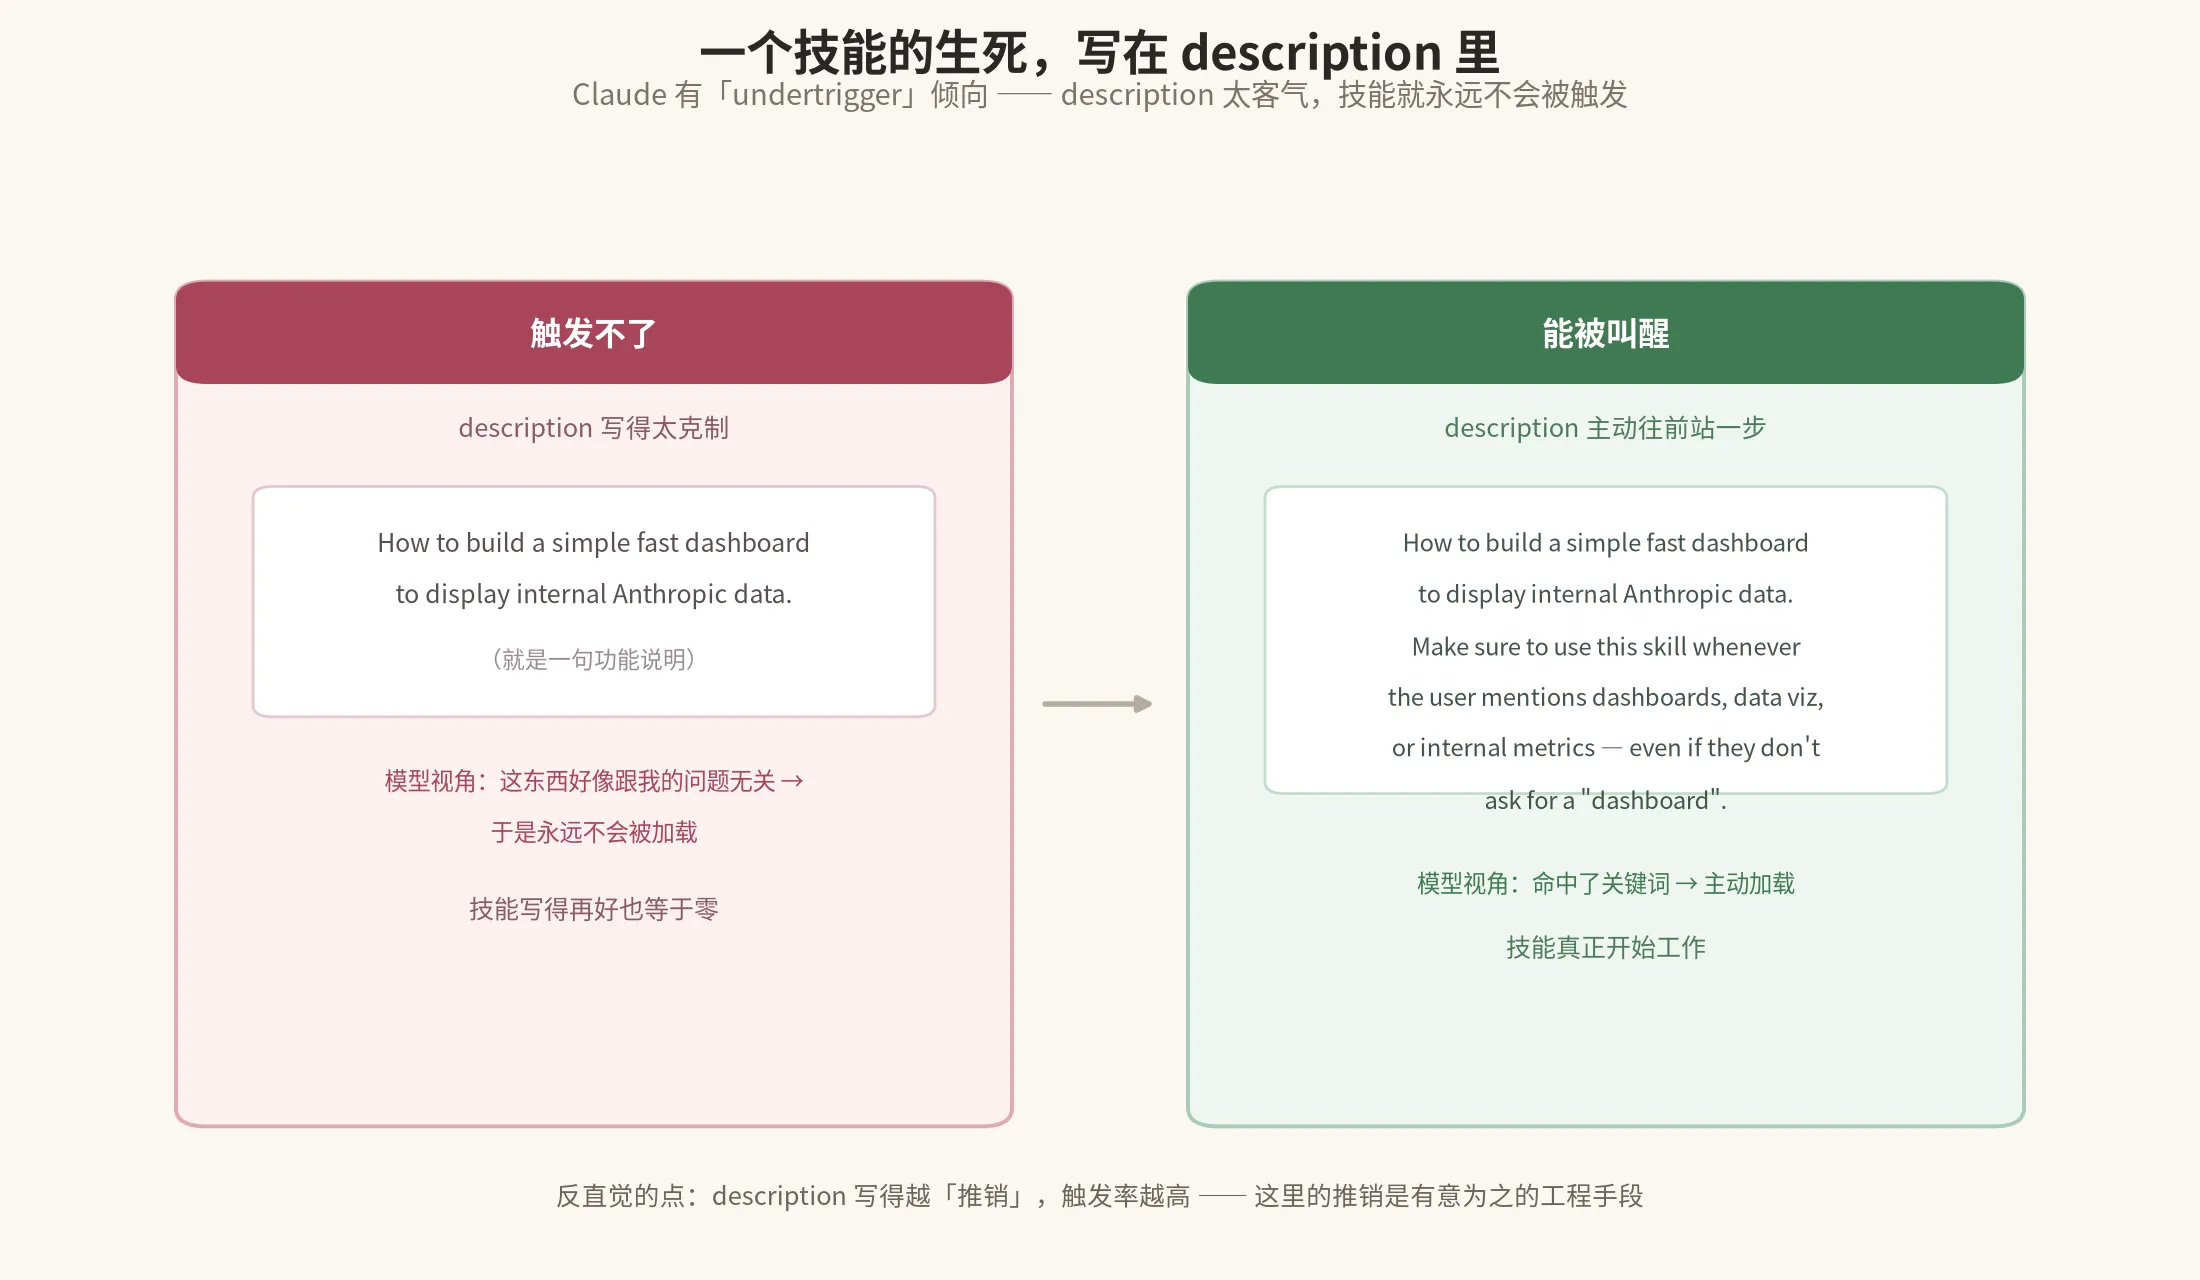
强版本多出来的那一大段,本质上是在做关键词穷举:dashboards、data visualization、internal metrics、company data——把用户可能用的所有说法都列一遍。
我在自己写系统提示词的时候,倾向的做法是「描述精确、克制、不啰嗦」。看到这条我停下来想了一下,确实可能踩坑。
原因也很实在:模型判断「这个技能要不要用」的时候,它是在拿用户的话去跟 description 做匹配。description 越短,能匹配上的表达方式就越少。你写得越「准」,越可能只覆盖了用户恰好没说出来的那个说法。
准确和被找到,是两件事。
顺带一个细节:skill-creator 明确要求「所有 when-to-use 的信息都写在 description 里,不要写在正文」。
这条规则乍看有点反直觉——正文才是给模型看的正文啊?但想明白了就顺:第 2 层只在技能已经触发之后才载入。这时候「什么时候该触发」这个决策早就做完了,再写一遍纯属浪费 token。写对地方,是在第 1 层;写错地方,是白占第 2 层的额度。
文档四件套:换格式不换方法论#
docx pdf pptx xlsx 这四个技能,体量都不小:
docx— SKILL.md 91 行 + 72 个 Python 文件 + 117 个 XSDpptx— SKILL.md 238 行 + 56 个文件xlsx— SKILL.md 99 行 + 53 个文件pdf— SKILL.md 314 行 + 12 个文件
四个技能的做法高度一致,基本是同一套流程的四个变体:
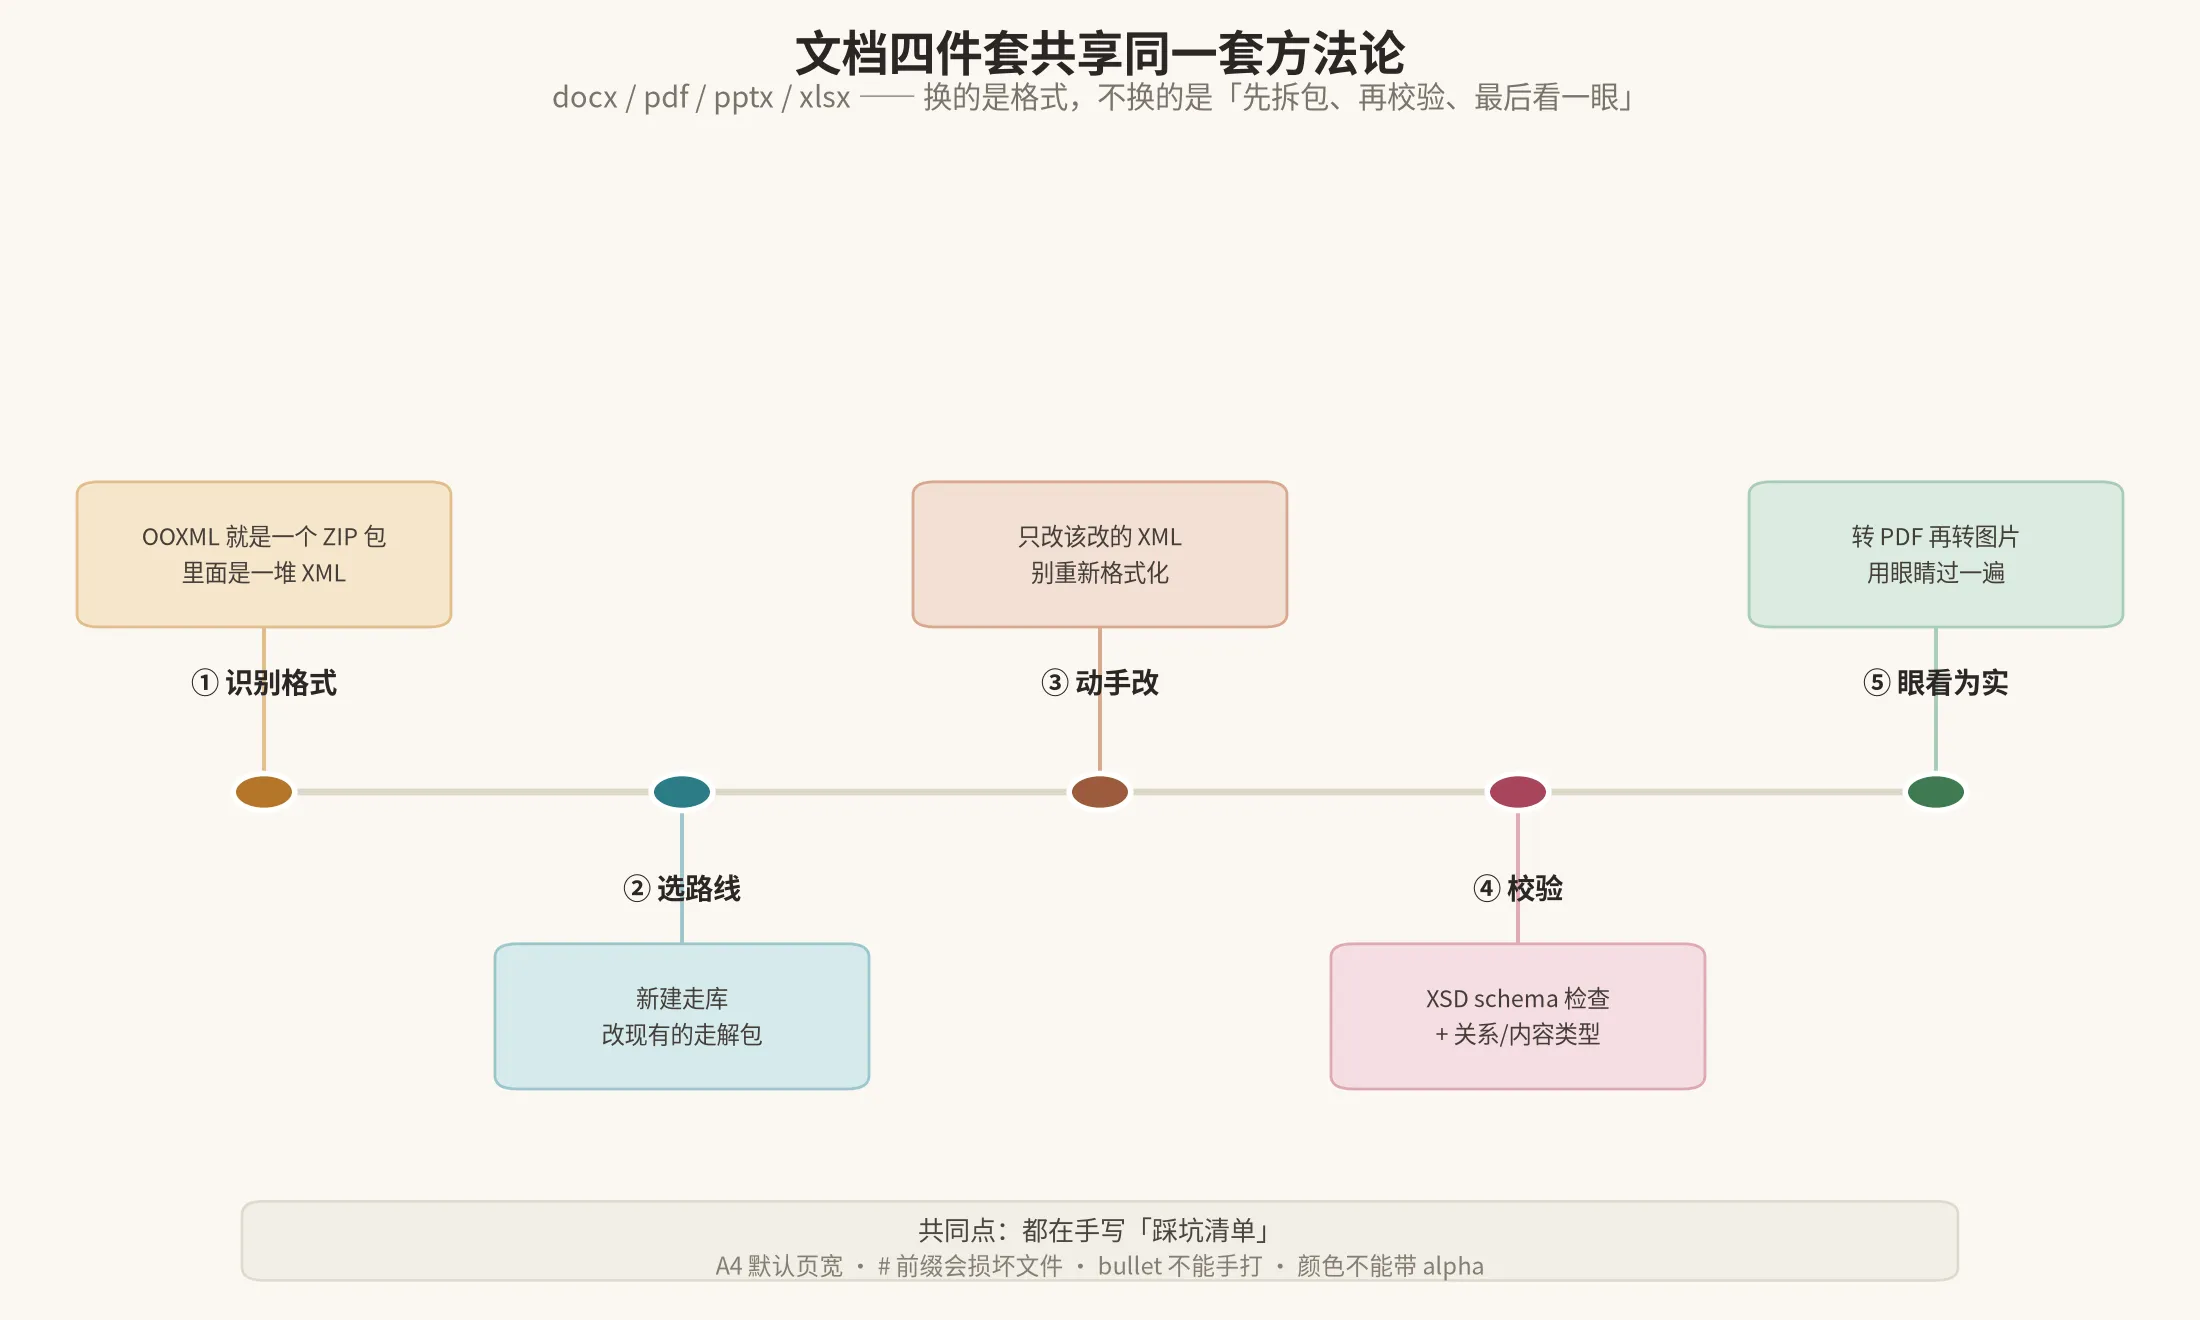
第一步:认清 OOXML 就是个 ZIP 包#
这是所有后续操作的前提。.docx .pptx .xlsx 都是 ZIP 归档,里面装的是一堆 XML。
.docx 里最重要的文件是 word/document.xml。想改内容,就得解包改 XML 再打包回去。
第二步:分清「新建」和「改现有」#
docx 给了一张非常清楚的对照表:
| 任务 | 做法 |
|---|---|
| 新建文档 | 写 docx(npm)脚本 |
| 改现有文档 | unzip → 改 word/document.xml → zip |
| 读取内容 | pandoc -t markdown file.docx |
关键在于:docx-js 打不开已有文件。 所以这是两条完全不同的路,不能混。混了就是「我用库读一下」然后撞墙。
pptx 的对照表结构一模一样,只是库换成 pptxgenjs,读取换成 markitdown。
第三步:只改该改的#
docx 里这句提醒我觉得很重要:
edit unpacked/word/document.xml in place — do NOT reformat or pretty-print
在原地方改,别重新格式化。XML 里那些换行、缩进、属性顺序,只要文件本身是合法的,你动它就可能引入 schema 违规。
配套的 validate.py 做的事就是拿 XSD 去校验,还能 --auto-repair 修一些常见问题。而且它支持 --original 参数做 baseline 对比——这个设计很聪明:如果你是拿一个模板改出来的,模板自己就有 XSD 错误,那不修就无法区分「你的错」和「模板的错」。
第四步:改完必须看一眼#
四个技能都在强调同一件事:验证输出。
docx 的例子:
python scripts/office/soffice.py --headless --convert-to pdf output.docx
pdftoppm -jpeg -r 100 output.pdf page
ls page-*.jpg # 然后用 Read 看这些图转成 PDF,再转成图片,然后用眼睛看。
xlsx 那句「A green recalc proves your formulas evaluate, not that they are right」也出自这一环——机器校验只能保证「不报错」,保证不了「算得对」。
那份「坑清单」才是真货#
每个技能的 SKILL.md 里都有一大段叫 “gotchas” 的清单。我挑几条最反直觉的:
docx:
- 页面尺寸默认是 A4,要 US Letter 得写
page: { size: { width: 12240, height: 15840 } }(DXA,1440 = 1 英寸) - 横向:传竖向的宽高 +
orientation: PageOrientation.LANDSCAPE,docx-js 内部会自己交换 - 表格底纹用
ShadingType.CLEAR,永远不要用SOLID(会渲染成黑色) - 列表绝不能手打
•,要用numbering配置 +LevelFormat.BULLET PageBreak必须包在Paragraph里面- 永远不要用
\n,要用多个Paragraph - 目录(ToC)必须用内置的
HeadingLevel.*,自定义标题样式不设outlineLevel就不会出现在目录里 - 别拿表格当横线用,用段落下边框
pptx:
pres.layout必须在加 slide 之前设置。默认是LAYOUT_16x9= 10 英寸 × 5.625 英寸,不是 13.3 宽。超出边界的坐标不会报错,形状就是不在页面上- 十六进制颜色永远不要带
#,也不要 8 位。color: "FF0000";"#FF0000"和带 alpha 的"00000020"会损坏文件 - 阴影的
offset必须 ≥ 0,负值会损坏文件 letterSpacing会被静默忽略,真正的选项叫charSpacing- 堆叠柱状图的
dataLabelPosition必须是ctr/inEnd/inBase,写outEnd会损坏文件 - 用了
secondaryValAxis的话,valAxes和catAxes两个数组都得给,只给一个 PowerPoint 会丢弃整个图表并报文件损坏 - 不要重排
<p:presentation>的子元素顺序,pptxgenjs 写的位置 PowerPoint 能读,挪一下同一个文件就打不开了
xlsx:
- openpyxl 写公式是写字符串,不带缓存值。不跑
recalc.py的话,所有读缓存值的工具(pandas、data_only=True)读出来全是None recalc.py返回的 JSON 里如果带error键(而不是status),说明什么都没重算errors_found是 exit 0,所以永远别把「退出码为 0」当成「工作簿干净」
这些坑的共同点是:错了不会报错,只会安静地产生一个坏文件。
如果只把这些写进一个「请注意 A4 默认页宽」的提示词,模型大概率记不住、也大概率理解不了「DXA 1440 = 1 英寸」意味着什么。但如果 SKILL.md 的第一屏就是这张清单,每次任务都会重新读一遍——这就是 skill 的价值。
skill-creator:一个技能是怎么被造出来的#
skill-creator 是这个仓库里最有意思的技能,485 行 SKILL.md + 18 个文件,包含 3 个 sub-agent(analyzer / comparator / grader)、6 个脚本和一个 eval 查看器。
它描述的流程是这样的:
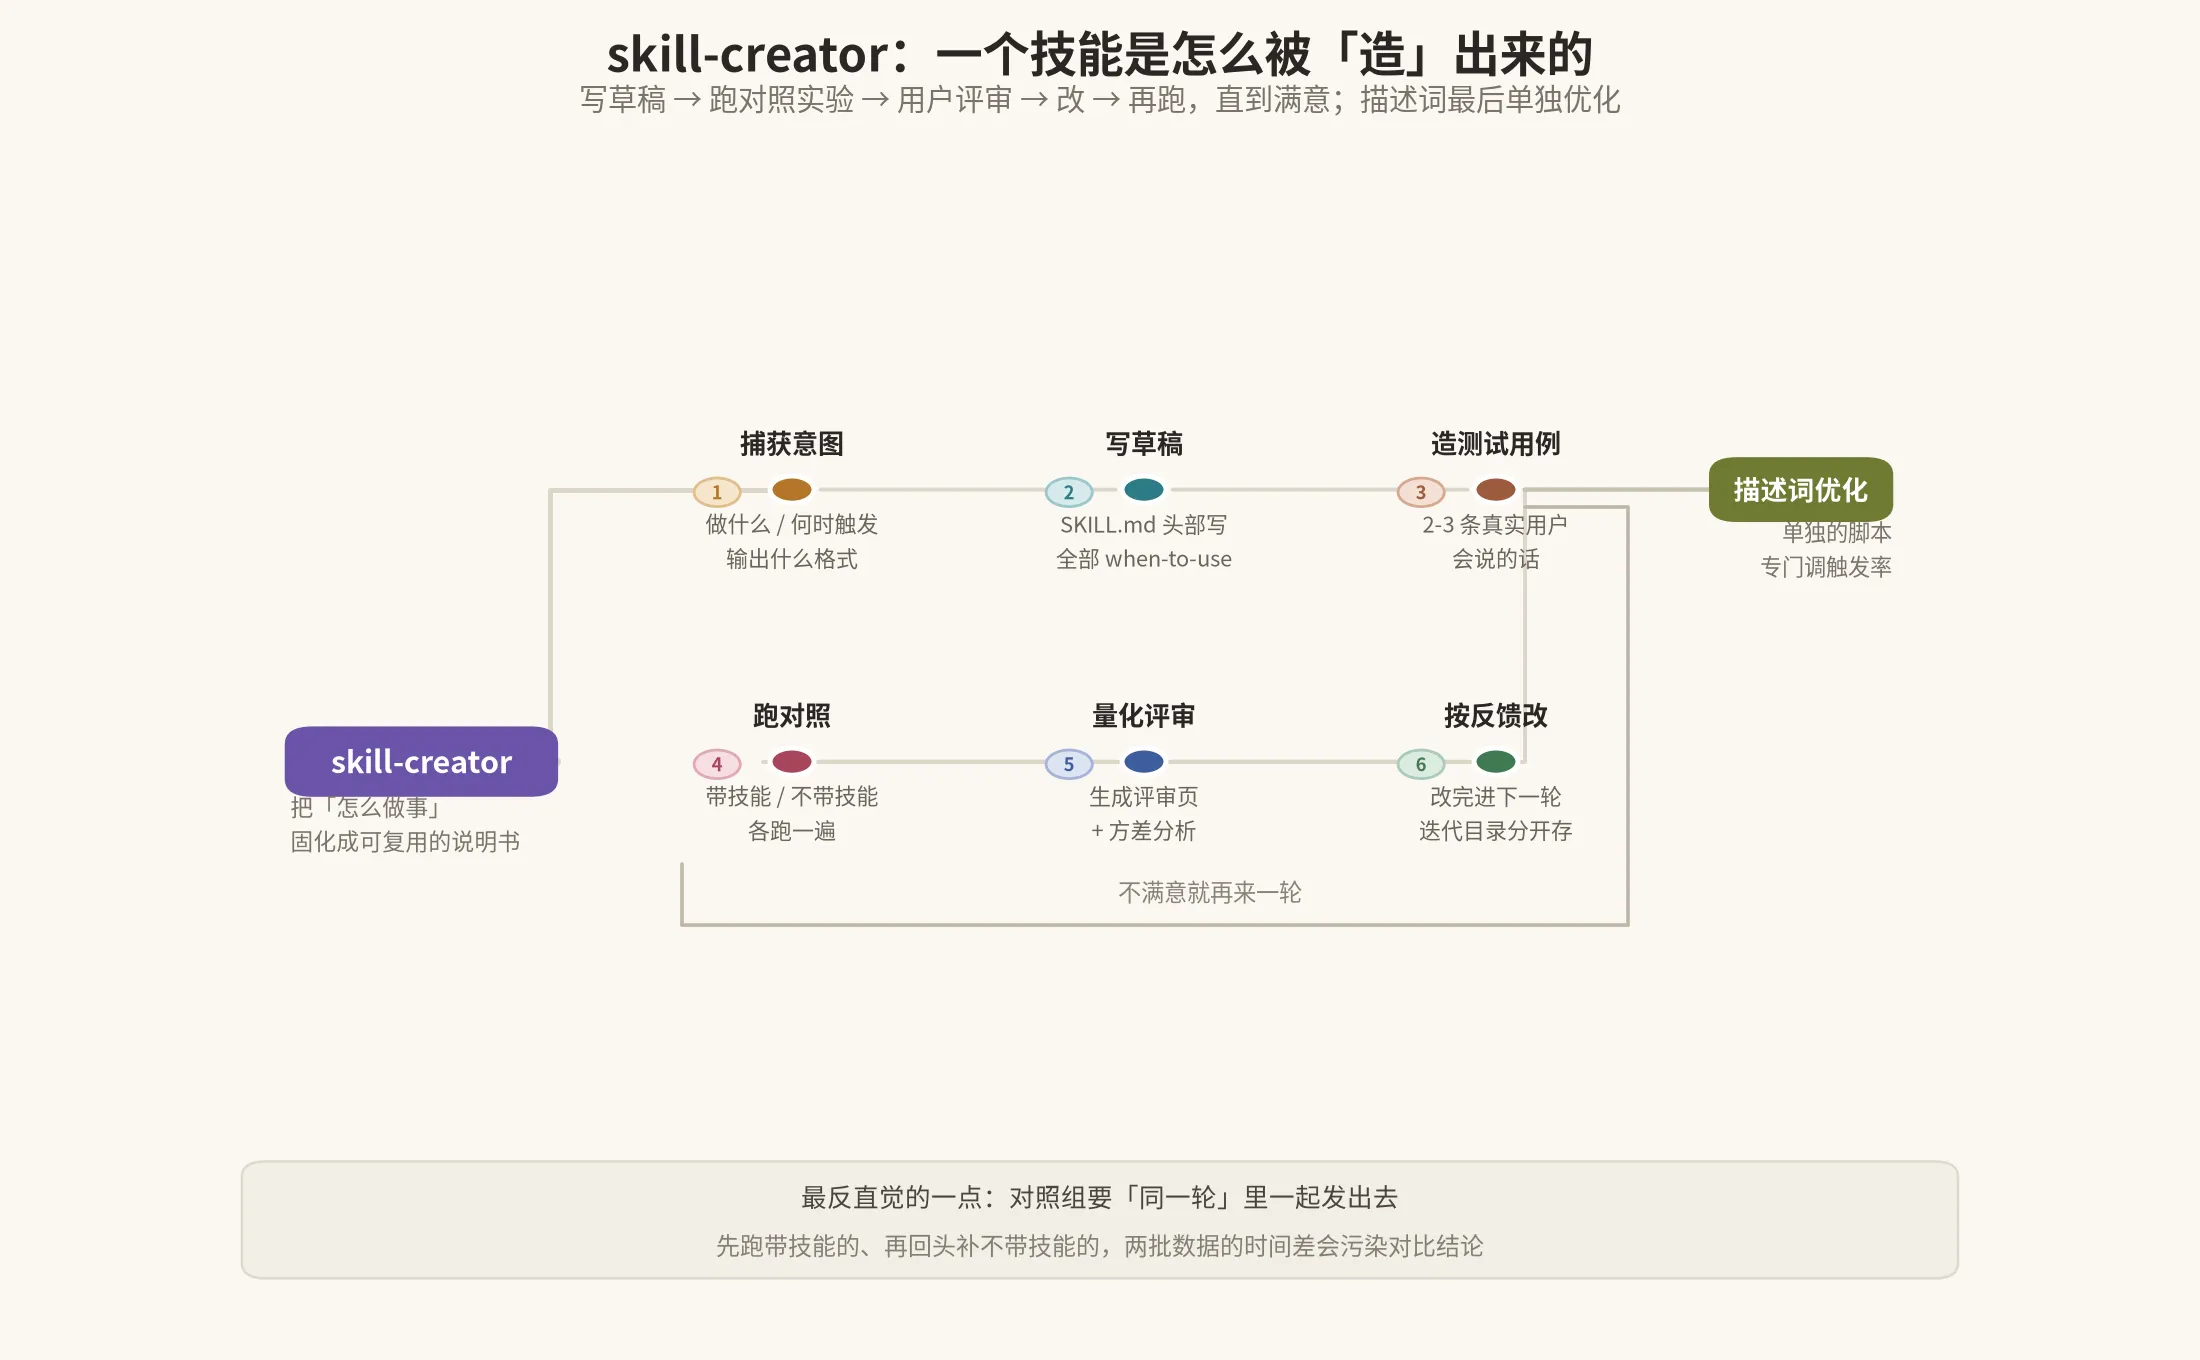
- 捕获意图 — 问清楚三件事:这个技能要让 Claude 能做什么?什么时候触发?输出格式是什么?
- 访谈与调研 — 主动问边界情况、输入输出格式、示例文件、成功标准
- 写 SKILL.md 草稿
- 造 2-3 条测试用例 — 要「真实用户会说的话」
- 跑对照实验 — 带技能 vs 不带技能
- 量化评审 — 生成评审页 + benchmark
- 按反馈改 — 改完进下一轮
有几个设计我觉得特别值得学。
对照组必须「同一轮」一起发#
原文:
For each test case, spawn two subagents in the same turn — one with the skill, one without. This is important: don’t spawn the with-skill runs first and then come back to baselines later.
如果先跑带技能的,过一会儿再回头补不带技能的,这两批数据之间隔了一段完全不同的上下文、不同的模型状态、甚至可能是不同的服务端负载。你没法确定差异是技能带来的,还是时间带来的。
同一轮一起发出去,是对照实验唯一靠谱的做法。 这跟做 A/B 测试要同时开两个组是一个道理。
「改进已有技能」的对照组是旧版本#
这个细节很贴心:如果你是在改一个已经存在的技能,那 baseline 不是「什么都不给」,而是改之前的旧版本。
cp -r <skill-path> <workspace>/skill-snapshot/先给旧版拍个快照,让对照组指向快照。这样才是在比「新版 vs 旧版」,而不是「新版 vs 裸模型」。
token 和耗时也要记#
{
  "total_tokens": 84852,
  "duration_ms": 23332,
  "total_duration_seconds": 23.3
}技能会让模型变准,但通常也会让它变慢、变贵。所以评估不能只看 pass rate,得把 token 和耗时一起纳入比较。
而且 benchmark 报的是 mean ± stddev,不是单个数。因为跑 5 次得到的均值和一个数意义有限,你得知道这个技能本身稳不稳。
描述词优化是独立的一环#
技能写完了,还能单独跑 improve_description.py 去优化触发率。
原因前面讲过:description 是「触发决策」的唯一输入,它的效果跟正文质量是正交的。一个正文写得再好但描述写得保守的技能,实际触发率可能接近零。
两个有意思的边角#
doc-coauthoring:三阶段协作#
doc-coauthoring 是个 375 行的技能,讲怎么跟人一起写文档。它的三阶段设计很清晰:
- Context Gathering — 先问元问题(什么类型的文档?主要读者是谁?读完希望产生什么影响?),然后鼓励用户「倒垃圾」——把背景、讨论记录、为什么不用其他方案、组织政治、时间压力、相关方的顾虑,想到什么说什么,不用整理
- Refinement & Structure — 一节一节来,每节先问要放什么,再头脑风暴 5-20 个选项,用户挑,然后起草,再精修
- Reader Testing — 用一个全新的、没有上下文的 Claude 去读这份文档,抓出盲点
第三个阶段我觉得是这套方法里最值钱的一步。你写文档的时候脑子里全是上下文,你觉得「这个显然能看懂」,是因为你恰好知道那句话的背景。换个空白的模型读一遍,立刻能看出哪些地方缺解释。
它还有一条「Exit condition」的判断:
Sufficient context has been gathered when questions show understanding — when edge cases and trade-offs can be asked about without needing basics explained.
收集够了的标准不是「用户说够了」,而是「你已经能问出只有懂这个领域的人才问得出的问题」。这个标准定得比大多数需求文档都准。
discernment-nudge:在答案后面追加 2-3 个问题#
这是仓库里唯一一个「不产出内容、只产出追问」的技能。
它的触发条件写得很细:答案里包含用户可能据此行动的内容——估算、预测、成本数字、涉及业务/健康/法律/财务的建议、用户会转述出去的事实主张、多步推理、或者一份要拿出去用的文档草稿。
然后在答案后面追加 2-3 个问题,分别指向:
- Checking facts — 这答案里哪些具体说法值得去核一核?跟什么核?
- Questioning reasoning — 哪一步推理用户可能想看到依据?
- Noticing missing context — 答案里假设了什么用户没说的事?
同时它列了一长串「不要用」的场景:trivial how-to、纯教学解释、只是格式转换、正在写代码、创意写作、闲聊,或者用户已经要求过 double-check。
它的存在理由写得很直白:
People often take an AI answer at face value, especially when it’s confidently written and well-structured.
写得自信、结构工整的答案,恰恰是最容易被当成真的。
这个技能我不太确定会不会火,但它背后的判断我完全同意:一个 AI 工具如果只会「回答」,不会「提醒你可能错了」,那它在某些场景下是有害的。
我从这仓库里真正学到的东西#
抛开技术细节,我觉得有三件事是通用的。
一、知识的载体应该是文件夹,不是 prompt#
Prompt 是线性的、无状态的。技能是有结构的、可演进的——一个文件夹里可以放说明、脚本、参考文档、模板,还能带版本、带测试。
而且脚本和 prompt 的可靠性差着一个量级。「记得用 DXA 设宽」是叮嘱,「运行 validate.py --auto-repair」是保证。
二、上下文预算是一种资源调度#
渐进式披露的三层设计,本质上是在回答:哪些信息任何时候都要花,哪些触发时才花,哪些永远不用花(让机器去算)。
这个思路可以直接搬到任何 Agent 系统里。我自己搭的 OpenClaw 里,Skills 机制也是类似的三层:SKILL.md 头部常驻,正文按需加载,scripts 直接执行。
区别在于,Anthropic 明确写出了每一层的体量上限(100 词 / 500 行 / 无上限)。有上限的设计才是设计,没上限的那叫「以后再说」。
三、好的描述词是工程产物,不是文采#
我以前写提示词,总想着把话说得准确、简洁、漂亮。看到 Anthropic 的做法才反应过来——description 的目标不是「描述得准」,而是「在用户 myriad 种说法里都能被匹配上」。
所以他们的做法是穷举关键词、主动加限定语、明确写「even if they don’t explicitly ask for…」。这跟写文章追求简洁是相反的,因为它们的评价标准不一样:文章的读者是「有耐心的读者」,description 的读者是「一个在做匹配算法的模型」。
想自己动手的话#
仓库支持直接当 Claude Code 插件市场:
/plugin marketplace add anthropics/skills然后装具体的插件组:
/plugin install document-skills@anthropic-agent-skills
/plugin install example-skills@anthropic-agent-skills装完直接说人话就能用,比如「用 PDF skill 把这个文件里的表单字段提取出来」。
如果你要自己写一个技能,template/ 虽然空,但 skill-creator 就是最好的模板——它把「一个技能该怎么被造出来」讲得非常细,包括怎么写测试用例、怎么跑对照、怎么用 benchmark 看效果。
顺带说一句,这个仓库的 spec/ 目录虽然被掏空了,但规范还在 agentskills.io 上。规范本身不长,核心就是:一个文件夹,一个带 name 和 description 的 SKILL.md,可选带 scripts / references / assets。
真正难的从来不是格式,是你那份知识到底该怎么组织。
一点观察#
这个仓库最后一条 commit 是 2026 年 10 月,更新 mcp-builder 的 TypeScript SDK v2 指引。也就是说它还在动。
我比较在意的是,文档四件套是 source-available 而不是 Apache 2.0。README 里说得挺坦诚:这四个是「Claude 文档能力的底层实现」,开源出来是作为「复杂技能的参考实现」。
这个分界挺合理——但也提醒了一件事:开源仓库里的 Apache 部分,才是你可以直接拿去用的部分。
另外整份 README 最后有一句免责声明:
These skills are provided for demonstration and educational purposes only. While some of these capabilities may be available in Claude, the implementations and behaviors you receive from Claude may differ from what is shown in these skills.
实际效果可能跟这里写的不一样。这话听着像套话,但在「skill 是一堆 prompt」这个前提下,这话其实很实在——同样一份 SKILL.md,不同的模型版本、不同的上下文,执行结果确实可能差很远。
所以真要用,还是老老实实跑一遍 skill-creator 的那套 eval 流程,自己测一遍。