深入解析 ArtCraft:一个 73MB 仓库,把 62 个 AI 模型收进同一个给艺术家的 IDE
💬 评论storytold/artcraft 是 Tauri 桌面端,双壳共用一套 API 客户端,Rust router 用 5 文件模型装下 62 个 AI 模型,Draft→Request 异步 finalize 解决参考图上传。深度拆解 192 个 Tauri 命令背后的工程取舍。
ArtCraft:73MB 仓库装下 62 个 AI 模型,还做了两个壳#
最近 GitHub Trending 冒出来一个项目叫 ArtCraft,自封 “The IDE for Artists”。73MB 的仓库,Rust + TypeScript 双线,主壳是 Tauri 桌面端,旁边还藏着个纯 egui 的备用壳。我一开始也以为又是某个”模型聚合站”——结果翻完代码,发现这个项目把”多 provider 协调”这件事做到了工业级,有几个设计真的值得记一下。
先说这是个什么东西#
ArtCraft 是 Storyteld 公司做的桌面应用,目标用户是搞 AI 影像创作的艺术家。它的核心主张不是”我有更多模型”,而是”我在一个 IDE 里把所有模型、3D 场景、相机控制、姿势编辑、合成工具装在一起”。
仓库里 73MB,crates/ 下 24 个 workspace 成员,frontend/ 是个 Nx monorepo,光 TypeScript/TSX 就 206K 行。换句话说——前端是大头,Rust 是胶水。这个比例和很多”硬核 Rust 项目”很不一样,值得先记一下。
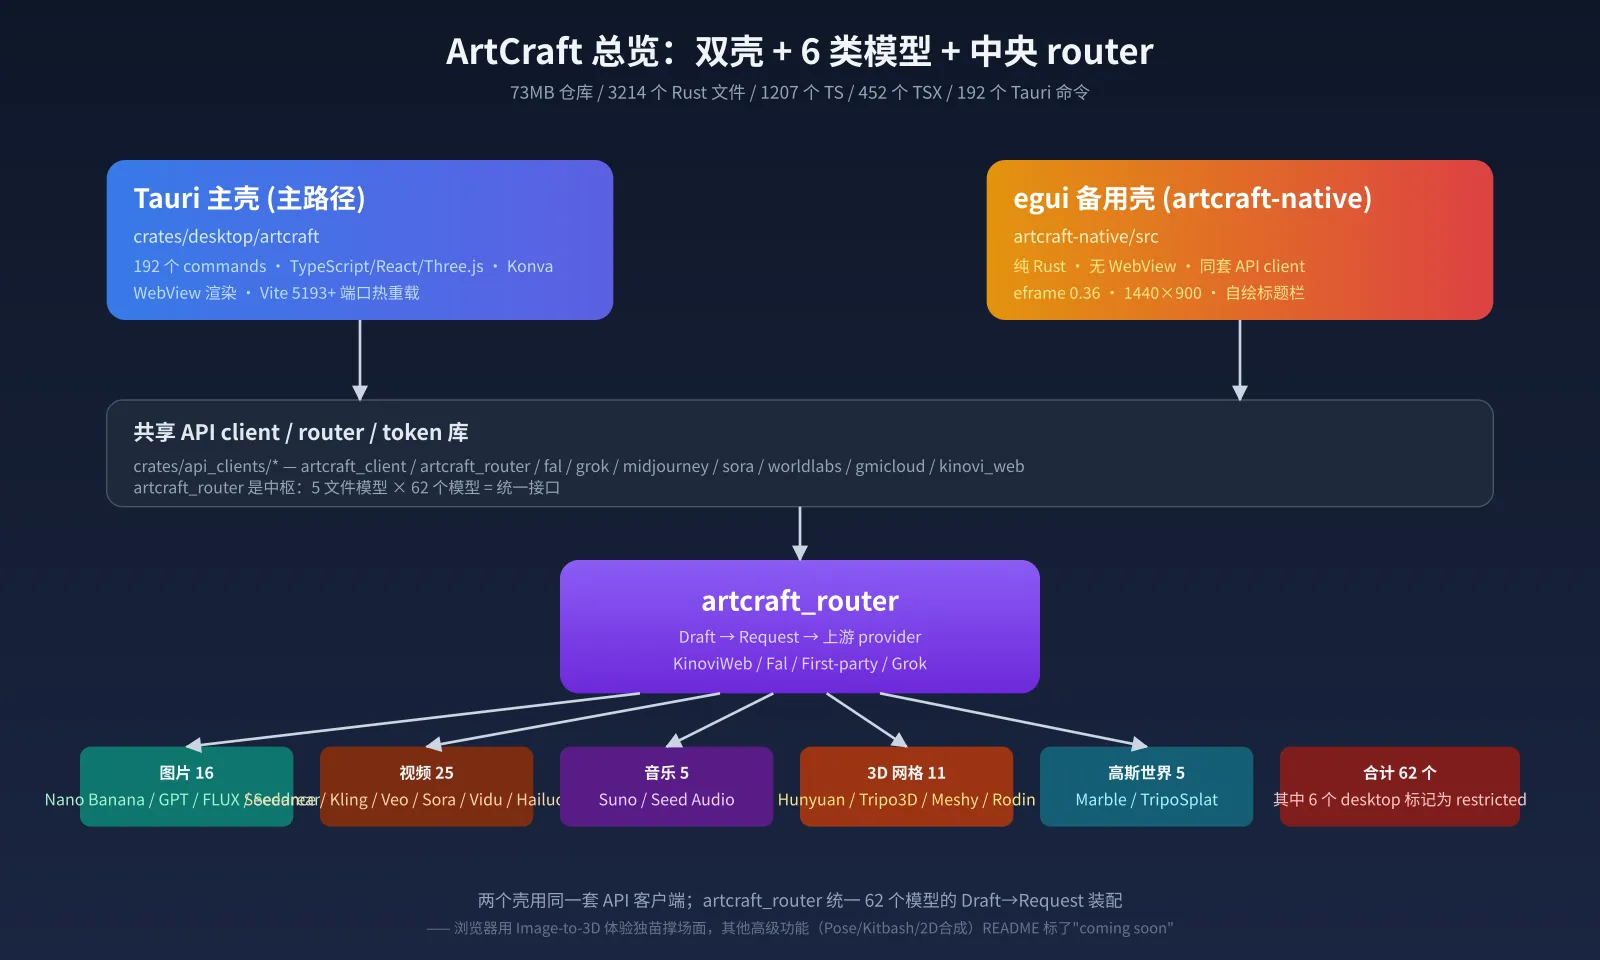
数清楚一共有 62 个 AI 模型接入,README 列得明明白白:16 个图片(Nano Banana / GPT Image / FLUX / Seedream 那一串)、25 个视频(Seedance / Kling / Veo / Sora / Vidu / MiniMax / Flux)、5 个音乐(Suno / Seed Audio)、11 个 3D 网格(Hunyuan 3D / Tripo3D / Meshy / Rodin)、5 个高斯世界(Marble / TripoSplat)。**注意:**其中 6 个标了”‡ Restricted model; not currently available in the desktop app”——README 老实告诉你桌面端有些模型不可用,这种透明度我喜欢。
双壳设计:Tauri 主 + egui 备#
仓库最让我意外的,是有两个独立的桌面壳,但共享同一套 API 客户端。
crates/desktop/artcraft/ 是 Tauri 主壳,这是正式产品路径。192 个 Tauri commands,前端 24 个 page(从 PageImage 到 PageVideoEditor 到 PageStoryboard),UI 用 React + Vite + Three.js + Konva。WebView 渲染,搭配 HMR 热重载,Vite 默认绑 5193 端口自动找可用。
artcraft-native/ 是 egui 备用壳,纯 Rust 无 WebView。Cargo.toml 里能看到它复用了同一套 workspace:artcraft_api_defs、artcraft_client、artcraft_router、fal_client、midjourney_client、tokens、cookie_store_wrapper——全是 Tauri 主壳用的 crate。
这个设计有意思在哪?它意味着API 客户端层和 UI 层完全解耦。如果哪天 WebView 在某个 Linux 发行版跑崩了,直接换 egui 启动,业务逻辑零修改。artcraft-native/src/main.rs 的 viewport 配置很值得看:1440×900 默认、最小 960×640、macOS 用 with_fullsize_content_view 自绘标题栏但保留红绿灯,其他平台用 with_decorations(false) 完全无边框——UI 层要操心的事全在 egui 里。
但这个 egui 壳不是”完整版”。我点开 artcraft-native/src/pages/,只有 create_image.rs / create_video.rs / create_audio.rs / other.rs / toolbar.rs / common.rs 这 6 个页面,而且是 MVP——README 没把它当作正式产品来宣传。我猜它的真实用途是应急逃生舱:WebView 在某个用户机器上起不来、或者 Storyteld 内部想用纯终端环境做 CI 验证时,还能跑。
192 个 Tauri 命令是怎么分桶的#
Tauri 项目最怕的就是命令堆一坨,ArtCraft 的组织方式直接写进了 crates/AGENTS.md:
Each Tauri command belongs in its own file module, named after the command.
我数了一下,crates/desktop/artcraft/src/services/ 下五大子目录:
storyteller/15 个 — 登录桥、密码登录、订阅、Stripe checkout/客户门户sora/4 个 — OpenAI Sora 1/2/Pro、GPT Image 1worldlabs/4 个 — Marble Gaussian splats,API + consumer 双 clientgrok/3 个 — Grok Imagine、Grok Videomidjourney/3 个 — 通过 KinoviWeb 中转 v7/v7niji/v8
剩下约 165 个全在 core/commands/ 下,按业务拆:app_preferences / cost_estimate(image/video/audio/mesh/splat 五个) / generate::* / enqueue(bg_removal/3Dobj/Gaussian) / providers(list/set/clear,带一个 deprecated 排序) / task_queue / download / media_files / 几个单点命令(flip_image / platform_info / load_without_cors)。
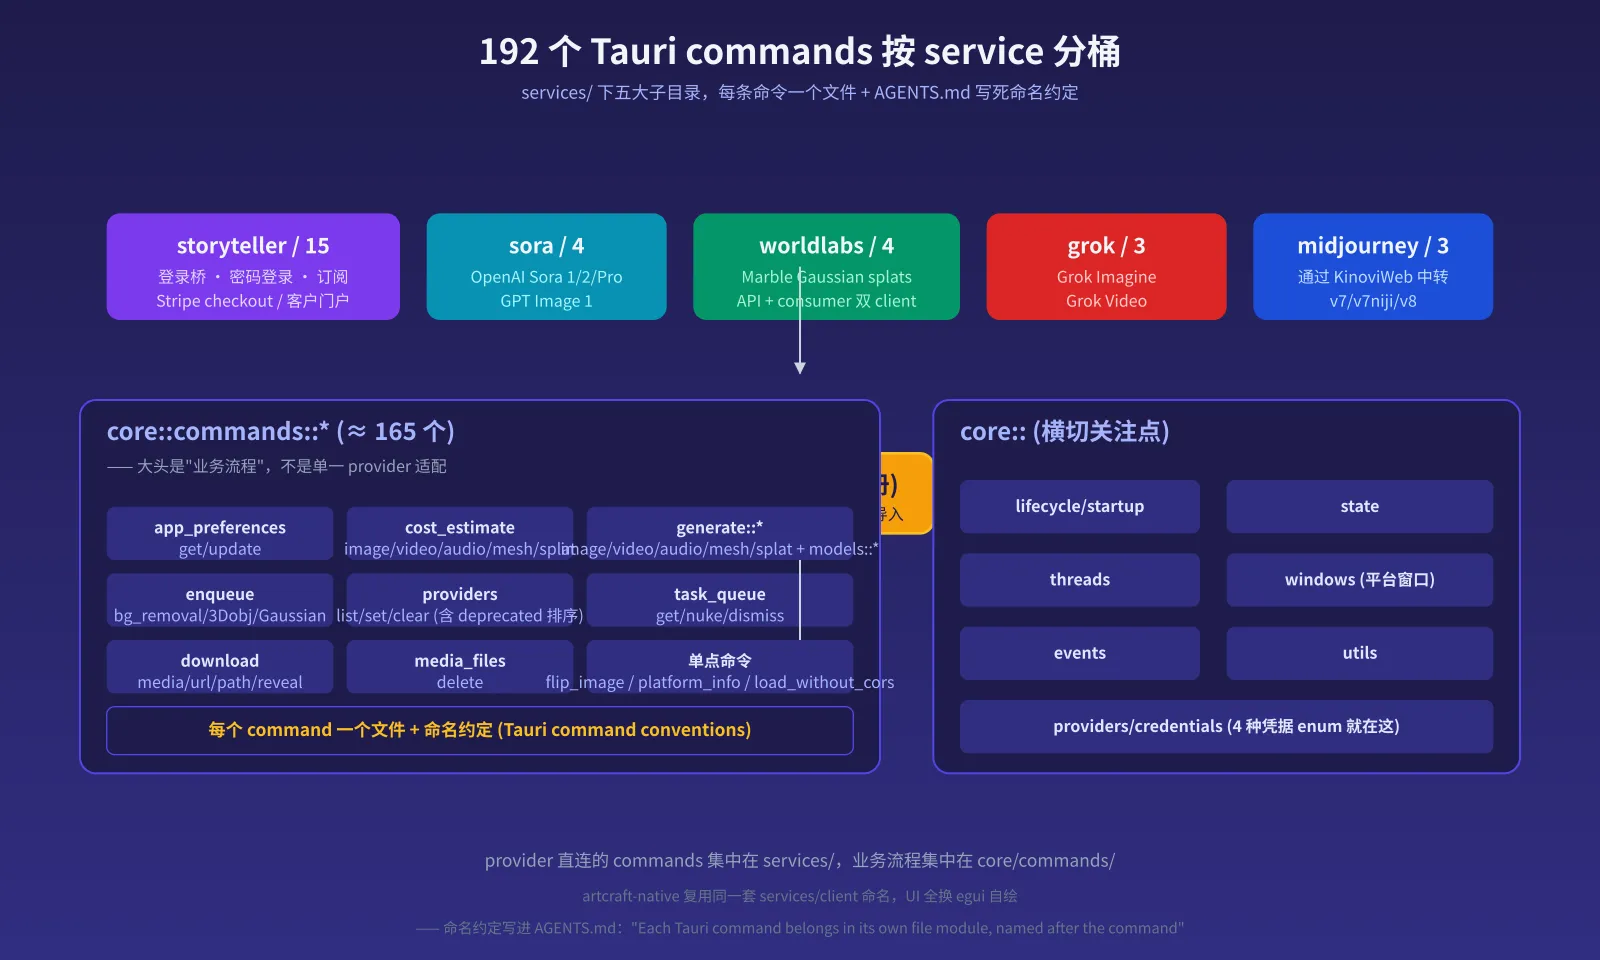
这种”provider 直连 vs 业务流程”两分法,带来一个直接好处:以后加新 provider(README 列了 Kling / Google / Runway / Luma),只需要在 services/ 加新目录,不动 core/commands/。 把稳定的东西和易变的东西物理隔离,这是分桶的真正价值。
核心设计 1:router 的 5 文件模型#
ArtCraft 怎么把 62 个模型的差异消解掉?答案是 crates/api_clients/artcraft/artcraft_router/,每个模型拆 5 个文件,目录结构像这样(以 Seedream 5.0 Pro via Kinovi 为例):
generate_image/providers/kinovi/seedream_5p0_pro/
├── request.rs    # 请求体 struct + 直接调上游的最小函数
├── build.rs      # 从 RouterRequest 装出 DraftState 的工厂
├── draft.rs      # DraftState::to_request() 异步 finalize
├── cost.rs       # CostState::estimate_cost() 价格预估
└── mod.rs # pub mod build; pub mod cost; pub mod draft; pub mod request;这 5 个文件不是随便拆的,每一个都在解决一个具体问题。
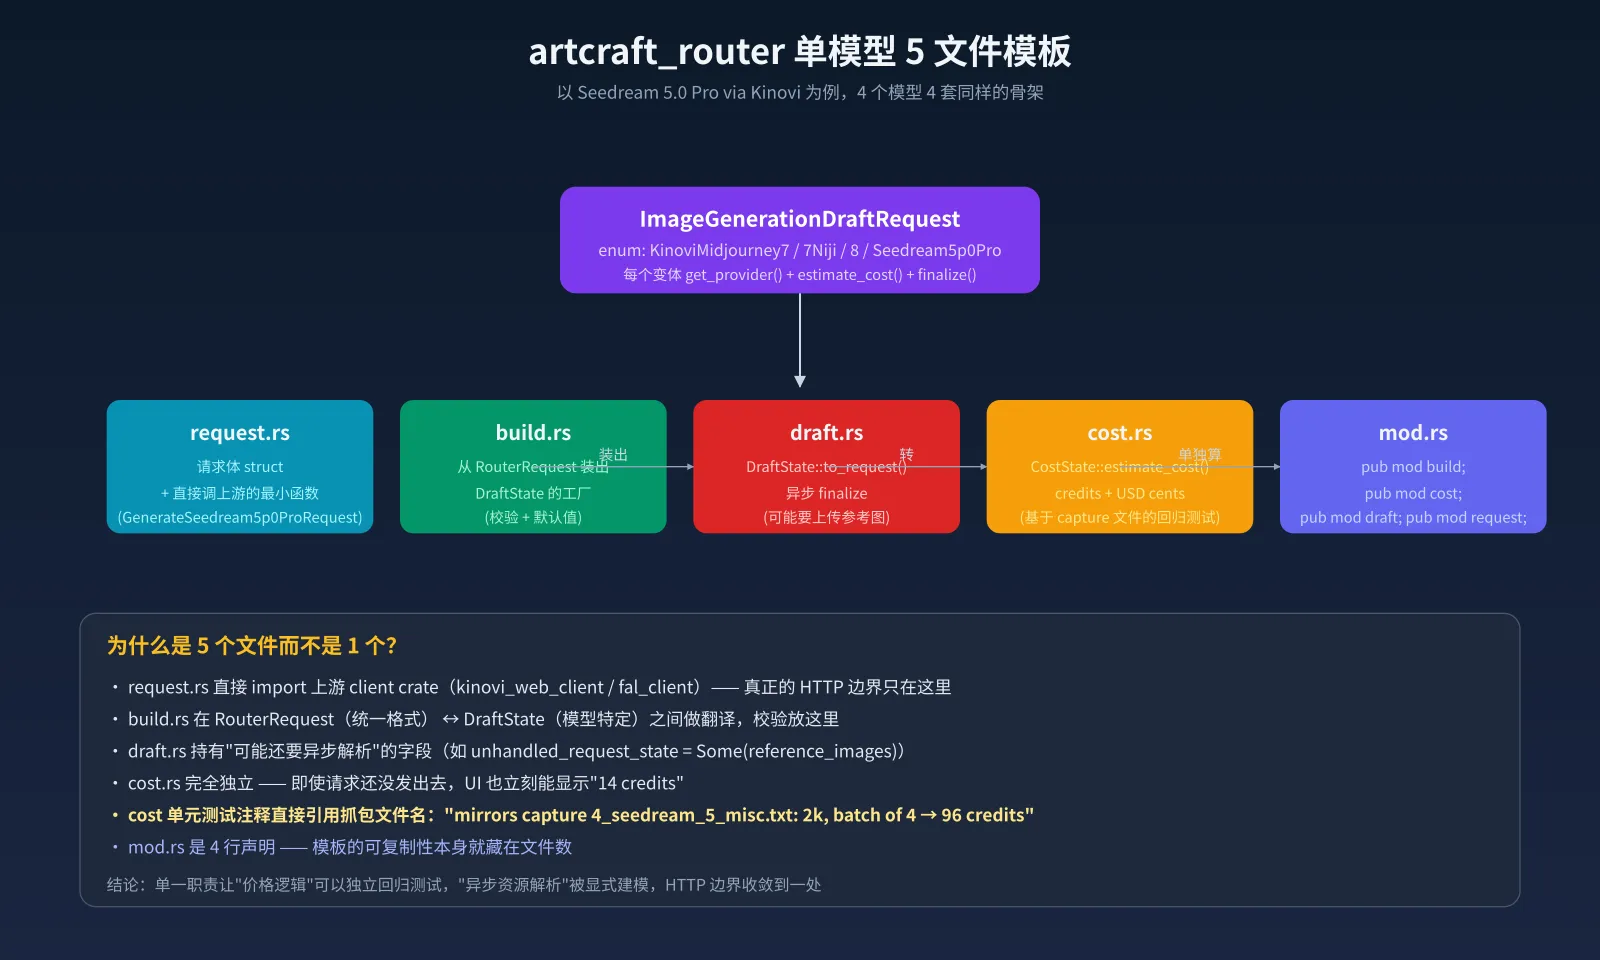
request.rs 是HTTP 边界——直接 import 上游 client crate(kinovi_web_client::generate::image::generate_seedream_5p0_pro::GenerateSeedream5p0ProRequest),所有要发到上游的字段都在这里定型。整个 ArtCraft 里就这一处直接碰上游的 wire format。
build.rs 是翻译器——从统一的 RouterRequest(所有模型共享的请求形态)装出模型特定的 DraftState,做参数校验和默认值填充。
draft.rs 是异步持有器——DraftState 里有这种字段:
pub unhandled_request_state: Option<KinoviSeedream5p0ProRemainingItems>,
pub struct KinoviSeedream5p0ProRemainingItems {
  pub reference_images: Option<ImageListRef>,
}翻译成人话:用户传的参考图可能是本地文件,需要先上传到 Kinovi CDN 拿 URL 才能发出去。 这个上传动作是异步的,所以”未解析的资源”被显式塞在 unhandled_request_state 里,等 to_request() 真正调用时才解析。
cost.rs 是独立的估价员——它完全不依赖网络,只根据 resolution + batch_count 算 credits 和 USD cents。
最有意思的是 cost.rs 的单元测试。Seedream 那个文件里我看到这样的测试:
/// Mirrors capture 4_seedream_5_misc.txt: 2k, batch of 4 → 96 credits.
#[test]
fn four_2k_images_is_ninetysix_credits() {
  let cost = KinoviSeedream5p0ProCostState {
    resolution: KinoviSeedream5p0ProResolution::TwoK,
    batch_count: KinoviSeedream5p0ProBatchCount::Four,
  }.estimate_cost();
  assert_eq!(cost.cost_in_credits, Some(96));
  assert_eq!(cost.cost_in_usd_cents, Some(40)); // 9600/243 = 39.51 -> rounds UP
}“mirrors capture 4_seedream_5_misc.txt”——这是把人工抓包数据当回归基线。 上游计费规则变了?改了 capture 文件、重跑测试、不用看上游 changelog 也能立刻发现价格对不上。这种”人工 capture + 注释引用 + 单元测试”的模式,我在生产代码里很少见,通常只在金融或计费系统里看到。
mod.rs 就 4 行声明——但它本身就是模板可复制性的证据。加一个新模型时,先复制整个目录、改 5 个文件名里的模型名,5 个文件骨架照着填就行,这种”用文件数表达架构”的做法对新人很友好。
核心设计 2:Draft → Request 异步 finalize 链路#
刚才说”未解析的资源”在 draft.rs 里异步解析,展开看一下完整链路。用户在前端点”生成”,到图片真正发出去,中间发生了什么?
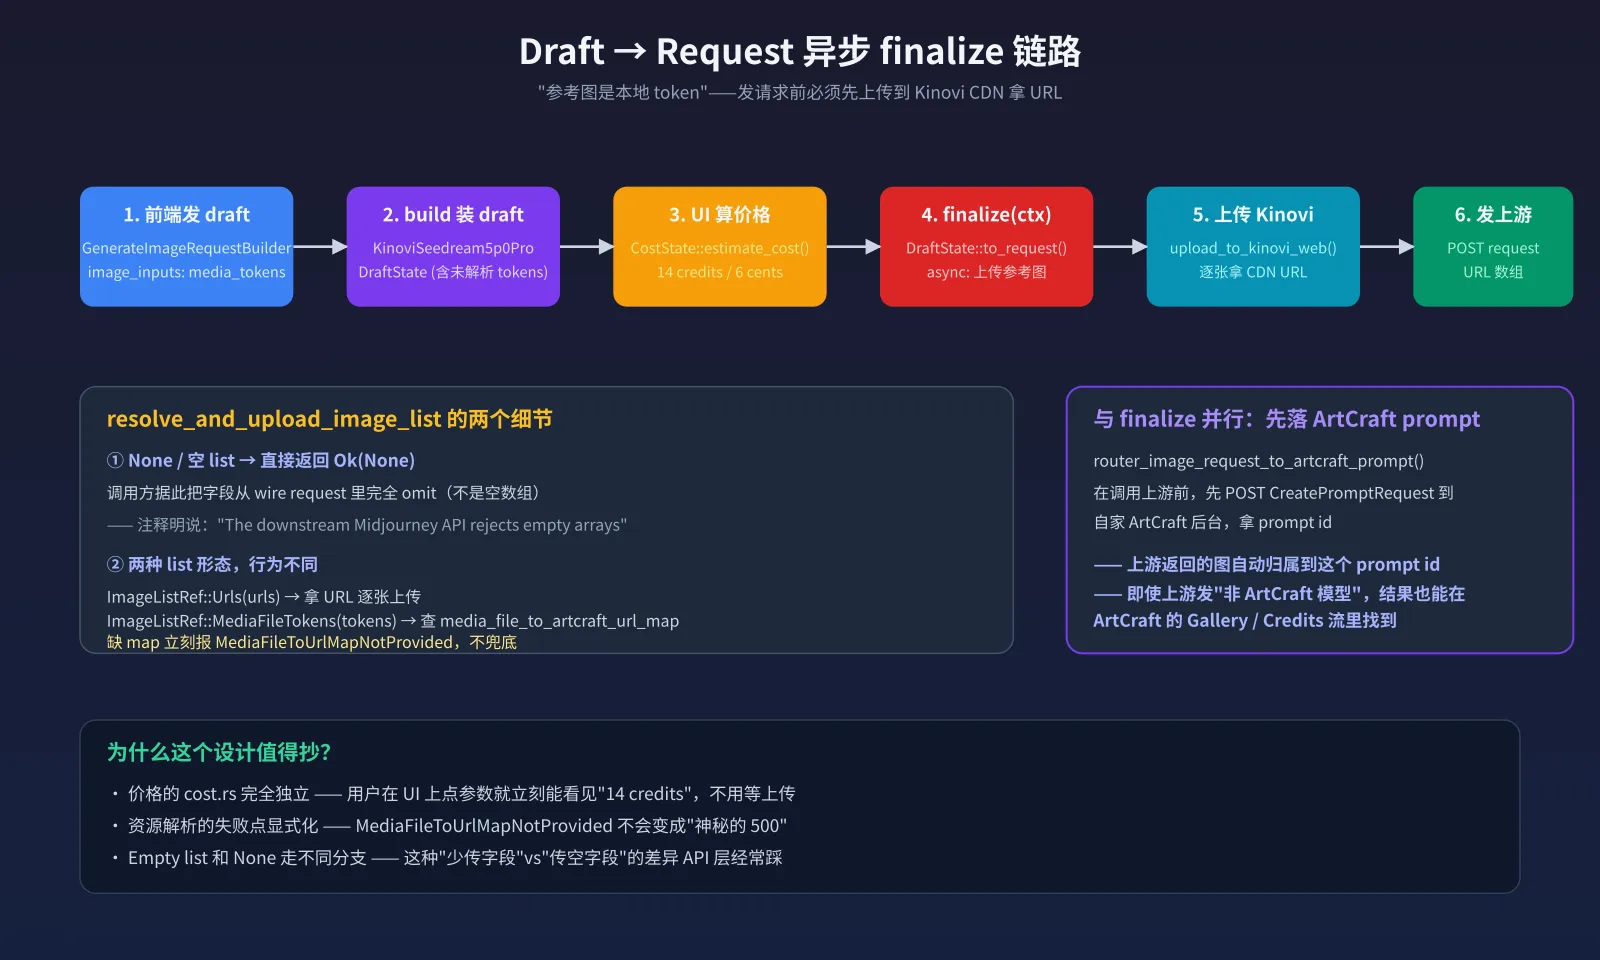
整个流程分 6 步:
- 前端发 draft ——
GenerateImageRequestBuilder携带image_inputs: media_tokens发出 - build 装 draft ——
build.rs把RouterRequest装成KinoviSeedream5p0ProDraftState,此时 reference images 还是 token - UI 算价格 ——
cost.rs完全独立地算出 14 credits / 6 cents(2k 1 张图),这一刻还没上传参考图 - finalize(ctx) —— 用户点确认,
DraftState::to_request(&draft_context).await被调用 - 上传 Kinovi ——
resolve_and_upload_image_list逐张调upload_to_kinovi_web,把 token → CDN URL - 发上游 —— 拿 URL 数组 POST 给 Kinovi,得到 task id
这条链路里,resolve_and_upload_image_list 写得特别小心(在 generate_image/providers/kinovi/resolve.rs):
pub(crate) async fn resolve_and_upload_image_list(
  session: &KinoviWebSession,
  list: Option<ImageListRef>,
  maybe_map: Option<&HashMap<MediaFileToken, String>>,
) -> Result<Option<Vec<String>>, ArtcraftRouterError> {
  let source_urls = match list {
    None => return Ok(None),
    Some(ImageListRef::Urls(urls)) if urls.is_empty() => return Ok(None),
    Some(ImageListRef::Urls(urls)) => urls,
    Some(ImageListRef::MediaFileTokens(tokens)) if tokens.is_empty() => return Ok(None),
    Some(ImageListRef::MediaFileTokens(tokens)) => resolve_tokens(maybe_map, &tokens)?,
  };
  // ...
}两个细节是真正的设计点:
① None / 空 list → 直接返回 Ok(None),不是 Ok(Some(vec![]))。 调用方据此把字段从 wire request 里完全 omit。函数注释明说原因:“The downstream Midjourney API rejects empty arrays”——空数组和”没传字段”在很多 HTTP API 里语义不同,这种细节不显式建模就一定踩坑。
② 两种 list 形态走不同分支,缺 map 立刻报错。 ImageListRef::Urls 直接用,ImageListRef::MediaFileTokens 必须查 media_file_to_artcraft_url_map,缺这个 map 就报 MediaFileToUrlMapNotProvided,不兜底、不 silent 失败。这种”资源未准备好”显式报错的做法,在异步系统里特别重要。
把价格独立出来是这条链路的真正亮点——用户在 UI 上调参数时,cost.rs 立刻就能反馈”14 credits”,不用等任何上传完成。业务体验和资源准备解耦,这是后端架构对前端 UX 的直接支撑。
核心设计 3:Prompt 双层归属#
62 个模型里,大部分不是 ArtCraft 自研的——Seedream 是字节的,Kling 是快手的,Veo 是 Google 的,等等。用户用 ArtCraft 桌面端跑这些模型,结果归属怎么处理?
router_image_request_to_artcraft_prompt 这个函数就是答案。它在做”去上游之前先在自家落库”:
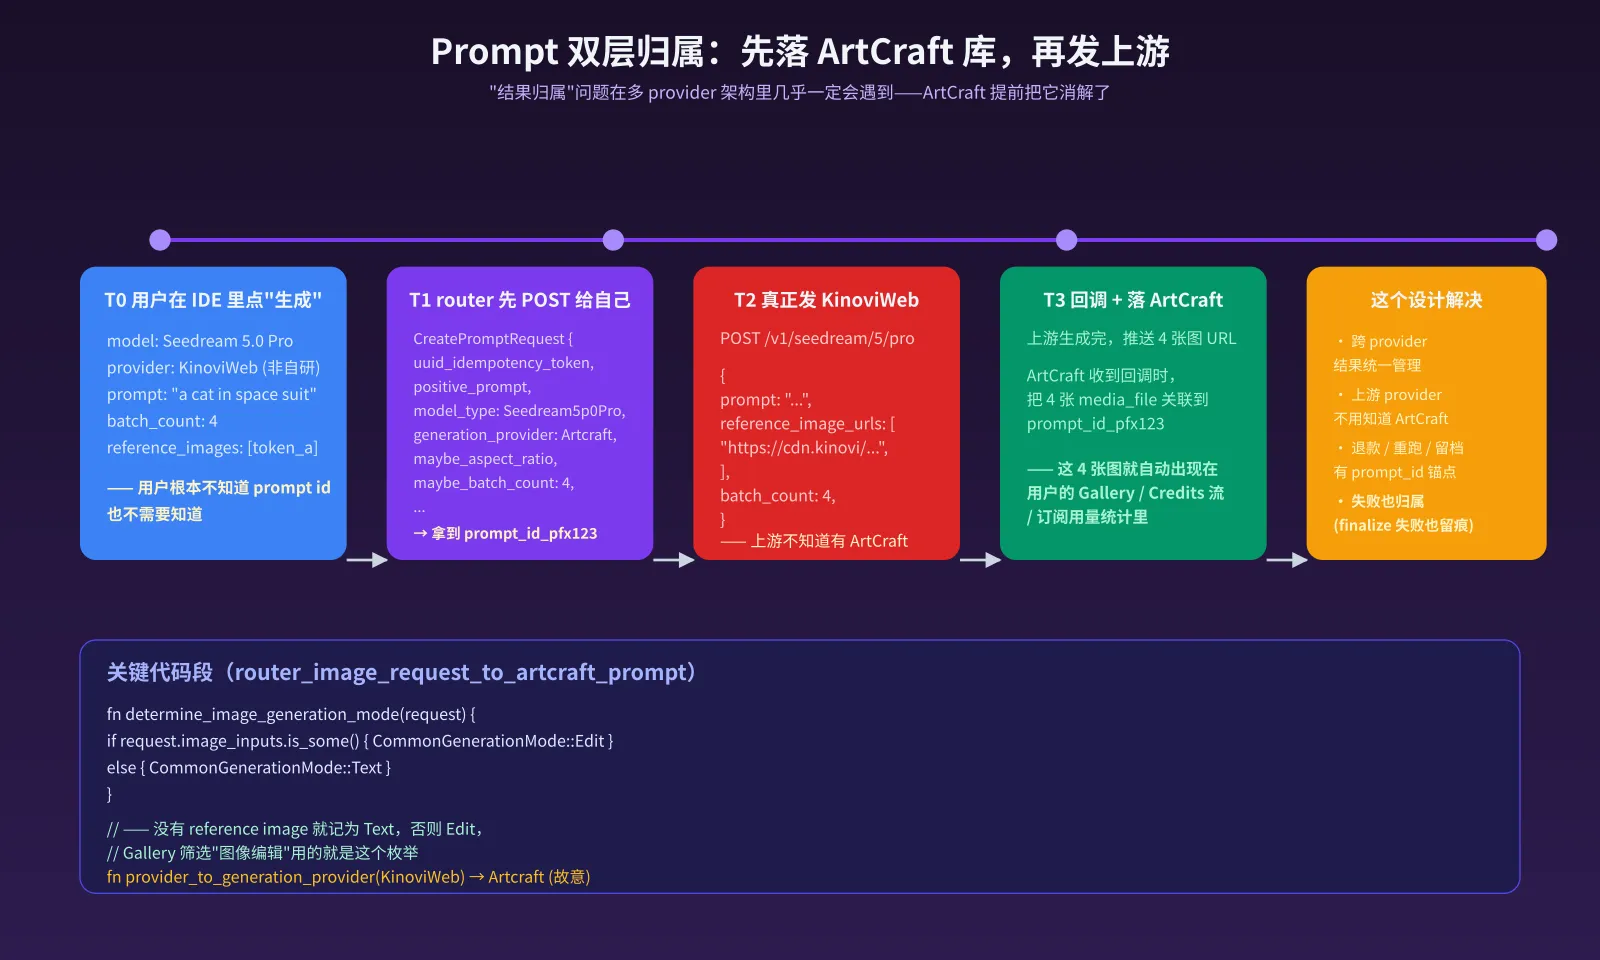
四个时间点:
- T0 用户点生成 —— 他不知道也不关心 prompt_id
- T1 router 先 POST 给自己 ——
CreatePromptRequest落到 ArtCraft 后台,带uuid_idempotency_token(防重复)、positive_prompt、model_type、generation_provider: Some(Artcraft)、可选的aspect_ratio/resolution/batch_count等 - T2 真正发上游 —— KinoviWeb / Midjourney / Fal 收到的是普通的 HTTP POST,完全不知道有 ArtCraft
- T3 上游回调 + 落库 —— 上游推 4 张图 URL 回来,ArtCraft 收到回调时把这 4 张 media_file 关联到 T1 拿到的 prompt_id
这套设计带来的好处是跨 provider 统一管理。即使你跑的是 KinoviWeb 中转的 Midjourney v8(非自研),这 4 张图也会自动出现在你的 ArtCraft Gallery / Credits 流 / 订阅用量统计里。
更妙的是 determine_image_generation_mode 这个小函数:
fn determine_image_generation_mode(request) {
  if request.image_inputs.is_some() { CommonGenerationMode::Edit }
  else { CommonGenerationMode::Text }
}—— 没 reference image 记为 Text,有 reference image 记为 Edit。Gallery 里”图像编辑”和”文生图”的筛选开关,就是基于这个枚举做的。模型在 wire 层是 62 个,但在 ArtCraft 自己的数据模型里只有”Text vs Edit”两种模式——这种”对外多、对内少”的归一化,是后端抽象能力的体现。
还有一处细节:provider_to_generation_provider(KinoviWeb) → Artcraft(故意)。README 列了 6 个 provider,ArtCraft 把非自研的全归到自己的 Artcraft 桶里——因为对终端用户来说,他不关心这图是 KinoviWeb 跑的还是 ArtCraft 自家 backend 跑的,他在意的是”我花的是 ArtCraft credits,图也存在 ArtCraft Gallery 里”。provider 在用户视角被故意压平了。
核心设计 4:Provider 凭据 4 种类型 + 6 位前缀 redact#
6 个 provider 的凭据,ArtCraft 用一个 enum 收口(core/providers/credentials/):
const ALL_KEYS: &[ProviderCredentialKey] = &[
  ProviderCredentialKey::FalApiKey,
  ProviderCredentialKey::ReplicateApiKey,
  ProviderCredentialKey::GrokWebLogin,
  ProviderCredentialKey::HiggsfieldWebLogin,
  ProviderCredentialKey::MidjourneyLogin,
  ProviderCredentialKey::RunwayWebLogin,
];新增 provider 时只需要在这里加一行,注释直接写:“Add new ones here as providers are added”。
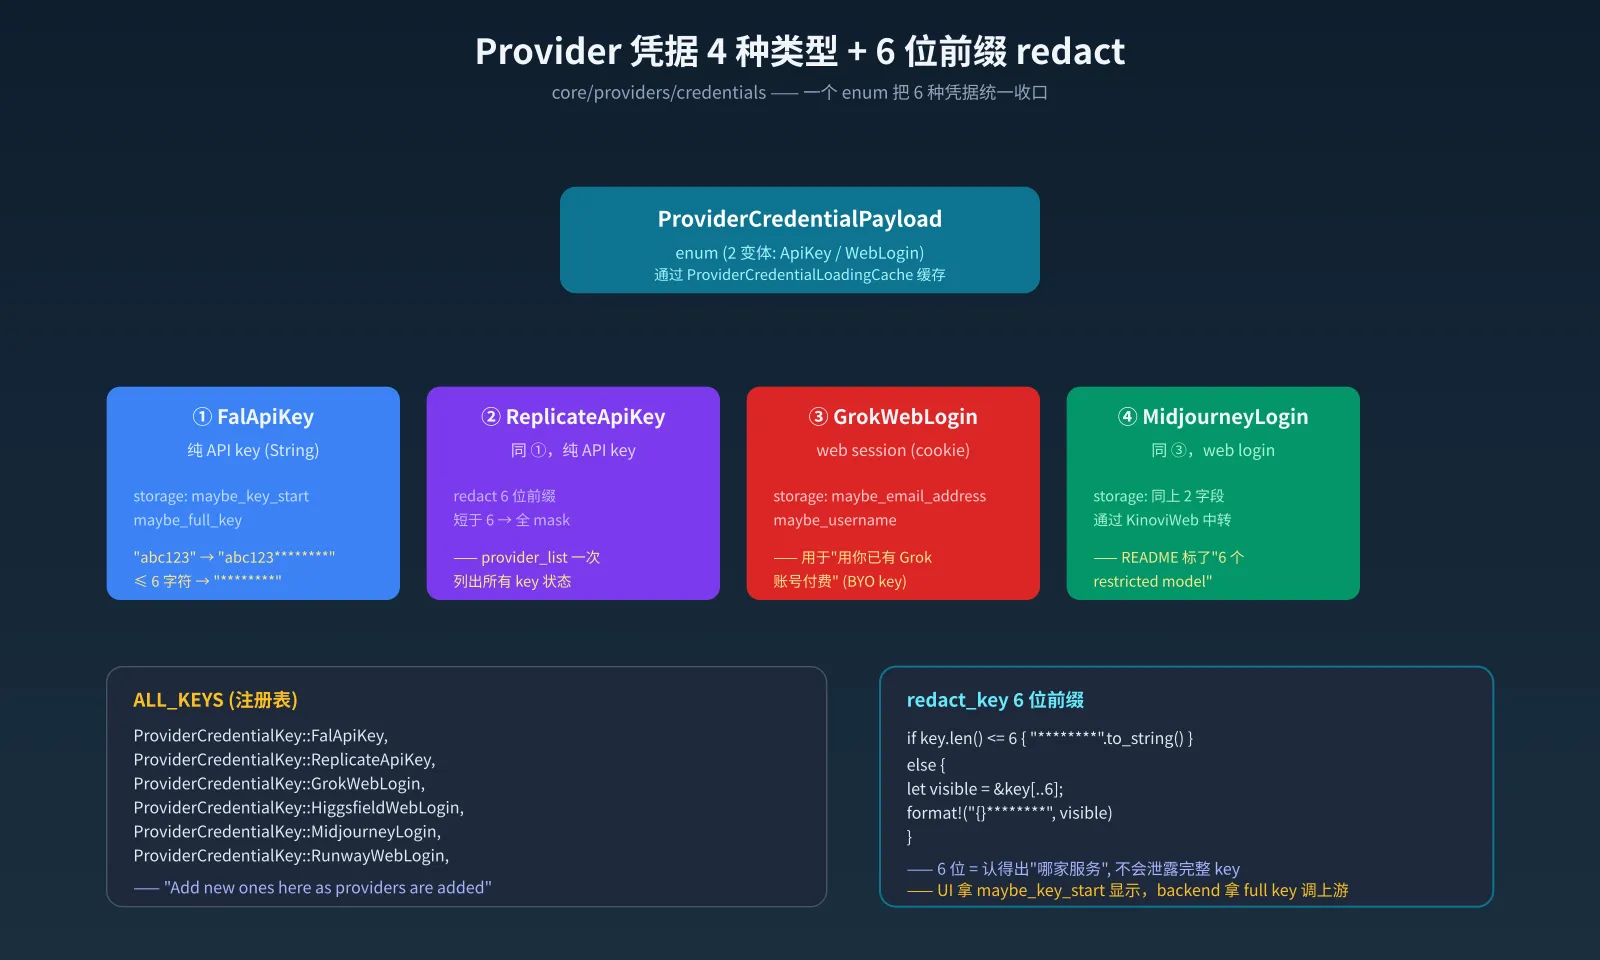
实际存储用 ProviderCredentialPayload enum,分两种形态:
- ApiKey —— 纯字符串,对应 Fal / Replicate
- WebLogin —— 带
email_address+username,对应 Grok / Higgsfield / Midjourney / Runway(允许”用你已有 X 账号付费”)
provider_list_command 把凭据状态返回给前端时,会做 redact_key:
const REDACTED_KEY_VISIBLE_CHARS: usize = 6;

fn redact_key(key: &str) -> String {
  if key.len() <= REDACTED_KEY_VISIBLE_CHARS {
    "********".to_string()
  } else {
    let visible = &key[..REDACTED_KEY_VISIBLE_CHARS];
    format!("{}********", visible)
  }
}6 位前缀 = 认得出”哪家服务”,不泄露完整 key。 比如 fal_abc123def456... 显示成 fal_ab********,用户能确认”这是我配的 Fal 那个 key”,又不会把完整 key 暴露给任何抓前端日志的人。
返回结构也设计得很讲究:
pub struct ProviderCredentialDetails {
  pub maybe_key_start: Option<String>,   // 给 UI 显示 "fal_ab********"
  pub maybe_full_key: Option<String>,    // 后端需要时可用,前端通常拿不到
  pub maybe_email_address: Option<String>, // web login 用
  pub maybe_username: Option<String>,
}—— UI 拿 maybe_key_start 显示,backend 拿 full key 调上游,前端的 IPC payload 跟后端的真实凭据严格区分。 这是”redact 在展示层做,不在存储层做”的标准做法,简单但很多人写不出来。
一些不太一样的观察#
写了这么多好的,也得说说仓库里我看到的问题。
README 严重超卖。 列了”Image to Location / 3D Image Compositing / 2D Image Compositing / Image to 3D Mesh / Character Posing / Scene Blocking with Kitbashing / Character Identity Transfer / Background Removal / Mixed Asset Crafting” 九大高级功能,但代码里实际只实现了 ImageTo3DExperience.tsx 这一个 42KB 的大文件(对应 Image-to-3D Object 和 Image-to-3D World)。其他 8 个高级体验在代码里完全不存在——components/experiences/ 目录下只有 ImageTo3DExperience.tsx 和 ImageTo3DStore.ts 两个文件。README 自己在底部标了 “More previews are coming for scene blocking, canvas editing, and scene relighting”——但 “coming” 是个非常软的词,其他 8 个 README 列出来的功能连骨架都没开始写。
ROADMAP 远大但当前差距大。 目标 1 是”Make ArtCraft better and more useful than model aggregation websites (our #1 goal)“。但目前 24 个 page 里只有 TextToImage 真正完整,3D Experience 是独苗,其他 PageImageTo3DObject / PageScene / PageStoryboard / PageVideo / PageVideoEditor 多数是薄壳。架构建得很扎实,但功能填得还远。
AGENTS.md 写得极其严格。 命名约定、文件布局、缩进(Two spaces for indentation (not four))、测试布局、Markdown 表格列对齐(强调”terminals/diffs/editors 看 raw 表格和渲染一样多,所以列要 padded 对齐”)——这种对工程文化的投入,在新兴 AI 工具项目里不常见。但这种”严格到骨子里的规范”也是一种信号:团队是真的想长期维护,不是 fire-and-forget。
几个值得抄的设计#
最后总结一下,如果让我从 ArtCraft 抄走 4 样东西,我会选:
① router 的 5 文件模型 —— 把”价格逻辑”独立成单独的文件,让它可以独立单元测试;把”HTTP 边界”收敛到一处;把”异步资源解析”显式建模成 unhandled_request_state 这种字段。多 provider 项目里这个模板直接套用。
② Draft → Request 异步 finalize 模式 —— 用户传的资源可能是 token、可能是 URL、可能是空的,统一在 finalize 阶段解析,显式报”未准备好”的错,不兜底。cost 独立这条尤其值得抄:用户调参数时立刻能看见价格,不用等资源准备好。
③ Prompt 双层归属 —— 跑非自研模型之前,先在自家后台落 prompt 记录。结果归属问题在多 provider 架构里几乎一定会遇到,提前消解比事后补救便宜得多。 加 uuid_idempotency_token 是顺手做对的事情。
④ 凭据 6 位前缀 redact —— 简单到 4 行代码,但解决了”用户能确认配的是哪家”的体验问题。redact 在展示层做,不在存储层做——maybe_key_start 和 maybe_full_key 严格分离,后端按需使用,这是凭据处理的正确姿势。
题外话#
ArtCraft 整个项目是 dual-licensed MIT or Apache-2.0(自己选),版权方是 2026 ArtCraft Team。
ROADMAP 末尾两行特别有意思:
- “Build an Open OpenAI / Google / Anthropic. Open models, open platforms, open hardware. Why? Because the future could be bleak without it.”
- “Don’t Be Evil™”
—— 在 2026 年,一个 AI 工具公司敢把这两句写进 ROADMAP,要么是真心话,要么是营销。不管是哪种,都比”我们的使命是赋能未来”那种空话有意思。
参考资料
- storytold/artcraft GitHub 仓库 ↗
- ArtCraft 官网下载 ↗
- 仓库内
_docs/dev_setup.md描述了 Unix / Windows 开发启动方式 - 仓库内
crates/AGENTS.md写死了 Rust 工作区规范 - 仓库内
crates/desktop/artcraft/src/services/storyteller/commands/AGENTS.md写死了 Tauri command 命名约定