深入解析 Ghidra: NSA 开源的工业级反编译器框架, 1000 万行 Java + 19 万行 C++ 怎么写
💬 评论NSA 在 2019 年开源的逆向工程框架 SRE Framework: 1000 万行 Java + 19 万行 C++, 39 个 CPU 架构, 138 条 Rule 不动点化简的 Decompiler, Sleigh DSL 让新架构在几周内可用。
深入解析 Ghidra: NSA 开源的工业级反编译器框架, 1000 万行 Java + 19 万行 C++ 怎么写#
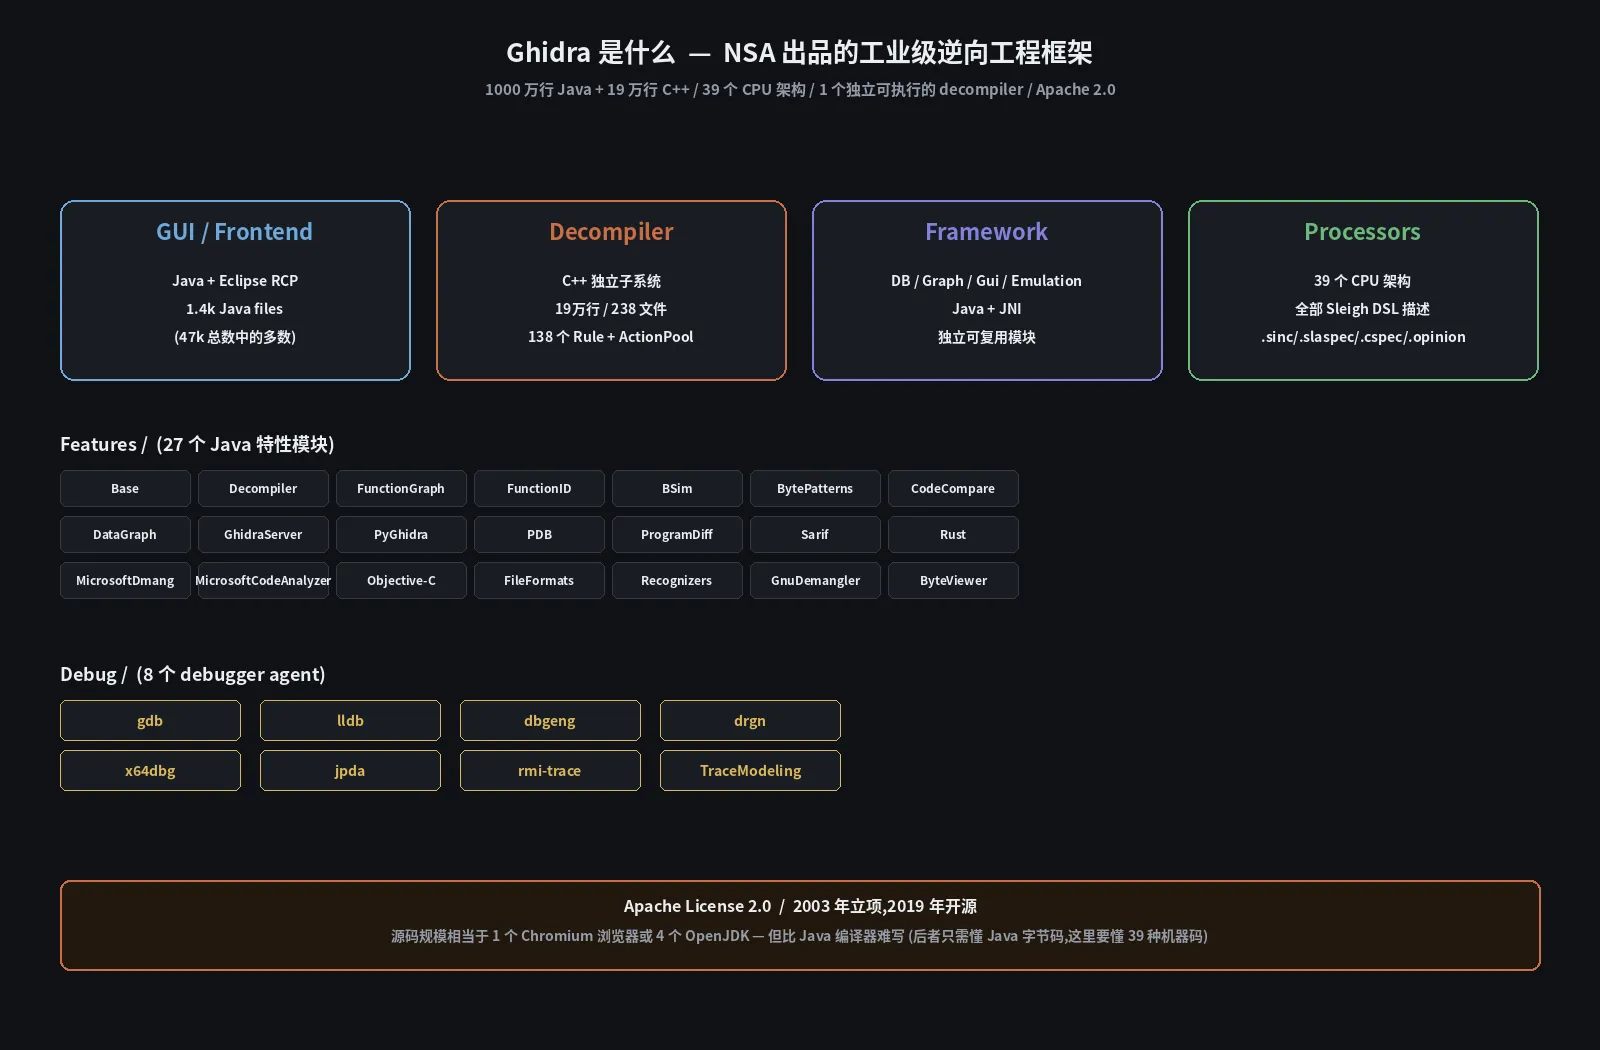
仓库: NationalSecurityAgency/ghidra ↗ · 1000 万行 Java + 19 万行 C++ + 2.1 万文件 · Apache 2.0 · 2019 年公开开源, 仍在每月迭代
如果你以为”反编译器 = IDA Pro 的 clone”,那 NSA 这群工程师在 Ghidra 里做的事情会让你重新理解什么叫国家级别的逆向工程基础设施。
Ghidra 不是单一产品,是一个完整的 SRE (Software Reverse Engineering) 框架——反汇编、反编译、图形化、脚本化、调试、协作、扩展,全部用一套 Java + C++ 的混合架构支撑,加上一套叫 Sleigh 的 DSL 让你能用 800 行代码加一个新 CPU 架构。
它的代码规模相当于 1 个 Chromium 浏览器或 4 个 OpenJDK,但比 Java 编译器难写一个量级——Java 编译器只需懂 Java 字节码,Ghidra 要懂 39 种机器码 + 它们的调用约定 + ELF/PE/Mach-O/DEX 文件格式 + P-code IR + SSA + 不动点化简。
这次拆解的目标是把这个庞然大物按层剥开,让你看到每个层是独立可学的技术栈,而且每层之间是干净的可替换接口。
一、仓库全貌:4 个主块 + 27 个 Features + 39 个 Processors#
Ghidra 的代码组织遵循一个清晰的”核心 + 模块”模式:
| 模块 | 规模 | 职责 |
|---|---|---|
Ghidra/Features/Decompiler/src/decompile/cpp/ | 19 万行 C++ / 238 文件 | 真正的 decompiler,独立可执行的 CLI,Java 端通过子进程 + JNI 调它 |
Ghidra/Framework/ (DB/Graph/Gui/SoftwareModeling/Emulation) | ~10 万行 Java | 通用基础设施,DB 是 B+ 树,Graph 是 DAG,Emulation 跑 Pcode |
Ghidra/Features/ | 27 个 Java 模块 | 27 个独立特性(函数图、BSim、PyGhidra、PDB 解析、Sarif、等等) |
Ghidra/Processors/ | 39 个 CPU 架构 | 全部 Sleigh DSL 描述,不含 C++ 代码 |
Ghidra/Debug/ | 13 个 debugger agent | 调 GDB / LLDB / dbgeng / x64dbg / drgn / DAP / JPDA |
Ghidra/Features/PyGhidra/ | 4335 行 Python | Python 嵌入 API + script + GUI |
整个项目的代码规模 1000 万行 Java + 19 万行 C++ + 4335 行 Python + ~5000 行 Gradle 构建脚本。底C++ 全在 decompiler 一个模块里,其他地方都是 Java——这是有意为之:Decompiler 是计算密集型,放 C++;UI 和框架放 Java,生态更好。
二、Pcode 流水线:从字节到 C 代码的 6 站转换#
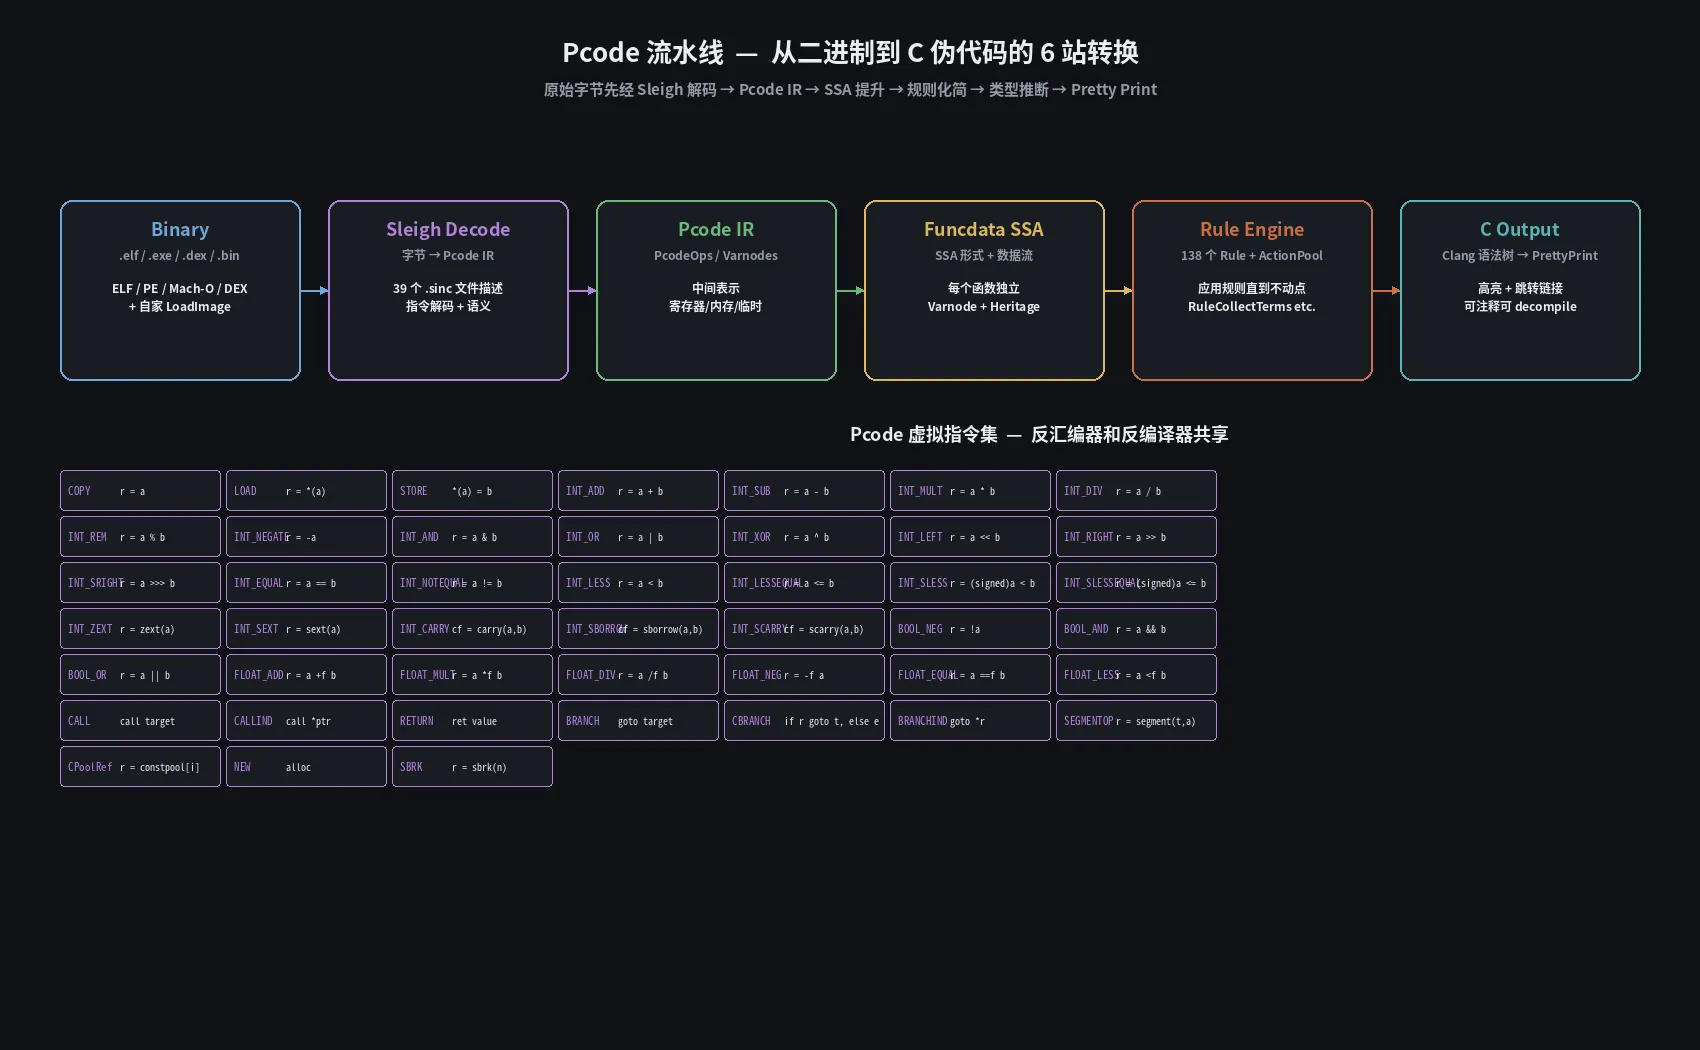
Ghidra 反编译的核心是 Pcode —— 一个跟目标架构无关的中间表示 (IR)。一条二进制 → C 伪代码的转换链:
- Binary 加载 (LoadImage):ELF/PE/Mach-O/DEX 文件解析,把所有 section/segment 映射成统一的 address space
- Sleigh Decode:39 个
.sinc文件描述的指令解码器,把字节流解析成 Pcode 操作 (见下) - Pcode IR:每条机器指令变成 1-N 个 PcodeOp,操作 Varnode (临时变量、寄存器、内存)
- Funcdata SSA:控制流分析 + 数据流分析,产出 SSA 形式的 Funcdata 结构
- Rule Engine:138 个 Rule + ActionPool 池式并行应用,直到不动点
- Pretty Print:ClangNode 语法树渲染成 C 风格伪代码
2.1 Pcode 虚拟指令集:反汇编器和反编译器共享#
Pcode 的 opcode 设计哲学和 LLVM IR 类似——目标架构无关的操作集合。一共 44 个核心 opcode:
- 数据移动:
COPY / LOAD / STORE - 整数算术:
INT_ADD / INT_SUB / INT_MULT / INT_DIV / INT_REM / INT_NEGATE - 位运算:
INT_AND / INT_OR / INT_XOR / INT_LEFT / INT_RIGHT / INT_SRIGHT / INT_ZEXT / INT_SEXT - 标志位:
INT_CARRY / INT_SBORROW / INT_SCARRY - 比较:
INT_EQUAL / INT_NOTEQUAL / INT_LESS / INT_LESSEQUAL / INT_SLESS / INT_SLESSEQUAL - 布尔:
BOOL_NEG / BOOL_AND / BOOL_OR - 浮点:
FLOAT_ADD / FLOAT_MULT / FLOAT_DIV / FLOAT_NEG / FLOAT_EQUAL / FLOAT_LESS - 控制流:
CALL / CALLIND / RETURN / BRANCH / CBRANCH / BRANCHIND - 特殊:
SEGMENTOP / CPoolRef / NEW / SBRK
x86 的 add 指令会被翻译成 INT_ADD,ARM 的 add 也是 INT_ADD,JVM 的 iadd 也是 INT_ADD —— 后续所有 decompiler 优化都不用关心是哪个架构。
设计哲学:不要把架构特定的 opcode 加进 Pcode,要让每个架构的 .sinc 把自己的指令翻译到这套 44 op 上。这让 rule 引擎架构无关——一套规则适用于所有 CPU。
2.2 Funcdata:SSA + 数据流的载体#
Funcdata 是 Pcode 上层的数据结构 (cpp/funcdata.hh,约 2000 行),包含:
- PcodeOp 数组:函数里所有 Pcode 操作
- Varnode 池:所有变量(寄存器、内存位置、立即数)
- Heritage:点的定义链(谁定义了我)
- Cover / BlockGraph:基本块 + 控制流图
- Type/Struct/Union:函数原型 + 数据类型推断结果
SSA 形式让 Rule 可以做”沿着定义链向上走”这种局部推理,这是 decompiler 能从一长串 mov/add 还原出 x = a + b * c 这种高级表达式的根本。
三、Rule + Action 引擎:138 条规则 + 不动点迭代#
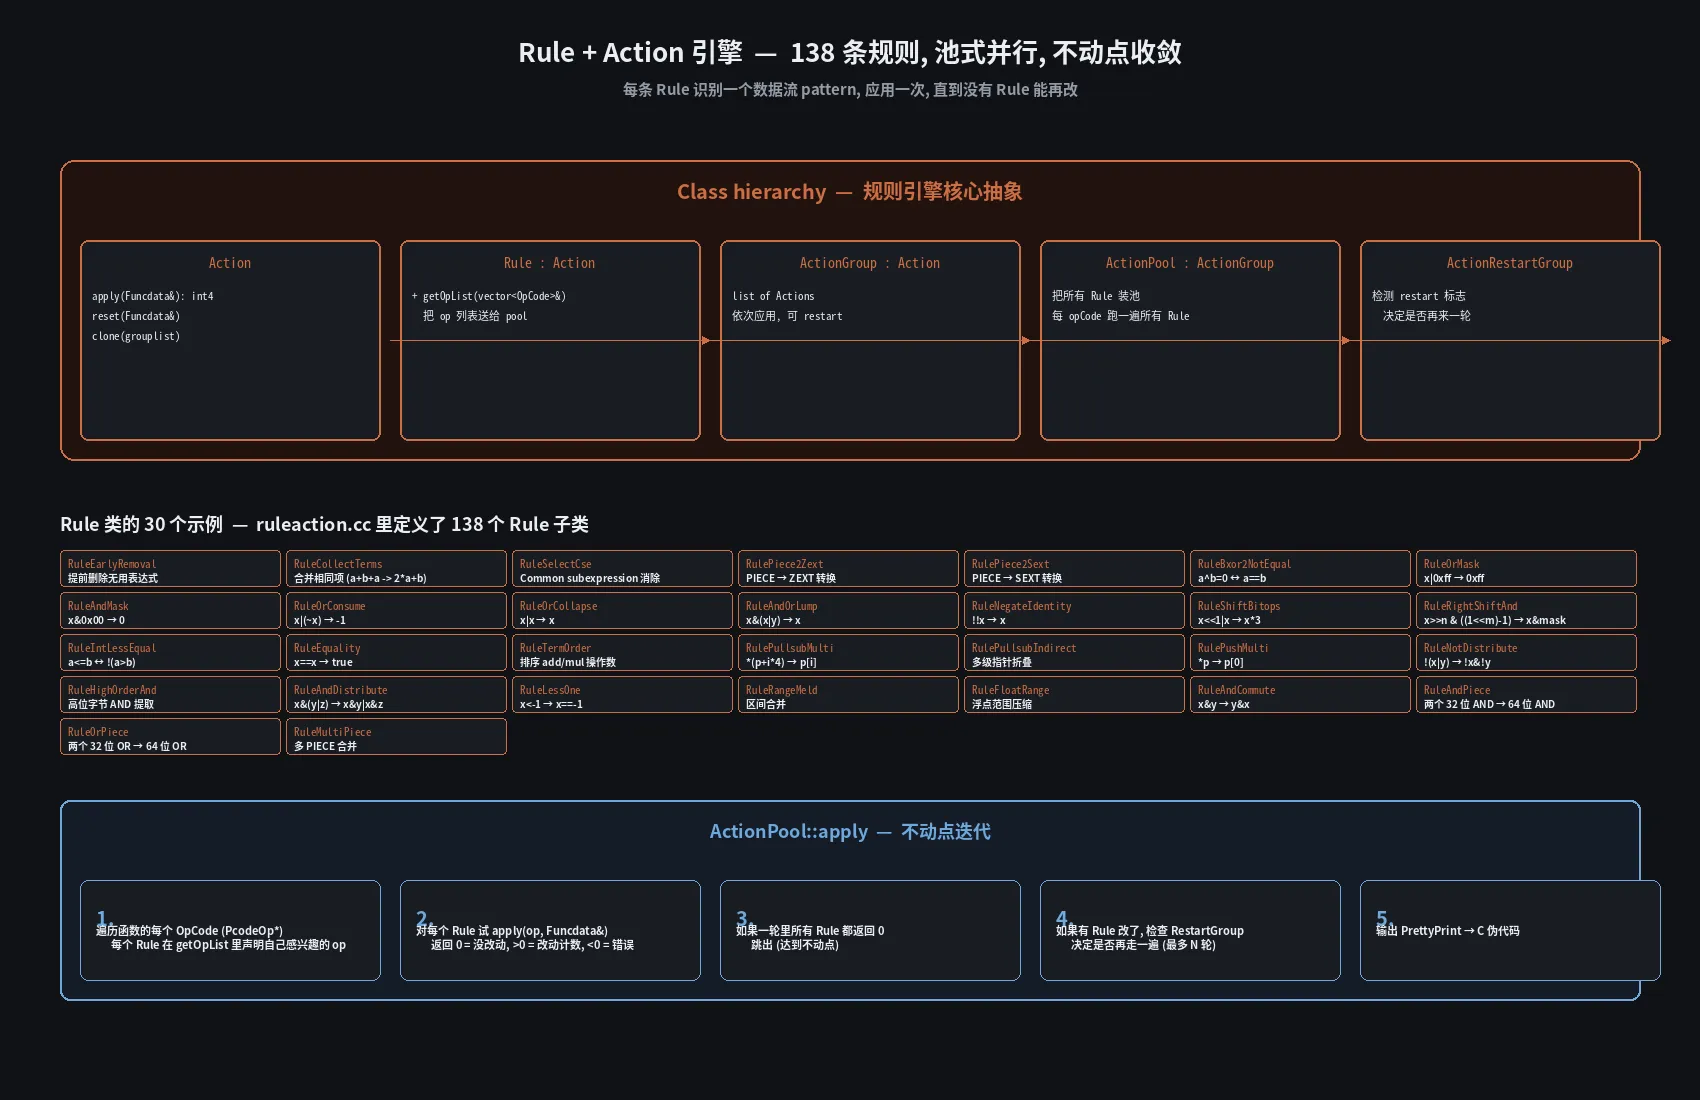
Decompiler 的核心创新不是某个 Rule,而是 Rule + Action + ActionPool 这套抽象。
3.1 类层次:Action → Rule → ActionGroup → ActionPool#
class Action {
  virtual int4 apply(Funcdata &data) = 0;
  virtual void reset(Funcdata &data);
  virtual Action *clone(const ActionGroupList &grouplist) const = 0;
  virtual int4 print(ostream &s, int4 num, int4 depth) const;
};

class Rule : public Action {
  virtual void getOpList(vector<OpCode> &oplist) const = 0;
};

class ActionGroup : public Action {
  vector<Action *> list;
  vector<Action *>::iterator state;
  // ...
};

class ActionPool : public ActionGroup {
  // 把所有 Rule 装池,按 OpCode 索引,apply 一次走完整个函数
  int4 apply(Funcdata &data);
};Rule::getOpList 声明这个 Rule 关心哪些 OpCode(例如 RuleOrMask 只关心 INT_OR)。ActionPool::apply 遍历函数的每个 OpCode,把对应 Rule 集合跑一遍。这种按 opcode 分桶的优化让 Rule 应用从 O(n_rules × n_ops) 降到 O(n_ops × |rules_per_op|)。
3.2 138 个 Rule 的设计哲学#
每个 Rule 都很小,做一件事。举几个例子:
RuleOrMask:识别x | 0xff → 0xff,消除冗位或RuleAndMask:x & 0 → 0RuleOrConsume:x | (~x) → -1RuleOrCollapse:x | x → xRuleAndOrLump:x & (x | y) → x(吸收律)RuleBxor2NotEqual:a ^ b == 0 ↔ a == b(语义转换)RulePiece2Zext:把两个 32 位拼接的 PIECE 操作识别成 64 位零扩展RulePullsubMulti:*(p + i*4) → p[i](数组索引识别)RuleShiftBitops:x << 1 | x → x * 3(位运算与算术的等价)RuleFloatRange:浮点表达式的范围压缩
为什么是 138 个而不是一个巨大的 Rule?因为每条 Rule 都试图被并行应用——两个 Rule 都满足,谁先动都可能产生新的模式让另一个 Rule 触发。这是用本地推理逼近全局最优的经典工程实现,跟 LLVM InstCombine 的设计思想完全一致。
3.3 不动点迭代的工程保障#
int4 ActionPool::apply(Funcdata &data) {
  // ... 遍历每个 OpCode, 对每个 Rule 试 apply
  // 任何 Rule 成功就标记 restart
  // 直到一轮里所有 Rule 都返回 0 = 都没改
  // 跳出
}不动点收敛的保证有两层:
- 结构上:每个 Rule 只做”等式重写”,不会引入新的 PcodeOp 类型——操作数变小/换形式,不增复杂度
- 工程上:
ActionRestartGroup检测这一轮是否触发了重启信号,触发就再来一轮,有迭代上限避免死循环
这种设计让 decompiler 能从一长串汇编里层层抽象——先识别常量折叠,再识别代数恒等式,再识别结构体访问,最后浮现出函数调用关系。
四、Sleigh DSL:用声明性语言描述 CPU 架构#
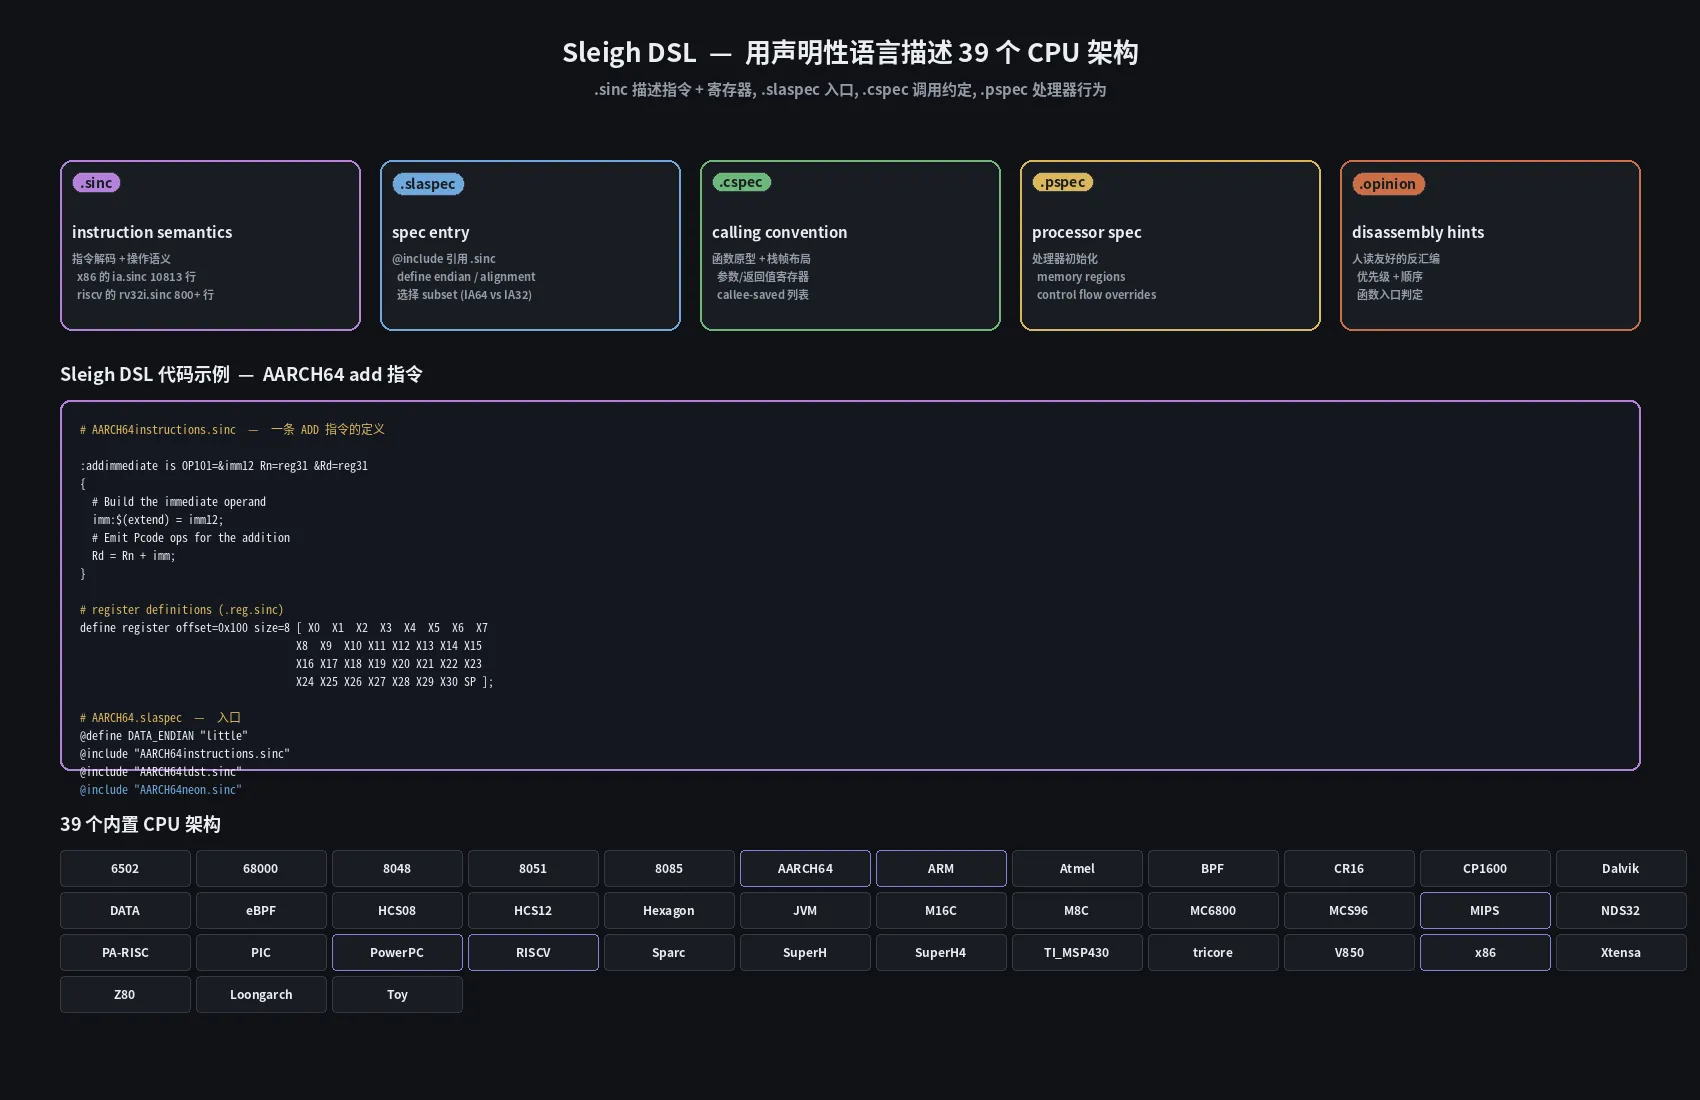
Ghidra 最”反主流”的设计是不让架构相关的代码写 C++。39 个 CPU 架构全部用 DSL 描述。
4.1 5 种文件类型,职责分明#
| 扩展名 | 职责 | 实例 |
|---|---|---|
.sinc | 指令 + 操作语义 (instruction semantics) | x86 的 ia.sinc 10813 行,覆盖 64 位指令集 |
.slaspec | 入口 (spec entry) | AARCH64.slaspec @include "AARCH64instructions.sinc" |
.cspec | 调用约定 (calling convention) | 函数原型、参数/返回值寄存器、callee-saved 列表 |
.pspec | 处理器行为 (processor spec) | 初始化、内存区域、control flow overrides |
.opinion | 反汇编偏好 (disassembly hints) | 人读友好的优先级排序 |
这套 DSL 的核心抽象是 token + constructor:
# AARCH64instructions.sinc  —  ADD 指令
:addimmediate is OP101=&imm12 Rn=reg31 &Rd=reg31
{
  imm:$(extend) = imm12;
  Rd = Rn + imm;
}

# 寄存器定义
define register offset=0x100 size=8 [ X0  X1  X2  X3  X4  X5  X6  X7
                                    X8  X9  X10 X11 X12 X13 X14 X15
                                    X16 X17 X18 X19 X20 X21 X22 X23
X24 X25 X26 X27 X28 X29 X30 SP ];:addimmediate is OP101=&imm12 Rn=reg31 &Rd=reg31 是指令解码模板——“这是一个 32 位指令,bit 10-21 是立即数,bit 5-9 是 Rn,bit 0-4 是 Rd”。{ Rd = Rn + imm; } 是操作语义——把这条指令翻译成一个 Pcode INT_ADD。
Sleigh 把”位图匹配 + 语义翻译”这两件事用一个声明性语法搞定,一个普通的架构工程师不需要学编译器前端就能加新架构。GhidraBuild/EclipsePlugins/GhidraSleighEditor/ 提供 Xtext 实现的语法高亮 + 语法检查 IDE,完整工程化。
4.2 39 个 CPU 架构#
Ghidra 开箱即用支持 39 个架构,横跨 8 位微控制器到 64 位服务器 CPU + 字节码:
- CISC:x86 / x86_64 / 68000 / Z80 / 6502 / 8085 / 8051 / i8051 / M8C / MC6800 / MCS96 / V850 / SuperH / SuperH4 / CR16 / CP1600 / M16C / TI_MSP430 / HCS08 / HCS12 / Atmel / NDS32 / PA-RISC / 8048 / PIC / TRICORE
- RISC:ARM / AARCH64 / RISCV (rv32i/rv64i/rv32f/rv64f/…) / MIPS / PowerPC / Sparc / Loongarch / Hexagon / eBPF
- 字节码:JVM / Dalvik (DEX Android 8/11/…)
每一个都是几百到几千行 .sinc + .cspec + .opinion,纯声明式,没有 C++ 代码。这就是 Ghidra 跟 IDA Pro 的关键差异——IDA Pro 的架构支持是 C++ 插件,改一个指令可能要重编译整个二进制;Ghidra 改 .sinc 文件重启就生效。
五、ClangNode 树:Decompiler 输出从字节到可跳转 C 代码的关键#
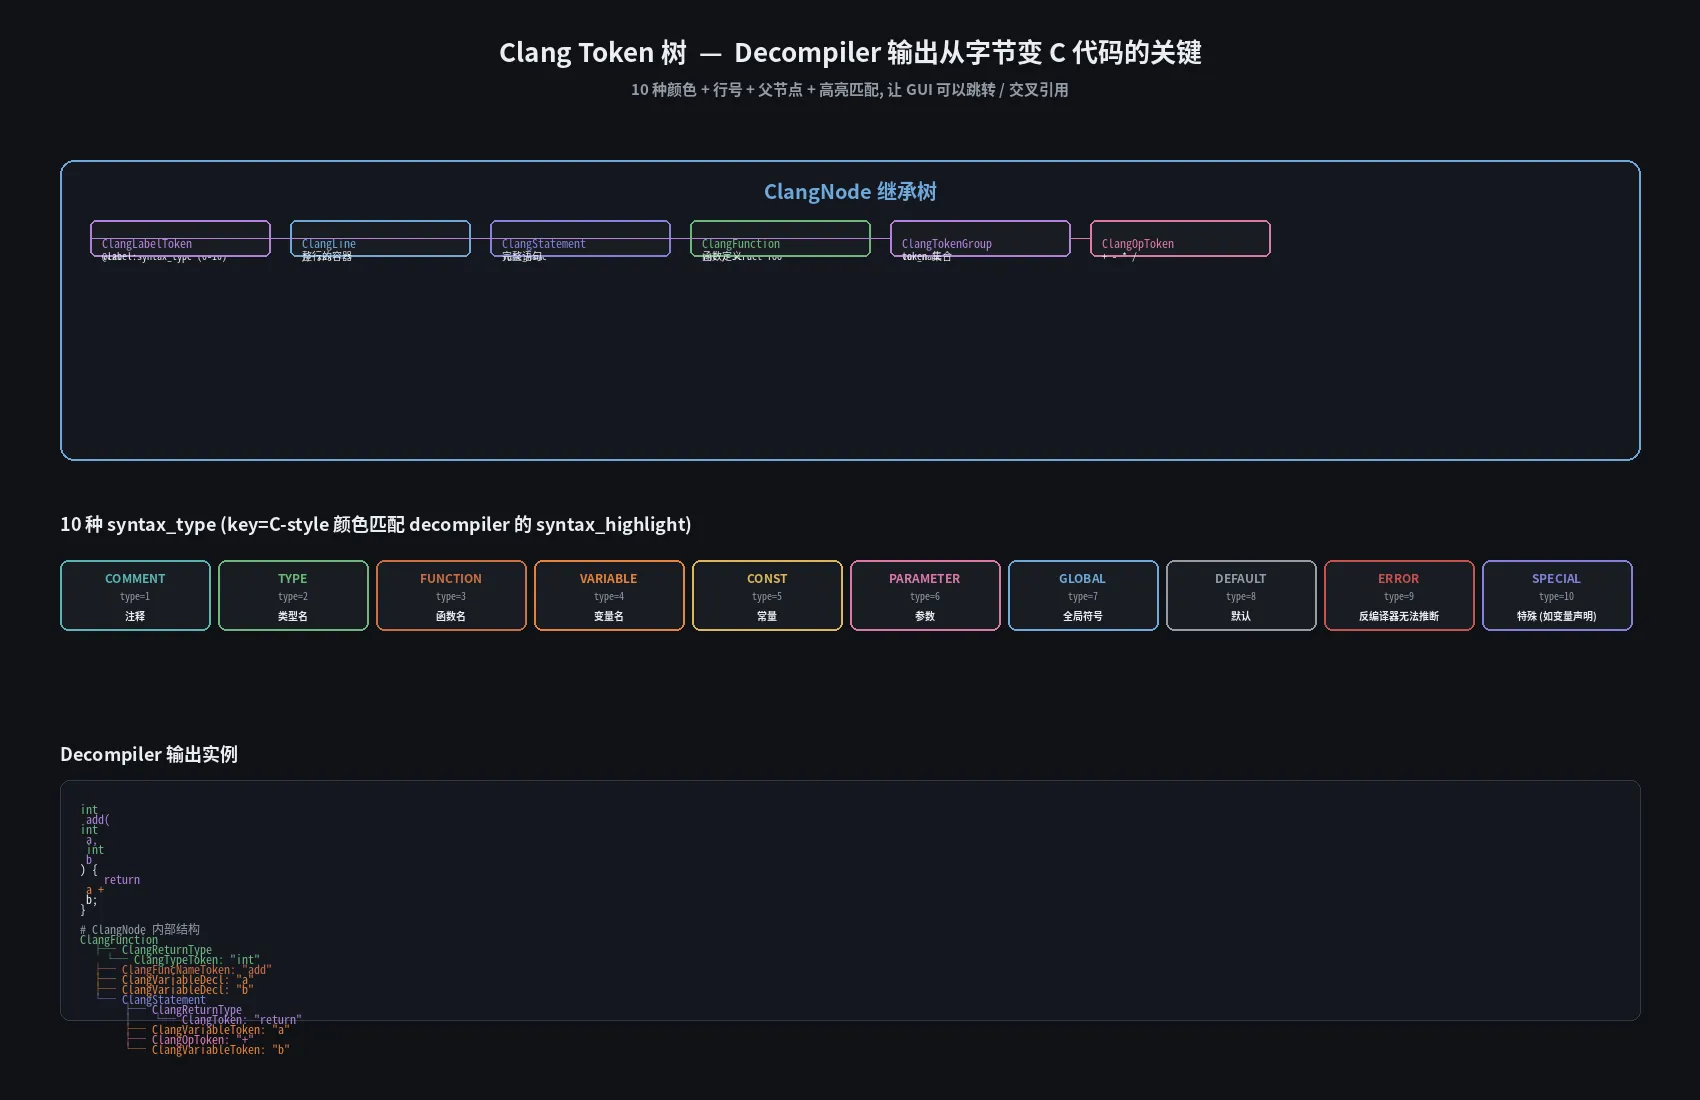
Ghidra/Features/Decompiler/src/main/java/ghidra/app/decompiler/ClangNode.java 定义了一个结构化的输出树。Decompiler 输出的不是字符串,而是这棵树——每个 token 都带语义信息,GUI 才能跳转 / 高亮 / 交叉引用。
5.1 继承树:12 个 ClangNode 子类#
ClangNode(interface):所有 token 的根ClangToken:叶子节点,带text + syntax_type- 叶子节点子类:
ClangLabelToken(标签) /ClangCommentToken(注释) /ClangFuncNameToken(函数名) /ClangTypeToken(类型) /ClangVariableToken(变量) /ClangOpToken(操作符) - 容器节点:
ClangLine(整行) /ClangStatement(语句) /ClangFunction(函数) /ClangTokenGroup(token 集合)
5.2 10 种 syntax_type:颜色编码#
public final static int KEYWORD_COLOR   = 0;
public final static int COMMENT_COLOR   = 1;
public final static int TYPE_COLOR      = 2;
public final static int FUNCTION_COLOR  = 3;
public final static int VARIABLE_COLOR  = 4;
public final static int CONST_COLOR     = 5;
public final static int PARAMETER_COLOR = 6;
public final static int GLOBAL_COLOR    = 7;
public final static int DEFAULT_COLOR   = 8;
public final static int ERROR_COLOR     = 9;
public final static int SPECIAL_COLOR = 10;注意:常量必须匹配 decompiler 的 syntax_highlight——C++ 端和 Java 端共用同一套编号。这是跨语言互操作的工程小细节。
5.3 一个反编译函数的内部结构#
int add(int a, int b) {
    return a + b;
}对应到 ClangNode 树:
ClangFunction
  ├─ ClangReturnType
  │   └─ ClangTypeToken: "int"
  ├─ ClangFuncNameToken: "add"
  ├─ ClangVariableDecl: "a"
  ├─ ClangVariableDecl: "b"
  └─ ClangStatement
       ├─ ClangReturnType
       │   └─ ClangToken: "return"
       ├─ ClangVariableToken: "a"
       ├─ ClangOpToken: "+"
└─ ClangVariableToken: "b"每个 token 都有父节点指针(双向链表),所以 GUI 可以:点击 token → 跳到反汇编位置、悬浮显示类型、交叉引用、改名。这是字符串输出做不到的——IDA Pro Hex-Rays 输出是文本,Ghidra 输出是带语义的结构。
六、B+ 树数据库 + Pcode 模拟器:Ghidra 的两个底层支柱#
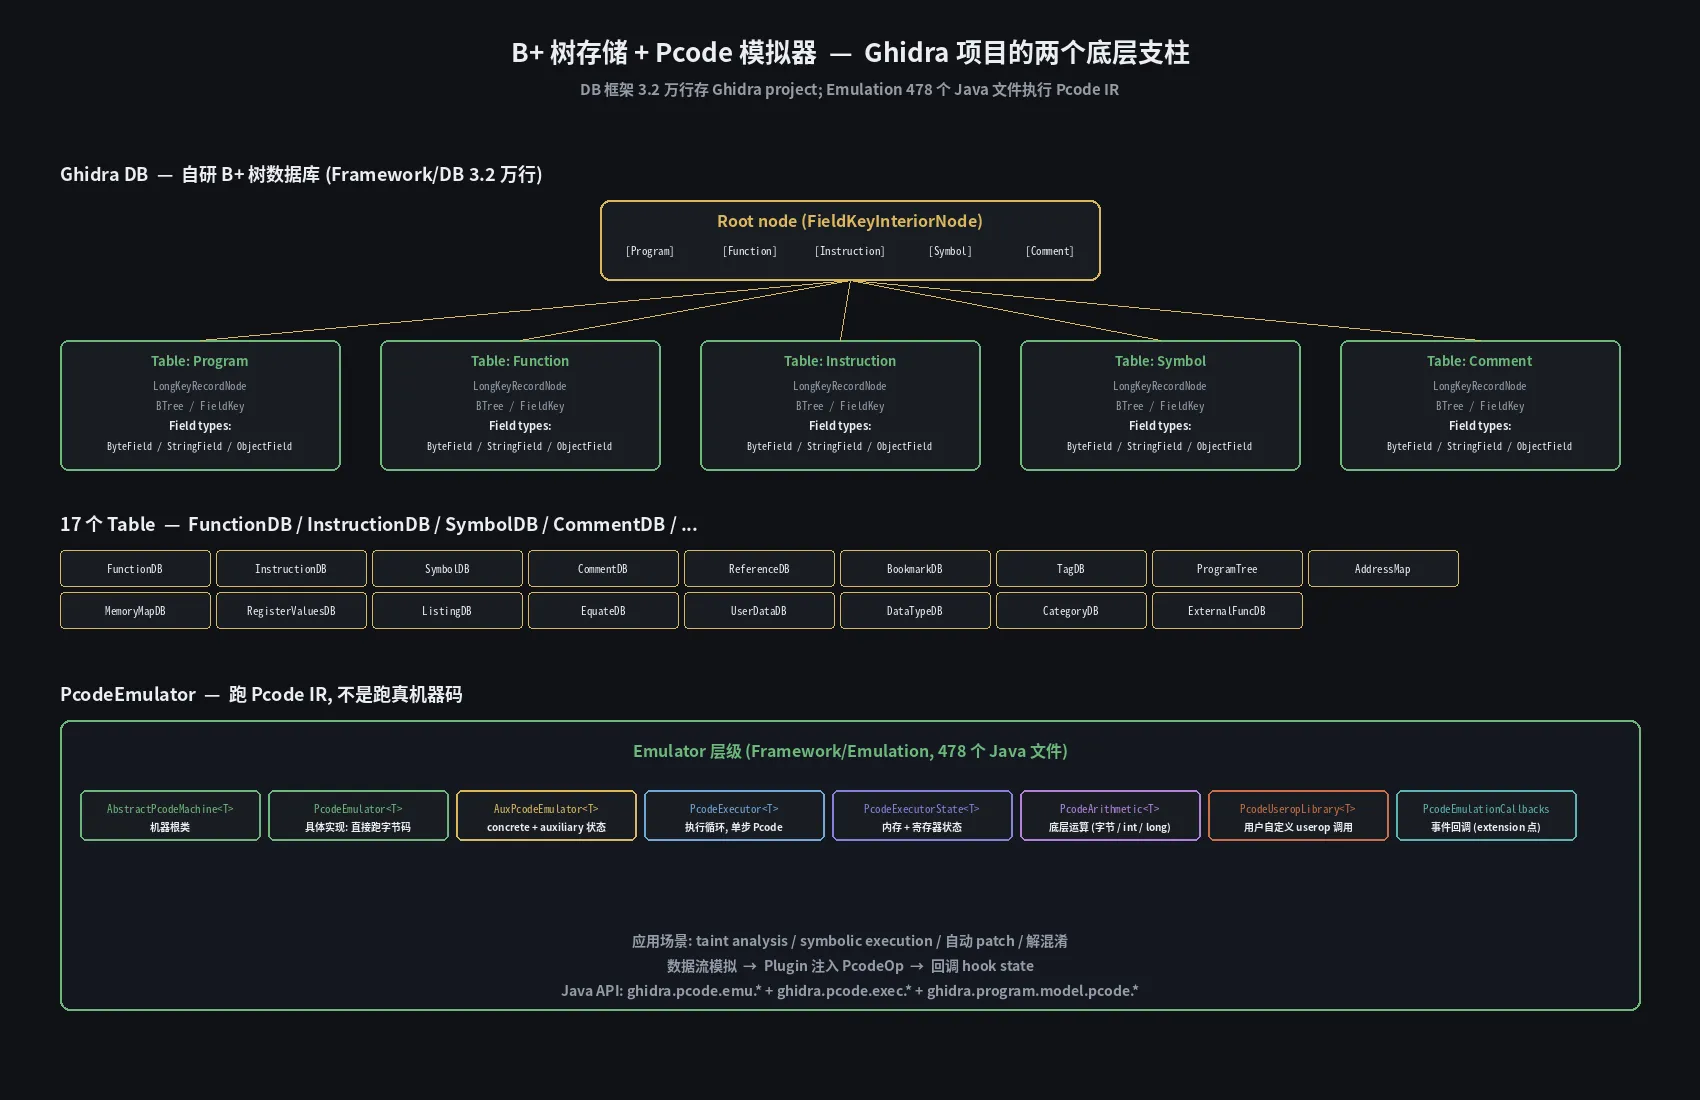
6.1 Framework/DB:Ghidra 的自研 B+ 树#
Ghidra/Framework/DB/ 是 3.2 万行 Java 的 B+ 树数据库,Ghidra 项目文件 .gpr 直接是这个 DB。
核心类:
NodeMgr:B+ 树节点管理器,管理 LongKeyNode / FieldKeyNode / StringKeyNodeLongKeyInteriorNode/LongKeyRecordNode:长整型 key 的内部/叶子节点FieldKeyInteriorNode/FieldKeyRecordNode:字段 key 的内部/叶子节点(每个 record 有多个 field)RecordTranslator:Schema演化时翻译老格式ConstrainedForwardRecordIterator:约束前向迭代器(支持 range query)
Ghidra project 里有 17 个 Table——FunctionDB / InstructionDB / SymbolDB / CommentDB / ReferenceDB / BookmarkDB / TagDB / ProgramTree / AddressMap / MemoryMapDB / RegisterValuesDB / ListingDB / EquateDB / UserDataDB / DataTypeDB / CategoryDB / ExternalFuncDB——每个是一个 B+ 树子表。
为什么不直接用 SQLite 或 H2?因为 Ghidra 的 schema 太动态——每个 program (binary) 都有自己的类型、自己的函数、自己的注释,Schema 演化极频繁(用户新加一个数据类型就是 schema 改动)。自研 B+ 树 + RecordTranslator 让 schema 演化零迁移代价。
6.2 Framework/Emulation:跑 Pcode,而不是跑机器码#
Ghidra/Framework/Emulation/ 478 个 Java 文件,提供了完整的 Pcode 模拟器。
层级结构:
AbstractPcodeMachine<T>
└── PcodeEmulator<T>              // 直接跑字节码
    └── AuxPcodeEmulator<T>       // concrete + auxiliary 状态
        ├── PcodeExecutor<T>      // 核心执行循环
        ├── PcodeExecutorState<T> // 内存 + 寄存器状态
        ├── PcodeArithmetic<T>    // 底层运算 (字节/int/long)
        ├── PcodeUseropLibrary<T> // 用户自定义 userop
└── PcodeEmulationCallbacks // 事件回调关键洞察:Pcode emulator 不跑真的机器码,跑 Pcode IR。这意味着同一套 emulator 可以模拟任何架构——x86 / ARM / RISCV 都用同一个 PcodeExecutor,只换 Language 参数。
应用场景:
- Taint 分析:标记一个寄存器的 taint 源,emulator 跑函数,跟踪 taint 流向哪些输出
- 符号执行:用 SMT 表达式代替具体值,模拟所有路径
- 自动 patch:emulator 找到 OEP (Original Entry Point),改一段指令,验证 patch 是否破坏语义
- 解混淆:把控制流平坦化还原成正常结构
七、Decompiler 子进程通信:Java 与 C++ 的边界设计#
Ghidra 是 Java (Eclipse RCP) 调 C++ decompiler,这个边界怎么处理?
答案:每个 Program 一个独立的 decompiler 子进程。
// ghidra.app.decompiler.DecompileProcess
public class DecompileProcess {
  // ... 单个进程的同步器
  public synchronized void decompile(...) { ... }
  // isReady flag + registerProgram 状态机
}为什么是子进程而不是 JNI:
- 崩溃隔离:decompiler bug 不会让整个 Ghidra 崩
- 内存隔离:每个 Program 的 decompile state 几十 MB,独立进程更好 GC
- 多架构并行:
ParallelDecompiler起 N 个进程同时反编译多个函数,真并行 - 序列化协议简单:decompiler 输出 XML,Java 端用 SAX 解析成 ClangNode 树
这是 “脆性 C++ 代码放进牢子进程里” 的经典做法——LLVM / Clang / WebKit 等同样项目都用这种边界。
八、PyGhidra:4335 行 Python,完整的 Python 嵌入#
Ghidra/Features/PyGhidra/ 提供 Python API,让用户能用 Python 脚本化 Ghidra:
pyghidra.core:open_program()/getCurrentProgram()等 flat APIpyghidra.script:@execute_ghidra_script装饰器,把普通函数变成 Ghidra scriptpyghidra.gui:pyghidra.open()启动一个带 GUI 的 Python 会话(嵌入 JNI)pyghidra.properties/pyghidra.ghidradoc:配置 + 文档生成
PyGhidra 是 Ghidra “用户友好”的另一面——Java / Eclipse RCP 是开发者视角,Python 是分析员视角。两者共享同一套底层数据,分析员写 100 行 Python 就能做到 Java 插件 1000 行的功能。
九、13 个 Debugger Agent:跨调试器的统一抽象#
Ghidra/Debug/ 目录下有 13 个 debugger agent,把不同调试器的协议统一到 Ghidra 的 Debugger-API 上:
- GDB (Linux/macOS 用户态)
- LLDB (macOS/iOS)
- dbgeng (Windows 用户态)
- drgn (Linux 内核)
- x64dbg (Windows 逆向)
- JPDA (Java)
- TraceModeling (Intel Processor Trace / ARM CoreSight)
- rmi-trace (RMI 远程 trace)
- DAP (Debug Adapter Protocol)
Ghidra 的 debugger 不只是断点管理——它把 trace 数据接进 Decompiler,能在反编译视图里直接看到执行流。这是 IDA Pro + WinDbg 都做不到的整合度。
十、能直接抄的 7 个工程模式#
- DSL-driven architecture description:让架构支持脱离主代码,改 .sinc 文件就生效。适合任何”支持多方言/多协议”系统。
- Custom B+ 树 + RecordTranslator:动态 schema + 演化零迁移。适合任何”用户改 schema 比改数据还频繁”的本地数据库。
- Pcode-style IR + 架构无关优化:把多架构问题统一到一个 IR 上做优化。适合任何”多方言 → 一套优化”编译器/转换器。
- Rule + ActionPool + 不动点迭代:用本地推理逼近全局最优,138 条 Rule + 一套 apply。适合任何”启发式重写系统”。
- 脆性 C++ 进程化:把易崩的 C++ 模块放进独立子进程,Java 主进程隔离。适合任何”Java + C++ 混合栈”。
- Token 树而非字符串输出:输出带语义信息的 AST,不是字符串。适合任何”输出需要 GUI 操作/跳转/交叉引用”的转换器。
- Pcode emulator 在 IR 层:模拟器跑中间表示,不跑真机器码。适合任何”需要跨架构/可注入”的模拟系统。
十一、非显然的小细节#
DecompileProcess的isReady状态机:decompiler 子进程可能挂在初始化,isReady flag 是唯一真相——任何 decompile 调用前必须检查,失败只能registerProgram重启- ParallelDecompiler 用 N 个子进程并行:不是 JNI 多线程,是真多进程——每个进程独立 Sleigh 状态,独立 PcodeCache,适合大规模批量分析
- AttributeId / ElementId 用数字编号:
AttributeId("address",148),这些 ID 用于 XML 序列化兼容——跨进程/跨版本通信时不变 - Decompiler 有自己 CLI:
Features/Decompiler/src/decompile/cpp/consolemain.ccint main(int argc, char **argv)——独立可执行decomp命令,不依赖 Ghidra GUI,适合 headless 批量反编译 - Framework/Utility 跨项目共享:很多基础类(
Msg/datastruct/exception)被 Framework 各模块引用,这是 Ghidra 内部”标准库” certification.local.manifest/certification.manifest:Ghidra 内部有个”certification”机制——某些代码模块会被标记成需要特殊审查,跟 NSA 的内部流程对齐- Eclipse RCP 不用新版 UI 框架:Ghidra 用的是 Eclipse 3.x 风格的 RCP + Docking Framework,自己写的
DockingApplication/DockingFrame,不跟 SWT 升级——稳定优先 - PyGhidra 的
@execute_ghidra_script装饰器:把 Python 函数变成 Ghidra script,直接调currentProgram等 flat API,装饰器让 IDE 类型推断能用——这是 Python + Java 互操作的工程技巧
结语#
Ghidra 不是一个”产品”,是一个国家级研究机构 20 年逆向工程经验的代码化沉淀。每一层抽象——Pcode IR、Rule 引擎、Sleigh DSL、ClangNode 树、自研 B+ 树——都不是为了”赶时髦”,而是为了让某个特定问题变得可被多人协作可被复用。
最值得借鉴的不是某个具体模块,而是它那种**“在每个边界都显式做一次选择”**的纪律:
- Java vs C++?在子进程边界
- 静态分析 vs 动态执行?在 Pcode emulator 层
- DSL vs 代码?在 Sleigh
- 字符串 vs 结构?在 ClangNode 树
- 不动点 vs 全局最优?在 Rule 引擎
每个边界都有自己的理由 + 接口 + 替代方案。这种纪律的源头是 NSA 真实在做 malware 分析、漏洞研究、固件逆向——他们每天跟这些抽象打交道,所以每个抽象都是”如果不这么做,我们会痛”的产物。
如果你想做一个自己的逆向工具,或者想理解现代 decompiler 怎么工作,Ghidra 的源码就是最好的教科书——比任何论文都详细,比任何商业产品都开放。
参考#
- 仓库: https://github.com/NationalSecurityAgency/ghidra ↗
- LICENSE: Apache 2.0
- Sleigh 文档: https://ghidra.re/courses/languages/html/sleigh.html ↗
- 源码规模: ~1000 万行 Java + 19 万行 C++ + 4335 行 Python
- 核心 C++ 模块:
Ghidra/Features/Decompiler/src/decompile/cpp/(238 文件 / 19 万行) - 核心 Java 模块:
Ghidra/Framework/{DB,Graph,Gui,Emulation,SoftwareModeling}+Ghidra/Features/Decompiler/src/main/java/ghidra/app/decompiler/ - Pcode 指令集: 44 opcodes (整数/浮点/位运算/控制流)
- Rule 引擎: 138 Rule + ActionPool + 不动点迭代
- CPU 架构: 39 个,全部 Sleigh DSL 描述
请关注「Next Now 」,留下您的一键三连,本人将不定期提供科技趣事和经验分享。
👉👉 「关注」
      「点赞」

            「投币??」

                         🚀🚀