Headroom:一次请求里,哪些字节允许被改#
仓库 headroomlabs-ai/headroom ↗,一个「AI Agent 的上下文压缩层」。我把它 clone 下来读完的时候,第一个感觉是:这不像一个压缩工具,更像一份关于「什么不能动」的工程契约。
0. 先说清楚它在解决什么#
现在几乎每个 Agent 都在烧同样的钱:工具输出塞进上下文。一次 grep 返回 200 行、一个 pytest 吐出 5000 行日志、一个 SQL 查询拉回 1 万行 JSON —— 这些东西原封不动进 prompt,token 账单按字收费,上下文窗口也被迅速吃光。
Headroom 的思路很直接:在内容进 prompt 之前先过一道压。但这件事的难点从来不是「怎么压」,而是——压完之后,你的 prompt cache 是不是废了?
这才是这个项目真正值得看的部分。
1. 数字先摆出来#
我下载的是默认分支,约 113MB(主要是 git 历史和 GIF)。代码体量:
| 部分 | 体量 | 说明 |
|---|---|---|
crates/headroom-core | 42967 行 Rust | 压缩器实现、CCR 存储、tokenizer |
crates/headroom-proxy | 37811 行 Rust | axum 路由、SSE 状态机、缓存前缀稳定 |
crates/headroom-py | 1924 行 Rust | PyO3 扩展模块 |
crates/headroom-parity | 1130 行 Rust | 双语言一致性校验 |
headroom/(Python) | 1722 个 .py / 27.8 万行 | CLI、SDK 门面、代理处理器、插件生态 |
| 测试 | 988 个 Python test + 1471 个 Rust #[test] |
有意思的是:Python 那 27.8 万行里,压缩核心已经退休了。headroom/transforms/smart_crusher.py 现在只剩一个 dataclass 外壳 + 一个转发,真正干活的是 Rust。
官方跑出来的效果(仓库里 benchmarks/index_proof_table.py 的输出,seed 固定、tokenizer 固定):
| 场景 | 压缩前 | 压缩后 | 节省 |
|---|---|---|---|
| Code search(100 条结果) | 17199 | 13597 | 21% |
| SRE 事故排查 | 55957 | 24340 | 57% |
| 代码库探索 | 58801 | 33895 | 42% |
| GitHub issue 分诊 | 46067 | 32429 | 30% |
| 合计 | 178024 | 104261 | 41% |
这个脚本的存在本身就很有意思 —— 它的文件头注释里写得很直白:
A number on the front page of the docs that nobody can regenerate is a liability, not evidence.
首页挂着的数字,谁都复现不了,那就是负资产,不是证据。所以他们把生成器、seed、tokenizer 全固定下来,让任何人 uv run python benchmarks/index_proof_table.py --seed 20260902 都能跑出同一张表。这种较真程度,在我见过的开源项目里排得上前三。
2. 核心机制一:live-zone,先划出「不许动」的地盘#
要理解 Headroom,得先理解 provider 的 prompt cache 是怎么工作的:它按前缀字节哈希。前缀一个 bit 变了,缓存全部 miss,账单重来一遍。
所以第一个设计决策不是「怎么压」,而是**「哪些字节有资格被压」**。Headroom 把这个区域叫 live zone,边界由两头夹出来:
- 下界:
frozen_message_count,由显式的cache_control标记算出来。这个下界以下的内容已经在缓存里了,必须字节相同。 - 上界:最新的那条 user message。再往上的 assistant message 也算热区 —— 下一次回答要接着它写,不能碰。
- live zone 内部:每个 block 都是候选。最常见的是
tool_result(工具输出本来就占 token 大头),textblock 也算(比如用户粘了一大段日志)。
live zone 之外的一切,一律不动。system 不动,tools[] 不动,历史轮次不动。
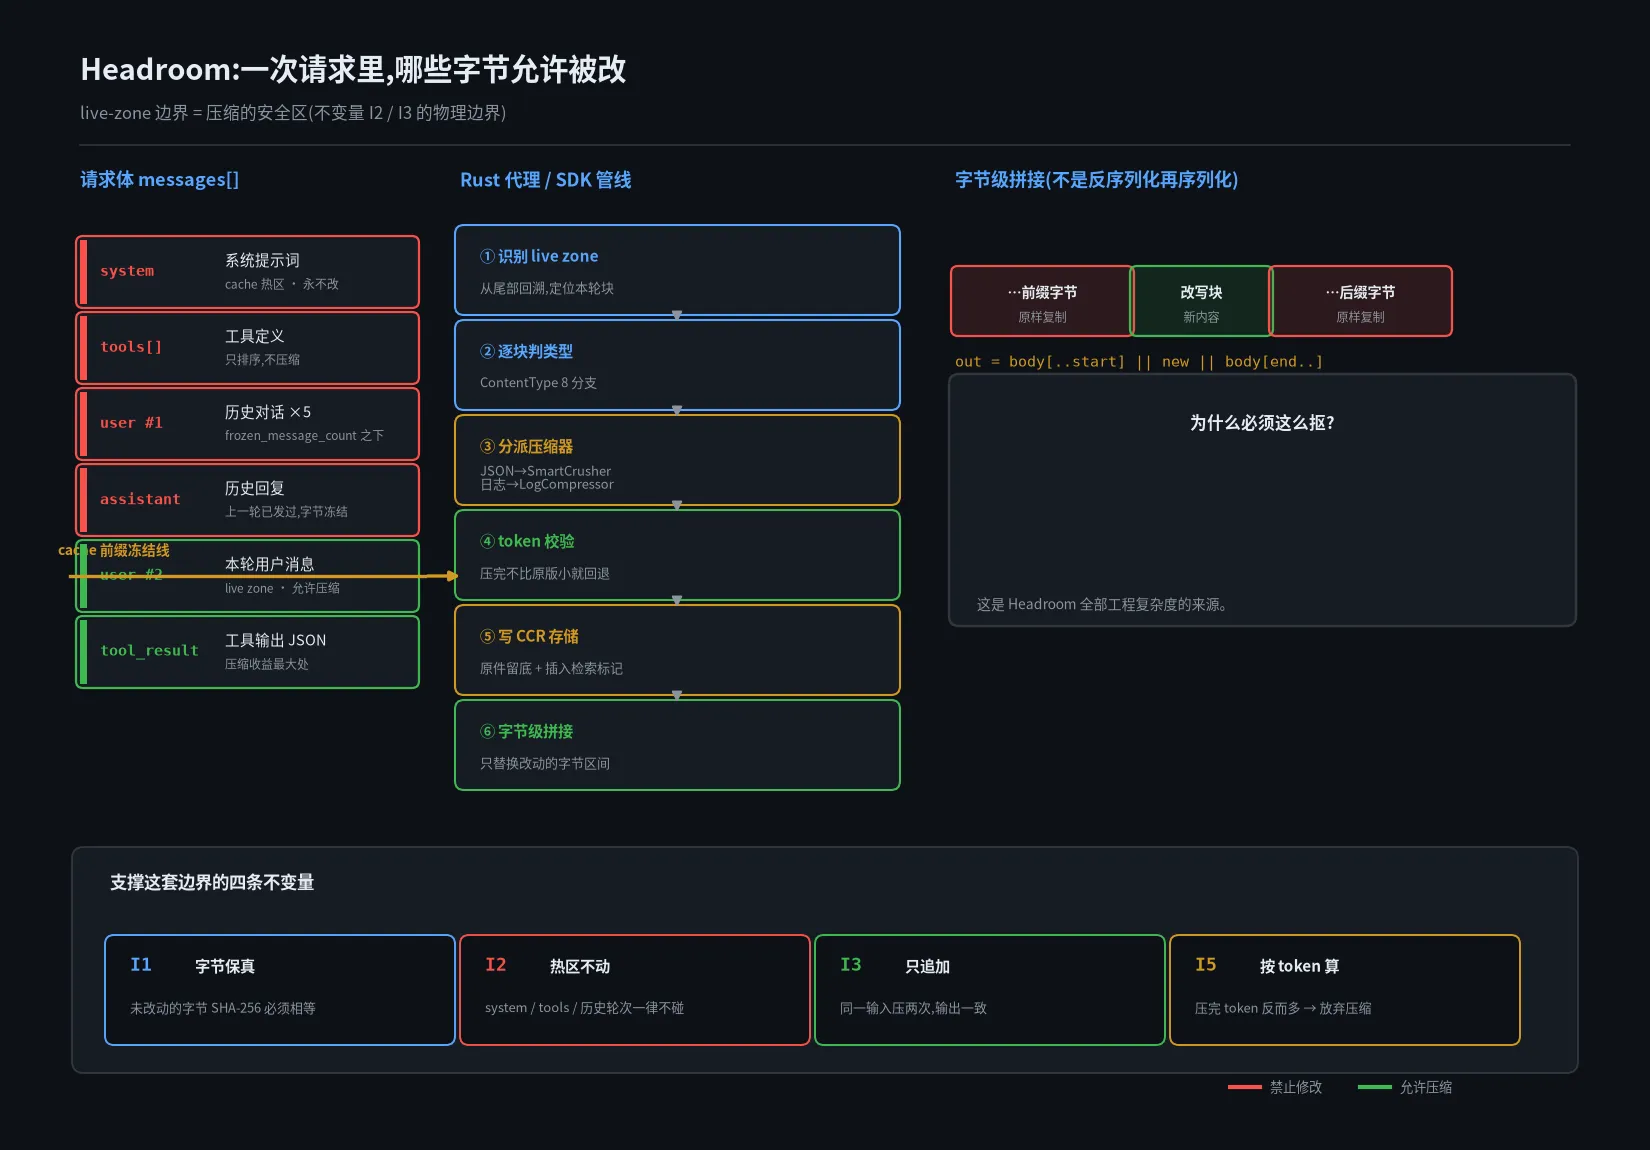
这张图里我特意标了三条不变量,因为整个项目基本就是围绕它们长出来的:
- I1 字节保真 —— 没被改动的字节,送到上游必须和收到的一模一样(SHA-256 相等)
- I2 热区不动 —— system / tools / 历史轮次一律不碰
- I5 按 token 算 —— 压完 token 反而变多,那就不压,原样发
字节级拼接:为什么不反序列化再序列化#
这是整个项目最让我觉得「学到了」的一个细节。
常规做法是:把请求体 parse 成 JSON 对象 → 改一改 → 再 json.dumps 出去。但这样一来,原始的空白、键序、数字格式(1.0 会不会变成 1?12345678901234567 会不会丢精度?)全都可能变,而 provider 的缓存是按字节算的。
Headroom 的做法是字节区间手术:
out = body[..block_start] || replacement || body[end..]serde_json::value::RawValue 会保留每个 messages[*] 原始片段的字节偏移量,改写完只把动过的那几段替换掉,其余部分逐字节原样拷贝。Rust 侧的 Cargo.toml 里为此开了三个 feature:
serde_json = { version = "1", features = ["preserve_order", "arbitrary_precision", "raw_value"] }preserve_order—— 用 IndexMap 而不是 BTreeMap,不然键序会被重排arbitrary_precision—— 数字保留原始字面量,1.0不会塌成1raw_value—— 拿到未解析的原始 JSON 片段
这三个开关,每一个都对应着一个具体的「不加就会出事」的场景。这种在依赖配置里写清楚「为什么」的注释,比注释本身更值钱。
3. 核心机制二:SmartCrusher,怎么把一份 JSON 压到只剩骨架#
live zone 划出来了,接下来是「里面装什么」的问题。Headroom 的管线是:
CacheAligner → ContentRouter → CCR
                 ├─ SmartCrusher   (JSON)
                 ├─ CodeCompressor (AST)
└─ Kompress-v2 (文本, HF 模型)ContentRouter 负责判断内容类型,分 8 类:JsonArray / SourceCode / SearchResults / BuildOutput / GitDiff / Html / Tabular / PlainText。判断方式是正则,不加载任何模型(上层还有个可选的 Magika ONNX 分类器,但注释里明确说了:失败时不静默回退到 PlainText,那种静默兜底是审计明确禁止的)。
我重点看了 SmartCrusher —— 处理 JSON 数组的那个。
五种策略,取决于数组长什么样#
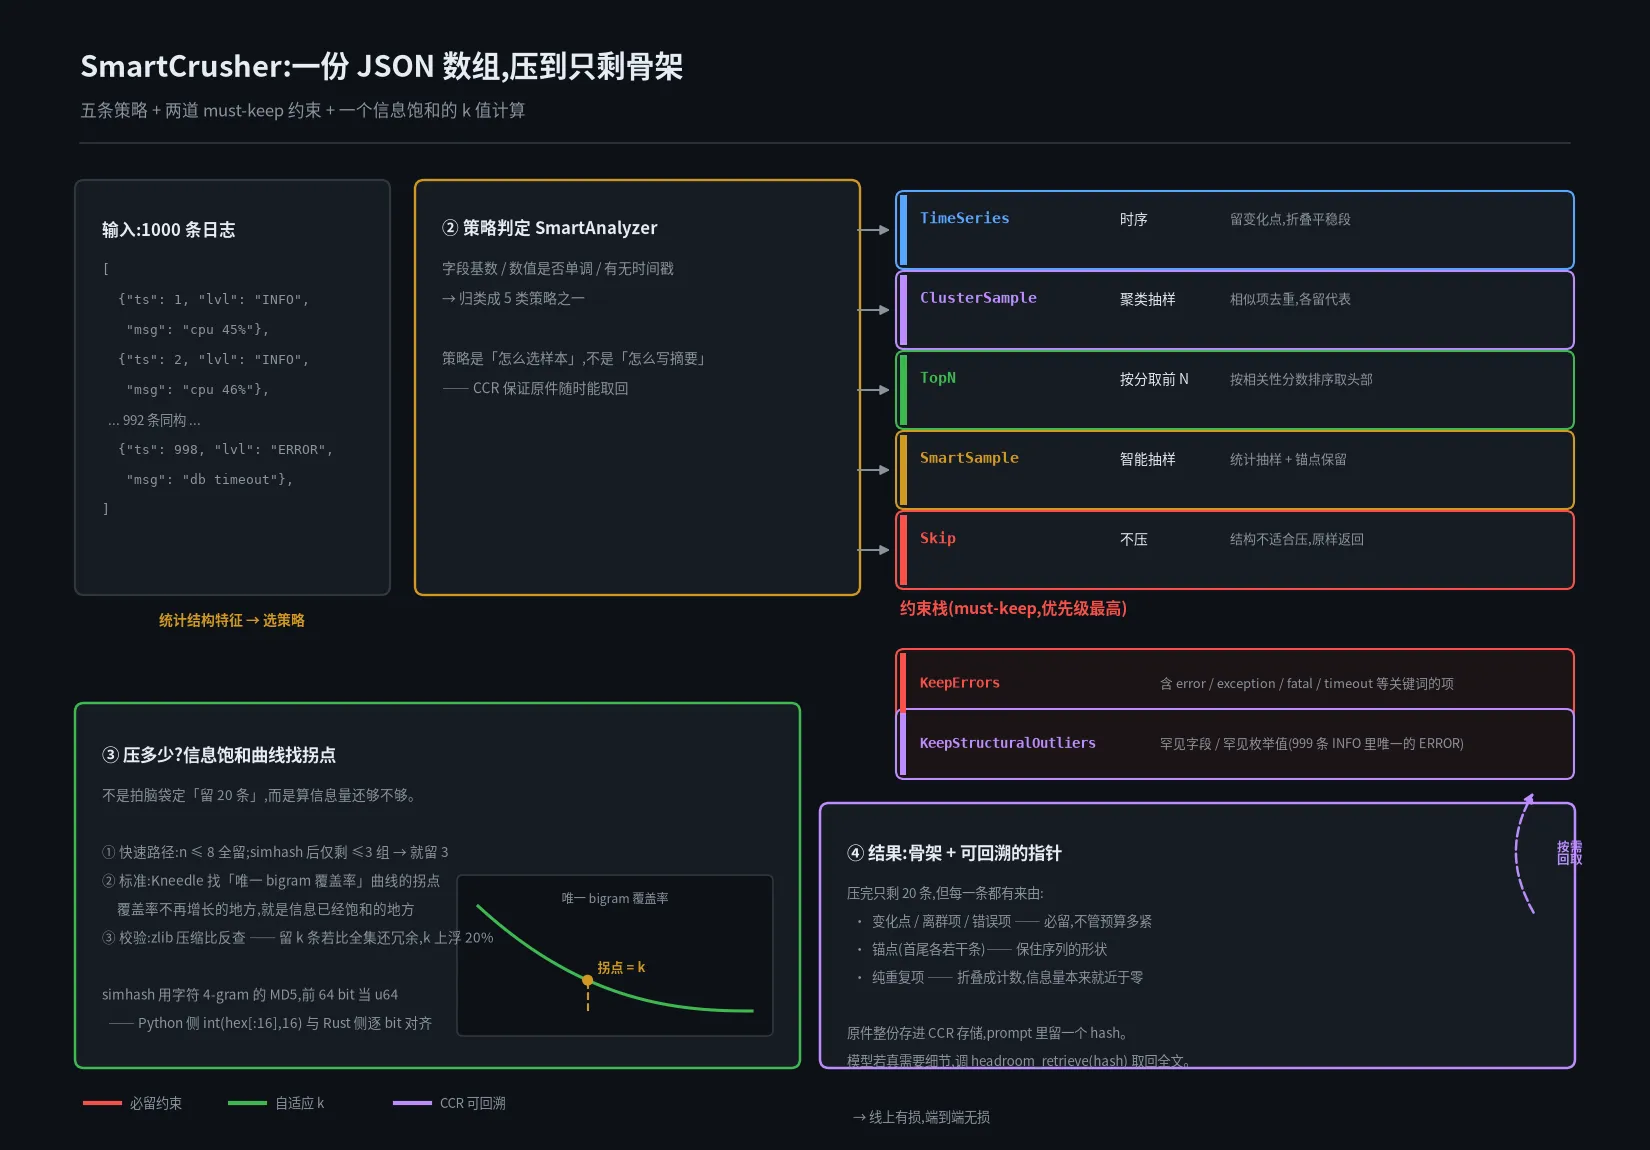
SmartAnalyzer 先统计数组的结构特征(字段基数、数值是否单调、有没有时间戳),然后归到 5 类策略之一:
| 策略 | 中文 | 什么时候用 | 怎么选 |
|---|---|---|---|
TimeSeries | 时序 | 数值随时间单调变化 | 留变化点,折叠平稳段 |
ClusterSample | 聚类抽样 | 大量相似项 | 去重,每簇留一个代表 |
TopN | 按分取前 N | 有明确相关性分数 | 排序取头部 |
SmartSample | 智能抽样 | 兜底 | 统计抽样 + 锚点保留 |
Skip | 不压 | 结构不适合压 | 原样返回 |
注意「策略」说的是怎么选样本,不是「怎么写摘要」。
两道 must-keep 约束#
不管选哪种策略,有两类条目是必留的:
KeepErrorsConstraint —— 含 error / exception / failed / fatal / critical / crash / panic / abort / timeout / denied / rejected 这些关键词的项。
KeepStructuralOutliersConstraint —— 结构上不合群的项,两种:罕见字段(某个 key 只在少于阈值的项里出现),以及常见字段的罕见值(比如 999 条 level: "INFO" 里唯一的 level: "ERROR")。
这两条被抽成了 Constraint trait,OSS 默认栈由 default_oss_constraints() 提供。注释里说得很清楚:抽出 trait 之后,行为和 PR1 之前的硬编码逐字节相同,只是给企业版的自定义约束留了口子。
压多少?信息饱和曲线找拐点#
这是我觉得最漂亮的一段。
它不是拍脑袋定「留 20 条」,而是算信息量还够不够。compute_optimal_k 三层判断:
- 快速路径 ——
n ≤ 8全留;如果 simhash 之后只剩 ≤3 组,那就留 3 - 标准 —— 在「唯一 bigram 覆盖率」曲线上跑 Kneedle 找拐点。覆盖率不再增长的地方,就是信息已经饱和的地方
- 校验 —— 用 zlib 压缩比反查:如果留 k 条产生的子集比全集还冗余,那 k 往上浮 20%
这里的 simhash 有个细节:用字符 4-gram 的 MD5,取前 64 bit 当 u64。Python 侧是 int(hex[:16], 16),Rust 侧是 big-endian 读前 8 字节 —— 完全等价,但要跨语言对齐就得写清楚。
find_knee 要求在归一化空间里偏离对角线 > 0.05,而且是严格不等号(< 返回 None)。这种「阈值差一丁点结果就翻盘」的地方,只有靠 fixture 锁死才敢动。
4. 核心机制三:CCR,让「有损压缩」变成「端到端无损」#
上面所有压缩都是有损的 —— 99% 的重复日志被丢掉了,信息是真的没了。
Headroom 的解法叫 CCR(Compress-Cache-Retrieve):
工具输出 1000 条
  → SmartCrusher 压到 20 条
  → 原件整份存进 CCR 存储,prompt 里留一个 hash
  → 给模型注入 headroom_retrieve 工具
        │
        ├─ 模型用 20 条就答完了  → 90% 省钱
└─ 模型觉得不够,调 headroom_retrieve(hash) → 全文取回关键在于这个回取是模型自己发起的,不是框架替它做主。模型有判断力:大多数时候 20 条够了,偶尔它需要看第 847 条,那就调工具取。
代理层拦截这个工具调用,从本地存储取回原文,再把结果塞回对话,客户端完全看不到这次 CCR 工具调用。
存储后端的三个选择#
Rust 侧 CcrStore trait 后面挂了三套实现:
InMemoryCcrStore—— 进程内 DashMap,测试默认,重启就没了SqliteCcrStore—— 生产默认,WAL 模式 + 预编译语句 + 读时惰性清理 TTLRedisCcrStore—— 多 worker 可选,不需要负载均衡器做 sticky session
有个细节我觉得挺贴心:默认 TTL 是 30 分钟,而且注释里解释了为什么从 5 分钟提到 30 分钟:
Session-scale: agentic sessions routinely outlive the old 5-minute default, and an expired entry silently converts “lossless with retrieval” into “lossy”.
一句话点出了「静默降级」的可怕 —— 你的兜底机制悄悄没了,你却不知道。
更妙的是 TTL 是空闲窗口而不是墙钟时间:每次成功 get 都会重置计时。所以一次长时间的 Agent 交互里,模型反复回取同一条记录,那条记录就能一直活着。
5. 核心机制四:CacheAligner,以及它「被阉割」的历史#
有个细节我一开始没看懂,后来读到 git 历史才明白。
CacheAligner 现在的实现是只检测、不改写。它只干一件事:用结构化解析器(不是正则)找出 system prompt 里的易变内容 —— UUID 用 stdlib 的 uuid 模块,ISO 8601 时间戳用 datetime.fromisoformat,JWT 只查形状(三段 base64url,不验签),十六进制哈希查长度和字符集(MD5=32 / SHA1=40 / SHA256=64)—— 然后打一条 warning 日志,提示用户「你的缓存前缀不稳定」。
它不碰 prompt 一个字节。
而文件头注释里写着:
The previous rewrite path (which strips dynamic content from the system prompt and re-inserts it as a context block) violated invariant I2 — the cache hot zone (system prompt) must never be mutated. That path has been removed.
所以这是先踩了坑,然后把路堵死的典型。系统提示词是缓存热区,任何”聪明的”改写都会让缓存失效。与其做一个聪明但会毁掉缓存的优化,不如老实只报警。
同理,REALIGNMENT/ 目录下有 13 个文档(01-bug-list.md 到 12-decisions-needed.md),把整个重构过程按 Phase A~I 记下来了。其中 01-bug-list.md 是一份 bug 清单,12-decisions-needed.md 是「还没想清楚要拍板的问题」。这个自我审计的密度,比代码本身更能说明团队的工程态度。
6. 核心机制五:同一个算法写两遍,还要逐字节对齐#
这是我觉得整个项目最费力、也最有价值的一部分。
现在的状态是:Python 是参考实现,Rust 是热路径。压缩核心(SmartCrusher / CodeCompressor / LogCompressor / DiffCompressor / ContentDetector / AdaptiveSizer)全部迁到了 Rust,Python 侧只留 dataclass 外壳 + 一个转发到 headroom._core(PyO3 扩展模块)的 shim。
文件头注释写得很明确:
The
headroom._coreextension is a hard import: there is no Python fallback.
没有兜底路径。要么 Rust 扩展能 import,要么就是崩。
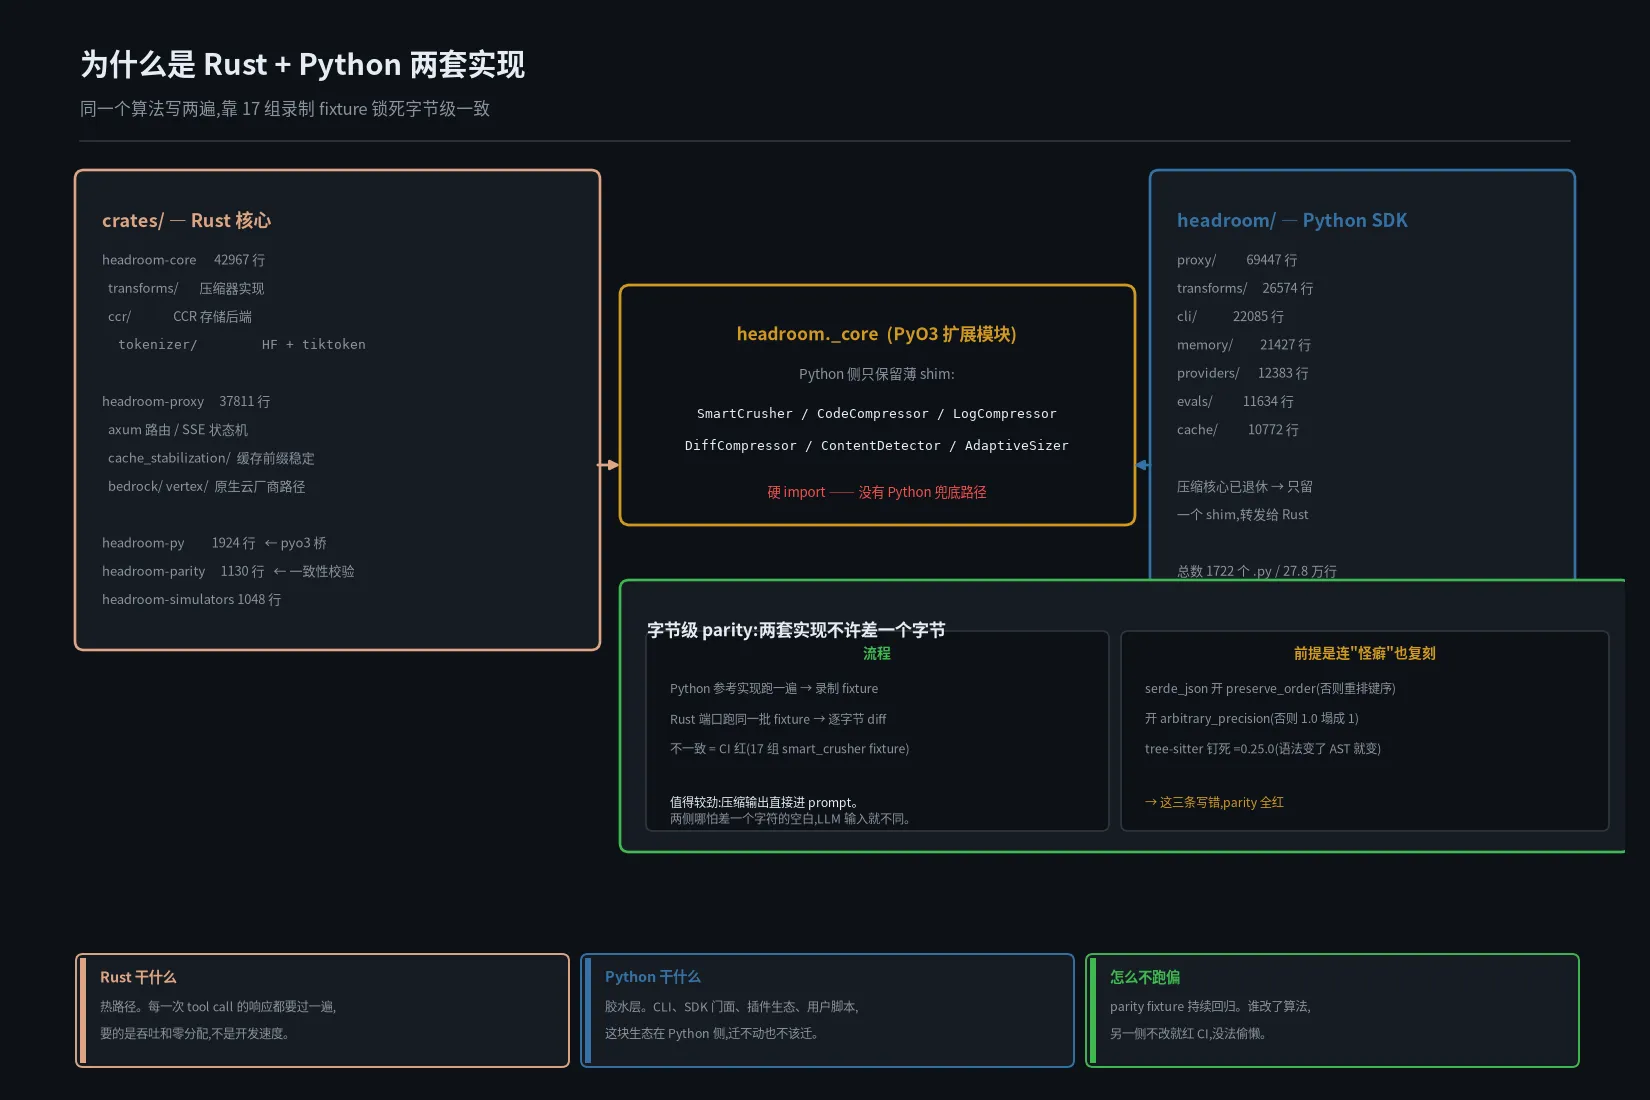
那怎么保证两套实现行为一致?靠 parity fixture:
- Python 参考实现跑一遍,把输入输出录制到 fixture 文件
- Rust 端口跑同一批 fixture,逐字节 diff
- 不一致 = CI 红
tests/parity/fixtures/ 下有 12 类 fixture(smart_crusher / log_compressor / diff_compressor / code_aware_compressor / content_detector / kompress / text_crusher / tokenizer / cache_aligner / ccr / codex_openai_contracts),smart_crusher 一个就有 17 组。
为什么值得较这个劲? 因为压缩器的输出会直接进 prompt。两侧算法哪怕只差一个字符的空白,LLM 看到的输入就不同,行为会漂移 —— 这种 bug 极难复现,极难定位。半吊子的一致性 = 随机性的 bug。
为了对齐,连「怪癖」都得复刻#
Rust 的 Cargo.toml 里那些 feature 开关,每一个都是踩过坑之后加的:
preserve_order—— 默认的 BTreeMap 会按字母重排键序,而 Python 的str(dict)保留插入顺序。不开这个,多键对象每个都对不上arbitrary_precision—— 不开的话Value::Number走 f64,1.0变成1,12345678901234567丢精度。注释里直接引用了 Realignment 不变量 I1raw_value—— 让 Phase B 能把没改动的messages[*]当精确字节副本转发
CodeCompressor 更狠,注释里承认了一个 Python 侧的潜在 bug:
All slicing that the Python reference does by byte offset into a
str(code[node.start_byte:node.end_byte]) is reproduced here as correct UTF-8 byte slicing (&code[start..end]). For ASCII inputs these are identical; for non-ASCII identifiers/strings the Python path is latently buggy (slices astrby byte index) and the two diverge. Parity fixtures are therefore ASCII; non-ASCII is out of parity scope.
翻译成人话:Python 按字节偏移切字符串,对 ASCII 没问题,遇到中文标识符就可能切坏。Rust 侧是正确实现,但为了「对齐」故意保留了 Python 的行为边界 —— fixture 只录 ASCII,非 ASCII 明确划出 parity 范围之外。
这种「我知道你那边有 bug,但我故意不修,因为一修 fixture 就全红了」的注释,是整个项目里信息密度最高的一段。 它同时告诉了你:哪里有坑、为什么没修、修了对谁有影响。
tree-sitter 那边也是同样的路子 —— 依赖版本钉死 =0.25.0,注释说 9 个样本 × 8 种语言做过 canary,确认 node-type 和行列 span 树 100% 一致。
几个具体的 bug 修复#
Rust 端口的注释里还记了一批 Python 侧的 bug,每一个都配了一个 fixed_in_3e5 标记:
TagProtector 的 O(n²) 和「替换第一个」的 bug
Python 版用 result.replace(original, placeholder, 1) 替换占位符,但 replace 匹配的是第一个文本出现位置,不是匹配到的那个 offset。同一份输入里有两个一模一样的自定义标签块时,会塌成一个占位符 + 重复的另一半。Rust 版改成基于 offset 的单遍扫描,线性时间。
LogCompressor 的 stack-trace 状态机
Python 版遇到任何空行就终止,结果 chained exception 的 trace(中间有分隔空行)会丢一半帧。Rust 版按 flavor 分别定义终止规则。
LogCompressor 的去重过于激进
Python 的 _dedupe_similar 把数字、路径、hex 全部归一化成 token,结果「不同地址的 segfault」和「不同 ID 的测试失败」会被合并成一条。Rust 版保留了冒号前的消息前缀,只归一化尾部的变量区。
CCR 存储失败静默
Python 把存储的异常全吞了,Rust 改成 tracing::warn!,Python shim 也记 warning 级别 —— 运维能看见配错的 store。
这些不是「顺手修的小 bug」,是同一个算法在两种语言里各自长歪,然后靠 fixture 一个个揪出来。
7. 核心机制六:auth mode,同一套压缩对三种人三套策略#
最后一块拼图是 CompressionPolicy。请求进来先分类成三种付费模式:
| 模式 | 策略 | 具体差异 |
|---|---|---|
| PAYG(按量付费) | 激进 | 全量 live-zone 压缩、CCR、工具注入、Phase 3 稳定化 |
| OAuth | 保守优先透传 | live-zone 只做无损压缩,不自动加 cache_control,不自动加 prompt_cache_key,不加 X-Forwarded-* |
| Subscription(订阅制) | 隐身优先 | OAuth 的全部,外加保留 accept-encoding、绝不向上游注入 X-Headroom-*、绝不改 User-Agent |
为什么要分?因为订阅制用户的请求是要「假装成没经过代理」的 —— 很多 provider 检测到中间层就降级或拒绝。而 PAYG 用户只关心账单,能压多重压多重。
代码里专门解释了这个模式:
Centralisation. Without a policy struct, the per-mode decision is duplicated at every gate (E3 cache_control, E4 prompt_cache_key, the new live-zone gate, the new cache_aligner gate, …). When F2.2 wants to tune (e.g. allow OAuth users a relaxed live-zone gate but stricter volatile-detector threshold) we’d need to find every site.
用结构体而不是到处 match auth_mode { ... },理由有二:一是集中,二是可测 —— for_mode(AuthMode) -> CompressionPolicy 是纯函数,能便宜地做属性测试,不用跑一整套请求 fixture。
8. 顺便说说其他几个有意思的模块#
headroom learn —— 挖失败会话,把纠正写进 CLAUDE.local.md(默认,gitignore)/ CLAUDE.md / AGENTS.md / GEMINI.md / GROK.md。
它的分析器文件头写着:「No regex patterns, no static lookback windows, no hardcoded heuristics. A single LLM call understands the full conversation context」。整个 pipeline 是 Scanner → Digest Builder → LLM → Recommendations,一次 LLM 调用出结构化建议。
调用 CLI 后端(claude / gemini / codex)那段注释特别实在:
--tools ""and--strict-mcp-configleave the analysis session with zero tools: the digest is the whole input and the answer is one JSON object, but a headlessclaude -pis otherwise a full agent (Bash, Edit, Task, every MCP server) under the user’s own permissions. A model that goes off to read or verify things keeps streaming, so the idle cap never fires and the run dies at the hard cap with nothing written.
翻译:不加这两个 flag,claude -p 是个完整 Agent,拿着你的权限去到处读文件,模型自己跑去”核实”了,于是永远不 idle,最后被硬超时杀掉,什么建议都没写出来。
跨 Agent 共享记忆 —— headroom/memory/ 21 万行,默认后端是 SQLite + HNSW + 内存图,零配置不用起 Docker;生产模式切 Qdrant + Neo4j,API 不变。
headroom wrap —— 一条命令包住 coding agent:
headroom wrap claude|codex|grok|copilot|cursor|aider|opencode|cline|continue|goose|openhands|openclaw|vibe|omp|zcode
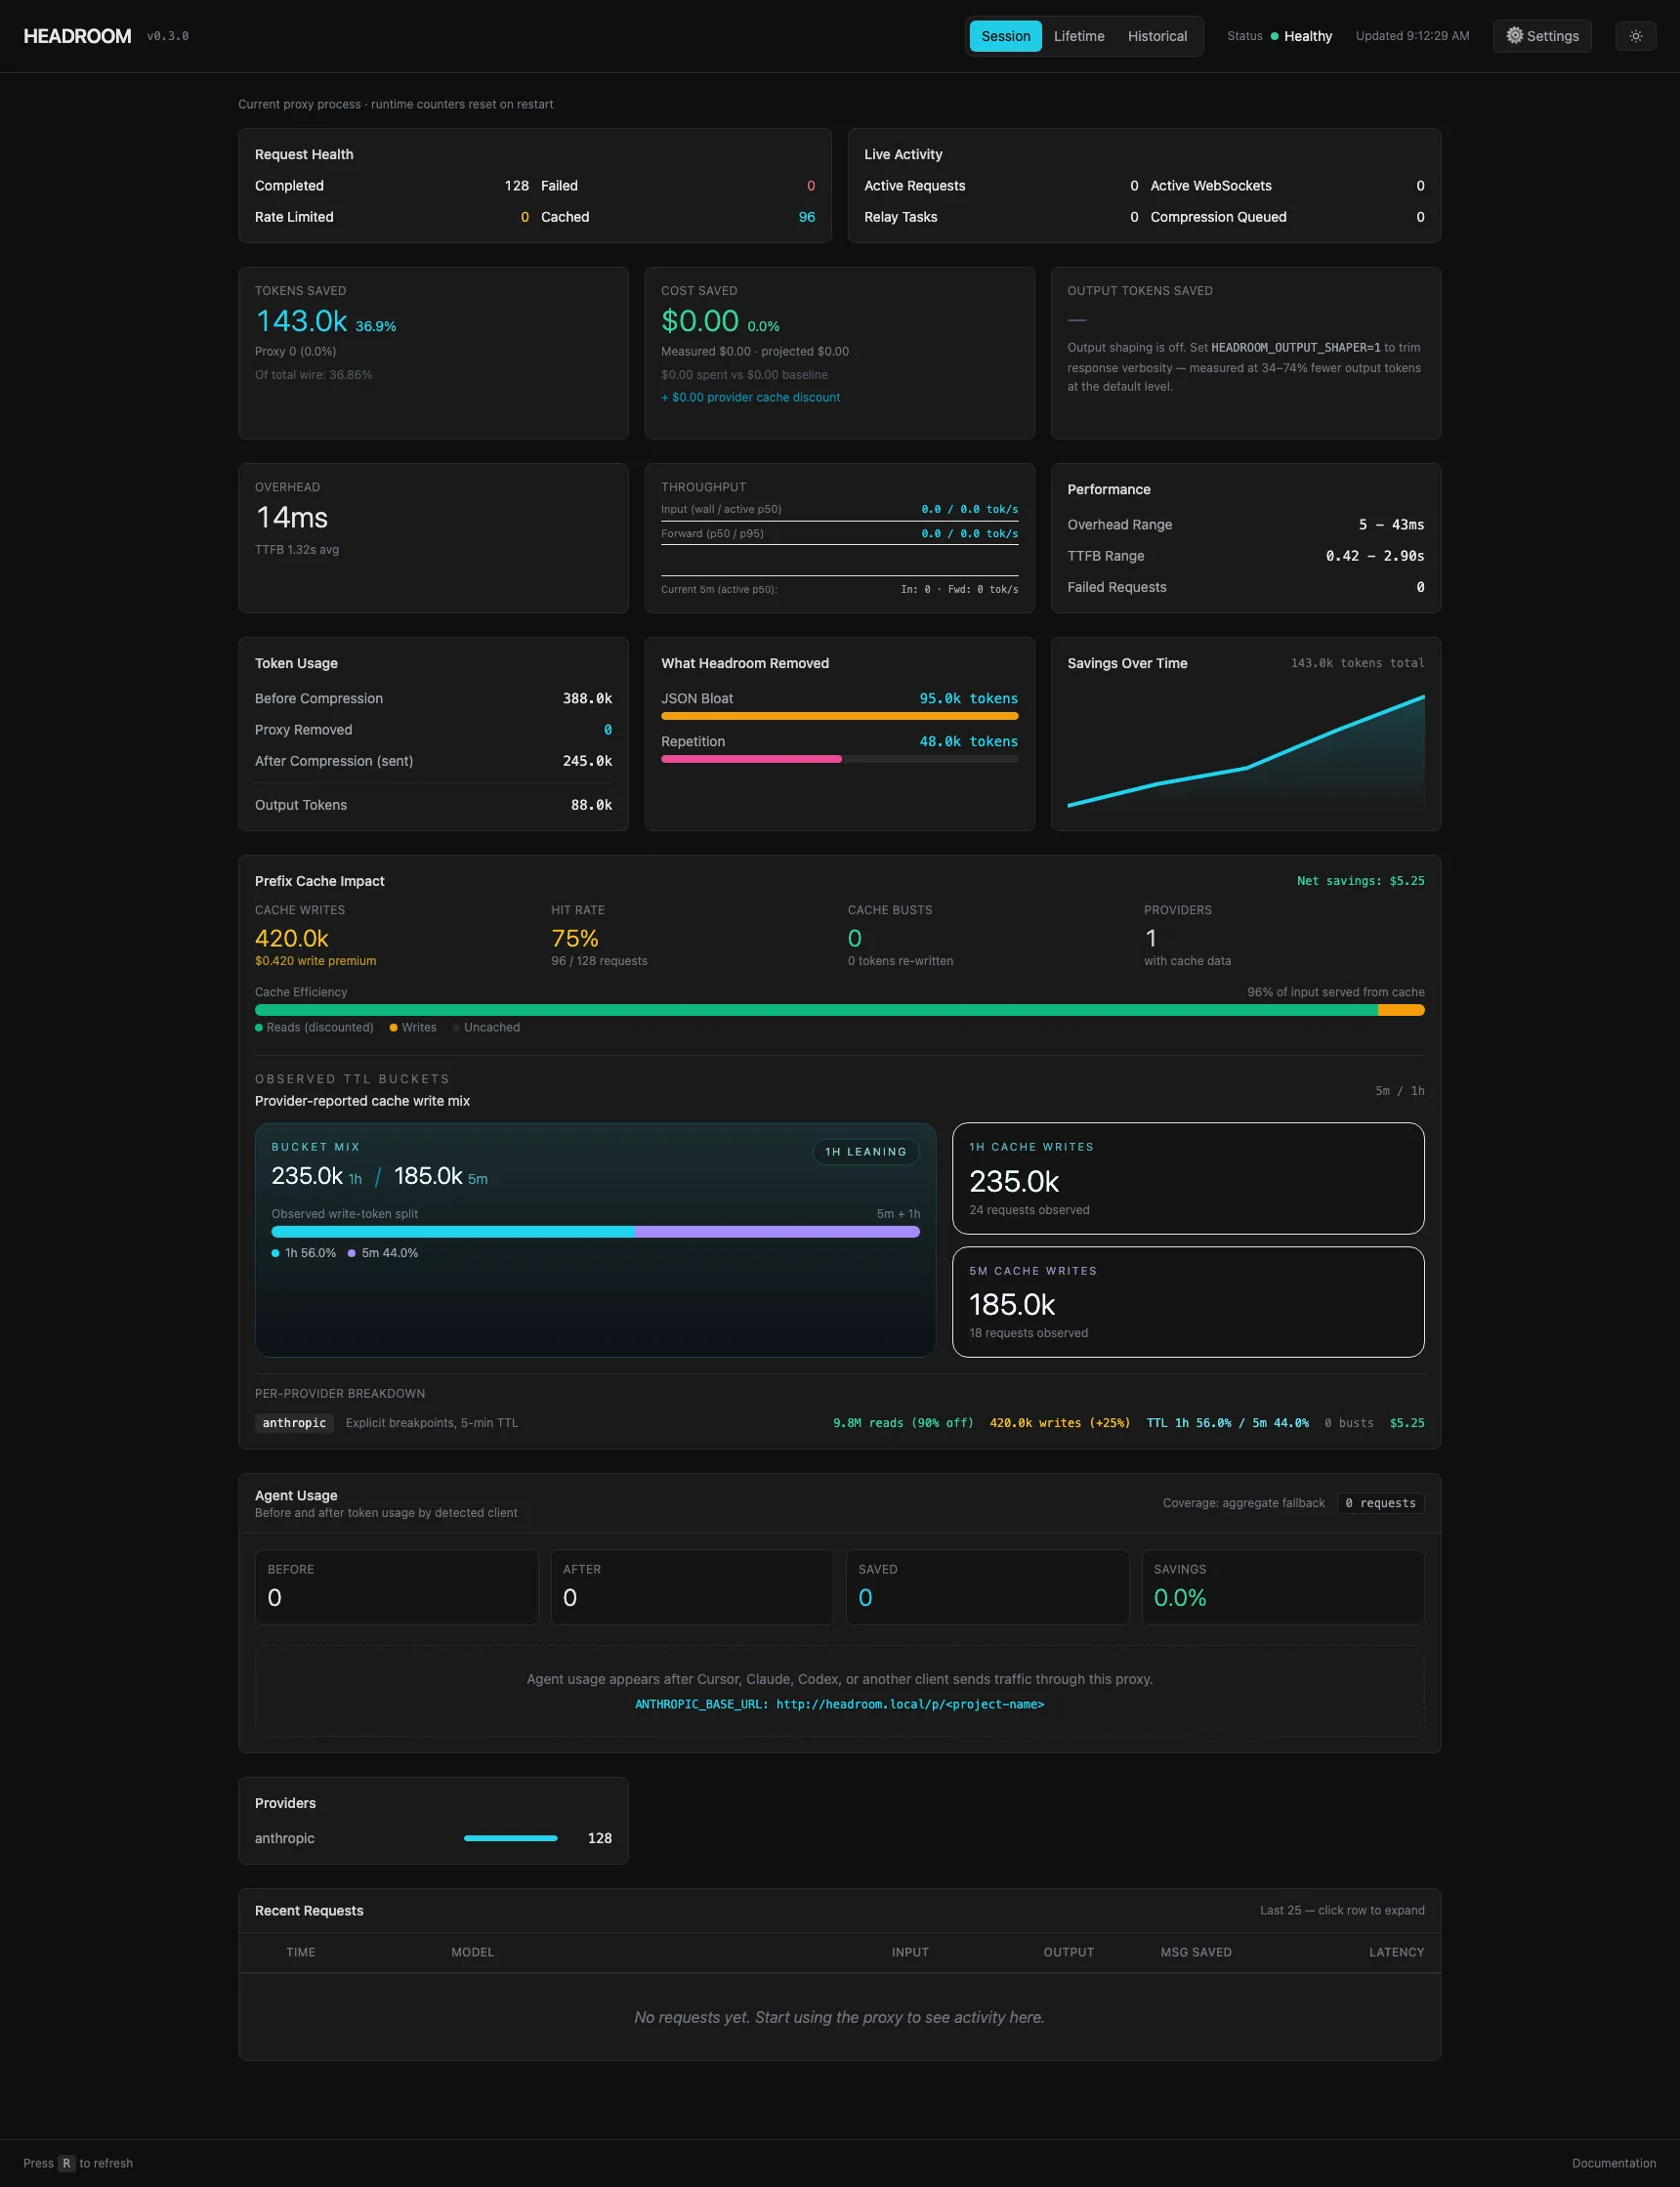
headroom unwrap <tool> # 撤销Dashboard —— 官方晒的社区数据(项目原图):
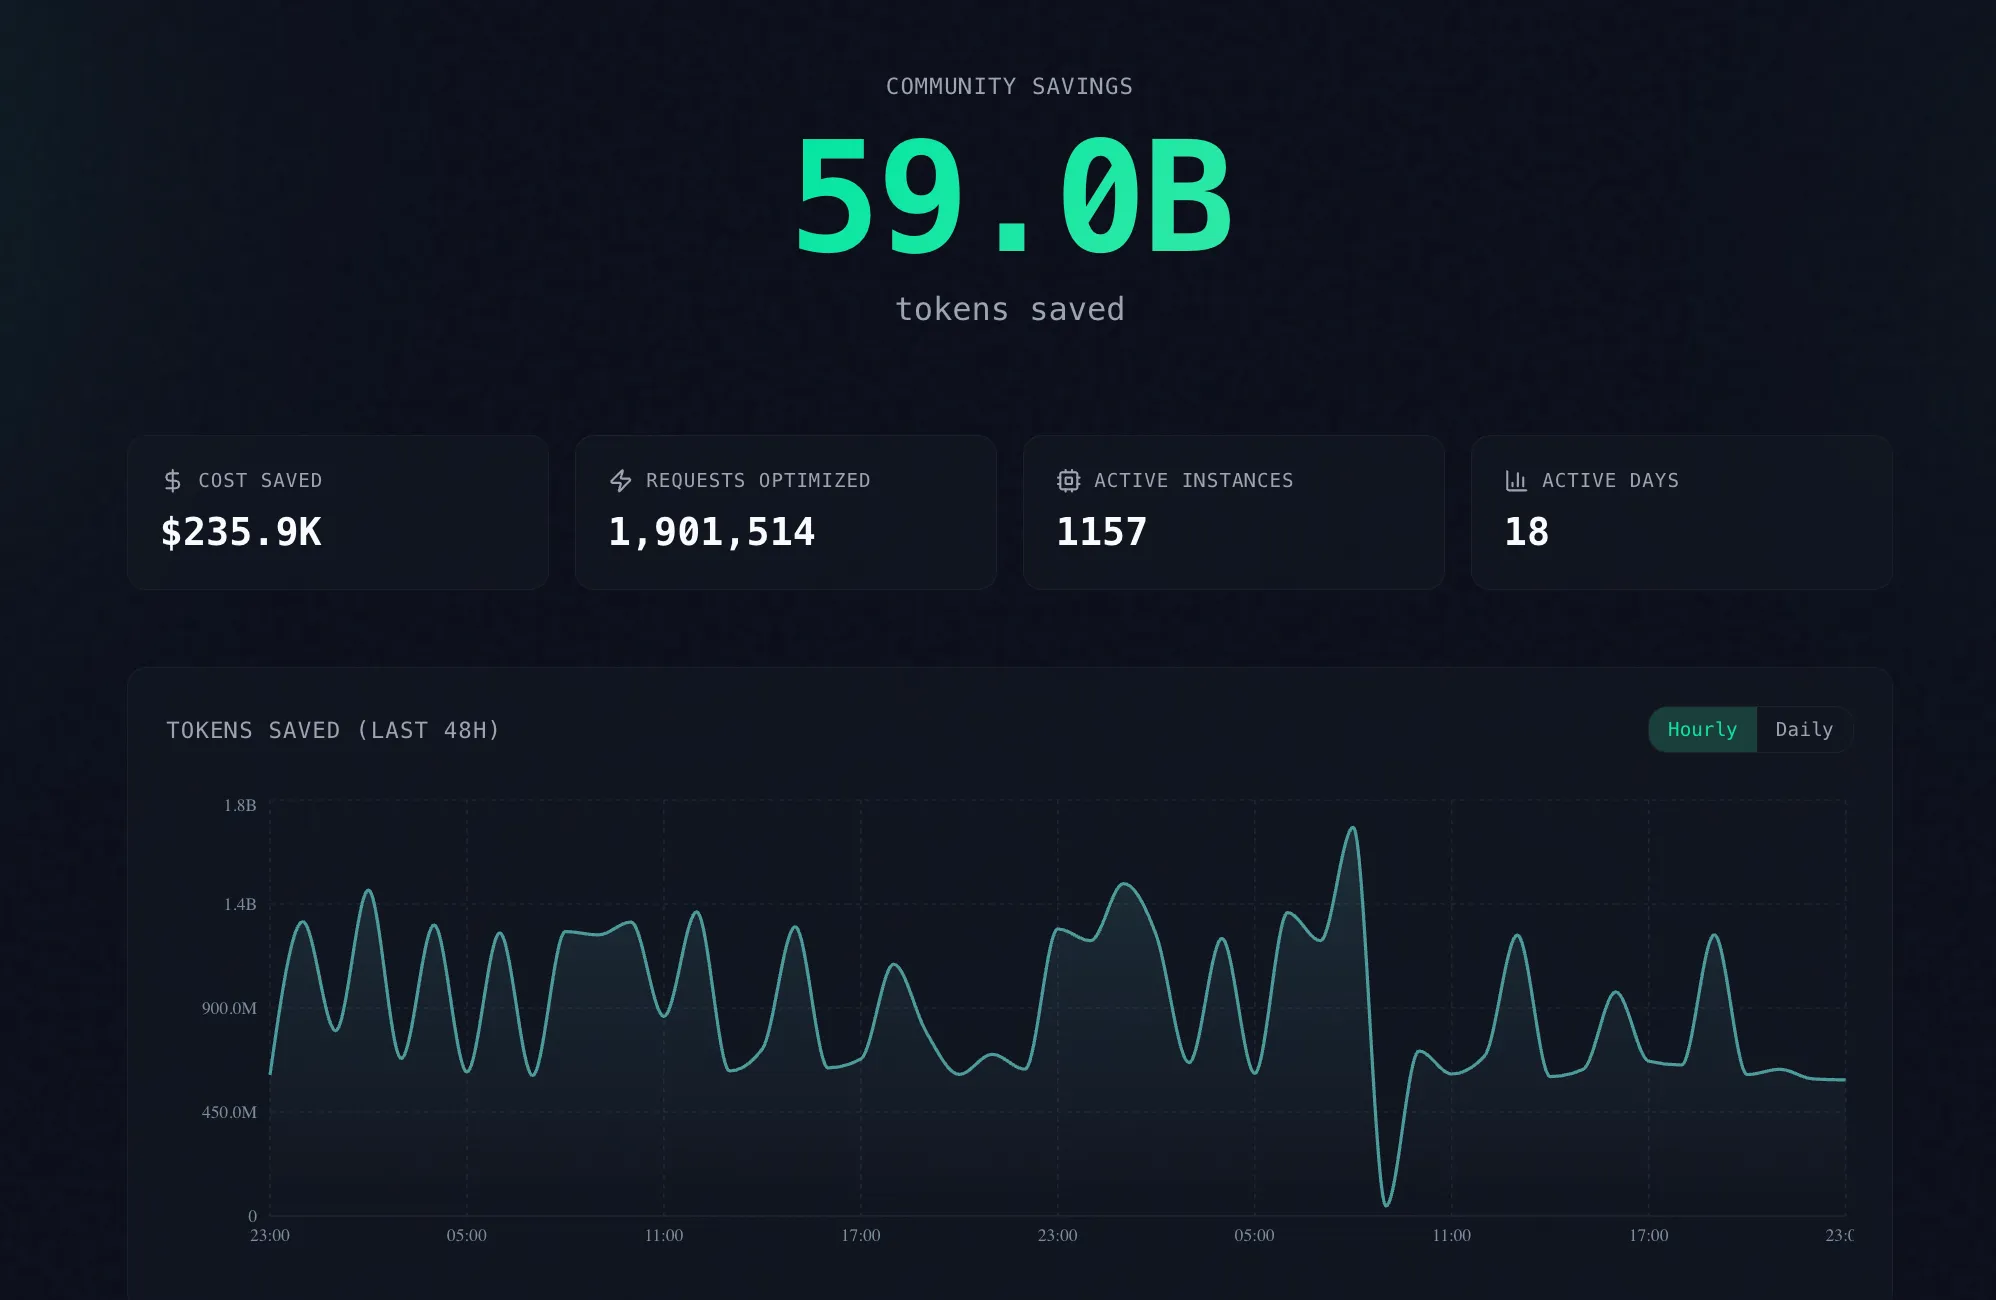
59.0B tokens saved、190 万次请求被优化、1157 个活跃实例、$235.9K 成本节省。这数字是全球口径,我没法验证,但至少它的 dashboard 本身做得挺干净。
9. 我觉得最值得抄的三个设计#
看完之后我挑了三个我觉得可以直接搬到别的项目里的做法。
一、把「不许动」写成一等公民#
大部分做代理优化的项目,默认状态是「我会修改你的 prompt」。Headroom 反过来:默认不动,只有 live zone 才有资格动,而且连 live zone 内部改完还要 token 校验 + 字节保真。
关键在于它把这些约束变成了显式的不变量,并且给每条不变量配了一个测试门禁:
- I1 →
proxy_byte_faithful_anthropic_sha256 - I2 →
cache_hot_zone_unchanged_under_compression - I3 →
append_only_invariant_under_recompression - I5 →
proptest_compression_token_count_non_increasing
「不可变性」不该只活在 wiki 里,应该活在能跑失败的测试里。
二、宁可报错,不要静默兜底#
这个项目里我看到好几次同一句话的变体:
We deliberately do not silently return
PlainTexton error — that’s the kind of silent fallback the audit doc forbids.
Magika 模型加载失败不静默降级;CCR 存储异常不静默吞掉;用户传了自定义 scorer 就不实现,直接 NotImplementedError 抛出来。
smart_crusher.py 里这段尤其戳我:
Silently dropping a user-supplied scorer is a silent-fallback bug we explicitly refuse to ship.
静默降级是 AI 系统里最阴险的一类 bug —— 它不会报错,不会崩溃,只是在某个角落悄悄让结果变差。而 Headroom 选择「宁可崩」。
三、把「怪癖」也当成契约的一部分#
跨语言 parity 那套东西,表面上是「两份实现要一致」,实际上它逼着你回答一个更难的问题:这个算法的语义边界到底是什么?
Python 按字节切字符串对 ASCII 正确、对中文有 bug —— 那 parity 范围到底包不包含中文?答案写进注释:不包含,划出范围。这个决定比「两边跑通」重要得多,因为它把边界变成了可讨论、可审查的东西。
10. 一些没藏住的取舍#
这个项目也不是没有代价,有几个地方我认为是明显的坑:
磁盘换内存。 delete_original=True 才不留双份 checkpoint,否则磁盘直接翻倍。CCR 的原件也占地方,30 分钟 TTL 缓解了一点,但高频大对象场景存储压力不小。
压缩和缓存前缀天然冲突。 你压缩 tool_result,内容长度就变了,而 tool_result 往往在缓存前缀里。这个矛盾 Headroom 用 live-zone 边界化解了 —— 意味着你只能在最新一轮的工具输出上省 token,历史轮次动不了。这也是为什么基准表里 protect_recent=4 和 protect_recent=0 的数字完全一样(都是 41%):能压的都压了。
速度换钱。 多一次 tokenize + 一次内容解析,是净增的 CPU 开销。收益体现在账单和上下文窗口上,不在延迟上。
Rust 扩展是硬依赖。 headroom._core 没有 Python fallback,装不上就是装不上。对纯 Python 用户来说,这是个挺硬的门。
官方数字有水分。 41% 的总节省是在「合成的、特意构造得高度重复」的语料上测的。真实场景里,工具输出未必那么同质。仓库自己的文档也提醒了:「Savings depend on how repetitive your tool output is, so treat these as a shape, not a promise」。这种自我打折反而让数字更可信。
11. 小结#
Headroom 表面上是个压缩工具,实际上是一份**「在 LLM 代理链路上,什么绝对不能碰」的工程契约**。
它真正的贡献可能不是那 41%,而是这几件事:
- 用 live-zone 把「能压」和「不能压」的边界画在了字节级别
- 用 10 条不变量 + 对应测试门禁,把「不能碰」变成了可执行约束
- 用 CCR 把「有损」变成了「线上有损、端到端无损」
- 用 parity fixture 逼着跨语言实现对齐,顺带把算法的语义边界逼清楚了
- 用「宁可报错不要静默兜底」的立场,挡掉了 AI 系统里最难查的一类 bug
如果我给自己的 Agent 加一层上下文治理,我会先照抄它的 live-zone 边界和 token 校验门禁这两条 —— 成本最低,收益最直接。
至于要不要上 Rust,那就看你的热路径有多热了。