Higgsfield 深度解析:把 GitHub Actions 当分布式训练调度器
💬 评论5,384 Star 的 Higgsfield 用 AST 把实验参数编译成 GitHub Actions 工作流,让 CI 去编排多机多卡的训练。这套设计里有很多值得抄的巧思,也有很多一碰就响的地方。
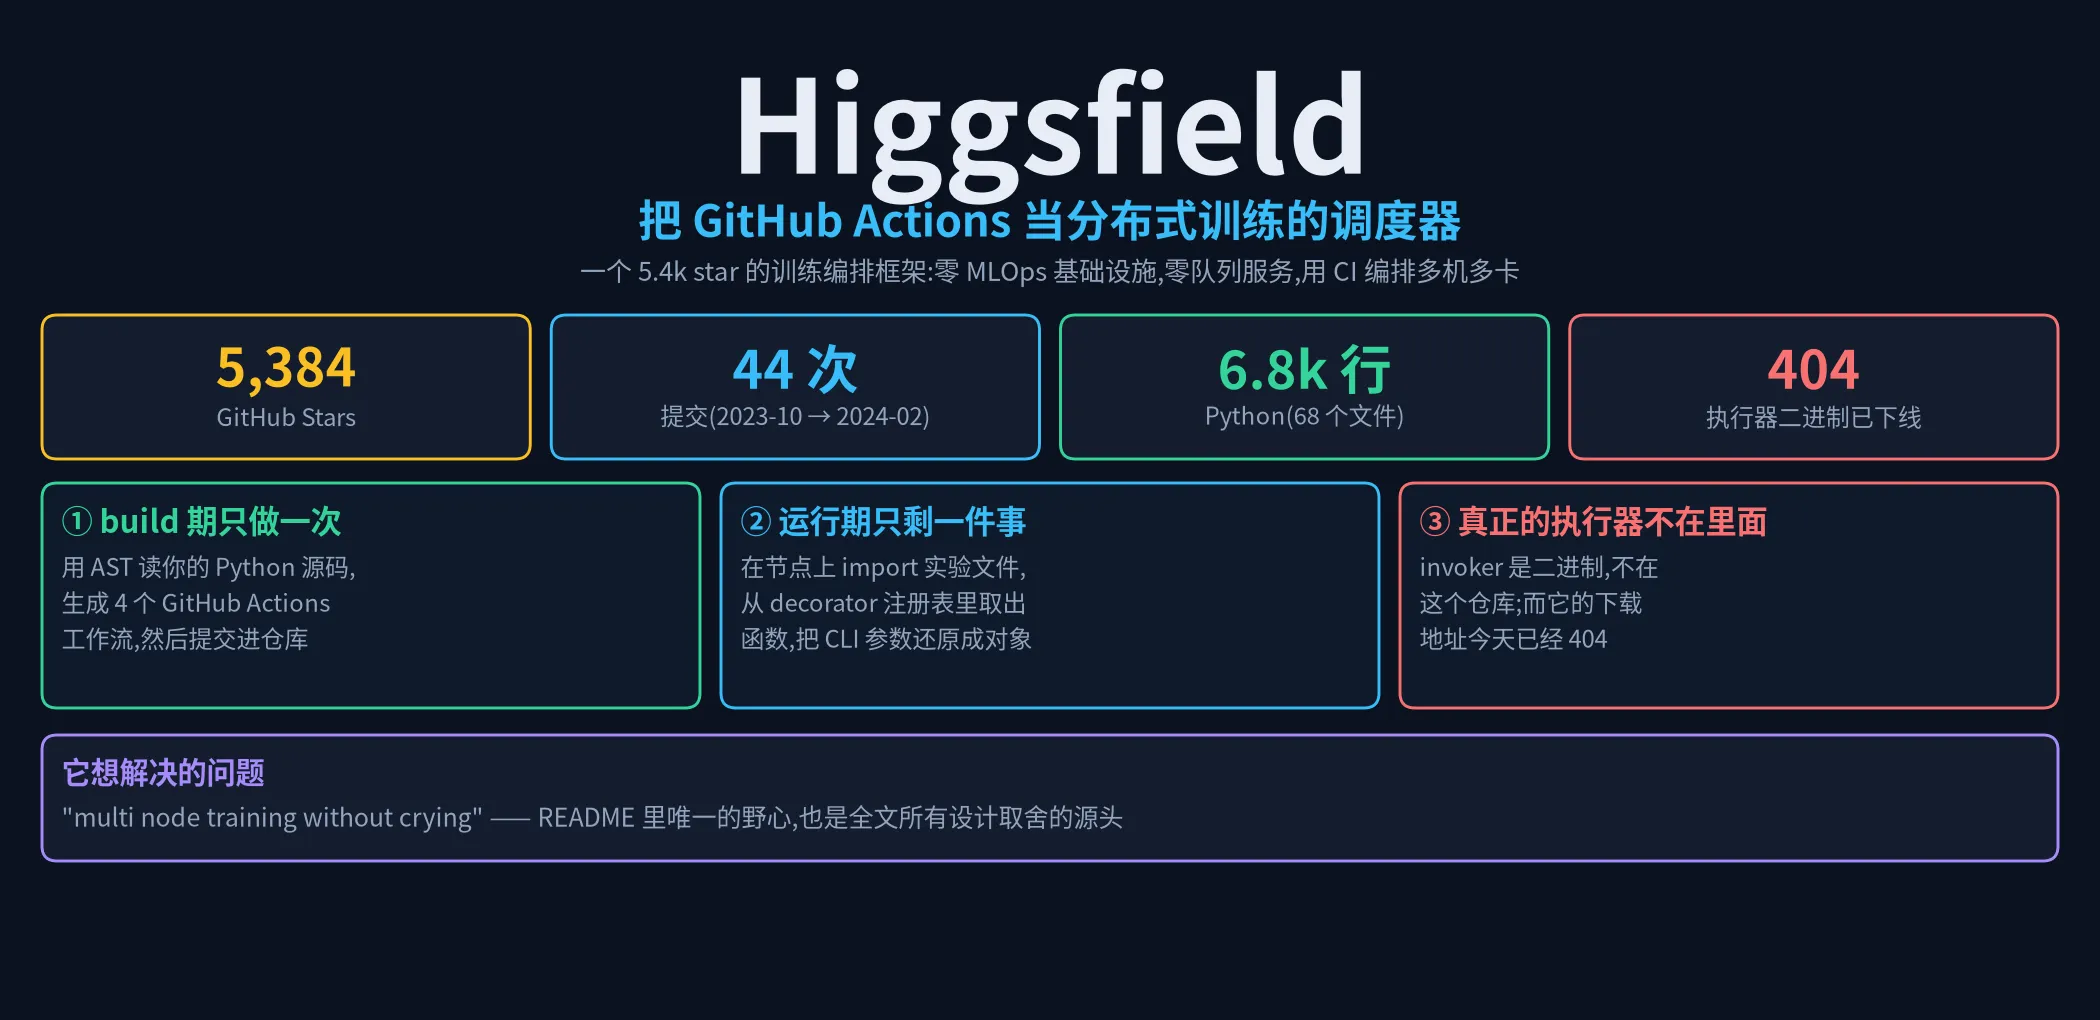
仓库:higgsfield-ai/higgsfield ↗ Apache-2.0 · PyPI
higgsfield==0.0.3· 5,384 stars / 956 forks(统计于 2026-09-21) 68 个 Python 文件 / 约 6.8k 行 · 44 次提交 · 活跃期 2023-10-10 → 2024-02-14
先问一个问题。
假设你手上有一批 GPU 机器,想把一个 70B 的模型微调起来。你会怎么搭这套系统?
正经的答案是:装 Slurm 或者上 K8s,写一堆 YAML,配好 NCCL、RDMA、共享存储,再找个人维护调度器。轻一点的答案是 Ray 集群,再轻一点是 deepspeed 的 launcher,再再轻一点是 torchrun 加一条 SSH 命令。总之,你总得在”训练代码”之外,再养一套”机器管理”的东西。
Higgsfield 给了一个很不正经、但很有意思的答案:
把 GitHub Actions 当成调度器。
它的 README 副标题只有一句话 ——「multi node training without crying」。你想在 8 台机器上跑 LLaMA,要做的全部事情是:在自己的笔记本上敲两条命令,然后去 GitHub 网页上点一个 Run workflow 按钮。
这听起来像是把 CI 玩坏了。但看完它的实现,我发现这个”玩坏”里藏着几处真正的设计智慧 —— 也有几处一碰就响的坑。这篇文章就按它自己的三条时间线来读:build 期在你的笔记本上、CI 期在 GitHub 的 runner 上、运行期在你那批 GPU 节点上。
一、先把这份代码的身份查清楚#
读代码之前,值得花两分钟确认一件事:这到底是谁写的,写给谁的,然后为什么停下了。
- 作者是 Yerzat Dulat(GitHub 用户名 @higgsfield ↗)。如果你在强化学习圈子里待过,大概率见过他的作品:RL-Adventure ↗(3,179 stars)、Capsule-Network-Tutorial ↗(765 stars)、np-hard-deep-reinforcement-learning(388 stars) —— 都是那种”把一个算法从论文讲到能跑的 notebook”的教程仓库。
- 公司是 Higgsfield Inc.(“AI lab”,higgsfield.ai ↗),GitHub 组织建成于 2023-09-27。这个仓库
higgsfield-ai/higgsfield里的文件,今天还是组织下的门面。 - 而仓库的第一个提交(2023-10-10
73fadfa,“add: tutorials”)做的唯一一件事,是把 RL-Adventure-2 的 9 个 notebook 搬进来。也就是说:这个 LLM 训练框架,是在自己的 RL 教程仓库里诞生的。 直到今天,包里还留着higgsfield/rl/rl_adventure_2/这个目录,以及两条Merge branch 'main' of github.com:higgsfield/RL-Adventure-2的历史 —— 一个仓库的出身,是可以从 git log 里读出来的。
然后是时间线,这个更关键:
| 时间 | 发生了什么 |
|---|---|
| 2023-10-10 → 2023-11-24 | 密集开发:项目骨架、模板、CI、Mistral 支持、许可文件 |
| 2024-01 → 2024-02-14 | 只剩零星修修补补,main 停在 d12a36e(Update llama.py) |
| 2024-03-23 | dev 分支最后一次提交,打出唯一一个 tag:v0.0.4-rc |
| 2024-03 → 2026-09 | 没有一次人工提交 |
| 2026-09-14 | 仓库级 pushed_at 更新,来源是一支 Snyk 机器人的分支 |
顺带看一眼那个 Snyk 提交的内容,你能闻到时间的气味。它给 requirements.txt 加了这么两行:
 higgsfield==0.0.3
+transformers>=5.0.0rc3 # not directly required, pinned by Snyk to avoid a vulnerability
+torch>=2.8.0 # not directly required, pinned by Snyk to avoid a vulnerability这份依赖清单原本钉在 2024 年初:optimum==1.13.2、peft==0.5.0、datasets==2.14.5。用 2026 年的 transformers 5.0 和 torch 2.8 去喂 2024 年的 optimum 1.13 和 peft 0.5,基本等于换了地基不换房子。机器人只负责把 CVE 从报告里划掉,不负责让代码还能跑 —— 这就是一个休眠仓库的”供应链式腐烂”。
有意思的是另一头:同一个组织今天还在活跃,但做的是完全不同的事 —— cli(564★)、skills(1,078★)、higgsfield-client(105★)、higgsfield-js(57★)、homebrew-tap、cursor-plugin,最近提交都在 2026-09 中下旬。这套老仓库讲的是”怎么用开源代码在裸金属上训练大模型”,那批新仓库讲的是”怎么让 agent 调我们的视频生成 API”。一个组组织里并排放着两块化石层:开源基础设施的时代,和 agent 工具链的时代。
那为什么还要读这层老化石?
因为它的核心命题至今没有人给出更好的答案:如果你不想养调度器,能不能把 CI 当调度器用? 而它给出的答案里,有几处精妙到值得抄进任何项目,也有几处糟糕到值得当反例讲。下面按它的三段式来。
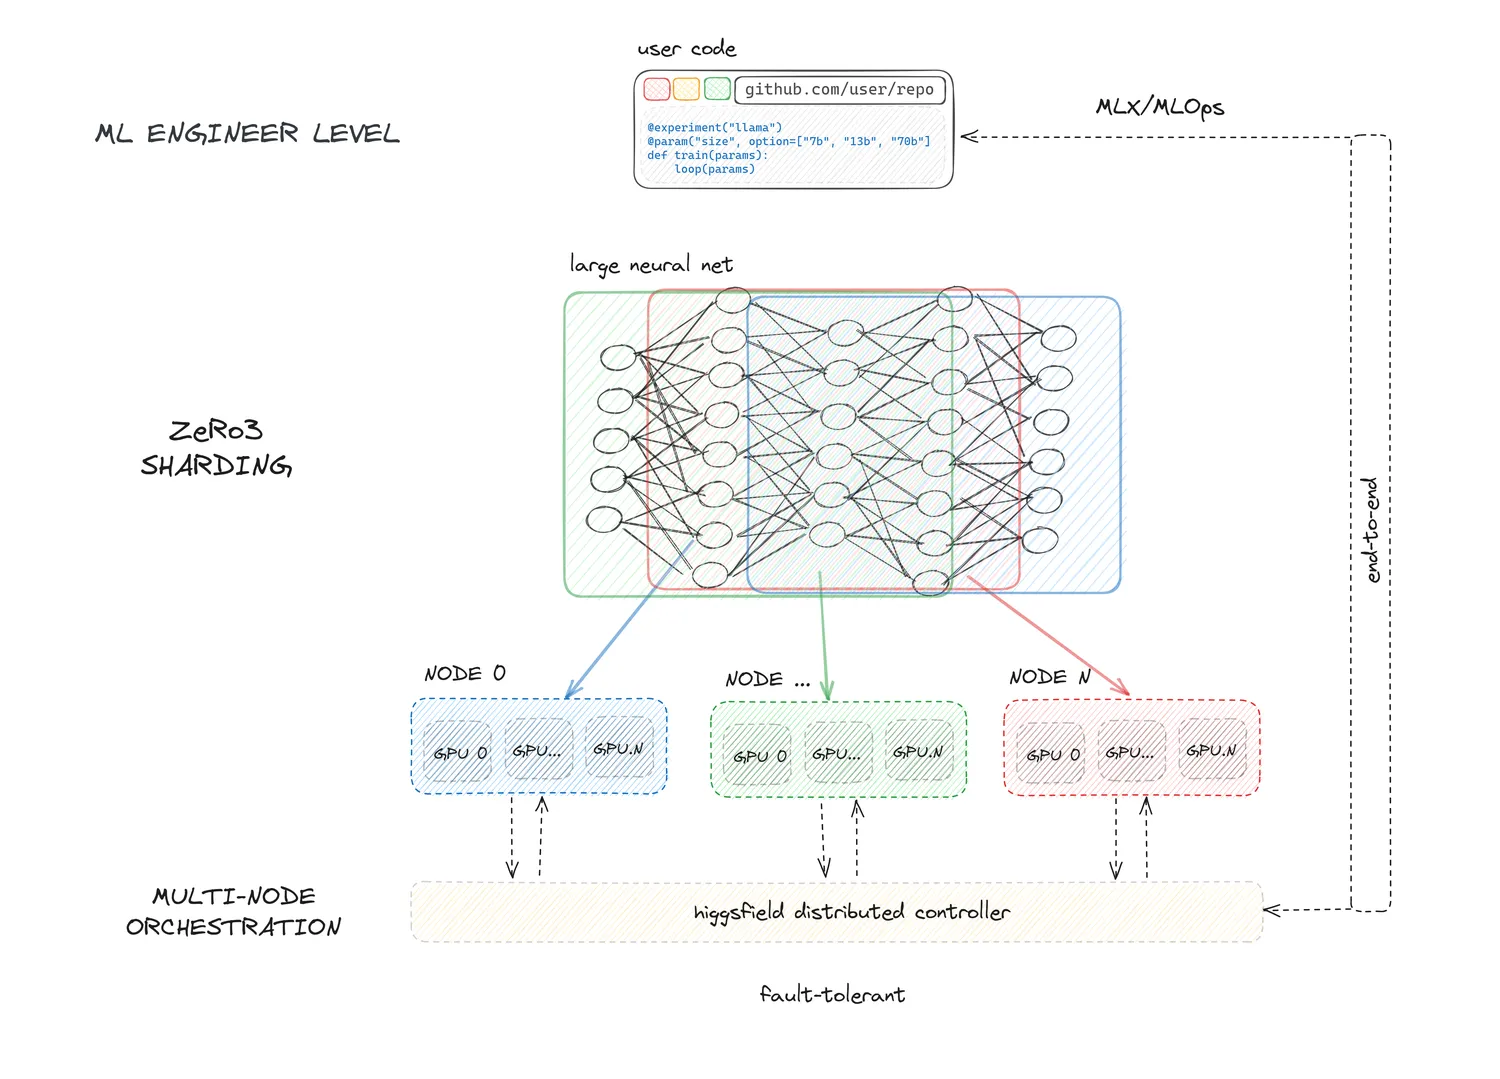
这是 README 里的架构图。建议你多看几秒最下面那个方框 ——「higgsfield distributed controller(multi-node orchestration, fault-tolerant)」。整篇文章里,我会反复回到这张图上:这个框里装的东西,不在这个仓库里。 这个仓库开源的是”编排”,不是”执行”。
二、它到底省掉了什么#
大多数”分布式训练框架”解决的是通信问题。Higgsfield 解决的是流程问题。它押注的历史事实是:
今天的 LLM 训练,绝大部分时间不是在写 kernel,而是在”我改了 3 个超参,今天要再跑一轮”这件无聊的事情上。
而”改 3 个超参再跑一轮”需要的机器能力其实很少 —— 需要的是:记住这次跑的参数组合、找一台闲机器、把代码同步过去、拉起进程、看日志。这四件事,GitHub Actions 一件不缺:
workflow_dispatch提供参数表单(下拉框、默认值、必填校验);concurrency: group: main提供队列(同名 group 只允许一个在跑,cancel-in-progress: false就是排队而不是抢占);- runner 提供一台免费的调度机(它自己不训练,只负责 SSH 过去发号施令);
- Actions 界面提供运行历史(每次跑的参数、日志、成败、耗时都在,还带一个可分享的 URL)。
于是它的架构就变成了这样一条链子:
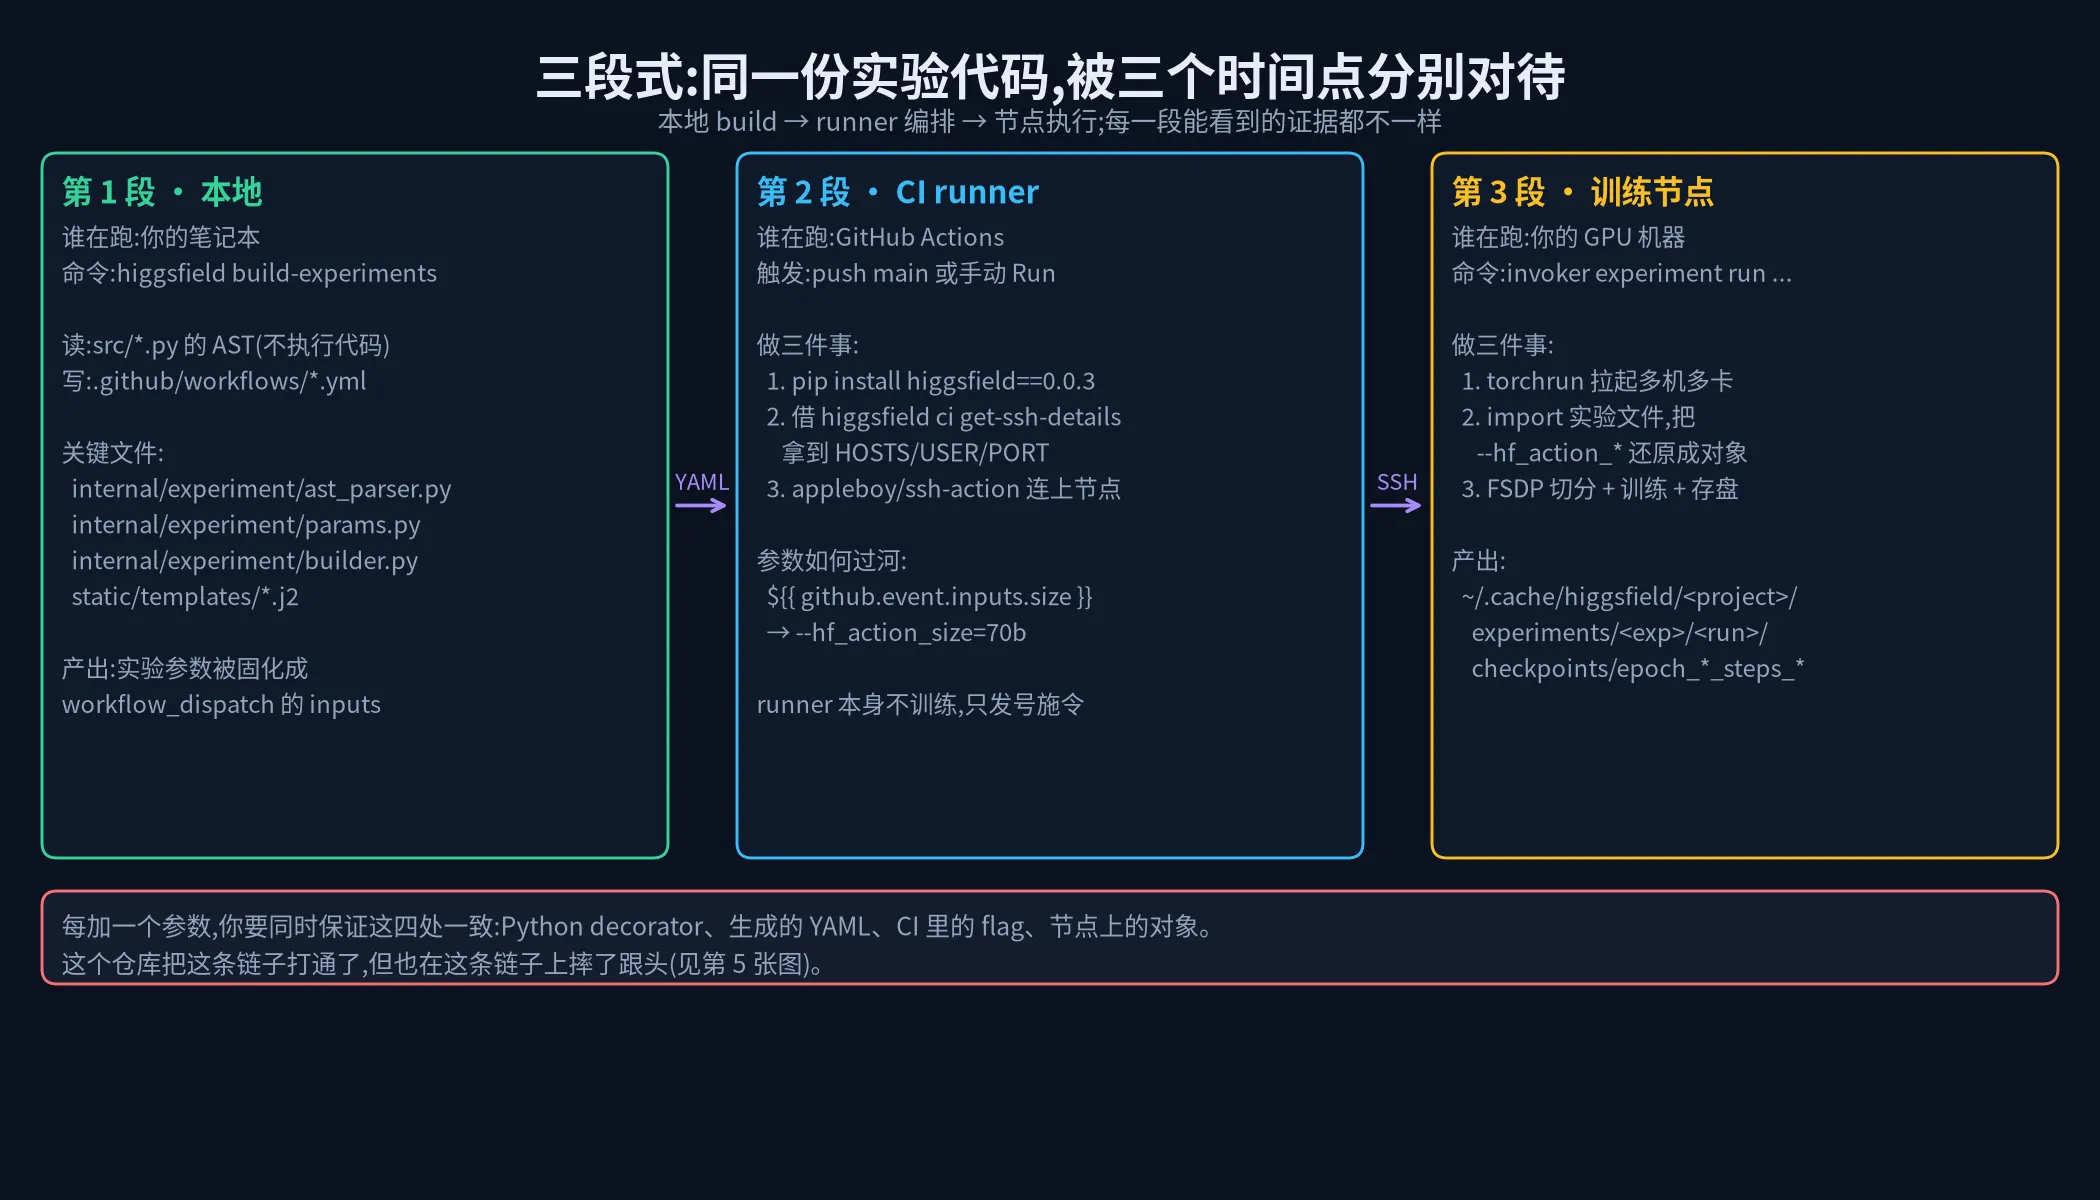
三段各自只做一件事,而且能看到的东西不一样:
- build 期(你的笔记本):
higgsfield build-experiments读你src/下的 Python 源文件,把它们”编译”成 GitHub Actions 工作流,提交进仓库。 - CI 期(GitHub runner):
push main触发部署,或者你在网页上手动触发某个实验。runner 只做”拆参数、连节点、下命令”。 - 运行期(GPU 节点):一个叫
invoker的二进制接手,拉起torchrun、多机通信、FSDP 切分、存盘。
这套设计的最大优点和最大缺点,其实是同一件事:它把”实验的参数契约”分散到了三个地方,而它选择用”生成”来保证这三处一致。这正是它的主心骨。
三、build 期:用 AST 读你的代码,而不是跑你的代码#
第一个让我停下来的决定:它不 import 你的实验文件,而是解析它的语法树(AST)。
# higgsfield/internal/experiment/ast_parser.py
def parse_experiments(filename: str):
    with open(filename, "r") as f:
        parsed_code = ast.parse(f.read())
    defs = func_defs(parsed_code)          # 只看顶层函数
    defs = filter_experiment_defs(defs)    # 只留带 @experiment 的
return build_experiment_defs(defs)为什么这件事重要?因为你的实验文件长这样:
@experiment("alpaca_bf16")
@param("size", options=["7b", "13b", "70b"])
@param("num_epochs", default=1, description="Number of epochs")
def train(params):
    ...
model = Llama(model_name=model_name, zero_stage=3, cpu_init_rank0=True, ...)这个文件里 import 了 torch、transformers、datasets。如果 build 期用 import 去读它,你就必须在笔记本上装好 CUDA 那一整套东西,只为”生成几个 YAML”。用 AST 解析,这些代价全部消失 —— 它只关心两个装饰器的字面量:@experiment 的名字,和 @param 的 name / default / options / description。
解析结果被包成两层对象(注意这一段的设计:解析层 Dec 和运行期 Param 是分开的):
class Paramdec(Dec):
    def __init__(self):
        super().__init__(name="param", allowed_args={
            "name": (str,),
            "default": (str, int, bool, float, type(None)),
            "description": (str, type(None)),
            "required": (bool, type(None)),
            "type": (type,),
            "options": (tuple, type(None)),
})allowed_args 是一张白名单表,写错参数名会直接报 argument xxx of param is not allowed;default 的类型会被记下来,再交给 Param.from_values 做归一化。在没有人肉 schema 的语言里,用一张 dict 当 schema,是这个套路里最省事也最结实的写法。
拿到参数声明之后,Jinja2 模板负责把它渲染成 YAML:
on:
  workflow_dispatch:
    inputs:
      {% for param in params %}
{{ param }}{% endfor %}而每个 Param 自己知道怎么变成 YAML —— 这个”对象自己会渲染”的写法值得单独看一眼:
def as_github_action(self) -> str:
    indent = "        "
    to_join = [f"{self.name}:"]
    if self.description:
        # TODO: fix that yaml.safe_dump with some proper encoder, string esc etc.
        to_join.append(f"{indent}description: {remove_trailing_yaml(safe_dump(self.description))}")
    to_join.append(f"{indent}required: {self.required}")
    if self.default is not None:
        to_join.append(f"{indent}default: {self.default}")
    if self.options:
        to_join.append(f"{indent}options: {list(self.options)}")
        to_join.append(f"{indent}type: choice")
    if self.type == bool:
        to_join.append(f"{indent}type: boolean")
return "\n".join(to_join)这里有个细节很坦诚:作者用 yaml.safe_dump 只为了让字符串带上正确的引号,而把整块 YAML 结构用手拼 —— 上面那行 TODO 就是他自己留的账。手拼 YAML 的代价是什么?required: True 是 Python 的布尔字面量,default: 1 是 Python 的整数,它们都不带引号地落进了 YAML。YAML 解析器能接受(我用 actionlint 1.7.7 校验了这份生成产物,它只报了 4 条 checkout@v3 太旧,没有报输入声明的错),但这种”靠解析器宽容”的写法,在字符串里出现 :、#、前导 0 的时候就该付账了。
试一试#
理论讲多了。我拿了 2024 年的这份代码,在本地真的跑了一遍:
$ pip install higgsfield==0.0.3     # 实际是 PYTHONPATH 指向源码
$ higgsfield init demo_project
$ cd demo_project && git init && git remote add origin https://github.com/user/demo_project.git
$ higgsfield build-experiments
Updated deploy action
Updated kill action
Updated experiment action alpaca_fp16
Updated experiment action alpaca_bf16四个文件应声落地:
$ ls .github/workflows/
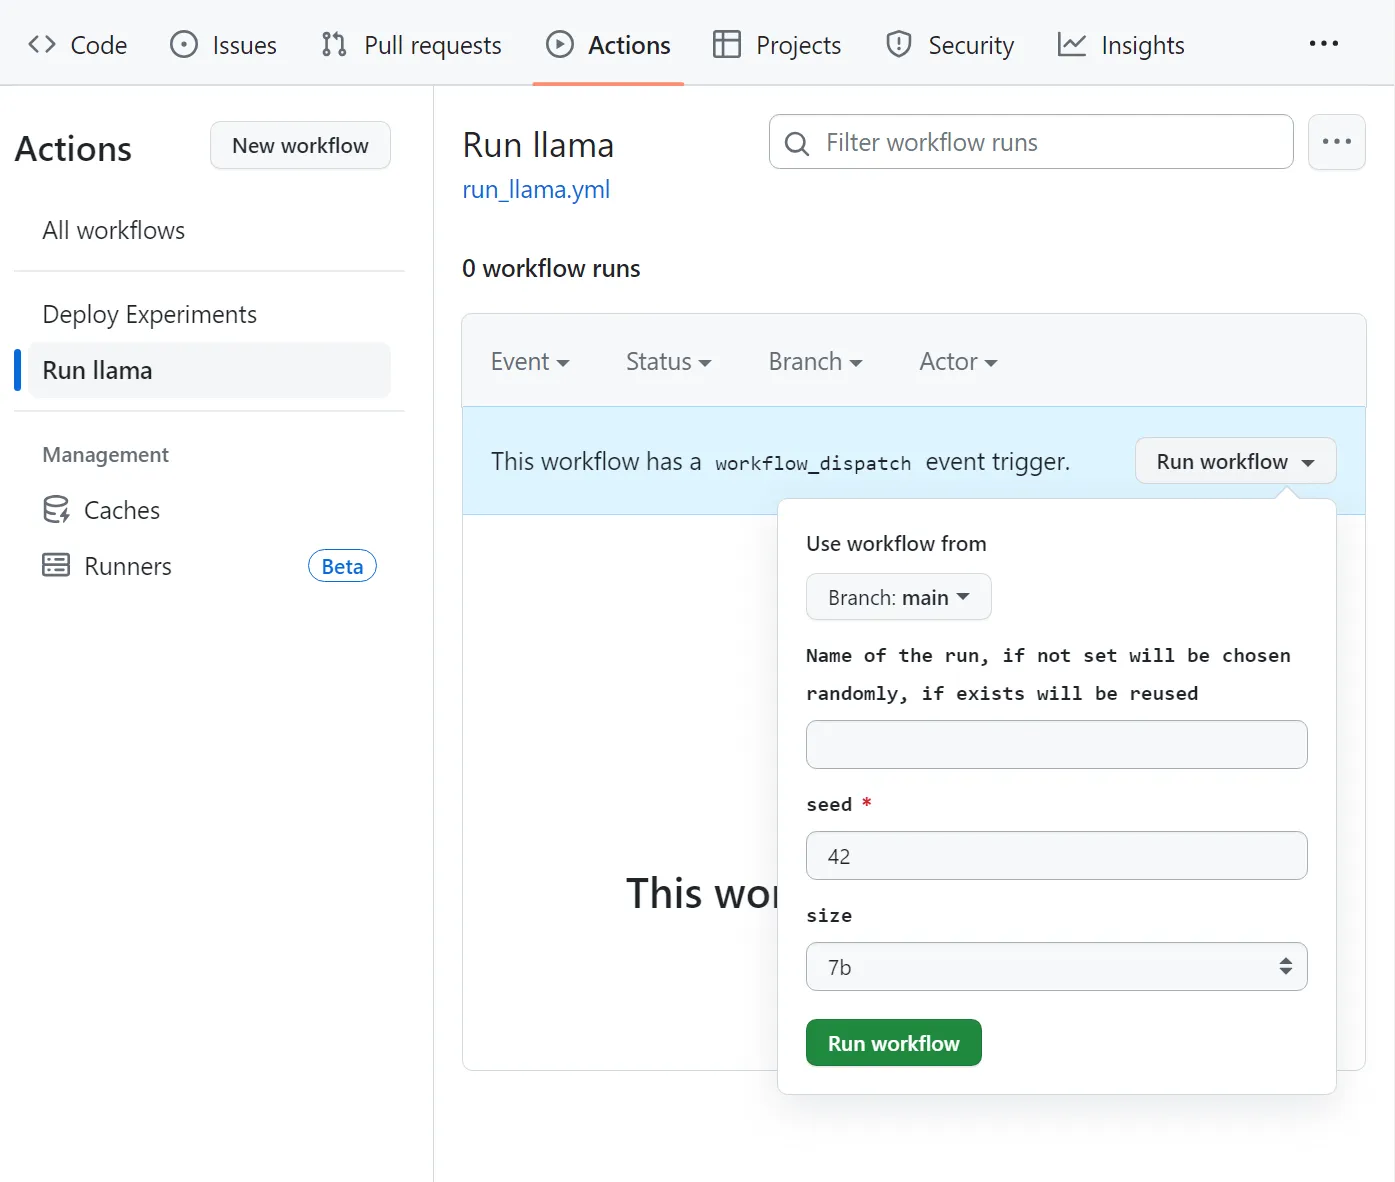
deploy.yml kill.yml run_alpaca_bf16.yml run_alpaca_fp16.yml打开 run_alpaca_bf16.yml,你会看到 workflow_dispatch.inputs 里安安静静地躺着你刚写的四个参数(其中一个 seed 是系统自动塞的,必填、默认 42):
name: Run alpaca_bf16
on:
  workflow_dispatch:
    inputs:
      run_name:
        description: 'Name of the run, if not set will be chosen randomly, if exists will be reused'
        required: false
      seed:
        required: True
        default: 42
      size:
        required: False
        default: 7b
        options: ['7b', '13b', '70b']
        type: choice
      num_epochs:
        description: Number of epochs
        required: False
        default: 1

concurrency:
  cancel-in-progress: false
group: main到这里,一条 Python 装饰器里的参数,已经变成了 GitHub 网页上一个下拉框。这份 YAML 是普通文件、普通提交,所以你想手动改也完全可以 —— 只是下次 build-experiments 会按模板重新生成覆盖掉。
哦,对了,build-experiments 只删自己生成的文件:它遍历 .github/workflows/run_*.yml,只删开头带它自己那三行注释头的。你自己写的工作流原地不动。同时这也是它唯一的”语言约定”:名字必须以 run_ 开头。
第一个坑,就埋在这个过滤器里#
filter_experiment_defs 是这么筛实验的:
def filter_experiment_defs(defs):
    for node in defs:
        try:
            if (len(node.decorator_list) >= 1
                and node.decorator_list[0].func.id == "experiment"):
                filtered_defs.append(node)
        except Exception:
pass它只看装饰器列表的第 0 个。 也就是说 @experiment 必须写在最上面(最外层)。这个要求本身说得通 —— 但如果你写成 Python 里更自然的顺序:
@param("lr", default=1e-5)
@experiment("reversed_order")
def train(params): ...结果不是报错,而是这个实验凭空消失。我实测的返回:parse_experiments(...) -> [],命令行一片安静,build-experiments 只打印它生成的那几个实验名,你甚至会以为自己的另一份文件”写得没错,只是没生效”。
更微妙的是第二层:build_experiment_def 自己其实是支持任意顺序的(它遍历整个 decorator_list)。真正卡住顺序的只有前面那个过滤器。两处逻辑对”装饰器顺序”的假设不一致,结果就是”上面这层把它丢了,下面那层根本没机会救”。这类不一致比纯粹的 bug 更值得记:它不产生报错,只产生沉默。
四、运行期:参数是怎么回到代码里的#
build 期把参数”编译”出去了,运行期就得把它”还原”回来。这一步只有两个动作,都很安静。
动作一:找到实验。 节点上执行的命令是:
invoker experiment run --project_name demo_project --experiment_name alpaca_bf16 \
  --run_name abc --port 1234 --nproc_per_node 2 --hosts 1.2.3.4 \
hf_action_seed="42" hf_action_size="70b" hf_action_num_epochs="1"最后那三个 hf_action_* 会被 Launch._parse 收进一个 dict,然后 —— 注意这里 —— 它会 import 你 src/ 下的每一个 .py:
def _source_experiments(base_path: Path):
    """
    Only used inside docker to inject experiments into the module.
    Do not use outside of docker. But if you do, you will have to have
    the same dependencies (aka environment) as the docker container.
    """
    for file in base_path.glob("**/*.py"):
        module_name = os.path.basename(file).split(".py")[0].replace(" ", "_").replace("-", "_")
SourceFileLoader(module_name, str(file)).load_module()这是 build 期和运行期的分工:build 期不执行你的代码(所以要 AST),运行期必须执行你的代码(所以要 import)。而装饰器的妙处就在这两者之间行了方便 —— 你在文件顶层写 @experiment("alpaca_bf16"),ExperimentDecorator.__init__ 会把这个实例注册进一个全局字典:
_experiments: Dict[str, ExperimentDecorator] = {}

class ExperimentDecorator:
    def __init__(self, name: str, *, seed: Optional[int] = None):
        name = check_name(name)
        if name in _experiments:
            raise ValueError(f"Experiment with name {name} already exists")
        _experiments[name] = self
        self.name = name
self.params = [Param.from_values(name="seed", type=int, required=True, default=42)]字符串 → 函数对象的映射,靠 import 时的副作用建立。 和 Flask 的 @app.route、pytest 的 @pytest.fixture 是同一招。代价也很熟悉:注册是全局状态,同一个名字注册两次就报错,所以 build-experiments 那侧才需要 check_name 去卡名字格式(顺带一提,它能接受的实验名必须是合法标识符且不超过 20 个字符) —— 因为这个名字同时要当 YAML 的 key、文件名的后缀和 CLI 的参数值。
动作二:把字符串还原成对象。 这里有个很好的设计:所有来自 CI 的参数都带 hf_action_ 前缀。为什么要前缀?因为这条命令行里混着两种参数 —— invoker 自己的(--port、--hosts)和你的实验参数。加前缀是最省事的命名空间隔离,顺带还避免了”实验参数叫 port”这种撞车。
还原逻辑里有一个归一化的来源:参数的类型信息来自 AST 解析时记下的 default 的类型。default="7b" → str,default=1 → int,default=None → str。然后:
def parse_kwargs_to_params(params, kwargs):
    keys = (key[len(pfx):] for key in kwargs if key.startswith(pfx))
    fields = {param.name: param for param in params}
    keys = [key for key in keys if key in fields]      # ← 这句
...第二个坑,比第一个更贵#
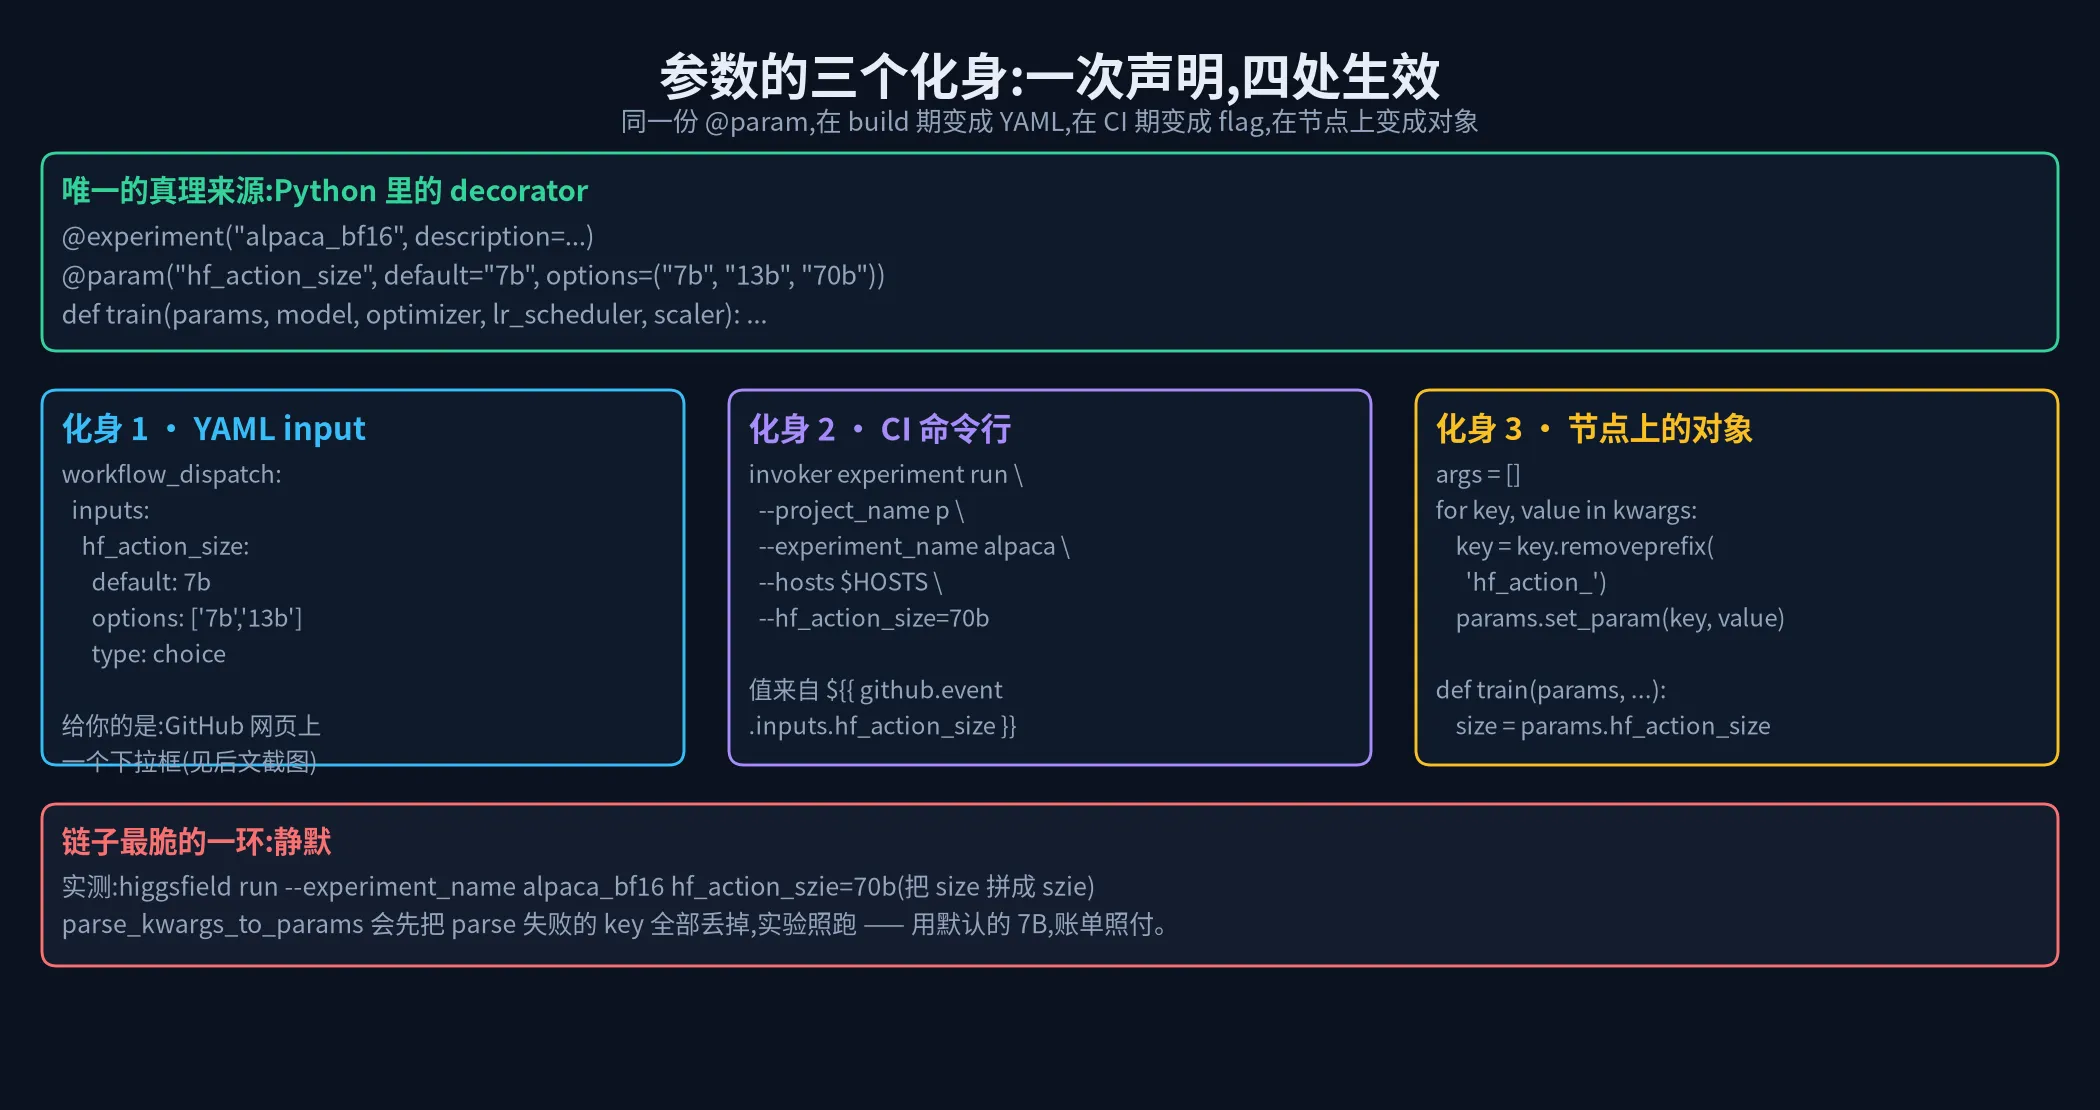
就是上面标出来的那一句。它先把所有不认识的关键字过滤掉。于是:
$ higgsfield run --experiment_name alpaca_bf16 ... hf_action_szie="70b"
# ^^^^ 拼错了我实测的行为是:没有任何警告,size 取默认值 7b,训练照跑。你以为自己在跑 70B,实际上在跑 7B;更糟的情况是你以为跑的是 13B,实际上跑的是 70B —— 而 70B 是要花钱的。
这里有一个通用的教训:“跨进程传参”这条链路上,未知 key 应该是错误,而不是噪音。 尤其是当参数会被翻译成 YAML、再翻译成命令行、再翻译成对象,经过三次转手的时候 —— 每一次转手都是一个静默丢信息的机会。同一条链路上还有第三个:如果参数值里恰好带一个 =,比如某个 URL,key, value = arg.split("=") 会直接抛 ValueError: too many values to unpack。
下面这张图是这条链子的全貌,以及它最脆弱的一环:
五、真正让我服气的三处#
前面讲的都是”流程”。现在讲三处工程细节 —— 这三处让我觉得:写这个框架的人是真在 GPU 上烧过钱的。
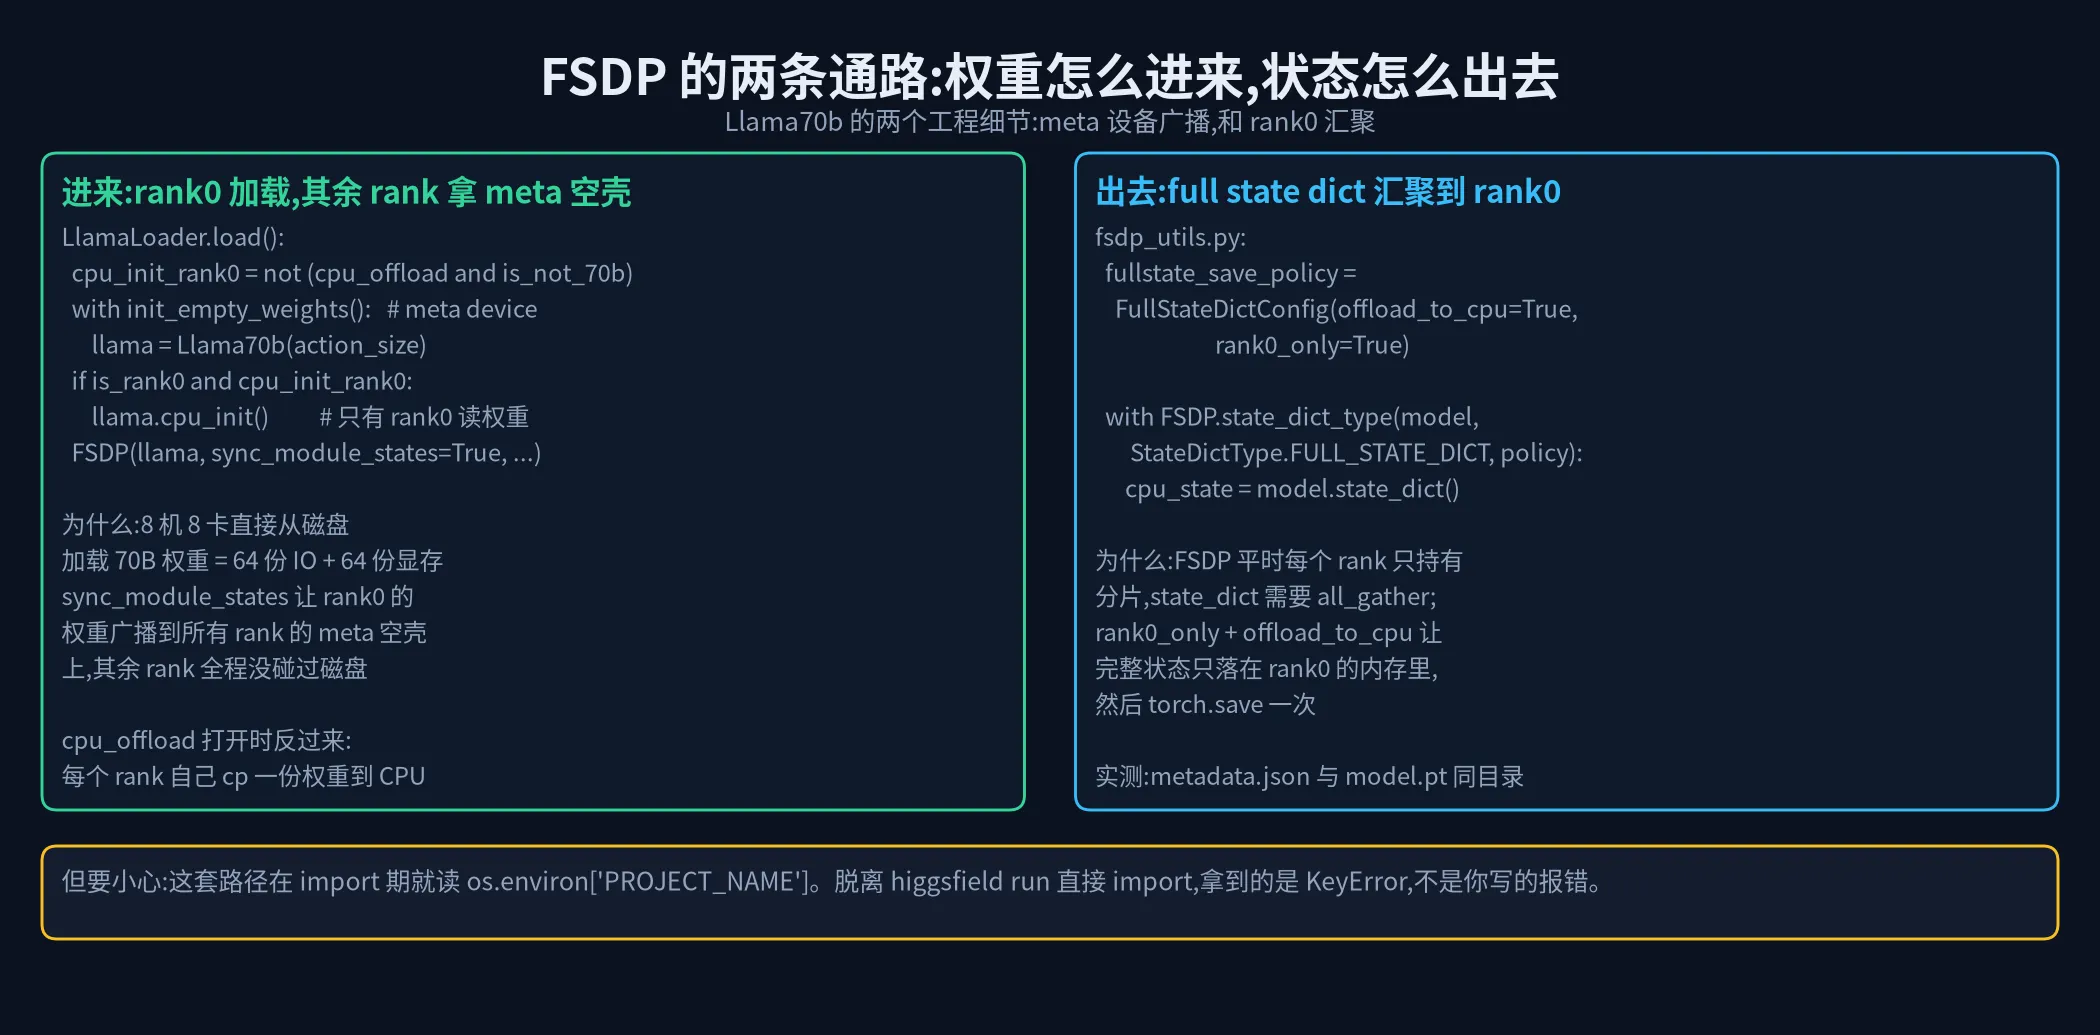
5.1 “只在 rank0 加载权重”这件事,它用 meta 设备做干净了#
裸 FSDP 的场景下,8 台机器 × 8 张卡 = 64 个进程,每个进程默认都会 from_pretrained 拉一份权重。70B 的权重是几百 GB,64 份就是几十 TB 的读取量 —— 网络和 CPU 都受不了。标准做法是”只在 rank0 加载,然后广播”,Higgsfield 提供开关 cpu_init_rank0,实现是这样的:
# higgsfield/llama/llama.py: Llama(FSDP).__init__ 里加载模型的部分
rank = dist.get_rank()

if not checkpoint_path:
    if cpu_init_rank0:
        if rank == 0:
            model = LlamaForCausalLM.from_pretrained(model_name, use_cache=False)
        else:
            llama_config = LlamaConfig.from_pretrained(model_name, use_cache=False)
            with torch.device('meta'):                    # 形状正确,零占用
                model = LlamaForCausalLM(llama_config)
    else:
model = LlamaForCausalLM.from_pretrained(model_name, use_cache=False)with torch.device('meta') 是这套戏法的核心:它建出来的模型只有形状,没有数据,参数躺在”元设备”上,一个字节显存都不占。
接下来才是真正需要功力的地方。meta 参数在 FSDP 里是不能直接用的,必须”落地”。所以 FSDP 的构造参数被分成了两路:
if cpu_init_rank0 and rank != 0:
    param_init_fn = lambda module: module.to_empty(
        device=torch.device('cuda'),
        recurse=False,
    )
else:
    param_init_fn = None

super().__init__(
    model,
    auto_wrap_policy=wrapping_policy,
    cpu_offload=cpu_offload,
    mixed_precision=mixed_precision_policy,
    sharding_strategy=sharding_strategy,
    device_id=torch.cuda.current_device(),
    limit_all_gathers=True,
    sync_module_states=cpu_init_rank0,
    param_init_fn=param_init_fn,
)读一遍这三个参数,整个流程就清楚了:
- 非 rank0 的模型是 meta 空壳,FSDP 需要把它”实体化”。
param_init_fn只在这个场景下给出,内容是module.to_empty(device='cuda')—— 在 GPU 上按形状分配显存,内容是未初始化的垃圾。 - 然后
sync_module_states=cpu_init_rank0出场:FSDP 会把 rank0 的真实权重广播到所有 rank 上,覆盖掉那些垃圾。 - rank0 走的是普通路径(
param_init_fn=None),因为它本来就拿着真参数。
三步下来,64 个进程里只有 1 个读过磁盘。“先造空壳、让垃圾数据先落地、再广播真值覆盖”听起来像倒着走,其实是最省 IO 的走法 —— 因为广播走的是 NCCL 的 GPU 互联,而读盘走的是网络存储,两者的带宽差了一个数量级。
同一段代码里还有一个我喜欢的细节:如果这次是从 checkpoint 恢复,cpu_init_rank0=False 会被强制改掉,并且明确告诉你:
else:   # checkpoint_path 不为空
    if not cpu_init_rank0:
        print("Ignoring cpu_init_rank0=False while loading model from checkpoint path")
        cpu_init_rank0 = True

    if rank == 0:
        model = load_llama_from_checkpoint(model_name, checkpoint_path)
        print("LOADED FROM CHECKPOINT")
    else:
        llama_config = LlamaConfig.from_pretrained(model_name)
        with torch.device('meta'):
model = LlamaForCausalLM(llama_config)从 checkpoint 恢复时,rank0 读的是你那份 checkpoint(不一定和 HuggingFace 上的权重一致),其他 rank 依然只需要 config。此时”我只想省点 IO”这个诉求会退化成”我不得不广播”,所以它选择忽略你的参数、打印一行说明、继续跑。忽略用户参数是重罪,但打印出来再忽略,是工程。
反例也在同一个文件里#
上面这套是”工程”的一面。同一批 LlamaLoader 里还有另外一面 —— 请看看它的函数签名:
class LlamaLoader(DataLoader):
    def __init__(
        self,
        dataset,
        tokenizer=LlamaTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf"),   # ← 在签名里联网
        max_sequence_length=2048,
        batch_size_per_gpu=1,
...Python 的默认参数在函数定义时求值。也就是说,你只要 import higgsfield.loaders,这个 from_pretrained 就会立刻执行 —— 它会去 HuggingFace 拉 LLaMA-2 的 tokenizer。断网、没配 token、或者只想在本地离线跑一个已经下载好的模型,你连 import 都过不去。
这不是我猜的。仓库 issue #37 里,一位用户把这条列在了第二位:
When I import llama loader it automatically tries to get access to the HF without any my permitions. Overall trying to access something from internet without explicit calls is a big red flag from the security of view. In my case I’ve already downloaded everything and don’t need to connect to the HG at all.
把会有副作用的调用写进默认参数,是最容易犯、也最容易被 review 漏掉的错误之一。 它违反的是”import 应该无副作用”这条基本约定 —— 而这条约定,恰恰是前面 5.1 里那套 meta 设备方案得以成立的前提(build 期敢用 AST 而不是 import,运行期敢批量 import 你所有的文件,都建立在”import 是安全的”之上)。
5.2 存盘:让完整状态只落在 rank0 的内存里#
FSDP 训练时,每个 rank 手里只有分片。要存出一个能直接 from_pretrained 的模型目录,得把所有分片聚合起来。PyTorch 提供了现成的策略:
# higgsfield/checkpoint/fsdp_utils.py
fullstate_save_policy = FullStateDictConfig(offload_to_cpu=True, rank0_only=True)

def fsdp_model_state_dict_rank0(model):
    with FSDP.state_dict_type(model, StateDictType.FULL_STATE_DICT, fullstate_save_policy):
        cpu_state = model.state_dict()
return cpu_stateoffload_to_cpu=True 让聚合结果落在 CPU 内存(cpu_state 这个名字就是线索),rank0_only=True 让只有 rank0 保留结果、其余 rank 拿到空 dict。于是”聚合”这件事不再需要 64 份显存,也不会让 63 个 rank 陪着白等。
然后是落盘:
def save(self, epoch, steps=0, metadata={}):
    save_path = Path(self.save_dir) / f"epoch_{epoch}_steps_{steps}"
    save_distributed_model_rank0(model_path, self.model)
    if self.optimizer:
        save_distributed_optimizer_rank0(optimizer_path, self.model, self.optimizer)
    ...
    if self.lr_scheduler:
        torch.save(self.lr_scheduler.state_dict(), save_path / "lr_scheduler.pt")
    with open(save_path / "metadata.json", "w+") as jsonFile:
json.dump(metadata, jsonFile)检查点的目录结构值得直接抄:~/.cache/higgsfield/<project>/experiments/<experiment>/checkpoints/<run>/epoch_N_steps_M/,外加一个 metadata.json 记录 epoch 和 step。同一次实验的不同 run 天然分开,不会互相覆盖;metadata.json 让”我要找第 3 个 epoch”不需要翻目录。这套命名规范在 path.py 里被抽成了三个类(ProjectCachePath → ExperimentPath → RunPath),层次很清楚。
5.3 我最喜欢的一处:SSH_KEY='NOTHING'#
去翻生成出来的工作流,你会看到这么一行:
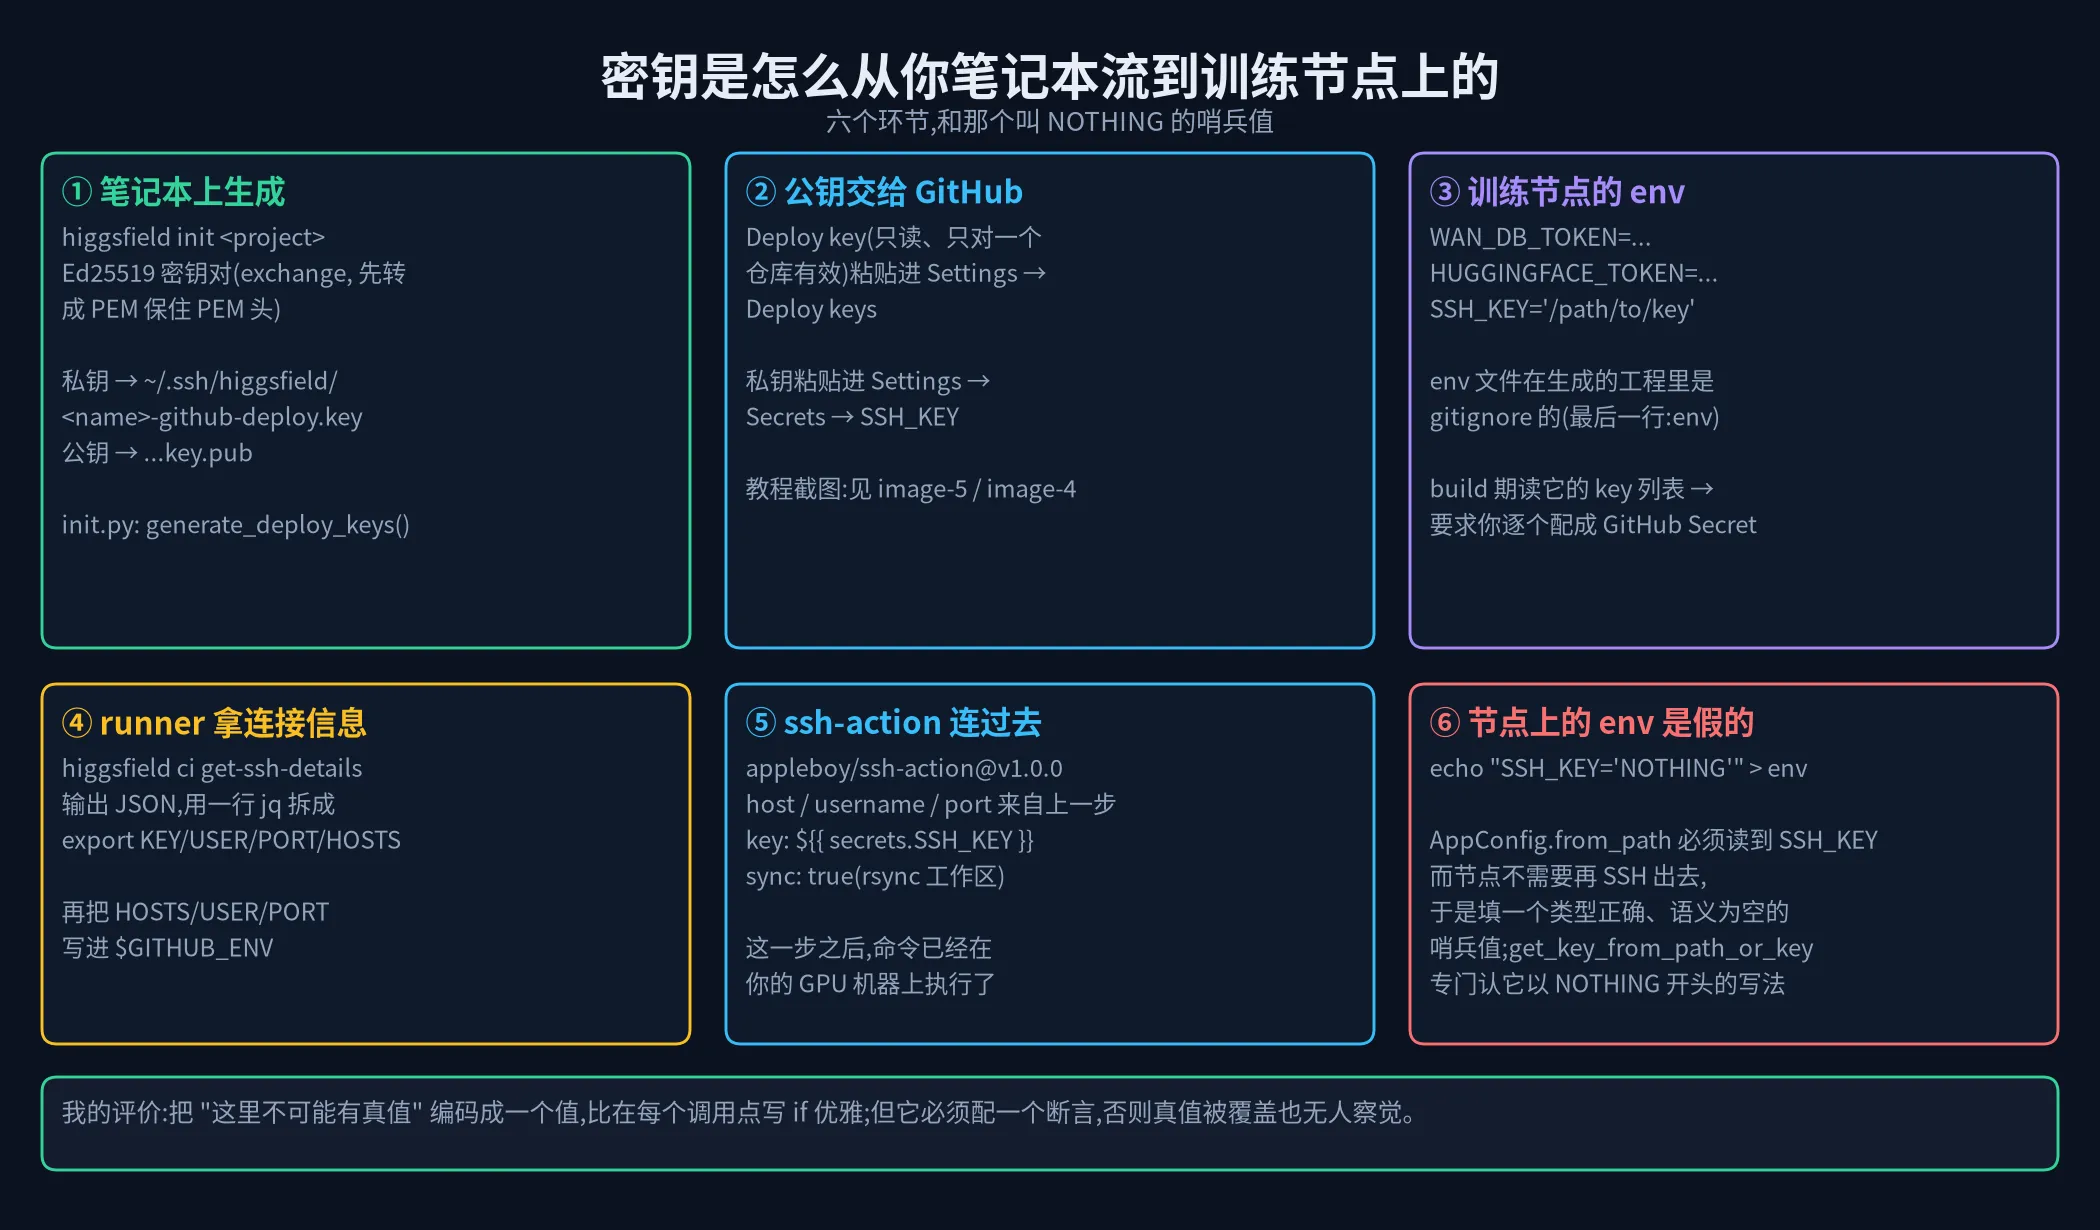
echo "SSH_KEY='NOTHING'" > env第一眼很荒诞:为什么要在训练节点的配置文件里,填一个叫 NOTHING 的 SSH 私钥?
答案藏在 AppConfig.from_path 里 —— 这个函数要求工程目录下必须有一个能读的 env 文件,而且里面必须有一个非空的 SSH_KEY,否则:
def get_key_from_path_or_key(key_or_path: Optional[str]) -> str:
    if key_or_path is None or key_or_path == "":
        raise ValueError("SSH_KEY in env is None")
    if (key_or_path.startswith("-----BEGIN")
        or key_or_path.startswith("ssh-rsa")
        or key_or_path.startswith("NOTHING")):      # ← 它专门认这个前缀
        return key_or_path
    path = Path(os.path.expanduser(key_or_path)).resolve()
    if path.exists():
        return path.read_text()
return key_or_path这是一个哨兵值(sentinel):节点上不需要再往外交 SSH(它的活是训练,不是编排),但配置结构要求”这里必须有一把钥匙”。于是作者在不可能有真值的地方放了一个类型正确、语义为空的假值,并让读取方显式地承认它。
我喜欢这处设计,因为它比”在每个调用点写 if is_ci / if is_node”干净得多 —— 它把”我们现在处于什么环境”这个信息,压缩进了一个值。你要判断一个系统的设计水平,看它怎么处理”不可能的输入”就够了:是到处加分支,还是造一个显式的占位符。
不过它也提醒一件事:哨兵值必须配断言。NOTHING 如果哪天被真钥匙覆盖,不会有任何机制提醒你 —— 这段代码里就没有。
密钥从笔记本流到训练节点,一共六个环节,下面这张图把它们串起来了:
六、把它跑起来:六步,和那几张原始截图#
前面讲的是机制。这一节按仓库自带的 setup.md 走一遍真实流程 —— 顺便保留它文档里的原始截图,因为这些图恰好拍下了”参数是怎么变成按钮的”。
第 1 步:higgsfield init#
$ higgsfield init demo_project
Initializing demo_project project at:
/home/you/demo_project生成的骨架很薄:src/config.py(节点地址、进程数)、env(密钥)、src/alpaca_bf16.py 和 alpaca_fp16.py(两个可直接跑的示例实验)、Dockerfile、requirements.txt。同时它会在你笔记本上生成一对 Ed25519 密钥(OpenSSH 格式,无口令),放在 ~/.ssh/higgsfield/<project>-github-deploy.key。
第 2 步:填 env 和 src/config.py#
env 需要三样东西:一个 SSH_KEY,以及两个示例性的密钥槽位(WAN_DB_TOKEN、HUGGINGFACE_TOKEN —— 它们会被自动发现,并要求你逐个在 GitHub 上配成同名 Secret,或者删掉)。src/config.py 里的规则写得很准:
# RULES FOR CONFIG FILE:
# 1. If you want something from env file, put it there, and just call the os.getenv, we will load it for you.
# 2. Do not put any imports here. None but 'os'.
# 3. Only simple definitions.

NAME = "demo_project"
HOSTS = ["1.2.3.4"]          # 你的训练节点 IP
HOSTS_USER = "ubuntu"
HOSTS_PORT = 22
NUMBER_OF_PROCESSES_PER_NODE = 2规则 2”不许 import”不是洁癖 —— config.py 会被 SourceFileLoader 直接读进字典取变量,而且它下游连着 setup-nodes 的 SSH 连接逻辑。这个文件被当成数据而不是代码,所以它看起来也就像数据。
第 3 步:接上 GitHub#
仓库要求你的工程必须有一个 git remote origin,而且解析器相当严格:https://github.com/<user>/<repo>.git 或者 git@github.com:<user>/<repo>.git,两种之一。它会把 https 形式自动改写成 SSH(因为部署时用的是 deploy key),再拼出一个特殊的 alias:
def as_keyed_repo_url(repo_url, project_name):
    # get the index of "/" after "github.com"
    # and replace it with "-project_name:"
return repo_url.replace("github.com:", f"github.com-{project_name}:")git@github.com:user/repo.git → git@github.com-demo_project:user/repo.git。这个 github.com-<project> 对应的是一条 SSH Host 别名,在 setup-nodes 时被写进节点的 ~/.ssh/config —— 于是同一台机器上给不同项目配不同 deploy key 时,它们不会互相打架。
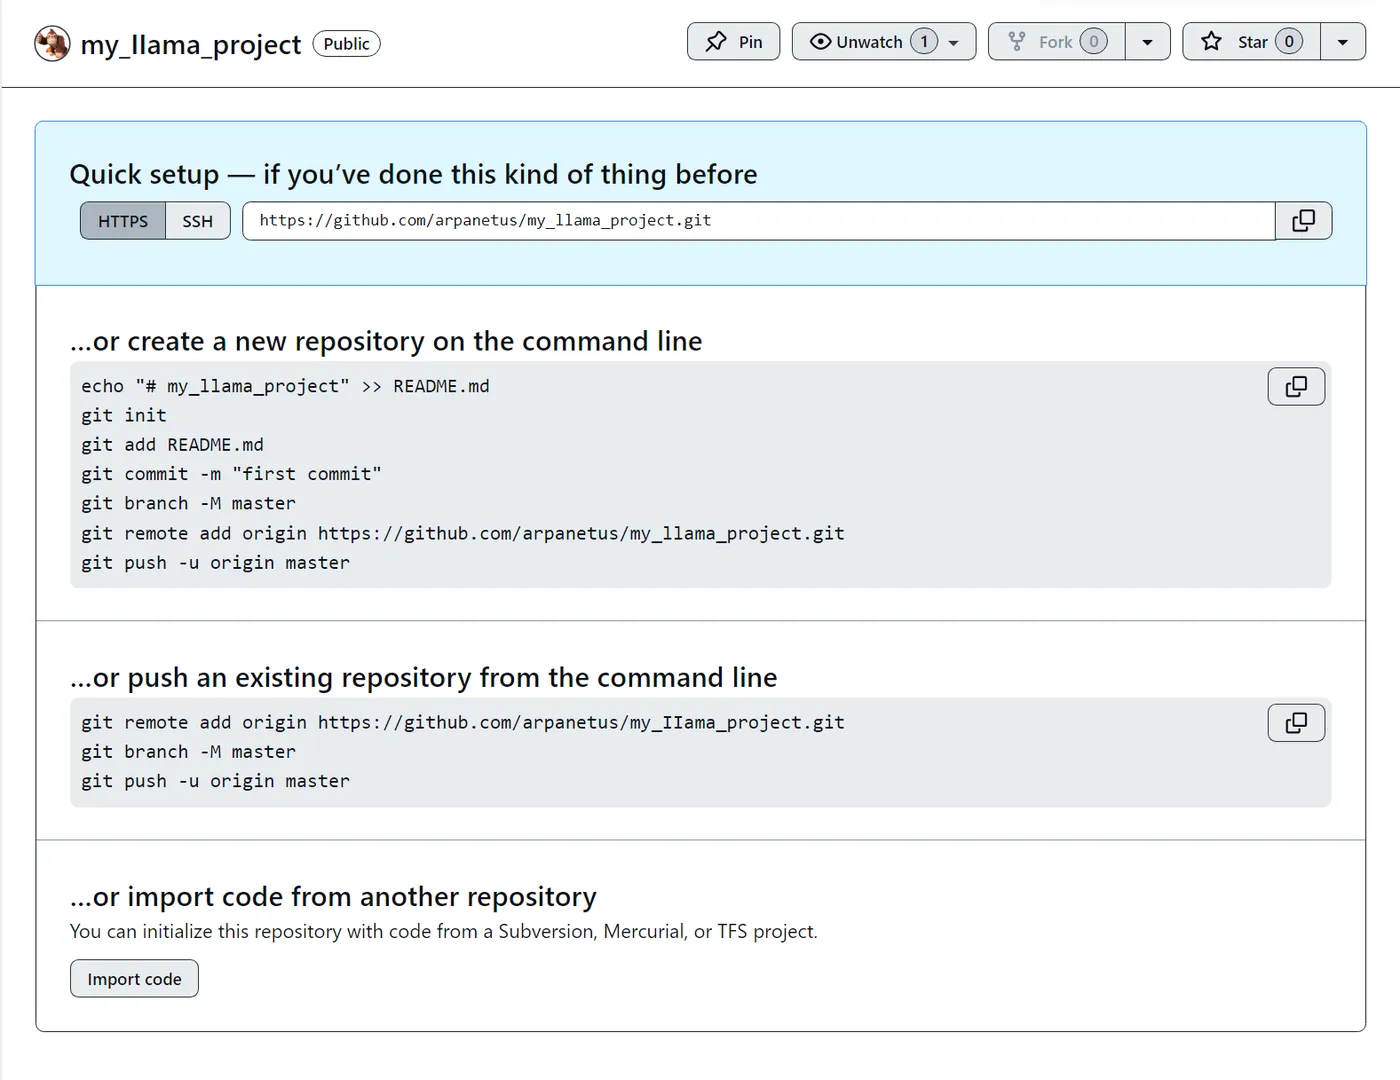
第 4 步:一条命令把节点配好#
$ higgsfield setup-nodes
INSTALLING DOCKER
...
INSTALLING INVOKER
...
SETTING UP DEPLOY KEY
...
PULLING DOCKER IMAGE忠实地说,这一步是把裸机变成训练节点的全部实现,而它的做法是:SSH 过去,装 Docker(curl ... | bash 一个托管在作者个人 gist 上的安装脚本),装 invoker,写 deploy key,拉镜像。省事、直接,但也意味着这条链路上有两个你无法审计的外部依赖:一份 gist,和一个二进制文件。后者在下面第七节会变成本文最刺眼的一处发现。
第 5 步:写实验,生成工作流#
写实验文件的全部要求就是两个装饰器:
from higgsfield.experiment import experiment, param

@experiment("llama")
@param("size", options=["70b", "13b", "7b"])
def train_llama(params):
print(f"Training llama with size {params.size}")setup.md 里对这两行的注释很坦率:“No need for hydra, argparse or any other boilerplate code.” 然后 higgsfield build-experiments,.github/workflows/ 就出现了。
第 6 步:配密钥、推送、点按钮#
先把私钥贴进 GitHub Secrets(名字必须叫 SSH_KEY),再把公钥贴进 Deploy keys(只读、只对一个仓库有效):
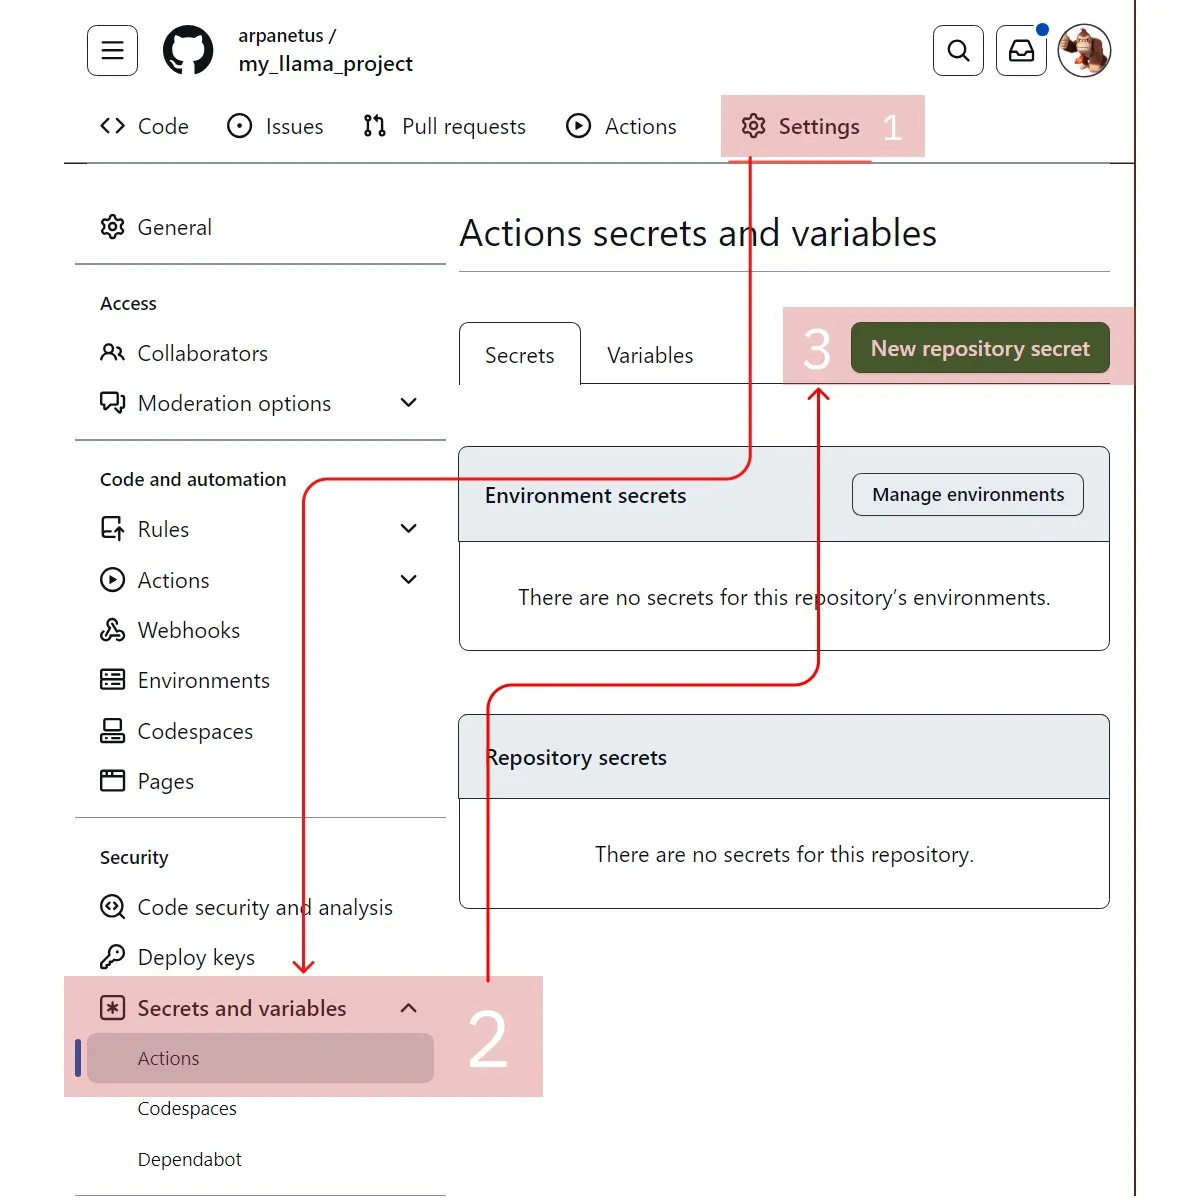
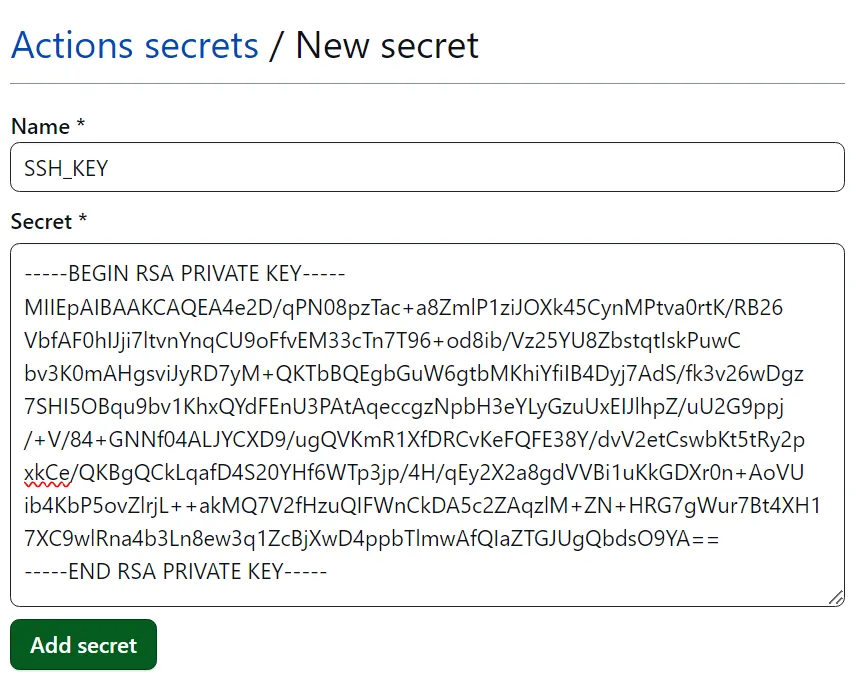
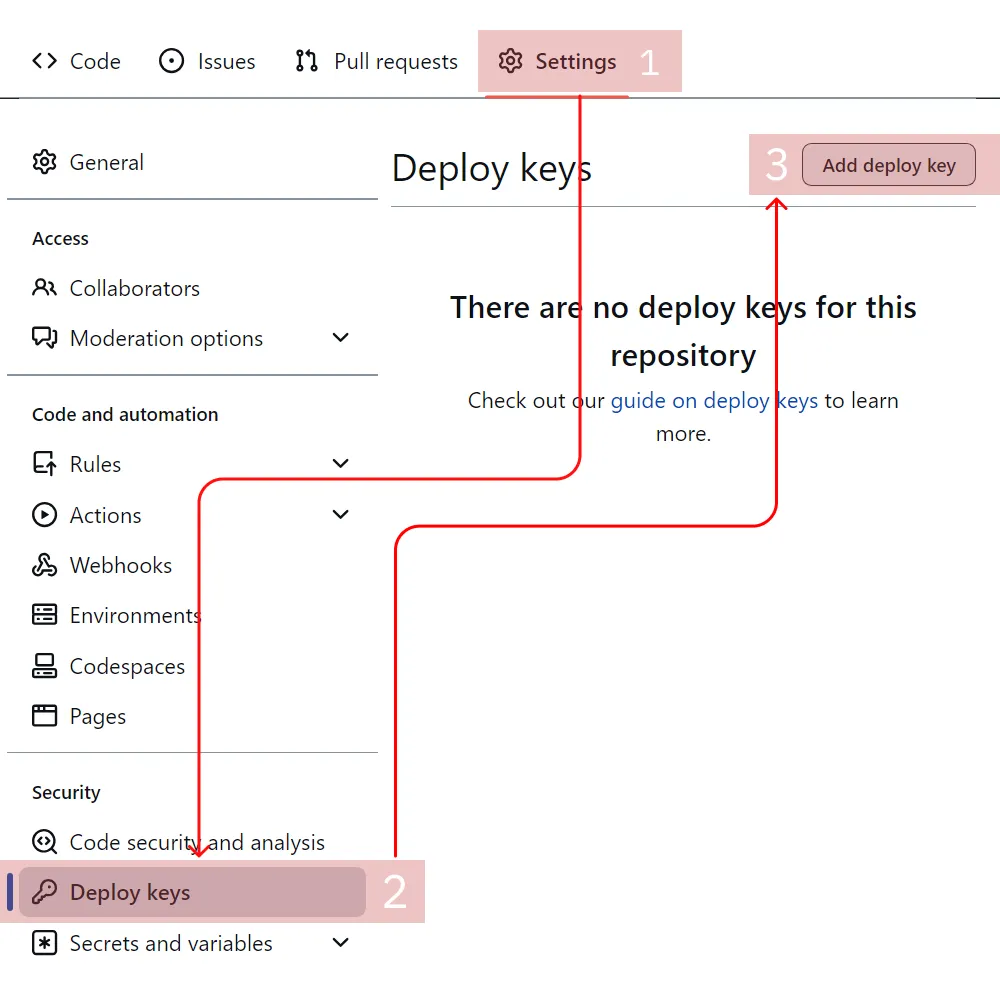
git push origin main 之后,deploy.yml 会自动把代码同步到所有节点。然后打开 Actions 页面,你会看到每个实验都变成了一个可以手动触发的工作流:
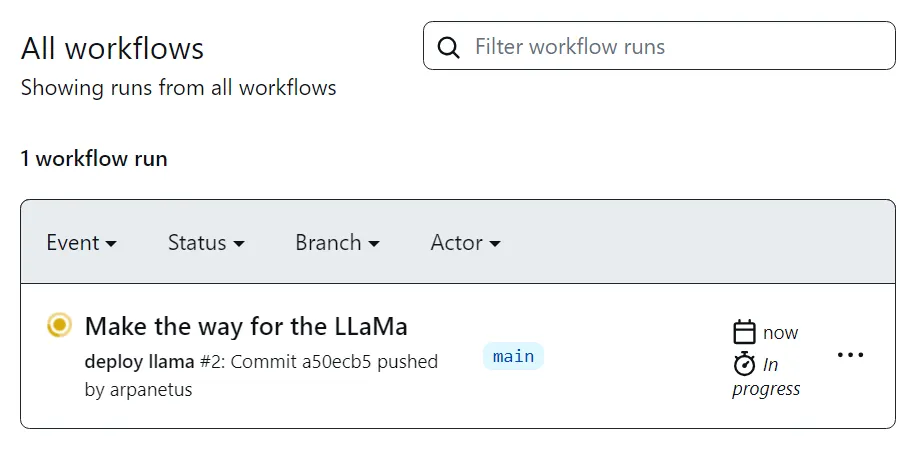
点 Run workflow,前面那些 @param 就在这里变成了表单 —— 一个文本框、一个必填的 seed(默认 42)、一个下拉框(7b / 13b / 70b),描述文字也在:
按下绿色的 Run,几分钟后你会看到这样一屏:
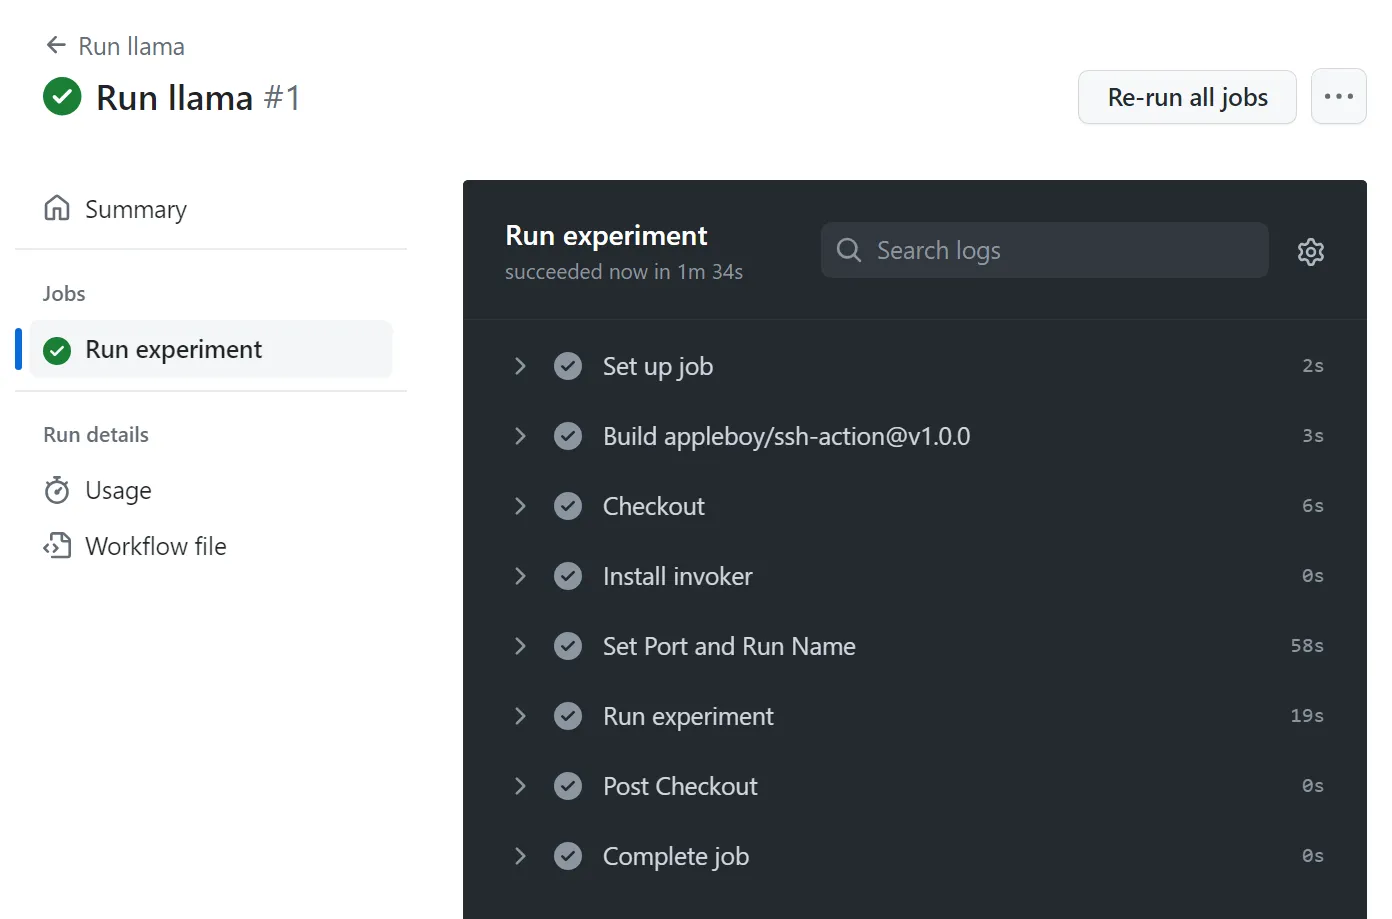
注意这张图里几个步骤的耗时:Install invoker 0 秒、Set Port and Run Name 58 秒、Run experiment 19 秒、整条流水线 1 分 34 秒。这就是它的价值所在 —— 一次”改超参再跑一轮”的完整流程,从点按钮到跑完,成本是一分钟和零个人工。
写到这里,一切都很好。接下来是我把这份 2024 年的代码在 2026 年的 Python 上真的跑了一遍之后,发现的东西。
七、把代码跑起来:十盏灯#
学术界读代码常犯的一个错,是把”我以为它会这样”当成”它就是这样”。所以这一节列出的每一条,我都在这篇文章写作的当天复现过 —— 包括错误信息,以及错误信息没有出现的地方。
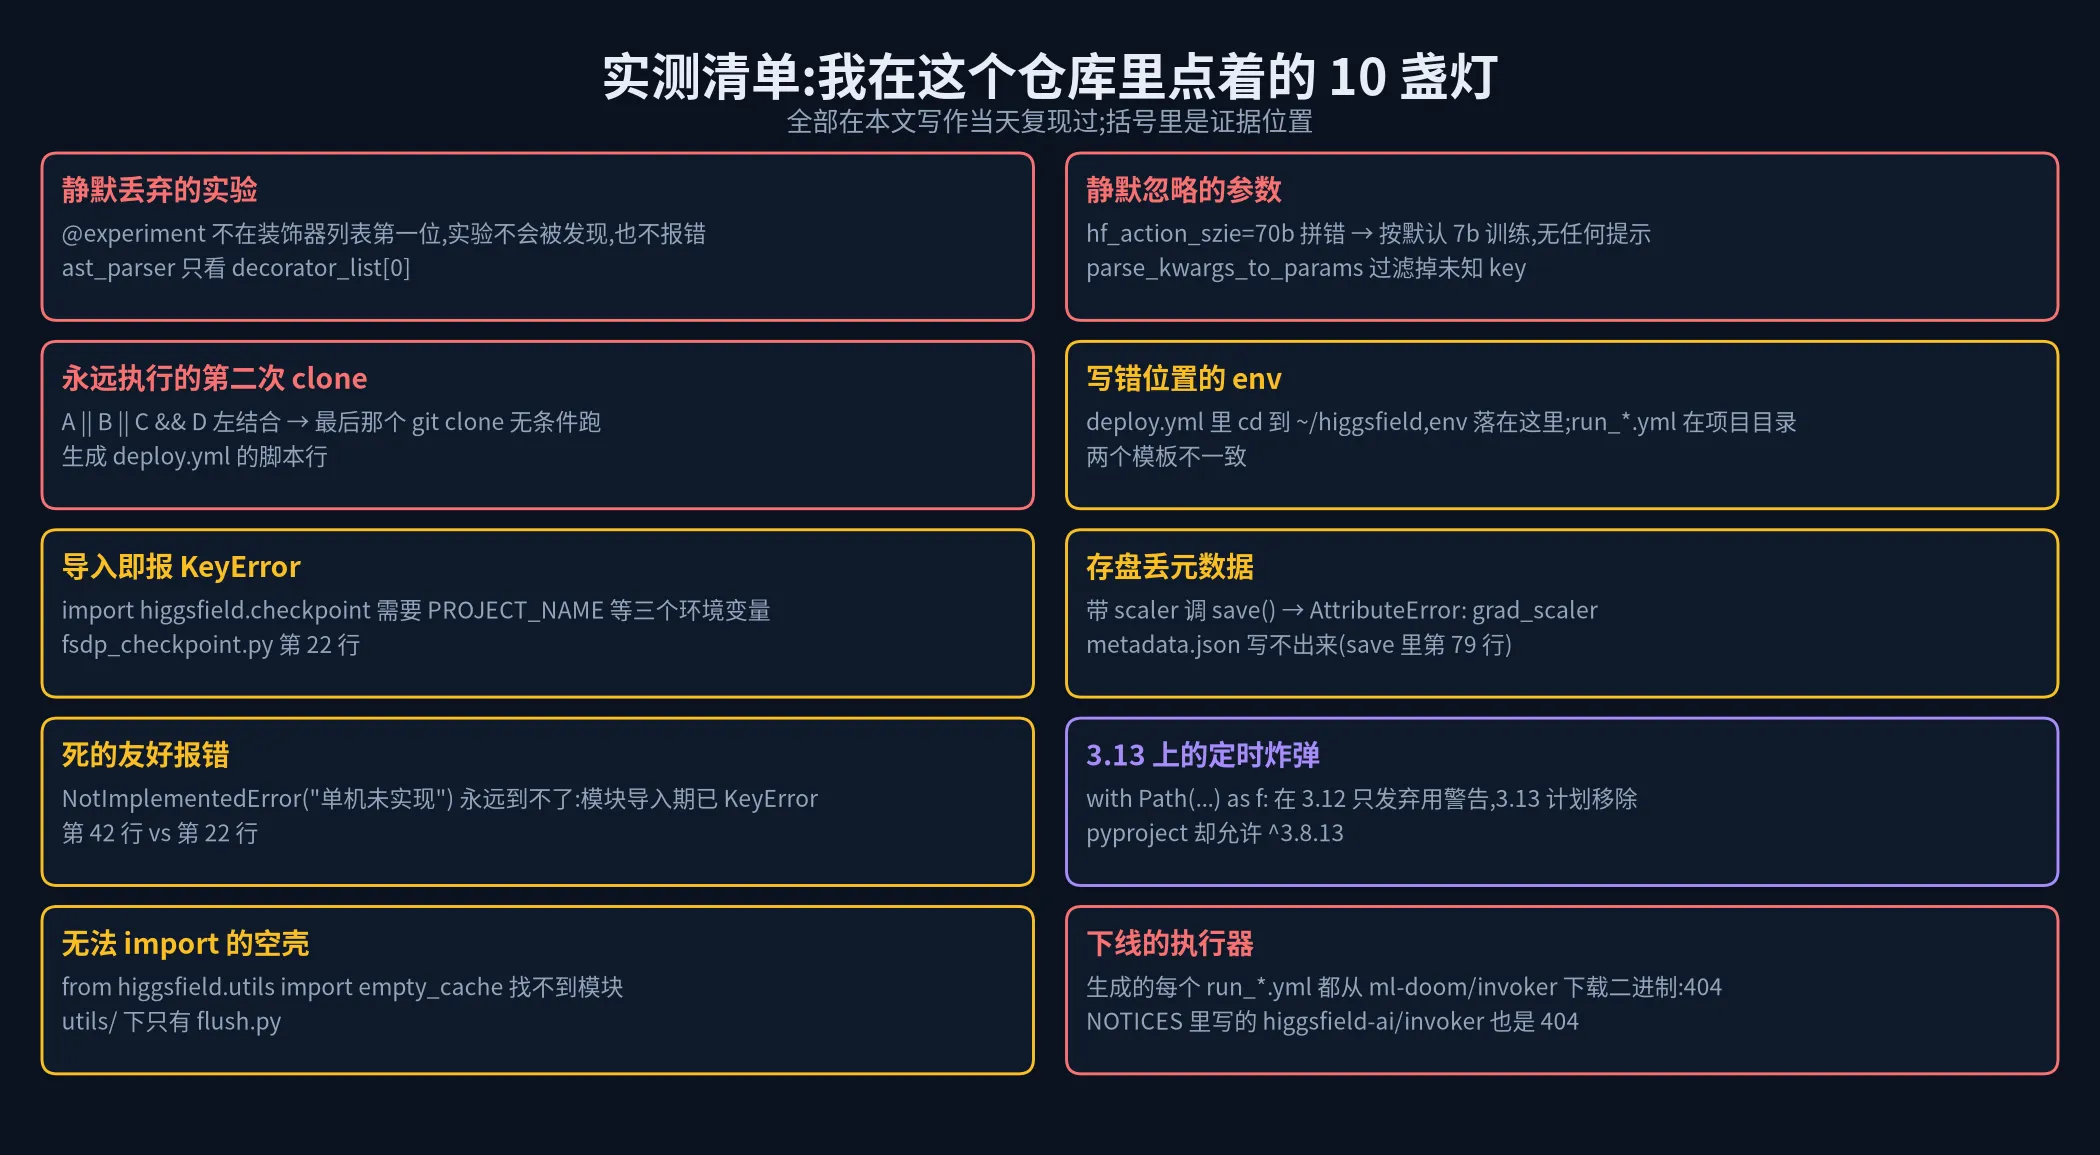
7.1 生成出来的部署脚本,最后那半句永远会执行#
这是我最喜欢的一条,因为它是纯粹的 bash 语义陷阱。生成的 deploy.yml 里有这么一行(我把它拆行显示,实际是一整行):
[ -d ~/higgsfield/demo_project ] && \
 (cd ~/higgsfield/demo_project && git fetch --all && git reset --hard origin/main && git pull origin main) \
 || git clone git@github.com-demo_project:user/demo_project.git demo_project \
|| rm -rf ~/higgsfield/demo_project && git clone git@github.com-demo_project:user/demo_project.git demo_project作者的意图很清楚:目录在就更新,不在就克隆,克隆失败就删掉重来。 但 bash 里 && 和 || 优先级相同、从左往右结合。所以这行的实际含义是:
((((A || B) || C) && D))其中 D 是最后那个 git clone。也就是说,只要前面任何一步成功(它总会成功,因为要么更新成功、要么克隆成功),&& D 就一定会执行 —— 在一个刚刚克隆好的目录上再克隆一次。
我用一个本地 bare repo 复现了两种情形,结果一样:
=========== MODE=fresh      # 目录不存在
[git clone ... demo_project]      → 成功
[git clone ... demo_project]      → fatal: destination path 'demo_project' already exists
EXIT_STATUS_OF_LINE=128

=========== MODE=prepared   # 目录已存在
[git fetch --all -q] → [git reset --hard] → [git pull]
[git clone ... demo_project]      → fatal: destination path 'demo_project' already exists
EXIT_STATUS_OF_LINE=128唯一能”成功”的路径是:A 失败 且 B 失败 且 C(rm -rf)成功 且 D 成功 —— 也就是说,只有”克隆失败”这条支路能走到正常的收尾。逻辑完全倒过来了。
这个坑的教训值得写进任何一份 shell 规范:在一个链条里混用 && 和 || 而不加括号,等于把你的意图交给结合性去猜。 想表达”目录在就 A,否则 B”,请写 if。
7.2 with Path(...) as f: —— 一颗定时炸弹#
show-deploy-key 和 setup-nodes 里有这么一段:
deploy_key_path = Path.home() / ".ssh" / "higgsfield" / f"{app_config.name}-github-deploy.key.pub"
...
with deploy_key_path as f:
click.echo(f.read_text() + "\n")Path 不是文件对象,把它当上下文管理器用,凭什么能跑?因为 pathlib 里历史上真的有过 __enter__ / __exit__ —— 它把 Path 变成一个”可变标志”(用完自动标记已关闭),而这个功能从未写进文档、违反了 PEP 428。所以 CPython 在 3.9 把 __exit__ 变成空操作,3.11 开始发弃用警告,标准库源码里写着:
def __enter__(self):
    # In previous versions of pathlib, __exit__() marked this path as
    # closed; subsequent attempts to perform I/O would raise an IOError.
    # This functionality was never documented, and had the effect of
    # making Path objects mutable, contrary to PEP 428.
    # In Python 3.9 __exit__() was made a no-op.
    # In Python 3.11 __enter__() began emitting DeprecationWarning.
    # In Python 3.13 __enter__() and __exit__() should be removed.
    warnings.warn("pathlib.Path.__enter__() is deprecated and scheduled "
                  "for removal in Python 3.13; Path objects as a context "
                  "manager is a no-op", DeprecationWarning, stacklevel=2)
return self我在 Python 3.12 上跑 higgsfield show-deploy-key,它真的把公钥打印出来了 —— 但先吐了这条 DeprecationWarning。而 pyproject.toml 里的约束是:
[tool.poetry.dependencies]
python = "^3.8.13" # 等价于 >=3.8.13,<4.0.0 —— 包含 3.13也就是说:这份代码允许你装在 Python 3.13 上,而在 3.13 上它会直接 AttributeError。 这类”靠一个已弃用的空操作活着”的写法,是代码里最隐蔽的一种技术债 —— 它不报错、不告警(默认过滤掉了)、CI 也不会拦,直到某天有人升级解释器。这个坑从 2023-10-13 的第一次提交就在了:git log -S 显示它和 init: project 一起诞生。
7.3 三处”报错写在了到不了的地方”#
这一类问题比单纯的 bug 更值得记:代码里有防护,但防护被放在了永远执行不到的位置。
第一处:import 期读环境变量。
# higgsfield/checkpoint/fsdp_checkpoint.py,模块级
DEFAULT_CHECKPOINT_PATH = Path.home() / ".cache" / "higgsfield" / \
                          os.environ["PROJECT_NAME"] / "experiments" / \
os.environ["EXPERIMENT_NAME"] / os.environ["RUN_NAME"]在没有 PROJECT_NAME 的进程里做任何和 checkpoint 有关的 import,拿到的都不是一句人话:
File "/tmp/higgsfield-main/higgsfield/checkpoint/fsdp_checkpoint.py", line 22, in <module>
    os.environ["PROJECT_NAME"] / \
    ~~~~~~~~~~^^^^^^^^^^^^^^^^
KeyError: 'PROJECT_NAME'第二处:那句亲切的报错,是死代码。 同一个文件里,Checkpoint.__init__ 有这么一段:
if os.environ["PROJECT_NAME"] and os.environ["EXPERIMENT_NAME"] and os.environ["RUN_NAME"]:
    save_dir = DEFAULT_CHECKPOINT_PATH
else:
raise NotImplementedError("Support single GPU/process not implemeted yet")作者显然想对”单机单卡”这个场景说一句人话。但 DEFAULT_CHECKPOINT_PATH 在模块导入时就已经求值过了 —— 环境变量缺失的话,KeyError 早就抛在 import 环节了,这个 else 分支永远到不了。想给用户一句友好的话,就得把”读环境变量”从模块级挪到函数里 —— 这是 Python 里最经典的一处”初始化时机”陷阱。
第三处:防御检查写在了不可能为 None 的字段上。
def is_valid(self) -> Optional[str]:
    if self.github_repo_url is None:
        return "GITHUB_REPO_URL is None"
    if self.key is None:                 # key 的类型是 str,永不为 None
        return "SSH_KEY in env is None"
returnkey 由 get_key_from_path_or_key 返回,类型标注和实现都保证它是 str。真正需要拦的情况 —— SSH_KEY 被填成一个不存在的路径字符串 —— 没有被拦。于是 higgsfield setup-nodes 会带着那个占位字符串一路走到 SSH 建立环节,最后报:
asyncssh.public_key.KeyImportError: Invalid private key一句和”你的 SSH_KEY 没配好”差了十万八千里的错误。对照一下:同一个项目里,get_key_from_path_or_key 对”没填”这件事给的报错是清楚的 —— 差的只是没人检查”填了但填错了”。
7.4 存盘时会悄悄丢元数据#
Checkpoint.save() 的收尾长这样:
if self.lr_scheduler:
    torch.save(self.lr_scheduler.state_dict(), save_path / "lr_scheduler.pt")

if self.scaler:
    scaler_path = save_path / "scaler.pt"
    torch.save(self.grad_scaler.state_dict(), scaler_path)     # ← self.scaler 还是 self.grad_scaler?

metadata_path = save_path / "metadata.json"
metadata["epoch"] = epoch
metadata["steps"] = steps
with open(metadata_path, "w+") as jsonFile:
json.dump(metadata, jsonFile)构造函数收的参数叫 scaler,存盘时访问的属性叫 grad_scaler。我实测了两种调用:
scaler=None:正常写出metadata.json;scaler=<对象>:AttributeError: 'Checkpoint' object has no attribute 'grad_scaler',model.pt在、lr_scheduler.pt在,metadata.json没了。
而 save() 是在训练循环里按 i % 30 == 0 调的 —— 也就是说,这个异常会在第一次存盘时炸掉整个训练进程。好消息是这个笔误一眼可见 —— 同一个目录下 model.pt、optimizer.pt、lr_scheduler.pt 命名一致,只有 scaler 那行对不上;坏消息是这条路径显然没有被跑过,而它恰恰是混精度训练绕不开的那条路。
顺带一记:同一目录下 Scaler 类的实现是这样的 ——
class Scaler(object):
    def __init__(self, model):
        if model.fsdp:
            self.scaler = ShardedGradScaler()
        else:
return torch.cuda.amp.GradScaler() # ← __init__ 里 return 一个实例Python 规定 __init__ 只能返回 None,返回别的东西会直接抛 TypeError: __init__() should return None, not 'GradScaler'。这个分支想表达的是”非 FSDP 场景直接用原生 GradScaler”,但正确的写法是赋值(self.scaler = ...)或者写一个工厂函数。另外,教程里写的是 scaler.scale(loss),而这个类暴露的是 scaler.scaler.scale(loss) —— 文档和实现对不上,这一处也在 issue #37 的抱怨清单里(用户报的是”LLama 和 hugging face 相关的接口”)。
7.5 一处 import 不了的空壳,一处值里带 = 就崩的解析#
# higgsfield/utils/__init__.py 的全部内容
from .utils import empty_cache但同目录下的文件叫 flush.py。任何 from higgsfield.utils import ... 都会得到 ModuleNotFoundError: No module named 'higgsfield.utils.utils'。这属于”重构没收尾”的痕迹:文件改名了,导出没跟着改,而没有任何测试会碰到它。
命令行解析同样脆:
def _parse(self, rest: List[str]):
    kwargs = {}
    for arg in rest:
        if "=" not in arg:
            continue
        key, value = arg.split("=")      # 值里再有一个 '=' 就崩
        kwargs[key] = value
return kwargs实测:hf_action_prompt_url=https://example.com/?a=1 → ValueError: too many values to unpack (expected 2)。缺 maxsplit=1,也缺”这个 key 没带 =”的提示 —— 后者是更常见的情况,而它选择静默跳过。
7.6 只用 GitHub 是刻意的,但错误信息不该刻薄#
https_repo_url_pattern = re.compile(r"^https\:\/\/github\.com\/[a-zA-Z0-9\-\_]+\/[a-zA-Z0-9\-\_]+\.git$")

def convert_https_to_ssh(link: str) -> str:
    gh, user, repo = link[8:-4].split("/")
return f"git@{gh}:{user}/{repo}.git"我实测了五种 remote:
| git remote origin | 归一化结果 | 最终 |
|---|---|---|
https://github.com/user/demo_project.git | git@github.com:user/demo_project.git | 正常生成 |
git@github.com:user/demo_project.git | 原样 | 正常生成 |
https://github.com/user/demo_project | None | 报 “Did you add git remote origin?” |
https://gitlab.com/user/demo_project.git | None | 同上 |
https://gitee.com/user/demo_project.git | None | 同上 |
注意第三条:从浏览器地址栏复制下来的链接通常就是不带 .git 的,而那正是新手最容易做的事。此时你得到的错误信息是”你有 push 到 github 吗?” —— 但你明明 push 了,只是 URL 少四个字符。issue #37 的第一条抱怨说的就是这个:
Please don’t expect that git address is something like this … I tried to use it with the internal github which is different from public github and got an error.
维护者在下面回复说”A nice catch. We haven’t thought about it.” —— 一个只支持 GitHub、且只支持两种 URL 形态的编排工具,遇到内网 GitLab 只能报一句误导人的话。
7.7 最刺眼的一条:执行器没了#
回到那张架构图的底部方框。invoker 是真正干活的组件(拉起 torchrun、管多机进程、随机端口、随机 run name、杀训练),它不在这个仓库里,而生成的每一个工作流都要去下载它:
- name: Install invoker
  run: |
    wget https://github.com/ml-doom/invoker/releases/download/latest/invoker-latest-linux-amd64.tar.gz
    tar -xvf invoker-latest-linux-amd64.tar.gz
sudo mv invoker /usr/bin/invokerinvoker 也出现在 ci/setup.py 里(装到节点上)和 NOTICES.md 里的引用链接中,而 NOTICES 里指向的是另一个组织名:higgsfield-ai/invoker。
我查了这两个地址,今天的状态是:
$ curl -s -o /dev/null -w "%{http_code}" https://api.github.com/repos/ml-doom/invoker        → 404
$ curl -s -o /dev/null -w "%{http_code}" https://api.github.com/repos/higgsfield-ai/invoker  → 404
$ curl -sI <releases/download/latest/invoker-latest-linux-amd64.tar.gz> → 404两个都不存在。所以今天你去跑这个框架,生成出来的工作流会在 Install invoker 这一步失败。
这条发现比前面所有 bug 都更能说明这个项目的性质:它是一个编排外壳,依赖一个闭源、且今天已经消失的执行器。 结论不重要(GitHub 上的休眠项目本来就是这样),过程很重要 —— 下次读任何”框架类”仓库,先问一句:它依赖的最关键组件,在这个仓库里吗?
7.8 顺手做个诚实校验:生成物本身是合法的#
前面说过手拼 YAML 的问题,那它到底有没有构成实质缺陷?我装了 actionlint ↗ 1.7.7(当前版本)来验:
$ actionlint .github/workflows/*.yml
deploy.yml:22:13: the runner of "actions/checkout@v3" action is too old to run on GitHub Actions. update the action's version ...
kill.yml:24:15: 同上
run_alpaca_bf16.yml:41:13: 同上
run_alpaca_fp16.yml:41:13: 同上
exit=1四条告警全部是同一件事:actions/checkout@v3 因为 Node 16 跑不动了,需要升级到 v4 —— 这是 2024 年项目的典型老化。至于 required: True、default: 1 这些 Python 字面量,actionlint 没有报错。所以结论应当说准确:这是一个不优雅但能被接受的实现,不是 bug。诚实地区分”不优雅”和”坏掉了”,比笼统地质疑更接近真相。
顺带说一句 deploy.yml 里另一处细节:它在 cd ~/higgsfield 之后写 echo "SSH_KEY='NOTHING'" > env,而 run_*.yml 是在 cd ~/higgsfield/<project> 之后写同样的东西。前者把 env 落在了项目目录外面(~/higgsfield/env),后者落在项目里面。部署流程里那份 env 大概率是多余的拷贝,但它落错了位置这件事,说明两个模板是同一个人在不同的心情下写的。
八、把代码事实和用户体感钉在一起#
上面那些发现,有一半不是我自己挑出来的 —— 它们被一个真实用户在 2023-11-22 就写进了 issue #37,标题叫 Some issues if try to use it in a real life :) ↗。这个 issue 至今还是 open 状态,而它列的四条,和我上面逐条实测的结果几乎一一对应:
| 用户的抱怨(2023-11) | 我在代码里找到的证据 |
|---|---|
| 别假设 git 地址一定是公网 GitHub,我用内网 GitHub 直接报错 | match_https_link 的正则写死了 https://github.com/…git;实测 GitLab/Gitee/无 .git 一律报 “Did you add git remote origin?” |
| 报错信息没用(“something is not a string”),要 debug 才能发现是我参数写错了 | AST 解析里 except Exception: print(e); stop = True —— 异常被打印后吞掉,实验直接消失;hf_action_* 的拼写错误被静默过滤 |
| import llama loader 就自动联网访问 HF,没有我的许可,我明明已经下好了 | LlamaLoader.__init__(tokenizer=LlamaTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")) —— 默认参数在定义时求值 |
| 能不能给个单机/单卡、不用 GitHub 也能跑的例子?不然我怎么 debug | Checkpoint.__init__ 的 NotImplementedError("Support single GPU/process not implemeted yet") 是死代码,单机场景在 import 阶段就 KeyError 了 |
维护者 arpanetus 在一天后回复,态度很好,逐条认了下来,包括那句”我们暂时没有单机路径,很抱歉”。这大概是开源里最健康的一幕:用户给了四条能直接落成 checklist 的反馈,维护者也认了,然后…… 这个项目在三个月后停止了更新。
值得说明的是,我不认为这些缺陷是”能力问题”。恰恰相反,这个仓库里 5.1 节那套 meta 设备方案说明作者对 FSDP 的理解是在水准线之上的。真正导致这些问题的,是另一件更常见的事:一个快速把想法做成了形的小团队,把预算全投在了”跑通主路径”上,而主路径之外的每一条支路 —— 单机、非 GitHub、报错信息、测试 —— 都留着”以后再说”。
那”以后”有没有来?看一下它的 CI 就知道答案。这个仓库的测试基础设施只有两个文件:一个发布 workflow,一个 smoketest.yml。而 smoketest.yml 的全部内容是:
- name: Install higgsfield
  run: pip install .
- name: Init project
  run: |
    higgsfield init some_project
    cd some_project
    git init
    git remote add origin https://github.com/higgsfield-ai/some_test
    git add .
    git commit -m "..."
    higgsfield build-experiments
# TODO: compare the generated files with static ones它做的唯一断言是”命令没有崩”。 生成出来的 YAML 对不对、实验有没有被静默丢掉、参数有没有被静默忽略 —— 全部不校验。那个 TODO 写在那里,而仓库的生命周期没有等到它被实现。于是前面 7.1 到 7.6 的所有问题,都是这个 TODO 的直接后果:一个没有断言的 CI,只能证明它跑过了,不能证明它对。
九、那么,这套设计里有什么值得带走#
批评完了,该说收获。我读完这份代码,记下了五条正面经验、三条反面经验,它们比我见过的很多”最佳实践”文章都具体。
① “CI 即调度器”是一个被低估的方案。 如果你要管的东西是”一批机器 + 同一个代码仓库 + 少量人工触发的任务”,GitHub Actions(GitLab CI、Jenkins 同理)提供的四件套 —— 手动触发表单、并发队列(concurrency + cancel-in-progress)、一台免费的调度 runner、可分享的运行历史 —— 刚好覆盖需求。它的代价是绑定平台、以及”调度状态存在平台里”;它的收益是零额外的运维面积。这个权衡在很多场景下是划算的,尤其是团队人数小于 10 的时候。
② 把参数契约”生成”出来,而不是”同步”出来。 这套框架的整个价值,就是把 @param 这份声明编译成三个消费端(GitHub 表单、CI 命令行、运行期对象)。手工维护三处一致是不可能的,生成是唯一出路。这件事在今天有更成熟的形态(比如 Pydantic + 代码生成),但”单一真理来源 + 生成”这个思路本身是稳的。
③ meta 设备 + sync_module_states + param_init_fn 的三件套。 这是 5.1 节讲的:先造空壳(torch.device('meta'))、让参数以”垃圾内容”落地(to_empty)、再用 rank0 的广播覆盖(sync_module_states=True)。任何要在多机上加载大模型的项目都能直接照抄这三步,而且它能顺手统一”从 HF 加载”和”从自己的 checkpoint 恢复”两条路径。
④ 用哨兵值编码环境差异。 SSH_KEY='NOTHING' 是一个漂亮的例子:在结构上必须有值、语义上不可能有值的地方,放一个显式的假值,并让读取方承认它。它比”到处判断我在哪个环境”干净,也比”留空让下游崩”可靠。
⑤ 检查点的目录规范。 ~/.cache/<project>/experiments/<experiment>/checkpoints/<run>/epoch_N_steps_M/ 加一个 metadata.json,这一套几乎是免费的可观测性:谁跑的、哪个实验、第几轮、多少步,全部能从路径读出来。多重实验、多个 run 并行时,你不会覆盖别人的结果。
然后是三条反面经验,我认为它们比上面五条更值钱:
⑥ 生成式配置的失败必须”响”。 这套系统里所有真正伤人的问题,都不是崩溃,而是沉默:装饰器顺序不对 → 实验消失;参数拼错 → 用默认值;值里带 = → 抛一个和上下文无关的 ValueError。当你把一个参数从 A 翻译到 B 再到 C,每一跳都必须有一个”未知即错误”的检查。宁可误报。
⑦ import 必须无副作用。 LlamaLoader 的默认参数联网、fsdp_checkpoint.py 的模块级 os.environ[...],都是这条规则的违反。它的代价不只是”不方便”:一旦 import 有副作用,“用 AST 静态分析代替执行”这个前提就失效了 —— 而这个前提恰恰是这套框架 build 期设计的全部依据。一个仓库里的好设计与坏实践常常互相拆台,而坏实践往往赢在”先写下来”。
⑧ 平台假设要写进错误信息里。 只支持 GitHub 是产品决策,没问题;但当用户拿着 GitLab 地址过来时,回他一句”你有 push 到 GitHub 吗?”就是另一种性质的问题了。错误信息的质量,直接决定了用户要花多少时间才能理解你的假设。
结语#
现在回到最初那三个问题。
为什么一个休眠两年的仓库值得读? 因为它提出并回答了一个别人很少正面回答的问题:如果不想养调度器,能不能用 CI 顶上去?它的答案里有真东西(meta 设备三件套、哨兵值、生成式参数契约),也有真坑(bash 左结合、消失的实验、埋错位置的报错)。前者可以直接抄,后者可以当反面教材 —— 而两者都比”又一个 FSDP 封装”更有信息量。
为什么它今天跑不起来? 因为它的执行器 invoker 从未开源,而那个二进制的下载地址今天返回 404;因为它的依赖钉在 2024 年初;因为唯一能救它的测试文件里写着 # TODO: compare the generated files。一个框架的死因通常不是技术不行,而是它依赖的那些东西 —— 人、二进制、平台、依赖 —— 逐个离开。
那它留下了什么? 我看到的是同一家公司今天在做的另一件事:组织的仓库列表里,cli(564 stars)、skills(1,078 stars)、higgsfield-client、higgsfield-js 都是 2026 年 9 月刚更新的,描述是”Higgsfield CLI""official Higgsfield SDK”。从”教你用自己的机器训练大模型”,到”让 agent 调用我们的生成 API” —— 同一个组织换了一种方式回答”谁该拥有算力编排”这个问题。
而这份老代码的价值,大概就像一块地层剖面:你想知道 2023 年一个 AI 小团队是怎么在两周里把”多机多卡训练”做成两条命令的,读它就够了。它失败了,但它失败得很具体 —— 具体到可以一条条复现,一条条学到东西。
这比成功案例有用。成功案例只告诉你它做对了什么,而这份仓库告诉你每一个”以后再说”会在哪里变成利息。
附:本文所有实测均在 2026-09-21 完成。复现环境:Python 3.12、
PYTHONPATH指向main分支(d12a36e)的源码树;需要click、jinja2、pyyaml、python-dotenv、cryptography、asyncssh(本机无 torch,torch相关模块级代码用 stub 模块加载到执行点)。生成的四个工作流用 actionlint 1.7.7 校验。截图来自仓库自带文档docs/static/。