一、为什么 io_uring 值得拆#
Linux 内核主仓库(torvalds/linux)1.4GB+、2000万行 C、几万个文件——我不会整体拆。但有一个子系统我必须拆:io_uring/。
它是 Linux kernel 历史上唯一一个因为”单子系统太重要”而独立建顶层目录的情况。2019 年 Jens Axboe 在 Linux 5.1 引入 io_uring,2020 年独立为 io_uring/ 顶层目录(和 kernel/ fs/ net/ mm/ 平级)。
我读完 io_uring/io_uring.c 头 30 行的注释,被锤到了——这是 Linux kernel 历史上最重要的「跨用户态/内核态同步契约」,没有任何其他子系统写得比它更清楚。
把心智吃透后,3 条核心:
- 2 个共享 ring(SQ 提交 + CQ 完成)+
mmap+tail/head索引 = 跳过 99% syscall - release-acquire 内存屏障配对——每一步都对应一对跨边界原子操作
- IORING_SETUP_SQPOLL —— 内核线程 poll SQ,连 syscall enter 都省了
让我把前两个画给你看。
二、先看 io_uring/ 长什么样#
我没 git clone 整个 kernel(那是 1.4GB),只 git 了 io_uring/ 子系统的核心文件:
io_uring/
├── io_uring.c          90KB · 3097+ 行 · 核心实现
├── io_uring.h          16KB · 内核内部头
├── Makefile            ← 30+ .c 文件构建规则
├── Kconfig             ← CONFIG_IO_URING 配置开关
├── opdef.c / rw.c / poll.c / fs.c / splice.c / sync.c / ...
├── cancel.c / timeout.c / waitid.c / futex.c / epoll.c / ...
├── sqpoll.c            ← IORING_SETUP_SQPOLL 实现
├── io-wq.c             ← 异步 worker 池(38KB)
├── kbuf.c / rsrc.c / filetable.c / tctx.c / register.c / ...
├── net.c / cmd_net.c   ← 网络相关
├── napi.c              ← NAPI / busy-poll
├── bpf_filter.c / bpf-ops.c ← BPF 集成
└── _echo/ (CI 回归 stub)30+ 个 .c 文件,加起来约 500KB——这只是一个 io_uring 子系统的体量。但里面藏着「未来 10 年 Linux I/O 编程模型」的设计哲学。
2.1 Makefile 揭示的依赖结构#
Makefile 里的 obj-$(CONFIG_IO_URING) 一行:
obj-$(CONFIG_IO_URING) += io_uring.o opdef.o kbuf.o rsrc.o notif.o \
                          tctx.o filetable.o rw.o poll.o \
                          tw.o wait.o eventfd.o uring_cmd.o \
                          openclose.o sqpoll.o xattr.o nop.o \
                          fs.o splice.o sync.o msg_ring.o \
... (30+ 个 .o)io_uring.o 是「主入口」,其余 30+ 个 .o 是「按 I/O 类型切分的实现」——读 / 写 / poll / fs / net / splice / sync / msg_ring / nop 等等。每个 .o 独立可配置,可以根据硬件平台剪裁。
2.2 io_uring_setup 在 3097 行#
io_uring.c 里 io_uring_setup() 函数在第 3097 行——SYSCALL_DEFINE2(io_uring_setup, u32, entries, struct io_uring_params __user *params)。
这是整个 io_uring 唯一的初始化 syscall——给你一个 mount(2) 风格的 fd,内部装着 2 个共享 ring。之后的所有 I/O 都是「写 ring + 偶尔 io_uring_enter() 唤醒内核」。
三、核心心智 1:双 ring + mmap 共享 = 跳过 syscall#
把 io_uring 的请求/响应链路画成一张图:
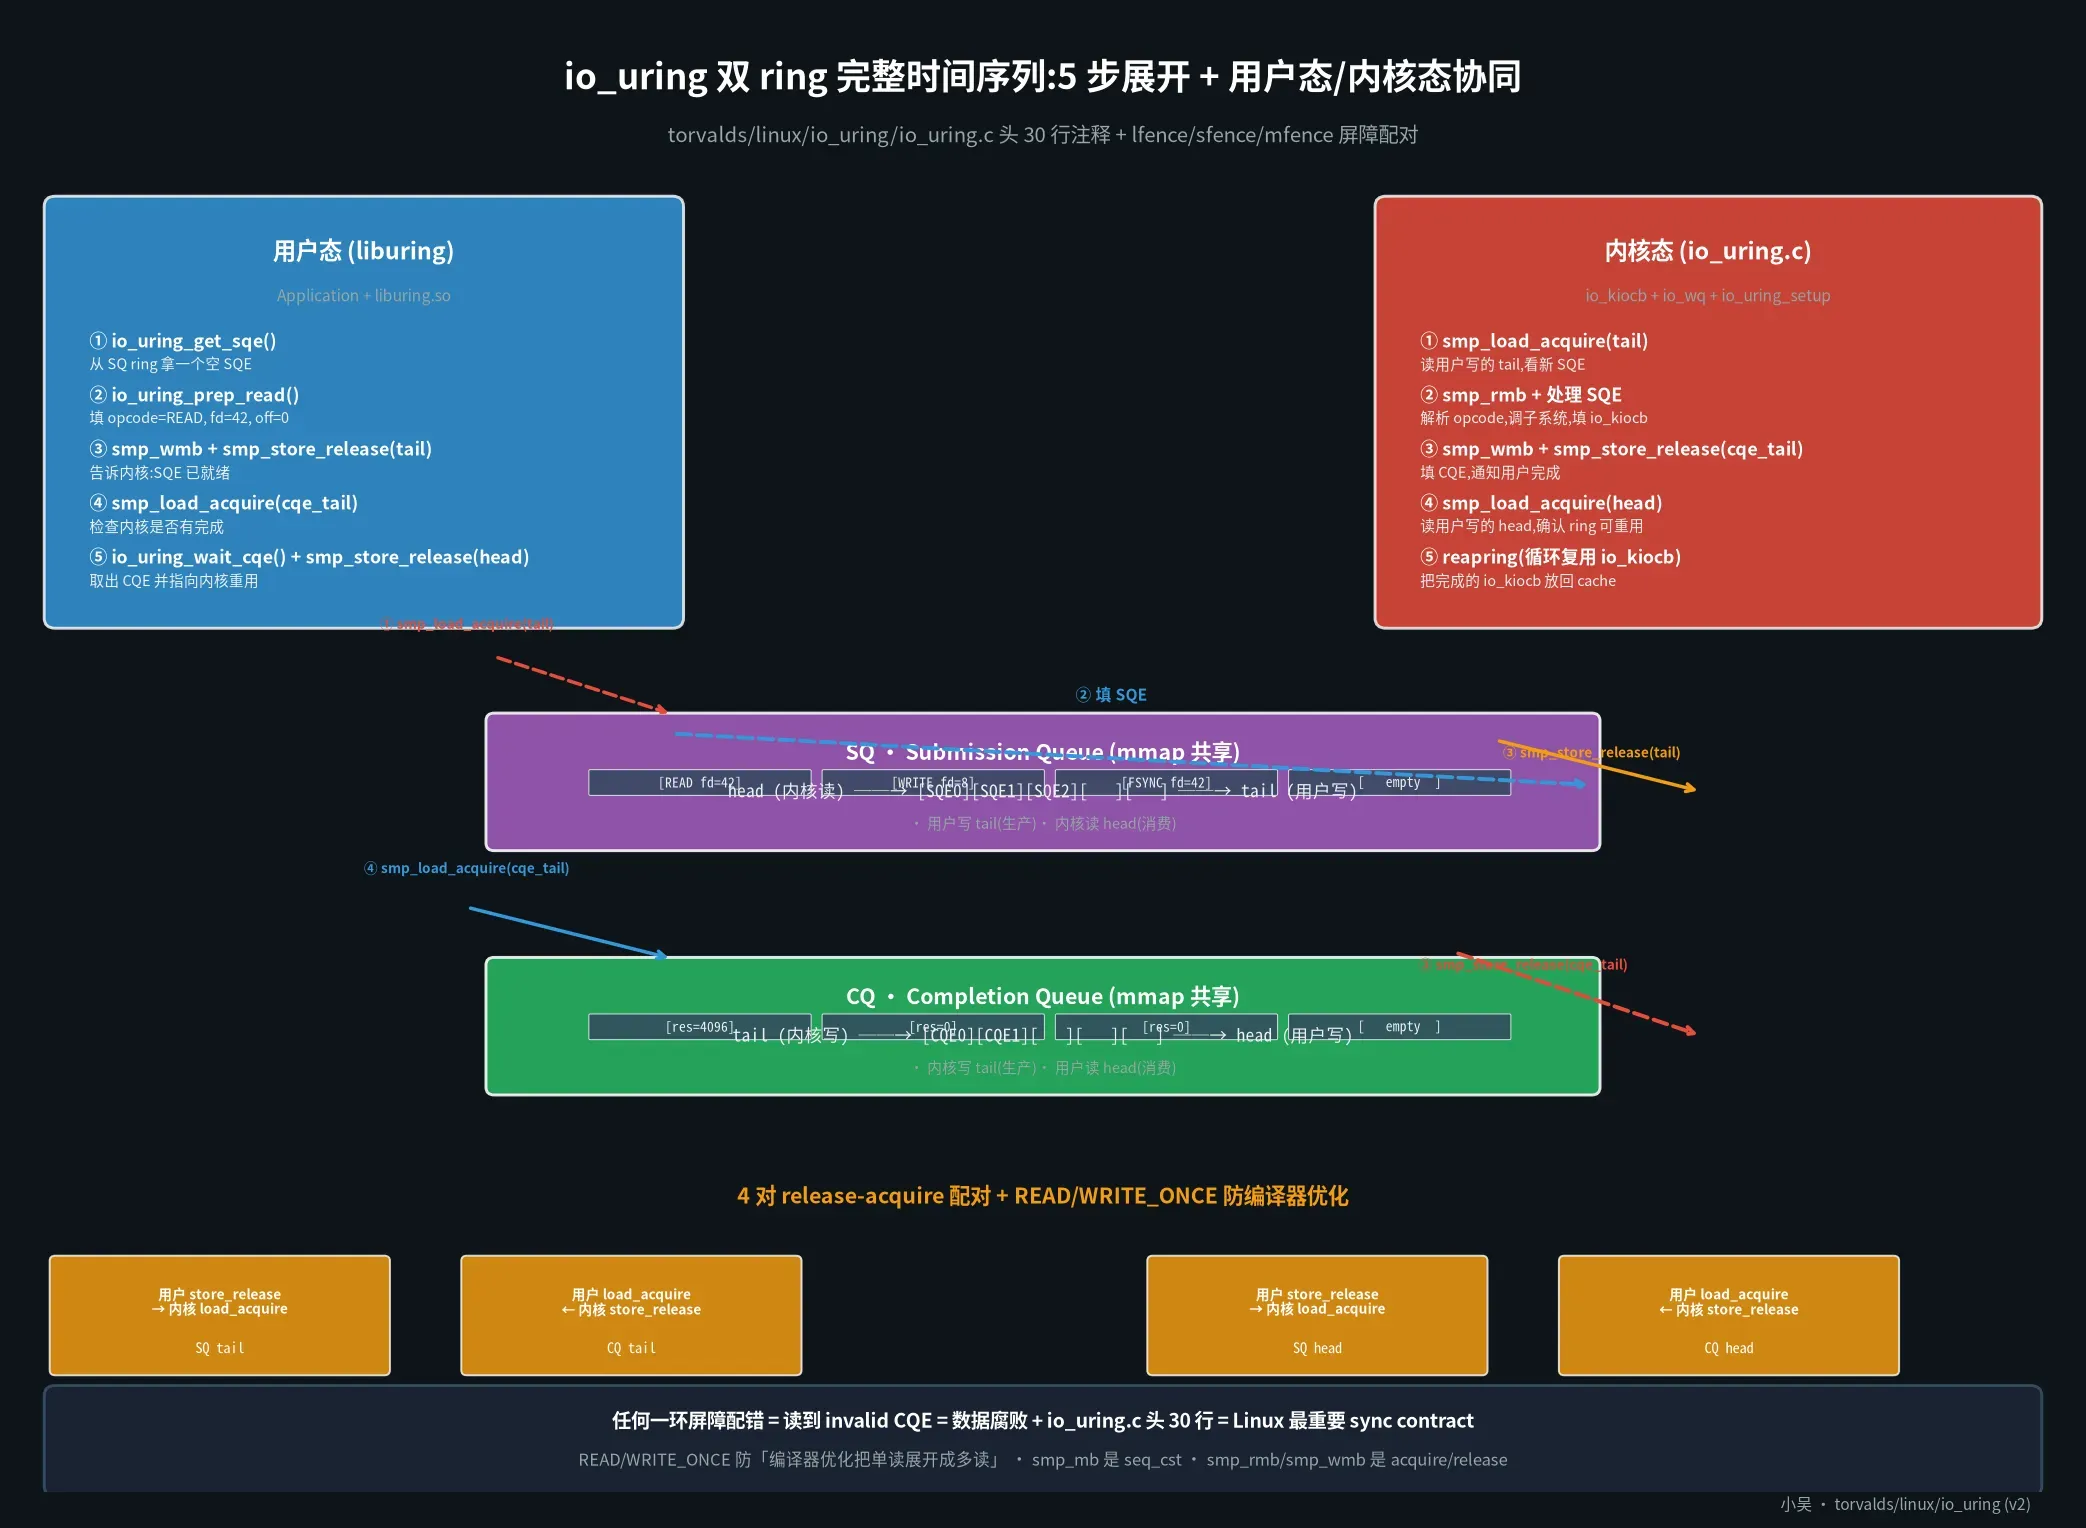
这张图把 io_uring 的核心心智可视化讲明白:用户态和内核态共享 2 个 ring,99% 的操作都不走 syscall。
【动图】 如果静态图看不清楚,这里有一张 6 帧动画逐步展示完整流程(用户填 SQE → 屏障 → 推 SQ tail → 内核 poll → 处理 → 推 CQ tail → 用户消费 CQE):
动图说明:首帧用户填 SQE0 = READ fd=42;后续 5 帧逐步推进 · 6 帧后完成一轮循环 · 最后一帧展示 smp_store_release(head) 复用 ring 准备下一轮。
3.1 2 个共享 ring#
io_uring 在初始化时申请 2 块共享内存:
- SQ(Submission Queue)——用户填请求,内核读请求
- CQ(Completion Queue)——内核填完成,用户读完成
这 2 个 ring 通过 mmap() 映射到用户态地址——用户态读写 tail / head 索引,不需要 syscall。
3.2 tail/head 索引约定#
每个 ring 用 tail(生产者)和 head(消费者)2 个原子索引:
SQ: tail (用户写) ── 推进 ──>  <empty>  <── 推进 ── head (内核读)
CQ: tail (内核写) ── 推进 ──> <empty> <── 推进 ── head (用户读)- SQ 的 tail 由用户推进——“我有新请求”
- SQ 的 head 由内核推进——“我处理了哪个”
- CQ 的 tail 由内核推进——“我有新完成”
- CQ 的 head 由用户推进——“我消费了哪个”
两个 ring 的 head/tail 永远不交叉,而且只往一个方向推进**——这是经典的「多生产者/单消费者环形队列」设计。
3.3 一次 syscall enter/leave 都没有#
传统 read() / write() 流程(每个请求 2-5 次):
fd = open(path, ...)         // syscall
fstat(fd, &st)              // syscall
read(fd, buf, len)          // syscall → 内核调度 → 拷贝
... 循环
close(fd) // syscallio_uring 流程(0 次 syscall / 一次请求):
io_uring_get_sqe()          // mmap 读 ring,0 syscall
io_uring_prep_read(...)     // mmap 写 ring,0 syscall
io_uring_submit()           // 写 tail + 一次 io_uring_enter syscall
... 循环
io_uring_wait_cqe() // mmap 读 CQ,0 syscall一次 io_uring_enter() syscall enter/leave 通常 batch 处理几十到几百个请求——这对高频 I/O 是几十倍到几百倍的开销下降。
3.4 IORING_SETUP_SQPOLL:连 syscall enter 都省了#
SQPOLL 模式(sqpoll.c)启动一个内核线程持续 poll SQ tail:
// 用户态:
int ret = io_uring_queue_init(32768, &ring, IORING_SETUP_SQPOLL);
// 之后用户完全不需要 io_uring_enter syscall
// 内核线程自己看到 tail 变化 → 处理 SQE → 填 CQE这条打破了我读 io_uring.c 头注释时最深的认知冲击:「I/O 不再等于 syscall」。
50 年前 Unix 把「I/O = syscall」写进操作系统教科书。io_uring 用 mmap + 内核线程 poll,把这条假设彻底打破——你 I/O 100% 在用户态做,内核只是被动服务。
四、核心心智 2:内存屏障配对 = 跨用户态/内核态同步契约#
io_uring.c 头 30 行的注释,把跨边界同步契约写得精确到原子操作。我把整个流程画成下面这张图:
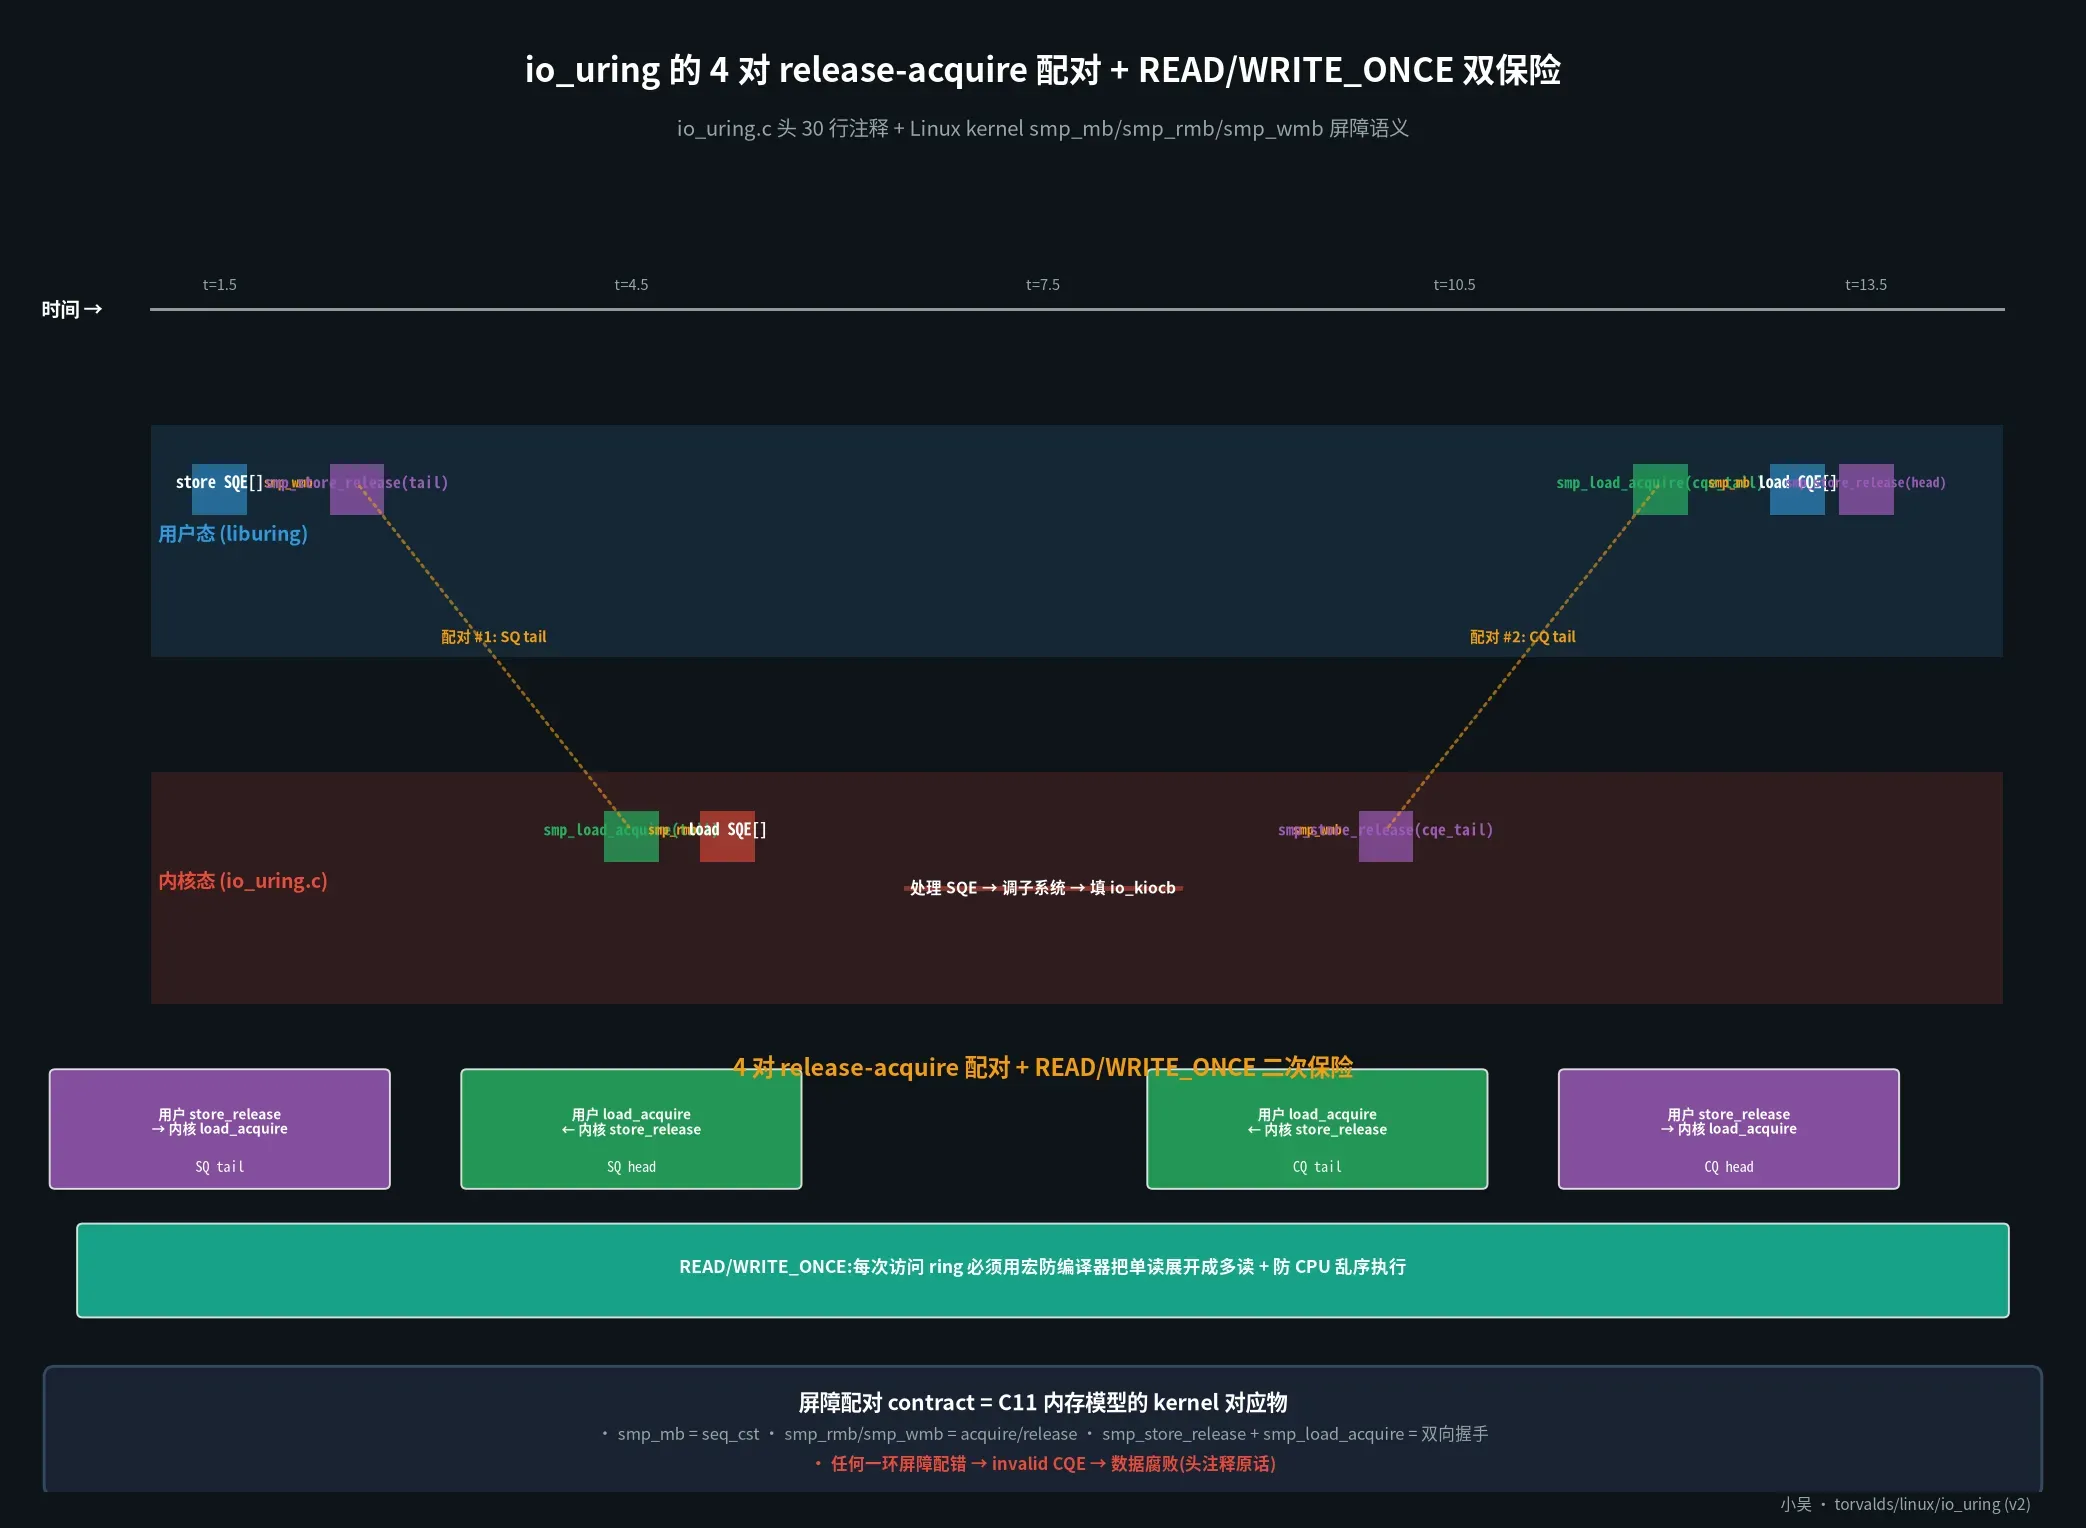
这张图把 io_uring 的「release-acquire 配对」同步模型可视化讲清楚。
【动图】 如果静态图看不清楚,这里有一张 8 帧动画逐步展示 4 对配对 + READ/WRITE_ONCE 二次保险:
动图说明:每帧推进时间线上一步,逐步展示 store_release / load_acquire / smp_mb / smp_rmb / smp_wmb 5 种屏障操作如何在用户态 + 内核态之间配对。8 帧后顶部出现「⚠ 任何一环屏障配错 = invalid CQE = 数据腐败」的红色警告。
4.1 头注释里的硬承诺#
源代码原话:
“After the application reads the CQ ring tail, it must use an appropriate
smp_rmb()to pair with thesmp_wmb()the kernel uses before writing the tail (usingsmp_load_acquireto read the tail will do). It also needs asmp_mb()before updating CQ head (ordering the entry load(s) with the head store), pairing with an implicit barrier through a control-dependency inio_get_cqe(smp_store_releaseto store head will do). Failure to do so could lead to reading invalid CQ entries.”
翻译:每一步都有对应的内存屏障配对,任何一环配错 = 读到 invalid CQE = 数据腐败。
io_uring 的同步契约是 4 对配对:
| 用户态 | 内核态 | 屏障 |
|---|---|---|
smp_store_release(tail) | smp_load_acquire(tail) | 隐式 |
smp_wmb() (sqe store → tail store) | smp_rmb() (tail load → sqe load) | 显式 |
smp_store_release(head) | smp_load_acquire(head) | 隐式 |
smp_mb() (cqe load → head store) | smp_wmb() (处理 → cqe store) | 显式 |
这条注释是 Linux kernel 历史上最精确的跨用户态/内核态同步契约——任何看 io_uring 头注释的人,都会被「屏障配错 = 读 invalid data」这条 hard guarantee 砸到。
4.2 release-acquire 的「双向握手」#
io_uring 的屏障配对本质上是 release-acquire 同步模型:
- store_release → 「我写完了,你看到了」
- load_acquire → 「我看到了,后续读都依赖这个值」
这是 C11 / C++11 引入的 std::memory_order 模型的 Linux kernel 对应物。
任何共享数据结构在用户态/内核态之间的同步,本质都是 release-acquire 配对——io_uring 把这件事做到了「头注释 30 行讲清,代码 100% 遵循」的极致。
4.3 READ/WRITE_ONCE = 第二道保险#
源代码里还有一条更硬的契约:
“io_uring also uses READ/WRITE_ONCE() for any store or load that happens from data shared between the kernel and application. This is done both for ordering purposes, but also to ensure that once a value is loaded from data that the application could potentially modify, it remains stable.”
READ/WRITE_ONCE() 是 Linux kernel 提供的”防止编译器优化把单次读展开成多读”的安全网——任何共享数据访问都必须用它。这是 io_uring 防止「编译器 + CPU 乱序执行」双层优化的标准武器。
任何一个 io_uring 实现,如果不用 READ/WRITE_ONCE,都是错的——这条契约比内存屏障配对还更基础。
五、读源码学到的 5 件事#
把 io_uring.c 头 30 行读完后,我把它对系统的工程认知总结成 5 条:
5.1 共享数据结构 = release-acquire 配对 + READ/WRITE_ONCE#
io_uring 的跨用户态/内核态共享 ring 用 4 对 release-acquire 配对 + READ/WRITE_ONCE 防优化 + smp_rmb/smp_wmb 显式屏障 三件套实现完整同步契约。
可推广到:
- mmap 共享 ring(io_uring 本身就是)
- 共享内存 IPC(System V shm / POSIX shm)
- GPU-CPU 同步(OpenCL / CUDA 共享显存)
- 进程间共享文件(Solaris doors / Plan 9 9P)
任何「共享数据 + 跨边界」的设计,都该先写头 30 行同步契约。
5.2 mmap + tail/head 索引 = 跨边界无锁环形队列#
io_uring 的 SQ/CQ 用 「多生产者/单消费者环形队列」——这是经典的 Lock-free MPSC 设计。tail 是生产者索引,head 是消费者索引,两个索引永远只往一个方向推进。
这条设计可以推广到:
- 数据库 WAL(pregreSQL / MySQL InnoDB 都用类似 ring)
- 网卡 ring buffer(DPDK / AF_XDP)
- 音视频 pipeline(GStreamer / JACK)
- 跨进程消息队列(Kafka segment / RocketMQ commitlog)
只要是「A 写 B 读 + 大量并发 + 零拷贝」,这个模式都是首选。
5.3 「I/O ≠ syscall」是 io_uring 的最大贡献#
50 年 Unix 把「I/O = syscall」写进操作系统教科书。io_uring 用 mmap + 内核线程 poll,把这条假设彻底打破。
这条心智可推广到:
- WASM component model —— 计算单元不一定是 syscall
- GPU programming —— 主机 ↔ device GPU 通过 PCIe + 共享内存,不是 syscall
- RDMA —— NIC ↔ host 通过 DMA + completion event,不是 syscall
- DPDK / AF_XDP —— 用户态驱动直接操作网卡 ring,绕过 kernel
「任何资源访问 = syscall」是 1970 年的假设——io_uring 是 2020 年代对这条假设的第一次系统级挑战。
5.4 IORING_SETUP_SQPOLL 把 syscall enter/leave 都省了#
SQPOLL 模式启动内核线程持续 poll SQ tail——用户态完全不调用 syscall,内核看到 tail 变化自动处理 SQE + 填 CQE。
这是 io_uring 最激进的优化——对 1KB 量级小 I/O 高频场景,SQPOLL 比传统 epoll/event loop 还快一个数量级。
这条心智可推广到:
- io_uring + DPDK —— 网络和存储全是 user-space 队列
- DPDK + SPDK —— 全用户态数据面,内核只做控制面
- OpenOnload / Solarflare ef_vi —— 内核 TCP 栈被完全绕过
未来 10 年的高性能服务:kernel-bypass + user-space ring + 零 syscall overhead。
5.5 头注释 = 工程 contract#
io_uring.c 头 30 行注释写的是「跨用户/内核同步契约」——这 30 行是被 Jens Axboe 反复推敲过的、跨平台跨硬件版本都成立的「合同条款」。
这条工程价值远超 io_uring 本身——它示范了「复杂子系统的头注释应该怎么写」:
- 不写「这个函数做什么」(那是实现)
- 写「用户必须做什么 + 内核保证做什么」(那是契约)
- 用最少的代码 + 最多的注释,把所有「违反契约会发生什么」讲清楚
我读完这段注释后把这条写进自己的代码审查清单:
任何暴露给其他子系统 / 用户态的接口,头注释必须包含「使用方契约 + 违反契约的后果」——这是「认真做 code」的飞轮起点。
六、横向对比:io_uring 和其他异步 I/O 框架的差异#
读完 io_uring 后,我把它和主流同步异步 I/O 模型做了横向对比:
| 模型 | 同步/异步 | 跨边界拷贝 | syscall 次数 | 性能 |
|---|---|---|---|---|
| read/write | 同步 | 内核空间 copy_from_user | 每请求 1 次 | 基准 |
| readv/writev | 同步 | 多次 copy_from_user | 每请求 1 次 | 多 buffer 友好 |
| epoll + read | 同步 | 内核空间 copy | 1 syscall + 1 read syscall | 高并发友好 |
| AIO(lio_) | 异步 | 内核空间 copy | 1 syscall | 仅限 O_DIRECT 写,buggy |
| libaio | 异步 | 内核空间 copy | 1 syscall | 仅限 O_DIRECT 写 |
| io_uring | 异步 | mmap 共享,零拷贝 | 0-1 syscall | SOTA |
| DPDK/AF_XDP | 用户态轮询 | 完全 user-space | 0 syscall | 内核 bypass |
io_uring 在「异步 + 不 bypass 内核」的范围内是 SOTA。它把传统 AIO 的多个限制都打破:
- 不再要求 O_DIRECT
- 支持任意文件描述符(sock / pipe / eventfd / 普通文件 / io_uring)
- 支持多 SQE 批量提交
- 支持 IORING_OP_* 任意 opcode 组合(read / write / accept / open / close / fsync / sendmsg / recvmsg / 各种 io_uring 内核操作)
- 支持 SQPOLL 模式(内核 poll,完全 0 syscall)
6.1 io_uring 不适合什么场景#
我自己的判断,以下场景 io_uring 不是首选:
- 一次性低频 I/O(shell 工具 / CLI 一次性操作)——epoll + read 更简单
- 跨平台——io_uring 仅 Linux,其他 OS 没有
- 已有 epoll/eventfd 的成熟服务——重写收益 < 工程风险
- DPDK/Solarflare 已经在用——直接 user-space ring 比 io_uring 还更直接
但如果你写新的 Linux 服务、需要高吞吐 I/O——io_uring 是 2024 年之后的默认选择。
七、可复用方法论:读 Linux kernel 子系统的正确姿势#
读完 io_uring 子系统(没读整个 kernel,只 git 它里面的东西),我把读「Linux kernel 子系统」的方法论总结成 4 步:
- 先看头 30 行注释——核心子系统都有「已经习惯了的头注释」(Jens Axboe 的 io_uring.c / Linus 的调度器注释 / Ingo Molnar 的调度器注释),头注释是 contract,比代码重要
- 看 Makefile / Kconfig——模块依赖 + 配置开关揭示「这个子系统如何被其他子系统使用」
- 找核心数据结构和主入口函数——
io_uring.c90KB 看着吓人,但核心就是 SQ/CQ 双 ring +io_uring_setup/io_uring_enter两个 syscall - 看「关键不变量」——io_uring 的不变量是「head < tail 永远成立」+ 「所有访问有屏障」。任何破坏不变量的代码都是 bug
这套方法论也适用于读 mm/ (页回收) / fs/ext4/ (文件系统) / kernel/sched/ (调度器) / net/ipv4/ (TCP) 等其他 Linux kernel 子系统。
八、写在最后#
io_uring 不是 Linux kernel 最大的子系统(那是 net/netfilter/ 或 fs/),但它是 Linux kernel 最重要的子系统之一——因为它重新定义了「程序如何和操作系统通信」这件事。
我把这次拆解的 3 个最深的收获总结给你:
- 「共享数据结构 + 跨边界」必须显式 contract——io_uring.c 头 30 行的屏障配对注释,是「认真做 sync code」的范本
- 「I/O ≠ syscall」 是 io_uring 的最大贡献——50 年 Unix 假设被打破
- 头注释比代码重要——任何复杂子系统的 contract 都在注释里,代码只是「按照 contract 实现」
io_uring 的代码会演进(Jens Axboe 每年都在优化),但**「头 30 行的同步契约」**永远不会过时——任何想重读 io_uring.c 的人,都应该先把这 30 行打印出来贴显示器上。
最后回答一个事实问题:Jens Axboe 是谁? 他是 Bloc IO 框架的主要维护者(fio / libaio / io_uring),在 Facebook/Meta 任职期间独立开发了 io_uring。Linux 5.1 (2019) 引入,5.6 (2020) 独立建顶层目录。截至 2026 年,io_uring 是 Linux 6.x 主线最活跃的子系统之一。
参考与引文#
本文涉及的所有引用都来自 torvalds/linux 主仓库的 io_uring/ 子系统(2026-09-30 通过 GitHub API 拉取),以下是我精读过的核心文件:
io_uring/io_uring.c(90KB / 3097+ 行)—— 核心 1:io_uring_setup()在第 3097 行 + 头 30 行跨用户态/内核态同步契约注释(整个 Linux kernel 历史上最精确的屏障配对注释)io_uring/Makefile—— 30+ 个 .o 文件的依赖结构io_uring/Kconfig——IO_URING/IO_URING_ZCRX/IO_URING_BPF/IO_URING_BPF_OPS等可选特性io_uring/sqpoll.c—— IORING_SETUP_SQPOLL 实现io_uring/io-wq.c(38KB) —— 异步 worker 池io_uring/kbuf.c/rsrc.c/filetable.c/tctx.c/register.c—— 资源管理io_uring/cancel.c/timeout.c/waitid.c/futex.c/epoll.c—— 取消/超时/等待io_uring/opdef.c—— 操作定义表(opcode → handler dispatch)
仓库地址:github.com/torvalds/linux/tree/master/io_uring ↗
作者:Jens Axboe(2019 引入),Linux 5.1 起主线上线,Linux 5.6 起独立 io_uring/ 顶层目录
关于配图:本文 4 张图(2 张静态 + 2 张动图) 都是用 matplotlib 重新画的——
img1-dual-ring-v2.png是 io_uring 双 ring 架构图(v2 版,5 步展开 + 4 对屏障配对),展示 SQ / CQ 用户态 + 内核态共享 mmap ring 的完整数据流img2-memory-barriers-v2.png是 io_uring 的内存屏障配对图(v2 版,时序图 + 屏障配对总览),展示「4 对 release-acquire + READ/WRITE_ONCE」的跨边界同步契约anim1-dual-ring-flow.gif是 6 帧动图,逐步展示完整流程(用户填 SQE → 内核 poll → 处理 → 用户消费 CQE)anim2-barriers-timeline.gif是 8 帧动图,逐步展示 4 对配对 + READ/WRITE_ONCE 二次保险原 kernel 主仓库的
Documentation/io_uring/下有大量官方文档(包括 HOWTO / design / syscall API),我没复用文档原图。重画 4 张是为了把「双 ring + mmap 共享」和「release-acquire 配对」这两个工程核心可视化讲清楚;动图是为了让时间序列 / 屏障配对顺序更直观(微信公众号对 GIF 不友好,公众号版用静态图;博客网站版用 GIF 动图)。