先说痛点:为什么「挑一个最好的固定协议」不行#
从数据中心扩展到跨区域部署,consensus 协议最大的成本是网络:一次 fast-path commit 在同一 DC 里是亚毫秒,跨大洲就要几十毫秒。所以大家一直在卷「能不能少 RTT」「能不能在更小的 quorum 里搞定」。
EPaxos 的解法是最被想出的:让每个 client 选最近的 acceptor 子集当 fast-quorum,再做 dep-check。问题是这个「最近的子集」在 N 个 replica、N 个 region 时有指数种组合,每个组合的延迟和可靠性都不一样 —— EPaxos 把这件事的优化权交给了运行时调参和经验值,没从机制上保证你选的子集在「快」的同时也能「安全 fallback」。
更糟的是,这种 fast-path 的安全性论证全靠反例 —— 这个提案在「fast path」上是 OK 的,前提是 fallback 路径能在某些条件被触发时恢复。一开始大家找的是「voter 数量 > f」这种 minority 不够格,后来 Paiya 团队的 Atum / DPaxos 等搞出更小的 quorum(f+1 就行),但每一份答案都要重新证明一遍「为什么 fallback 能恢复」。
KCensus 这篇论文的核心洞察是:这一切其实是一个「recovery 性质」的问题 —— 如果你能在 fast-path 之外给出一份不依赖经验值的必要性+充分性条件,然后把所有现有 fast-path 都表达成这个框架里的一张表(knowledge-requirement per proposer),那「挑最好的」就变成了一个组合搜索问题。
下面我们看看它具体怎么做。
核心命题:Recoverability(可恢复性)#
整篇论文最硬的部分就是这一节。我们先把这事讲清楚,后面所有 fast-path 的引入都会顺很多。
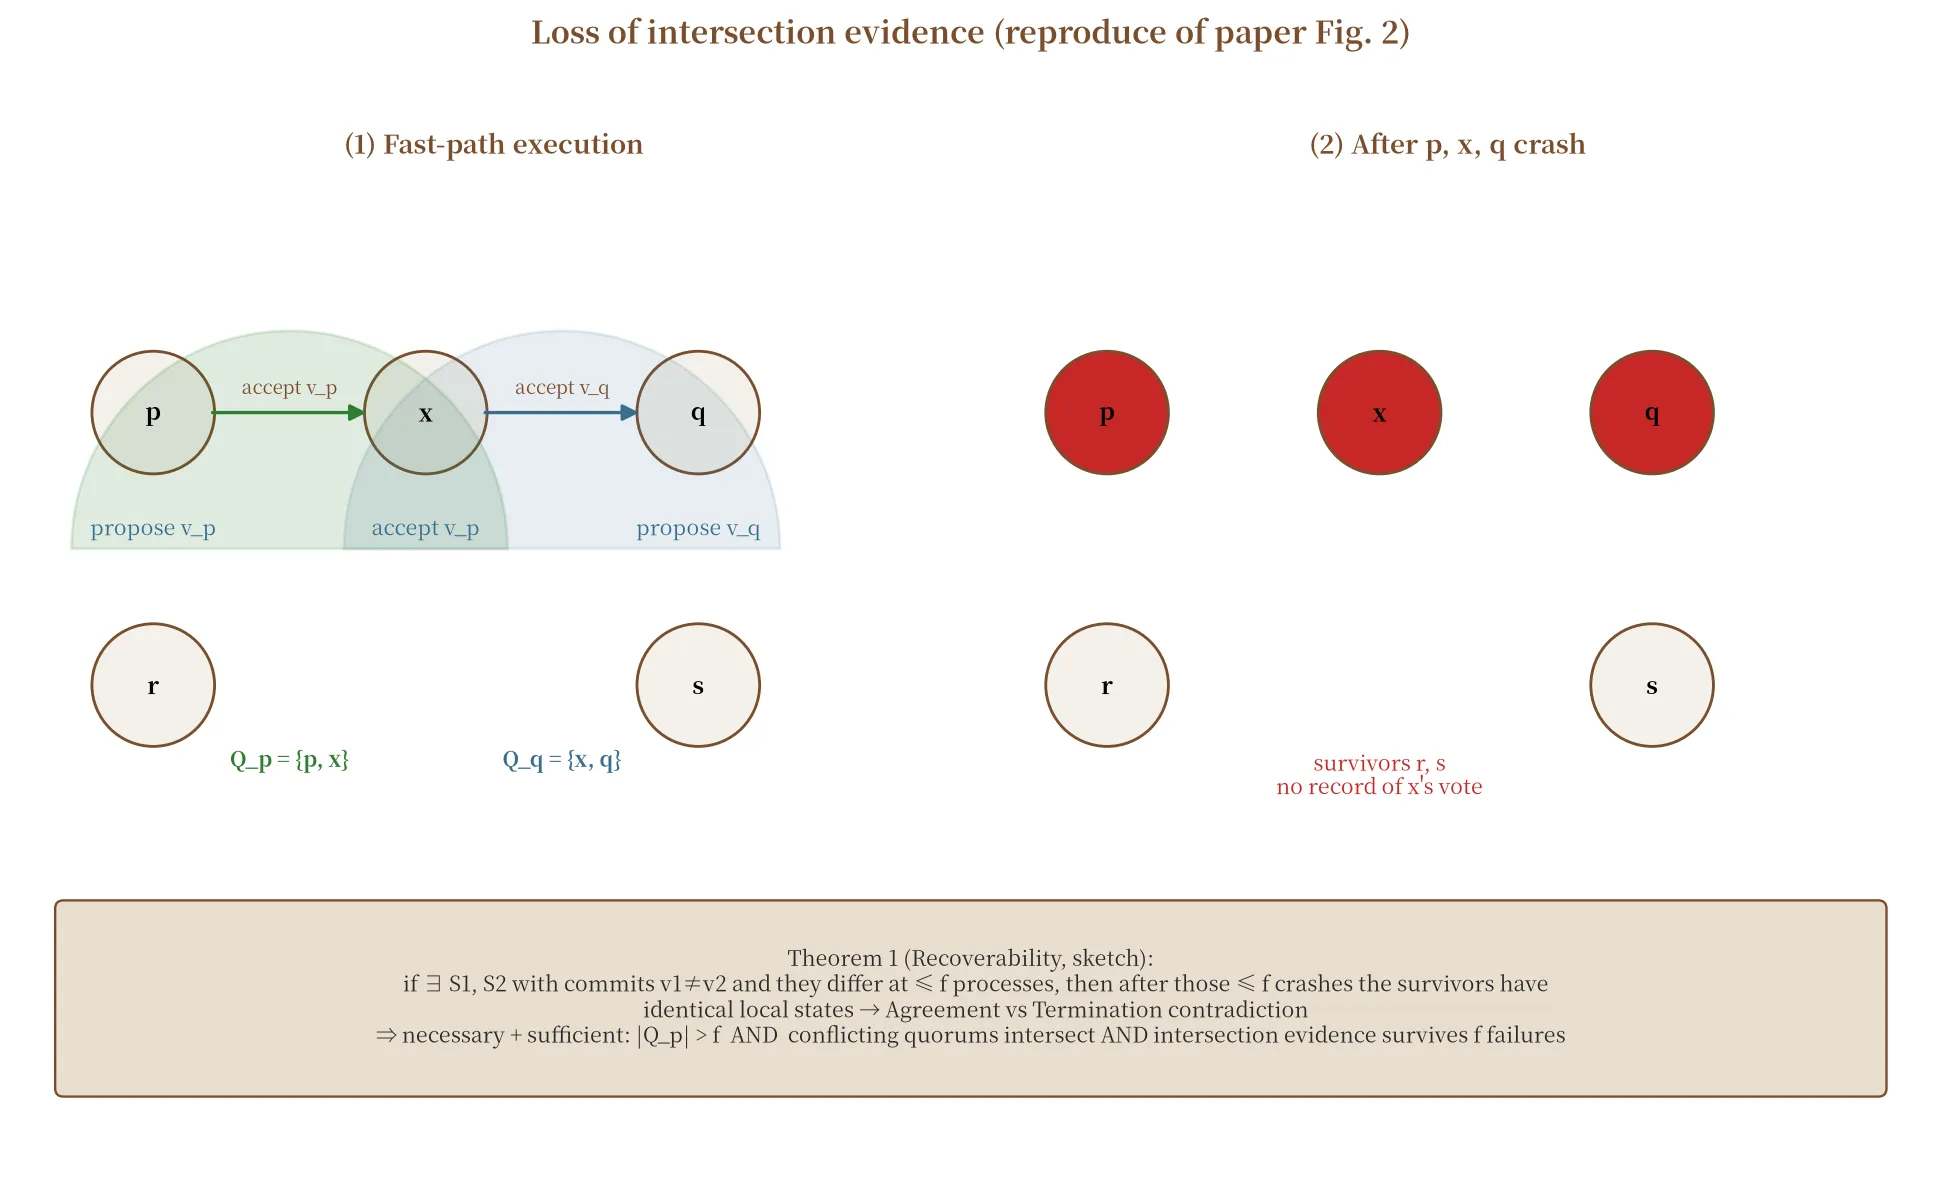
Recoverability 的定义(paper §3.1,Definition 2):一个状态 S₀ 叫可恢复的,如果对任意一对执行 S₁, S₂ 满足:
- 两个执行都从 S₀ 出发
- 两个执行最终都各自 commit 了一个值(可能是同一个,可能是不同的)
- 两个执行中间都不发生 f+1 次以上 crash
那么一定存在另一个执行 S₃,能从 S₀ 走到 S₁ / S₂ 任意一个最终状态。
用人话翻译:fast-path 不能让系统进到一个「fallback 路径再也救不回来」的角。
这条性质的关键洞察是:它独立于「fallback 协议具体是 Paxos / Raft / 还是别的」 —— 任何能维护「能从坏 state 救回来」的 fallback 协议,只要 fast-path 满足 recoverability,系统就是对的。
那 recoverability 的必要+充分条件是啥?paper 给了 Theorem 3):
任意两个会 commit 不同值的初始状态 S₁, S₂ 必须至少在 f+1 个进程上有所区分(local state 不同)。
证明是反证:如果两个状态在 ≤ f 个进程上不同,那 f 次 crash 一来,survivor 的 local state 完全一样,然后它们都还得各自 commit 不同的值 —— 但 survivor 看到的世界是一样的,这种区分就只能由 fallback 协议凭空造出来,而 consensus 协议又禁止凭空区分 → 矛盾。
这个必要+充分性给出了一个可验证的条件:你给我两个能 commit 不同值的 state,我去比它们的 local state 集合,只要交集 ≤ f,这个 fast-path 就是错的;反之 >= f+1,就是对的。
这就允许 KCensus 把 fast-path 的正确性问题转换成对 acceptor evidence 的结构问题:提交 p 的值,你需要从哪些 acceptor 那里收集到「我见过 p 的 acceptance」的证据。这就是下一节的 knowledge requirement。
把所有 fast-path 装进一张表:Knowledge Requirement R_p#
KCensus 的第二个关键抽象是:每个 proposer p 都有一个 knowledge requirement R_p —— 一个 dict<pid, set<pid>>,意思是「为了提交 p 的值,你需要收到哪些 process 对哪些 witness 的 accept 证据」。
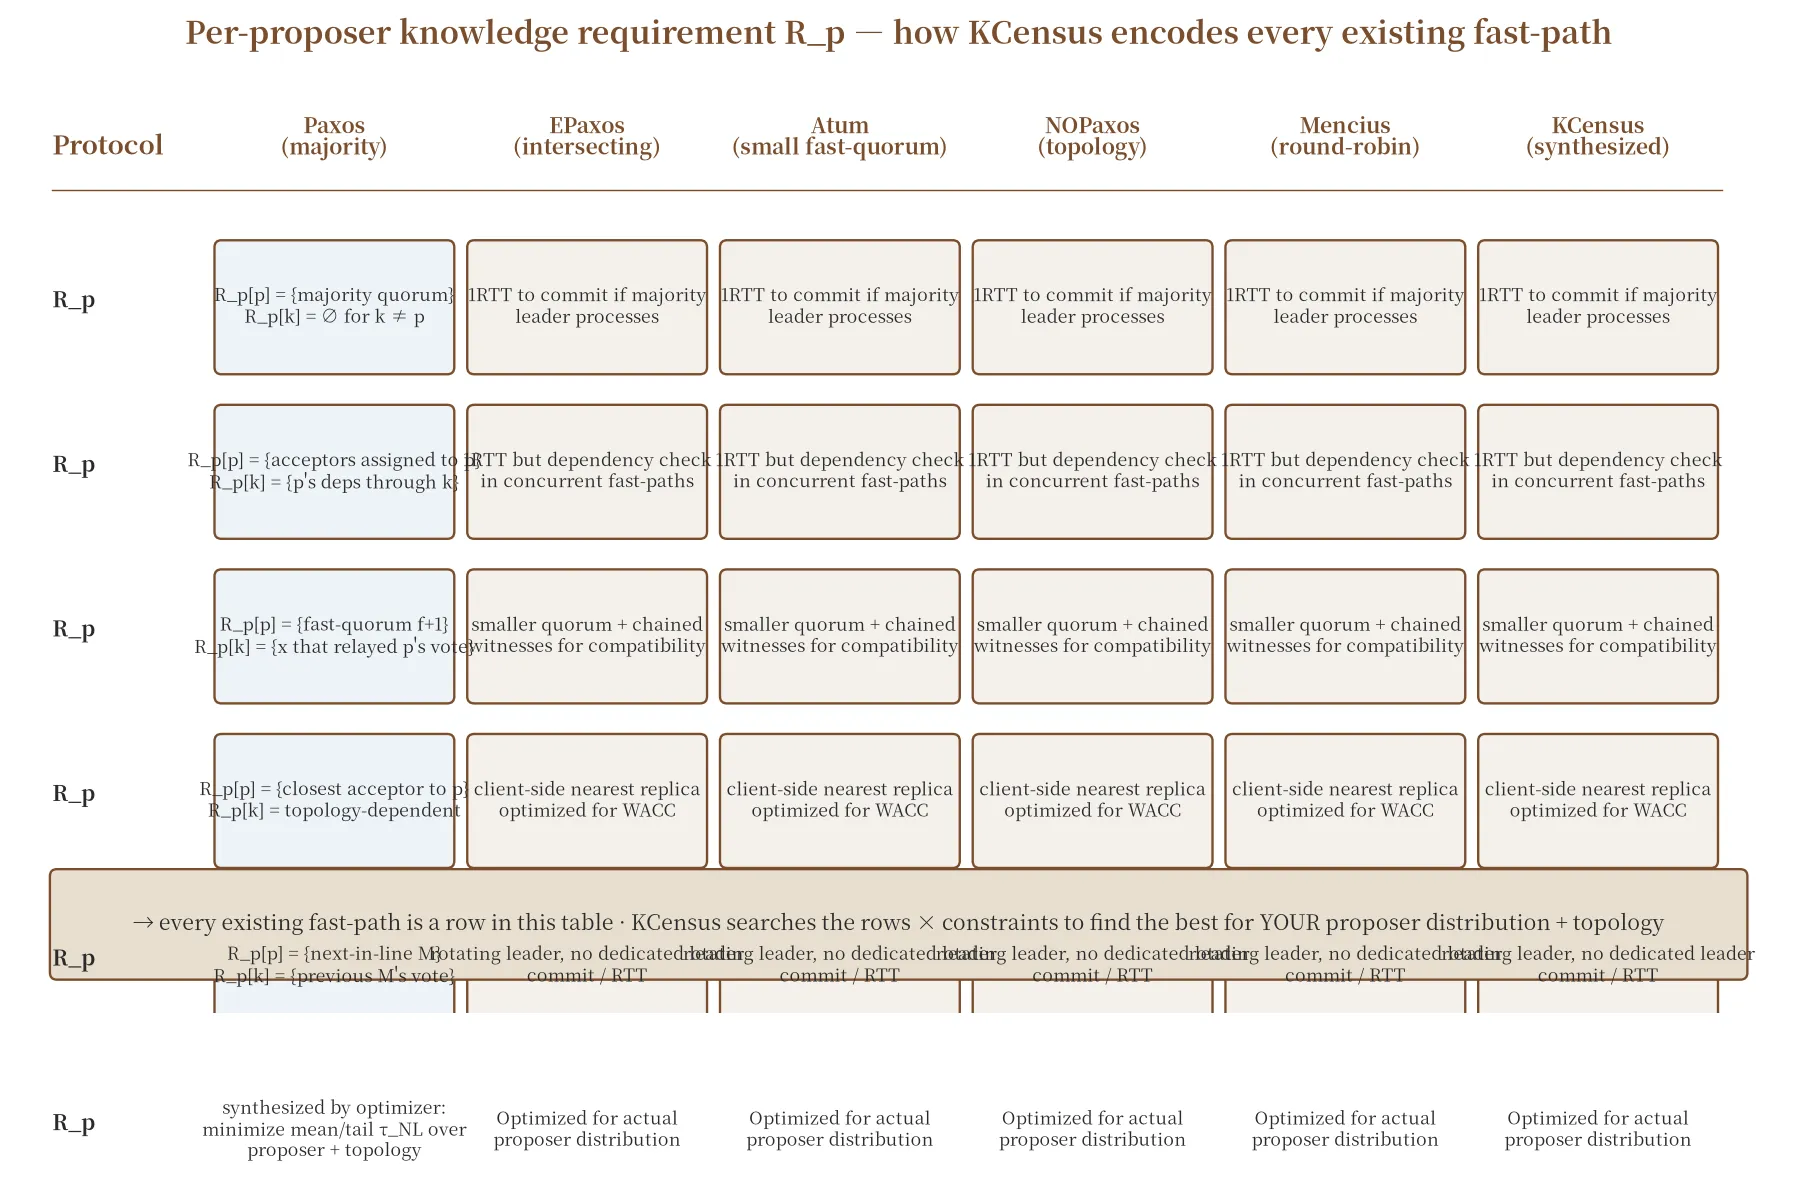
具体来说,如果是 Paxos,leader 的 R_p 就是 R_p[leader] = 一个固定的多数派 quorum;非 leader 角色的 R_p[k] = 空集。
如果是 EPaxos,R_p = {client 选中的 fast-quorum,还有所有跨 command 的依赖 acceptor 集合} —— 这个解空间非常大,EPaxos 没明示告诉你它选了哪个。
KCensus 不替你决定,它搜索 R_p 的空间:每个 R_p 满足 |R_p.keys()| > f(基本要求),任意两个 R_p 和 R_q 之间满足兼容性(compatibility)—— 这是下一节的关键 —— 然后在所有合法的 R_p 集合里挑一个对当前 proposer 分布最优的。
这种抽象的最大价值不是「找到更好的 fast-path」,而是把 recovery 性质 + 优化 装进同一个机制:你不再需要为每个新协议写一遍「为什么 fallback 能救」,只要 R_p 满足兼容性,你新协议的 safety 就自动继承了 recoverability 定理。
Compatibility:两个 proposer 怎么一起工作#
光有 R_p 没用,你还得证明任意两个 proposer 的 R_p 兼容。
Compatibility 的定义(paper §3.2,Definition 6):R_p 和 R_q 兼容,如果存在一个 witness 集合 W 满足:
- |W| > f(witness 不够,recovery 都不可能)
- 对每个 W 中的 witness w,要么 w 在 R_p[k] 中,要么 w 在 R_q[k’] 中(任何 witness 必须「在两边都被问到」)
用人话:当两个 proposer 都在跑 fast-path 时,要有 > f 个「共同认识的证人」见到对方 acceptor 的 acceptance。
这是为什么 EPaxos 的 dep-check 这么绕 —— 它本质上在构造 R_p 和 R_q 的兼容集,但这是运行时做的、有概率选不好,而且没法证明「所有兼容 probe 都正确」。
KCensus 把这件事变成了离线静态规划 —— 在合成阶段就穷举所有的兼容 R 组合,选最优的那一个部署到运行时。运行时的「fast-path」就是执行这个 R 计划的副本。
怎么跑起来:Algorithm 2-6 的拆解#
光有 R_p 是「policy」,运行时要把它演成「mechanism」。下面是 KCensus 的运行时算法框架(简化自 paper §4):
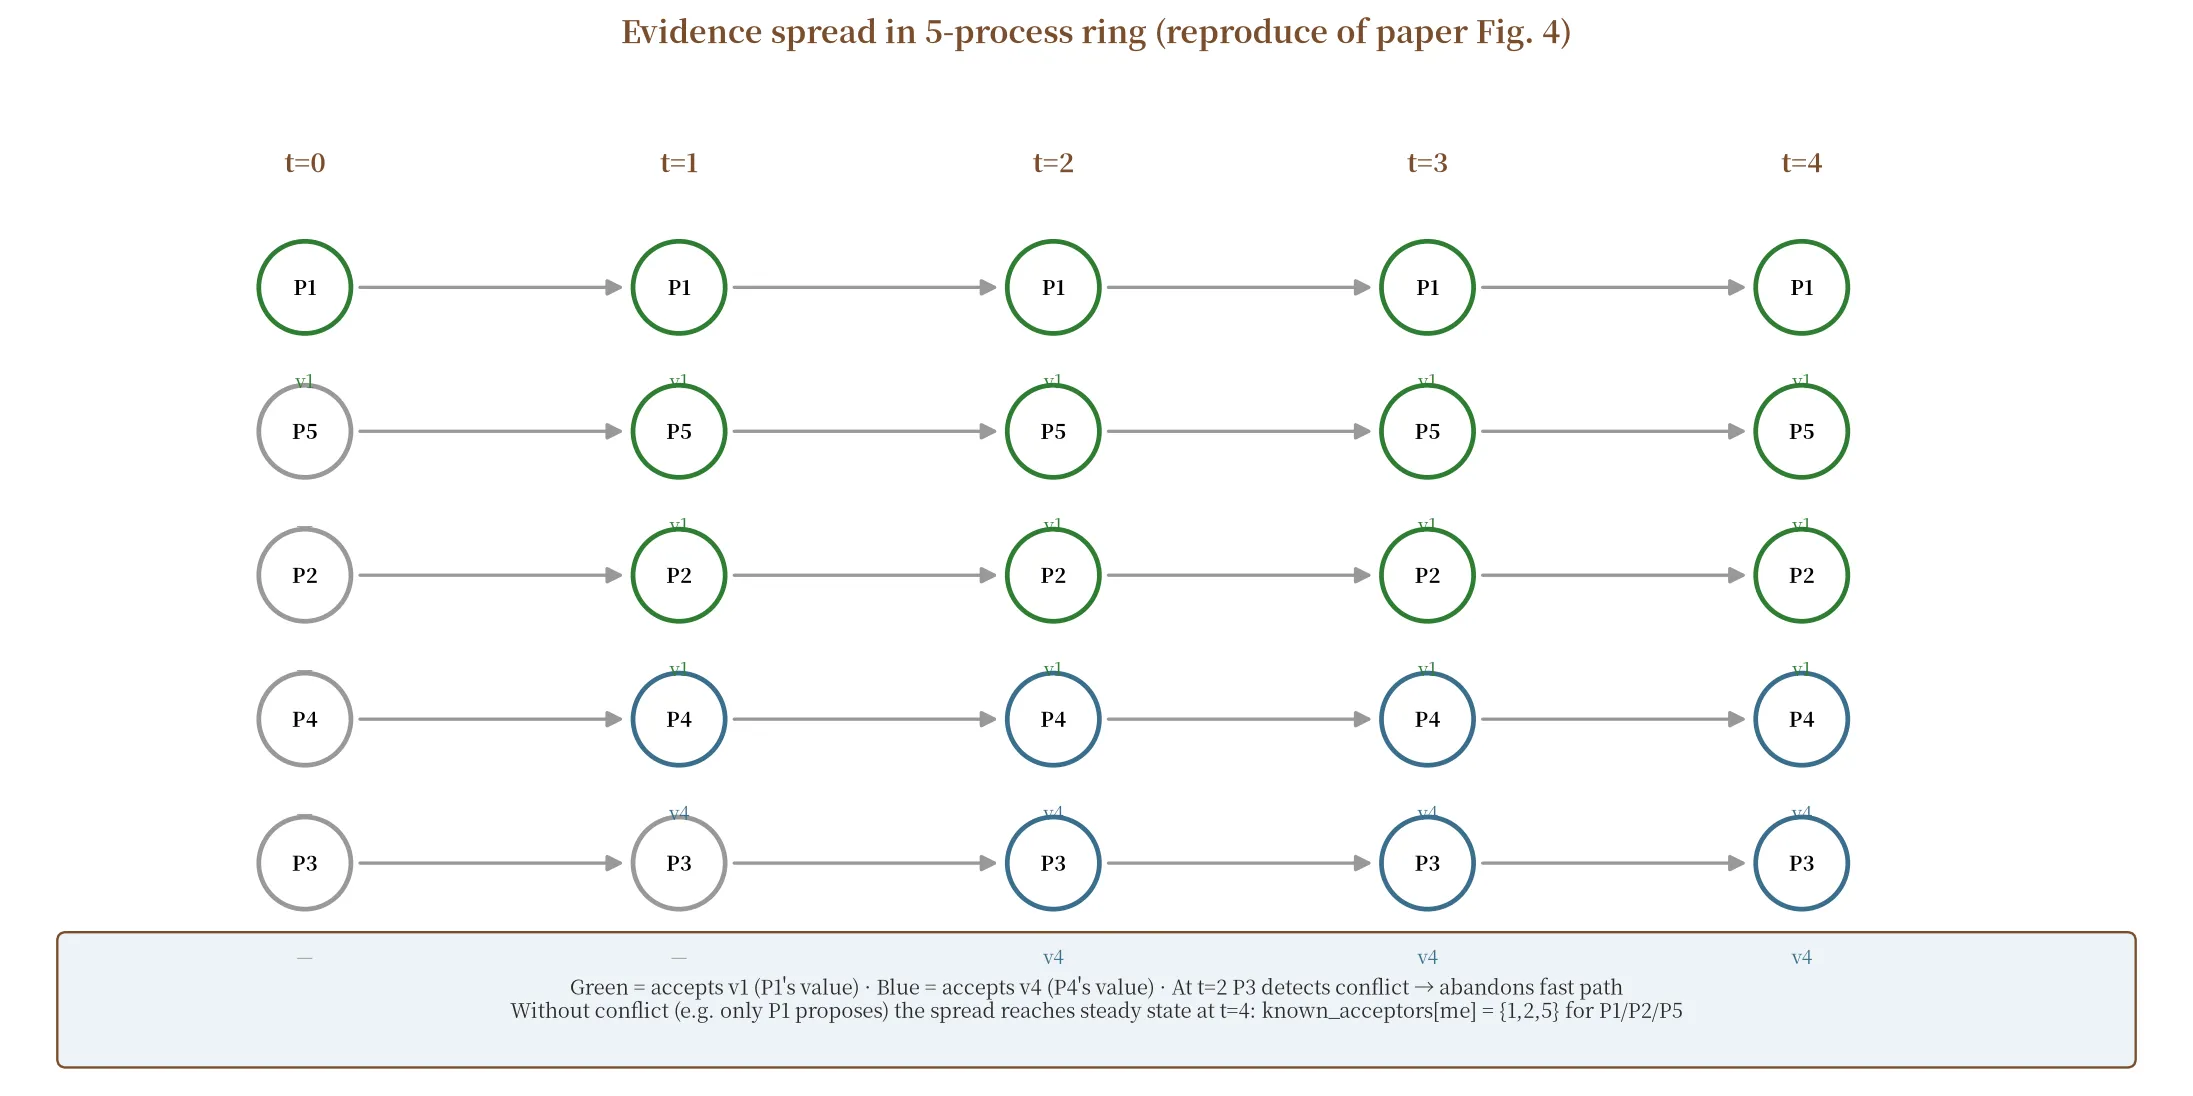
Algorithm 2 Propose(v, p) — 一个 proposer p 想提交 v 时:
- 自己先 accept,广播
Accept&Spread(v, R_p)(这条消息含 p 的 R_p 表 —— 谁需要看到谁的 acceptance 证据) - 听其它人的
Accept&Spread消息,更新自己的known_acceptors数组 —— this is the “Knowledge Census” 在累积 - 当
can_commit(v)返回 true(本地所有 R_p.keys() 里的 witness 都覆盖了),commit v,fast-path 完成 - 如果中间检测到 conflict(收到的 acceptance 跟自己的 R_p 不兼容)或 potential failure(
WeakFailureDetector::PotentialFailure(q)),DoAdopt()触发 recovery
Algorithm 4 can_commit(v) — 检查 commit 条件:
def can_commit(v):
    if accepted != v: return False  # 我自己都没接受
    for q in REQUIREMENTS[me].keys():  # 遍历 R_me 的所有 witness
        if REQUIREMENTS[me][q] ⊆ known_acceptors[q]:  # 我看到了所有要求 q 见证的 acceptance
            return True
return False这里的关键设计是 known_acceptors[q] 不止是 q 自己的 accept,还包含 q 转发给别人的 acceptance 报告 —— 也就是既算 1st order(自己接到的),也算 2nd order(别人接到的、转告 q 的)。这种「anyone who received a report from q knows q received acceptance」的处理方式就是 paper 第 4.2 节反复强调的「evidence has its origin at the witness」。
Algorithm 5 DoAdopt() — 冲突或潜在故障时:
- 给自己发
DoAdopt() - 广播
Freeze()给 n-f 个进程
为什么是 n-f?因为 recoverability 定理说了 R_p.keys() > f,所以 n-f 集合里一定有 R_p 每个 key 的一个 witness。
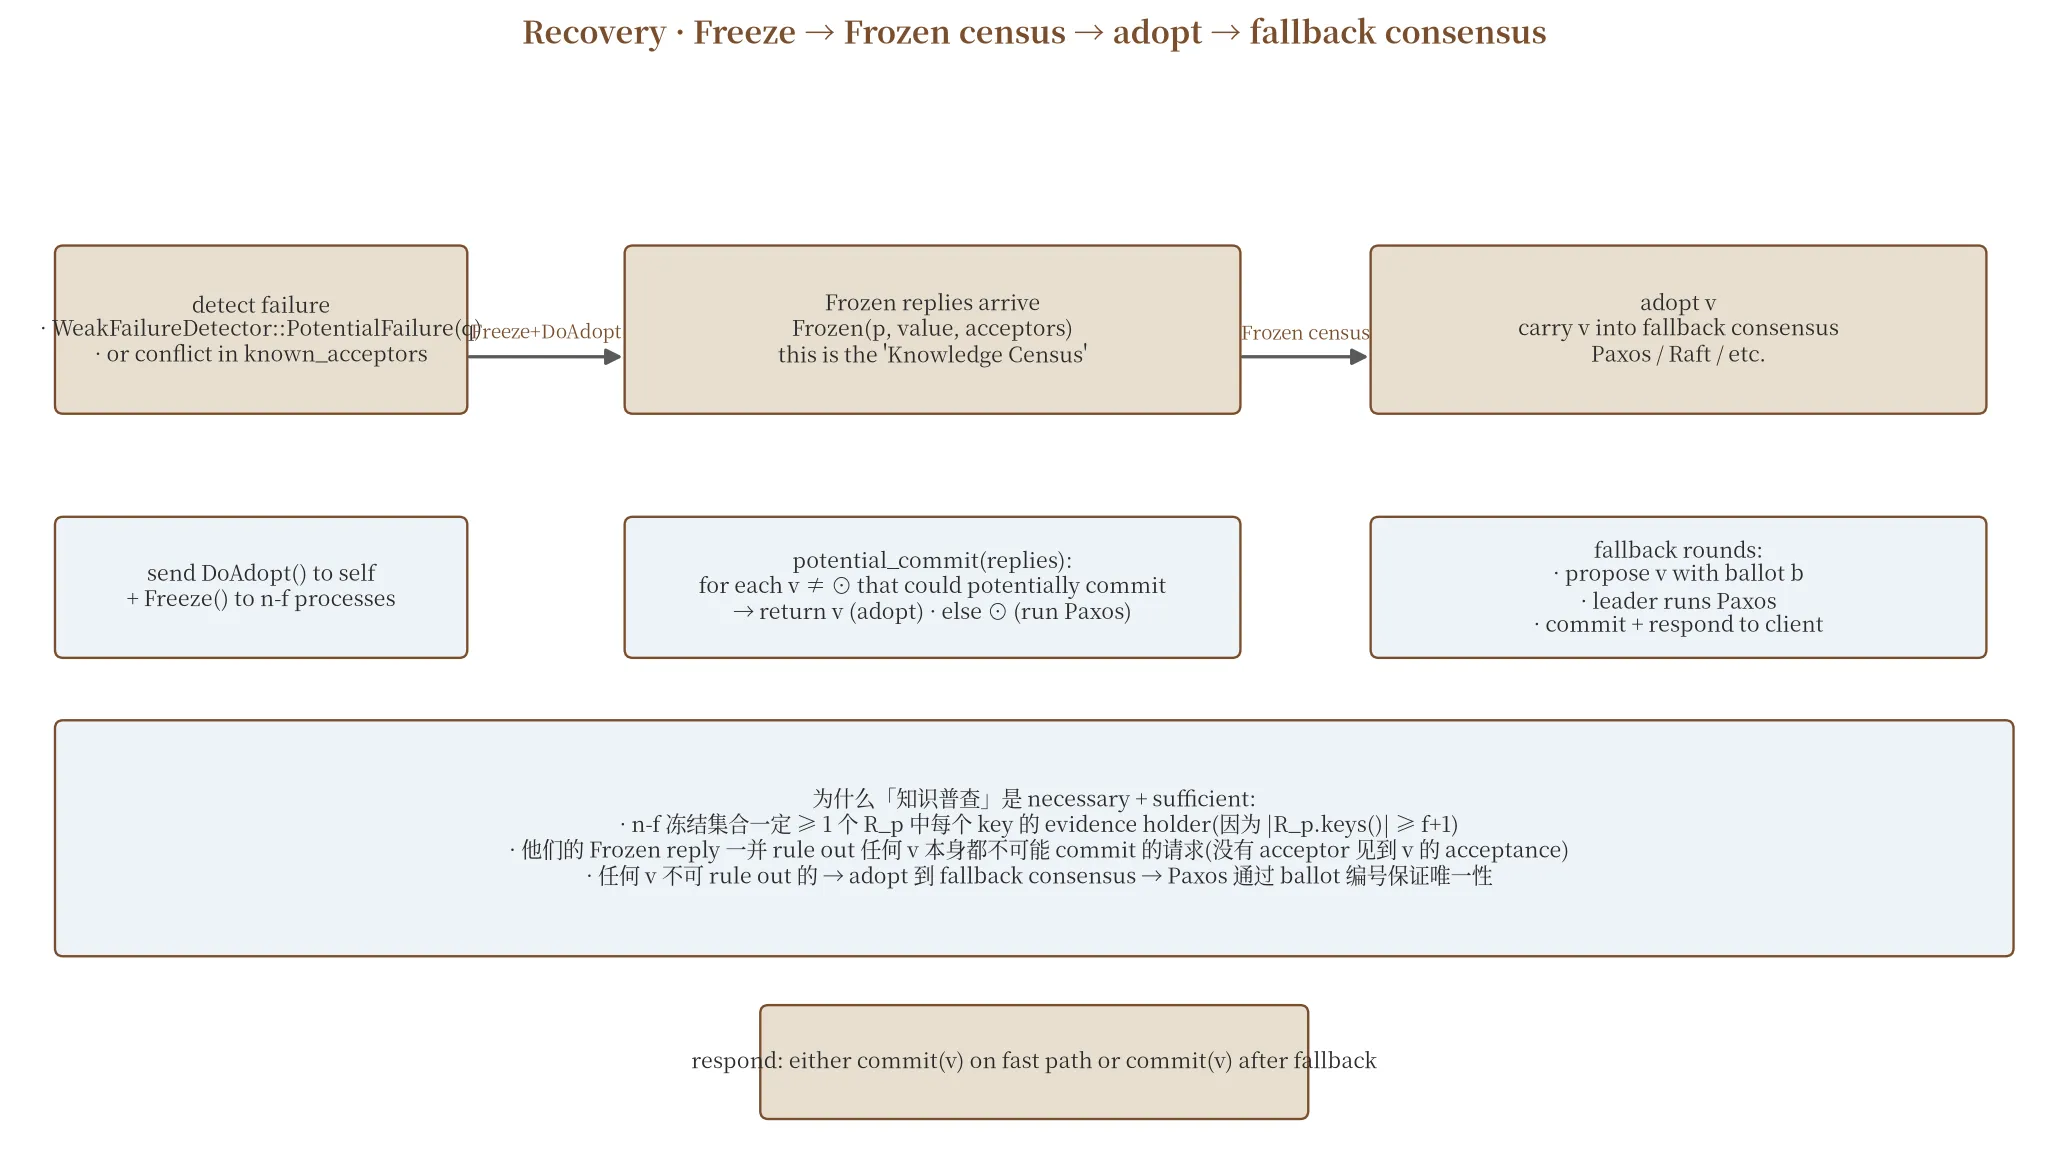
Algorithm 6 potential_commit(replies) — 收到 Frozen 集合后的 adoption:
for each v ≠ ⊥ in replies:
    req_v = REQUIREMENTS[v.proposer]
    for each Frozen(p, val ≠ v, acceptors) in replies:
        # 有 witness p 报告它见过 val ≠ v
        # 那么 R_v.keys() 必须有谁见过 v
        if ({p} ∪ acceptors) ∩ req_v.keys() == ∅:
            return False  # 不可能 commit v(p,rounds insufficient)
    for each Frozen(p, val == v, acceptors) in replies:
        # 有 witness p 报告它见过 v
        if p in req_v.keys() and req_v[p] ⊆ acceptors:  # p 没掌握足够信息
            return False
return True用人话:对每个候选值 v,扫一遍所有 Frozen reply否决它 —— 如果某个 Frozen reply 说「我见过 val ≠ v」而且那个 witness 不在 R_v.keys() 里(也就是没有 R_v 的 witness 见过 v),v 不可能 commit —— reject;如果某个 Frozen reply 是「我见过 v」但它掌握的 evidence 不够 R_v[p] 的要求,v 还是不能 commit —— reject。如果 v 没被任何 Frozen reply 否决,那 v 是唯一可能 commit 的值 —— adopt 到 fallback consensus(Paxos / Raft 都行)。
整个算法的优雅之处在 「Knowledge Census」这个命名:你 frost 一组进程,他们每个人的 Frozen reply 是一次「普查」,你从普查结果里反推出哪些值还能 commit、哪些值已经被否决。这就是为什么这个算法能用固定的 n-f 回退反推出唯一性,而不是要再跑一遍 Paxos 才能定。
优化器:怎么从所有合法 R 里挑最好的#
理论上的 R 是无穷多的(每个 proposer 都可以是「选谁当 witness」「每个 witness 要看到几个 acceptor 的 evidence」的任意组合),所以 paper §5 给了一个实用搜索:
搜索算法:随机起点 + 局部搜索(类模拟退火 flavor):
- 起点:所有 proposer 共享一个全局 quorum 的简单 plan(就是 Paxos baseline)
- 邻域:在 R_p 上做局部修改(把某个 witness 换成另一个、把某条 R_p[p] 加一个 acceptor)
- 接受:minimize mean commit latency E_p[commit_RTT(p)] 或 tail latency
- 终止:几轮没改进或超过时间预算
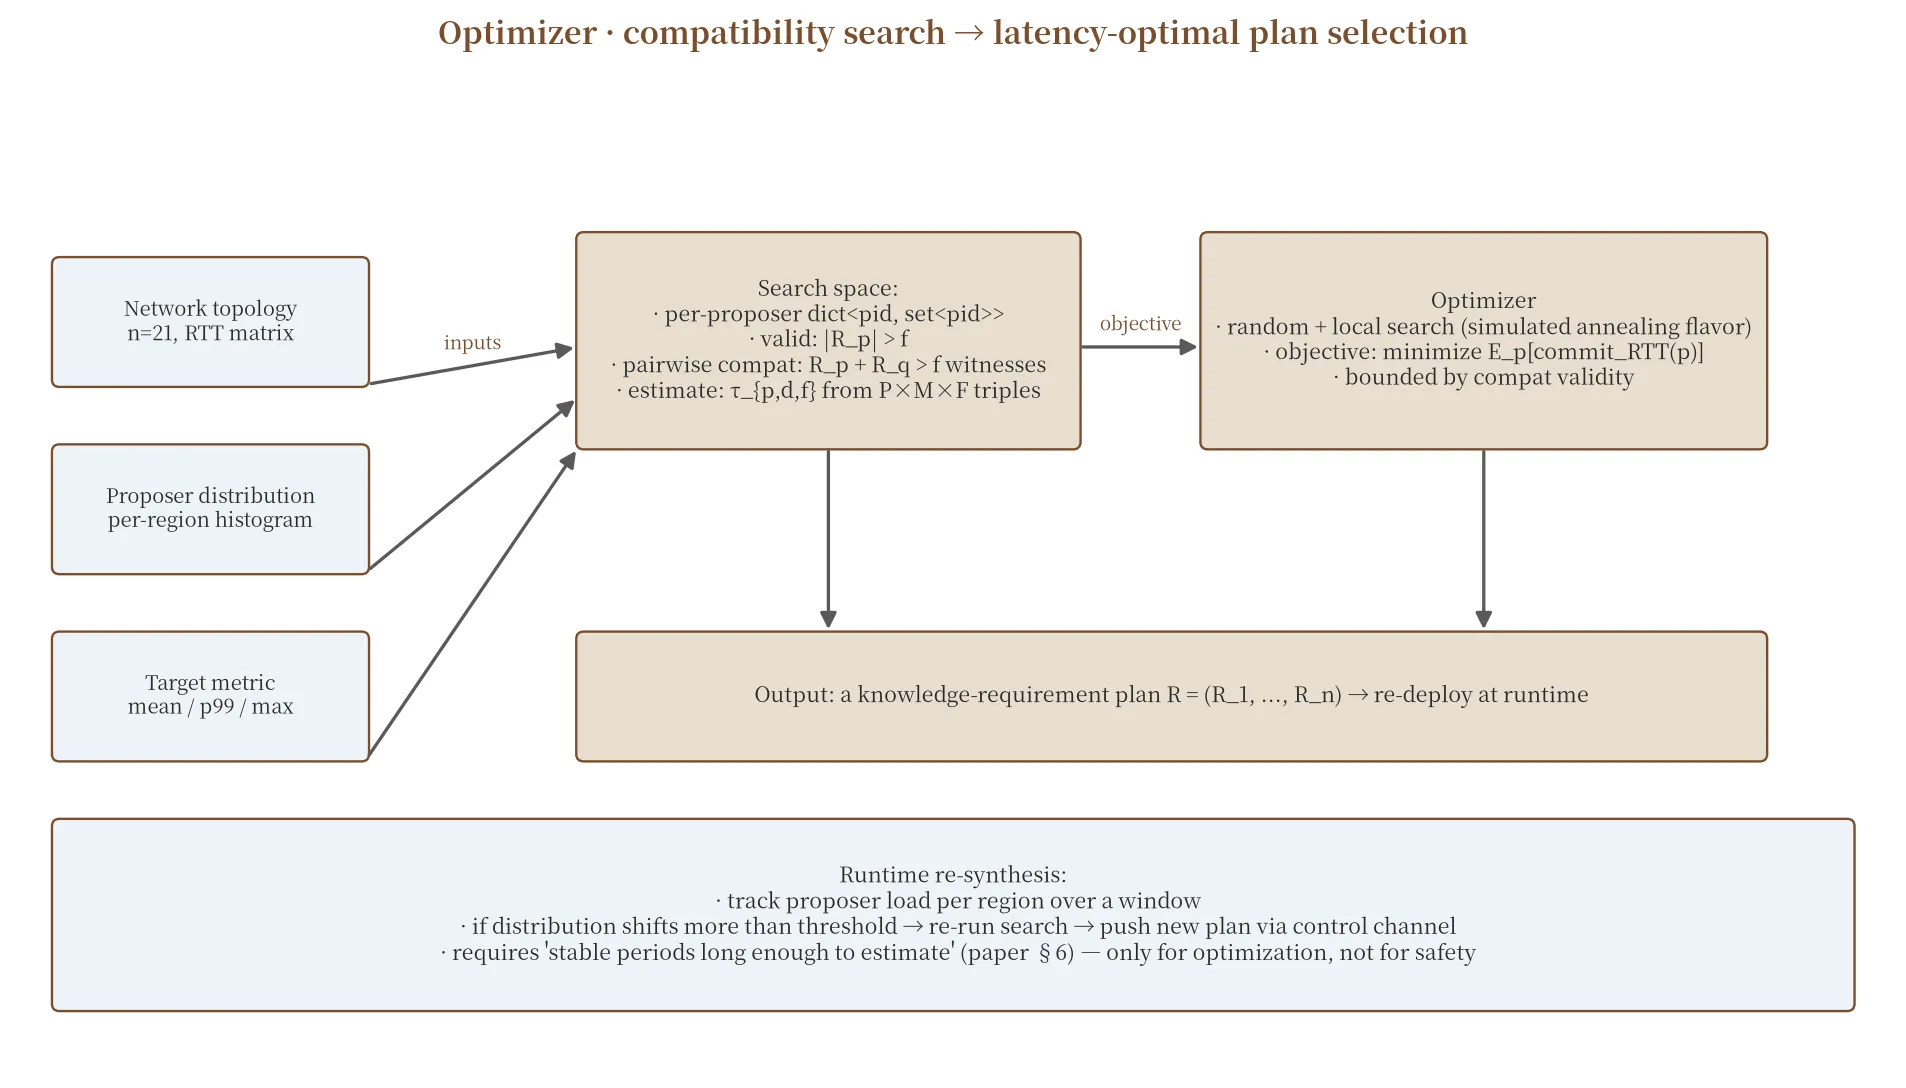
代码层面,优化器在 src/consensus/kcensus/propagation.rs 的 787 行 kcensus_plan() 函数。整个文件 59KB,除了优化器,还内置了所有 baseline protocol 的 plan 生成(paxos_plan、epaxos_plan、swift_paxos_plan、pando_plan、multi_paxos_plan) —— 这就是为什么 KCensus 能公平地跟这些 baseline 比较:所有 plan 都用同一套搜索框架生成,只是搜索空间不一样。
bin/graph_bench.rs 单独测搜索时间 —— paper Figure 12 显示 21 个 replica 时优化跑完只要 90 秒,29 个 5 分钟,在这个量级下,优化器可以部署前离线跑一次也可以运行时重新合成(paper §6 提到的「stable periods long enough to estimate」,这就是为什么它能给 SMR 部署做 re-synthesis 而不是 static compilation)。
评估:AWS 21 replicas,16% 平均延迟降低#
评估部分 paper §7 跑得很硬,不是 toy benchmark:
Testbed —— 全部 t3.medium(Intel Xeon Platinum 8000-series),resilience 2f+1 配置下 n=5,扩展性实验从 3 到 31 replicas,AWS 区域包括 EU(Paris)、NA(Ohio)、EA(Seoul)、NH(Cape Town)。
主结果 Figure 7(per-client latency):
- EA(Seoul,us-east-1,ca-central-1) —— 5 replicas 就有 best baseline 一致 latency;11+ replicas KCensus dominate baseline
- EU(Paris 主) —— 选最近 quorum 时 NH(Cape Town)区域特别省
- NH(Cape Town)最差位置 —— KCensus 比 best baseline 99th percentile 低 23%,这是 tail latency 上最猛的结果
Figure 9 (扩展性) —— 3 replicas 时 KCensus 跟 EPaxos 一致(quorum 选择有限);7 replicas 开始 KCensus 平均延迟比最快 baseline 低 8%,21 replicas 时 16%(SAP 这条线)。
Figure 8 (故障) —— 1 个 replica 持续失败时 KCensus 继续是最优,因为它对「worst-location client」特别照顾(EPaxos 没管这点)。
Figure 13 (conflict) —— 高冲突场景下 KCensus 会快速进 fallback,但因为 fallback 的 adopt() 是 Paxos,commit 时延跟 Paxos baseline 几乎一样 —— 这意味着 KCensus 在「应该放弃 fast-path」时确实就放弃了,而不是拖更长。
注意 KCensus 评估里的对照公平性:所有 baseline 也在 src/consensus/paxos_family.rs 实现,所有协议跑同一份代码 —— 不存在「EPaxos 的 C++ 实现比 KCensus 的 Rust 实现快」的 system-level 不公平。
18 GB 的真实 AWS 实验日志开源在 Zenodo(doi: 10.5281/zenodo.22914044),你可以 bash plot.sh 一键出所有 14 张 figure —— 这个 reproducibility 我之前没见过哪个 consensus 论文做到。
学习总结#
直接借鉴的设计(「如果我自己要做类似的东西,我会直接抄这几条」):
-
「per-proposer knowledge requirement」这层抽象 —— 把 fast-path 的 R 跟「fallback 能不能恢复」彻底解耦。这个抽象的最大好处不是「找到更好的 fast-path」,而是fast-path 不再是「pick one of the well-known protocols」,而是「在这张表上选一行」。这是思路层面的范式转移,值得所有 SMR 类项目(Cosmos SDK / Substrate / OpenSearch / Elasticsearch 的集群协调模块)参考。
-
Compatibility 在优化阶段而不是运行时做 —— EPaxos 的 dep-check 是个 runtime hot path,KCensus 把这件事移到离线搜索,运行时只负责执行。这不只是快一点 —— 它把「fast-path 的 safety 论证」从「运行时要 trace」变成了「搜索的合法性约束」。我做协议代码 review 时,这种「静态正确性」比「动态不变式」友好太多了。
-
「Knowledge Census」这个名字起得好 —— 你 frost 一组进程,他们的 Frozen reply 是一次「普查」,从普查反推可恢复状态。这个术语让 §4 的算法可读性比 Paxos/EPaxos 的伪代码高不少 —— 同样一个递归式 adoption,写成「scan frozen replies」比写成「check ballots」清晰得多。
我不会照抄的设计 / 保留意见:
-
运行时 re-synthesis 的实用性:paper §6 说「stable periods long enough to estimate latencies」是 re-synthesis 的前提 —— 实际生产里 proposer 分布滑动很快时(比如突发流量、滚动重启),这个估计本身就会跑偏,optimizer 会跟实际优化目标错位。我觉得工程上离线合成 + 人工评估切换比运行时 re-synthesis 更稳妥。
-
compatibility 检查是 O(n²) —— 21 replicas 还能 90 秒跑完,但 50+ replicas 时搜索空间爆炸。paper Figure 12 也承认这个 scalibility 跟「具体 search 策略」挂钩 —— 你真实做大规模 SMR 时可能要先 ILP 简化或者随机降维,不能直接拿来用。
-
recovery 路径的 fallback 假设:KCensus 假设 fallback 是 Paxos/Raft,这套假设在「fast-path 是带 NOPaxos 风格的极端优化」时不太成立 —— 如果你的 fast-path 太激进,fallback 可能要 N 轮才能 stabilize 一次 commit。
值得记住的 5 个具体知识点:
- Recoverability(可恢复性):fast-path 必须保证「任意能 commit 不同值的两个状态在 ≥ f+1 个进程上区分」
- Knowledge requirement per proposer:每个 proposer 一个 R_p = dict<pid, set
> 表达他要哪些 witness 的什么 acceptance - Compatibility:任意两个 proposer 的 R 必须有 > f 的共同 witness
- Freeze → Frozen census → adopt 的三段式 fallback
- 「Knowledge Census」术语:把 n-f 个进程的 Frozen reply 当作一次反推可恢复状态的普查
一个不确定的事:paper 没充分讨论在 0~2 replicas 持续失败但 fallback 也失败的极端场景下,KCensus 是不是「应该更早放弃 fast-path」。我没在代码里看到明显的 early-fallback 策略,可能这是个改进方向 —— 或者可能不值得,等真实线上 run 到 prod 数据再说。