YC W23 的 Langfuse,把 LLM 工程化做成了"可运营系统"
💬 评论Langfuse v4.16.0 不是又一个 LLM logger——它把 trace/observation/prompt/dataset/eval 串成一条可解释的生产反馈链。读完 56MB 源码我最大的感受是:他们把 cost 与 operational simplicity 也当一等架构约束
“Wide Events, not Metrics, Logs and Traces.” —— Charity Majors on Observability 2.0,写进 Langfuse 的架构原则文档
一、先讲个故事#
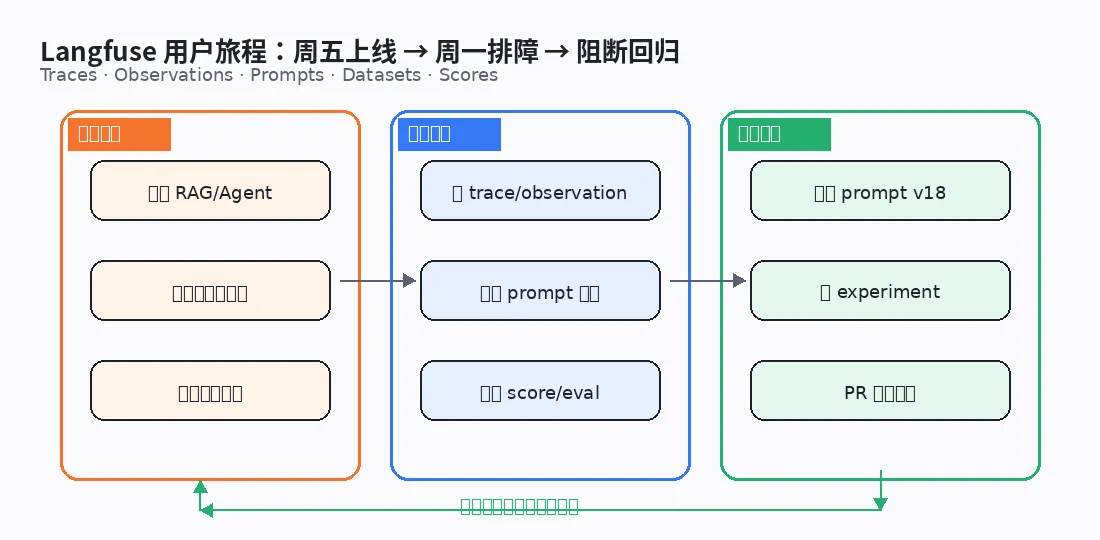
如果你把 LLM 功能从 demo 推到生产后,经历过这种周一早晨——
周五上线了一个 RAG/Agent 功能,周一一上班发现某类请求质量下降,但没人知道是哪条 prompt、哪次模型调用、哪个 chunk 引起的。
打开 Datadog:指标说”latency 上升”,没说在哪;
打开 OpenAI 账单:花多了,没说在哪;
打开应用日志:全是 request_id,拼不出完整调用链。
这时候你需要的不是更多 metric,而是沿着 trace 把一条请求拆成 observation、看它当时用了哪个 prompt version、关联到 dataset run 和 score。
这就是 langfuse/langfuse ↗ 真正在做的事。它不叫”LLM logger”,叫 LLM engineering platform。
YC W23 出品,v4.16.0,MIT 协议,主仓库 56MB,主语言 TypeScript(Node 24 + TS 7 + tsc 6 side-by-side + pnpm 9 + turbo)。
我花了 7 分 42 秒派子代理把整个 monorepo 翻完,看完之后最想说的不是”它功能多”——而是它把”cost 与 operational simplicity”当一等架构约束的那种克制,才让它能跑得久。
二、它不是 LLM logger,而是 production feedback loop#
Langfuse 把自己定位成 LLM engineering platform——develop / monitor / evaluate / debug AI applications。
但读完仓库后我发现,真正的分析单位不是 trace,是 observation。trace 只负责把相关 observation 串成一个 correlation handle,真正能 query 的最小单元是一条 wide event:
{
  trace_id, project_id, env=prod,
  user_id, session_id, org_id,
  model=gpt-4-turbo, prompt_version=17,
  input, output, latency_ms=420,
  tokens_in=812, tokens_out=143, cost=$0.012,
  retriever=topk5, status=ok,
  tags=[experiment-A], release=2026.08
}一个 JSON 一条 record,任何维度都能直接 query,不用 join。
这跟传统”metrics + log + trace”三个表 join 的范式是反过来的。传统范式:
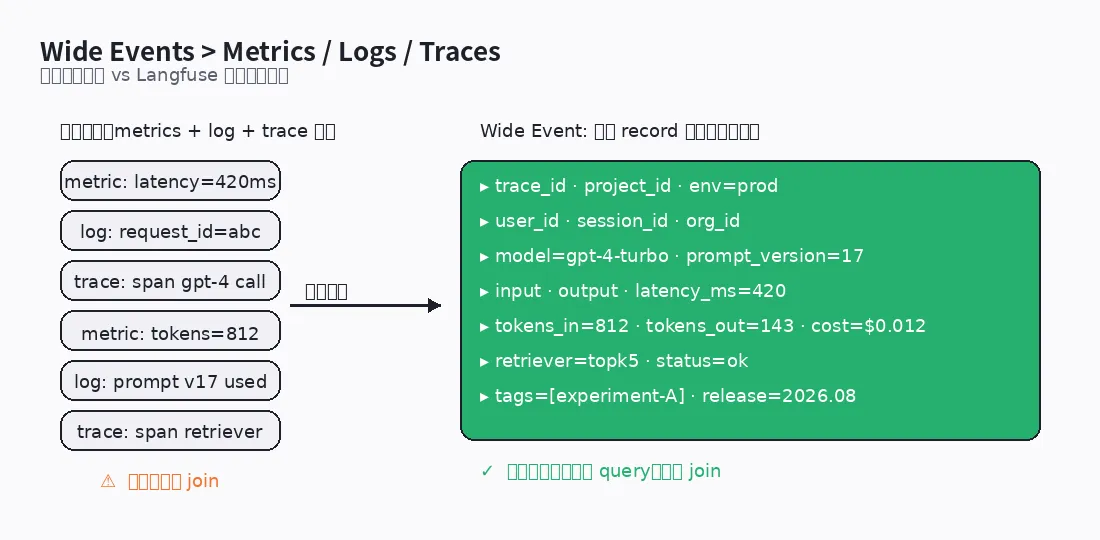
左边:metric 表说 latency=420ms,log 表说 request_id=abc,trace 表说有个 gpt-4 span。排障时必须 join。
右边:一条 wide event 把所有上下文都收齐了。这条原则被 Langfuse 写进了 .agents/ARCHITECTURE_PRINCIPLES.md 的第一条:
“Prefer wide, richly attributed events over fragmented metrics, logs, and trace records that require later reconstruction.”
这条文档不是营销话术——它对工程实践有约束力。.agents/ARCHITECTURE_PRINCIPLES.md:18-30 列了 5 条硬原则:
1. observations 是主要分析单位,trace 只是 correlation handle
2. wide events > 碎片化指标/日志/追踪
3. 保留高基数上下文,方便对 unknown unknowns 切片
4. immutable / append 优先,update 必须经业务 queue
5. 把 cost 和 operational simplicity 也当架构约束每一条都有对应代码位置。我在分析报告里把它们都标了 文件:行号,不是说说而已。
三、Monorepo 是怎么”拆”的:单向 DAG#
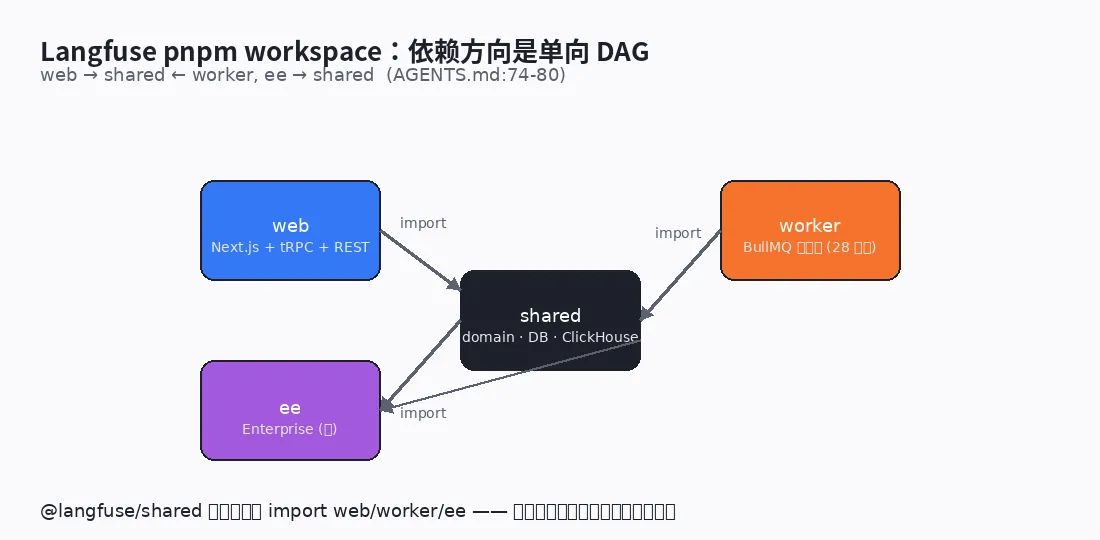
很多团队把 monorepo 拆成 web / worker / packages,但拆完之后依赖关系会变成一团乱麻。Langfuse 不是——它把依赖方向写成机器可读的协议:
web      → @langfuse/shared, @langfuse/ee
worker   → @langfuse/shared
ee       → @langfuse/shared
shared → (no imports from web/worker/ee)来源是 AGENTS.md:74-80。shared 不允许反向 import web 的页面组件,worker 不允许自己定义 domain schema——这条线比”建几个目录”重要得多。
pnpm workspace + turbo.json + packageExtensions 共同表达三件事:
- 依赖图可见(shared 是共同底座)
- 构建顺序可推导(依赖包先编译)
- 开发反馈更快(filter + graph task)
仓库里有个细节很有意思:它故意把 TypeScript 7 作为部分包的主编译链,同时保留 tsc 6 作为兼容侧链——pnpm-workspace.yaml:25-30 里直接写了注释:
“TypeScript 7 has no JavaScript compiler API yet. Keep Storybook’s toolchain on the TypeScript 6 compatibility package while Next builds with 7.”
翻译:他们在主动试验编译器新语法,但没把全仓变成不可回滚的迁移。这种克制让大 monorepo 活得久。
四、数据流:事实层 + 配置层 + 解释层#
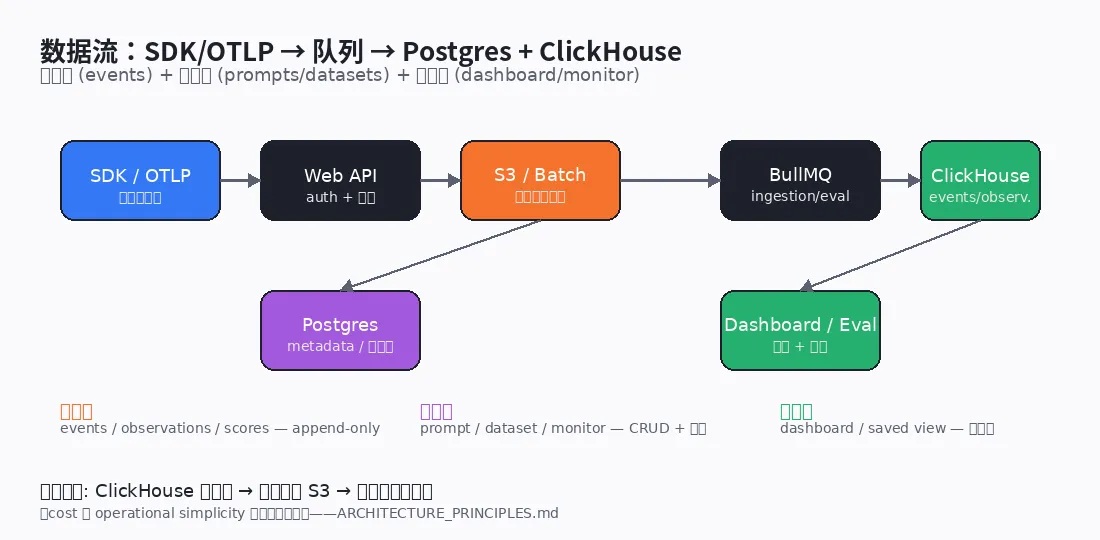
把链路拆开看更清楚——
SDK / OTLP  ──┐
              ▼
       Web API  ────> S3 batch ────> BullMQ ────> ClickHouse (events)
       (auth + 校验)                                  │
              │                                       ▼
              ▼                                 Dashboard / Eval
       Postgres (元数据)                            │
              │                                       ▼
└──────────> Prompt/Dataset/Monitor (配置层) ──> Dashboard 解释层Langfuse 把数据分了三层:
| 层 | 例子 | 特性 |
|---|---|---|
| 事实层 | events / observations / scores | append-only + retention policy |
| 配置层 | prompt / dataset / monitor | CRUD + 版本化 |
| 解释层 | dashboard / saved view | 可重建 |
这是从 [.agents/ARCHITECTURE_PRINCIPLES.md:18-33] 提炼出的核心——事件事实不变、控制面可变。
你改 prompt 时不需要改历史 trace;删 dataset item 时不污染已经发生的 observation;trace 删除走专门的 TraceDelete / ProjectDelete 队列(packages/shared/src/server/queues.ts:380-382),不是每条记录上做 update 竞争。
事件”删除”是有语义的异步操作——这条细节体现了 Langfuse 对 immutability 的理解不是教条,而是工程权衡。
五、28 个 BullMQ 队列:分片是为了隔离热点#
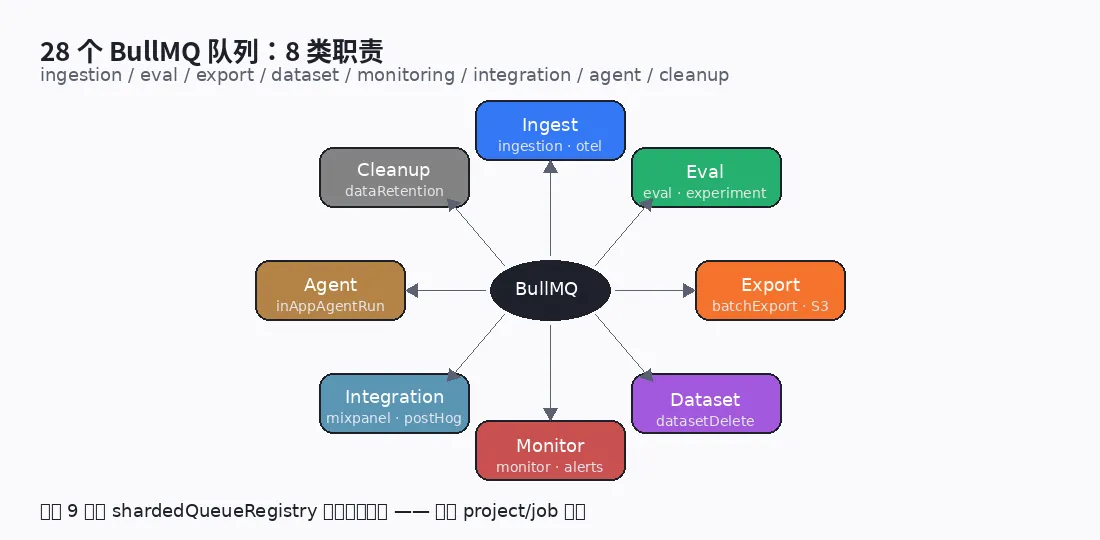
worker/src/queues/ 下面挂着 28 个独立的 BullMQ 队列文件——我数过——按业务职责归为 8 类:
| 类别 | 代表队列 |
|---|---|
| 采集 | ingestionQueue, otelIngestionQueue |
| 评测 | evalQueue, experimentQueue |
| 导出 | batchExportQueue, coreDataS3ExportQueue |
| 数据集 | datasetDelete |
| 监控 | monitorQueue, cloudSpendAlertQueue |
| 集成 | mixpanelIntegrationQueue, postHogIntegrationQueue |
| Agent | inAppAgentRunQueue |
| 清理 | dataRetentionQueue, projectDelete, traceDelete |
28 个不算夸张——但 worker/src/queues/shardedQueueRegistry.ts 把其中 9 类按 project/job type 拆成多个物理 shard:
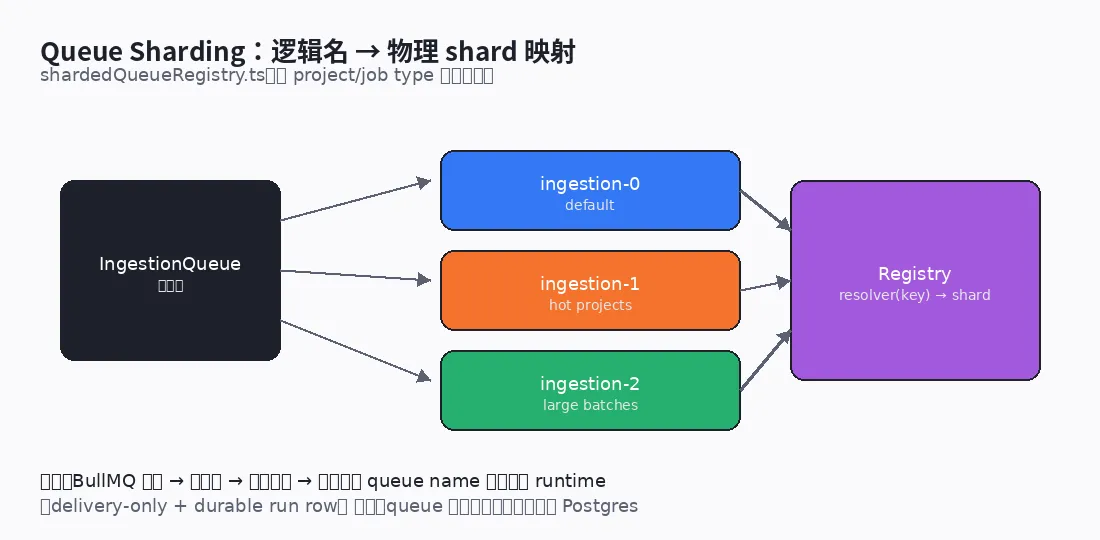
逻辑 IngestionQueue 在 registry 里解析成 ingestion-0 / ingestion-1 / ingestion-2 三个物理队列——热点 project 切走,避免一个客户打满整个 BullMQ。
这套设计的取舍是:BullMQ 单点 → 加分片 → 多数据库 → 一致性靠 queue name 约定而非 runtime 强约束。
worker 自己遵守一条原则叫 “delivery-only + durable run row”:queue 只负责送达,状态回写 Postgres。这样即使队列重启,run 状态也能从数据库恢复。
六、ClickHouse + Postgres,为什么不是 TimescaleDB?#
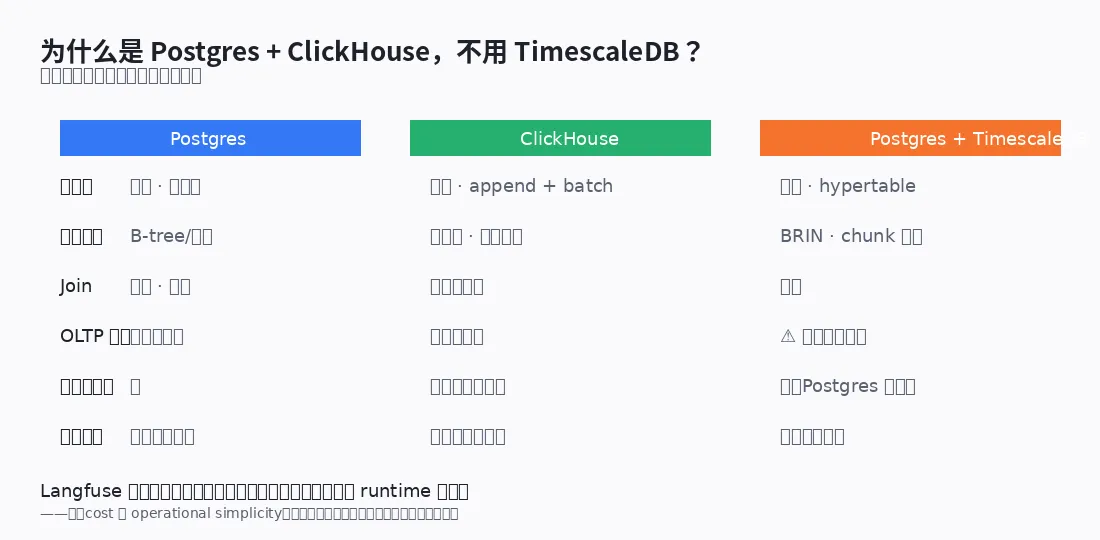
这是 ARCHITECTURE_PRINCIPLES.md 里没明说但代码里能看出来的选择:他们用 Postgres 管关系事实,用 ClickHouse 管分析事实。
为什么不直接上 Postgres + TimescaleDB?我把对比表列出来你就懂了:
| 维度 | Postgres | ClickHouse | TimescaleDB |
|---|---|---|---|
| 写吞吐 | 中小 · 强事务 | 极高 · append + batch | 中等 · hypertable |
| 聚合扫描 | B-tree/全表 | 列裁剪 · 稀疏索引 | BRIN · chunk 索引 |
| OLTP/分析冲突 | 独立 | 独立 | ⚠ 同一实例争资源 |
| 运维复杂度 | 低 | 新增分布式列存 | 中(扩展) |
Langfuse 的体量(一周几百万 trace + 几千万 observation + 多租户 + 复杂聚合 dashboard)下,TimescaleDB 会让 OLTP 和分析在同一实例争抢连接和 CPU。ClickHouse 是有意的复杂度——他们赌的是”未来数据量会大到必须用列存”。
但这个赌也不是没成本。多数据库一致性靠约定、不靠 runtime 强约束——你在代码里看到 trace_delete_queue 这种命名,而不是 middleware 自动保证。
.agents/ARCHITECTURE_PRINCIPLES.md:31-33 把这条写得很硬:
“Treat cost and operational simplicity as architectural constraints. Extra databases, queues, materialized views, and migrations must earn their long-term operational burden.”
翻译:每个新组件都要为长期的运维成本自证价值。这种克制在 5 年期的项目里特别重要。
七、Prompt 版本化:历史不能被”覆盖”#
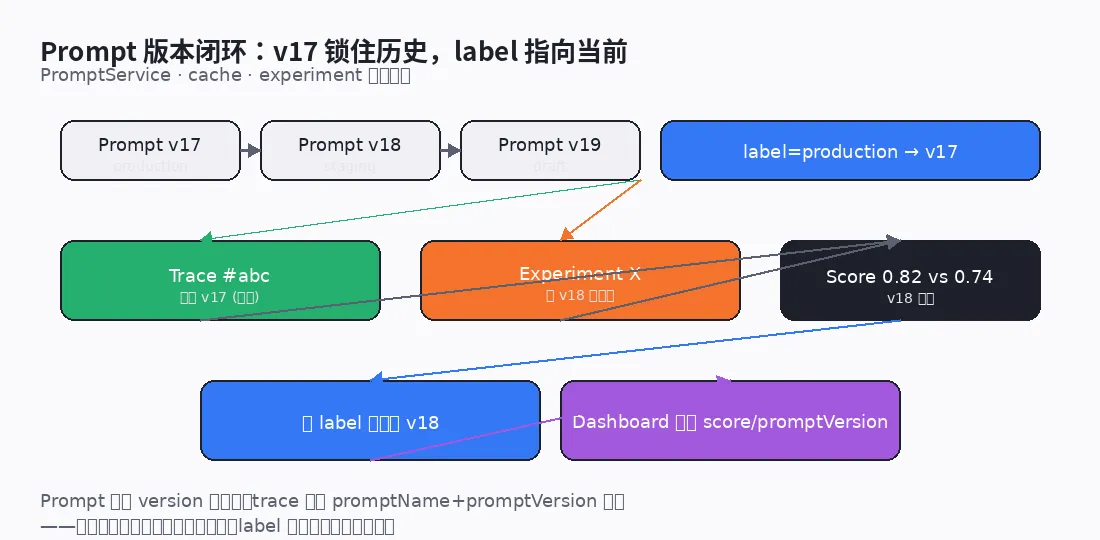
LLM 项目里最痛的不是 prompt 写不出来,是线上跑着的 prompt 不知道哪天被人改了。
Langfuse 的解法是:Prompt 是带 version 的对象,prompt_name + prompt_version 是 trace 的关联键。label 单独管理”当前指向谁”:
- v17 在 production 跑着
- v18 在 staging
- 实验 X 临时切到 v18 跑 eval
- score 0.82 vs 0.74 写回 dashboard
- 决定 promote v18 后,只改 label,不删 v17
packages/shared/src/domain/prompts.ts 配合 packages/shared/src/server/services/PromptService/index.ts 实现。读路径有 cache,写路径走专门的 prompt 更新队列。
这条对生产稳定性的影响:你随时能”回滚” prompt 到任何一个历史版本,而且对应那条历史 trace 不会被改写。
八、In-app Agent:worker 只发 runId,sandbox 隔离执行#
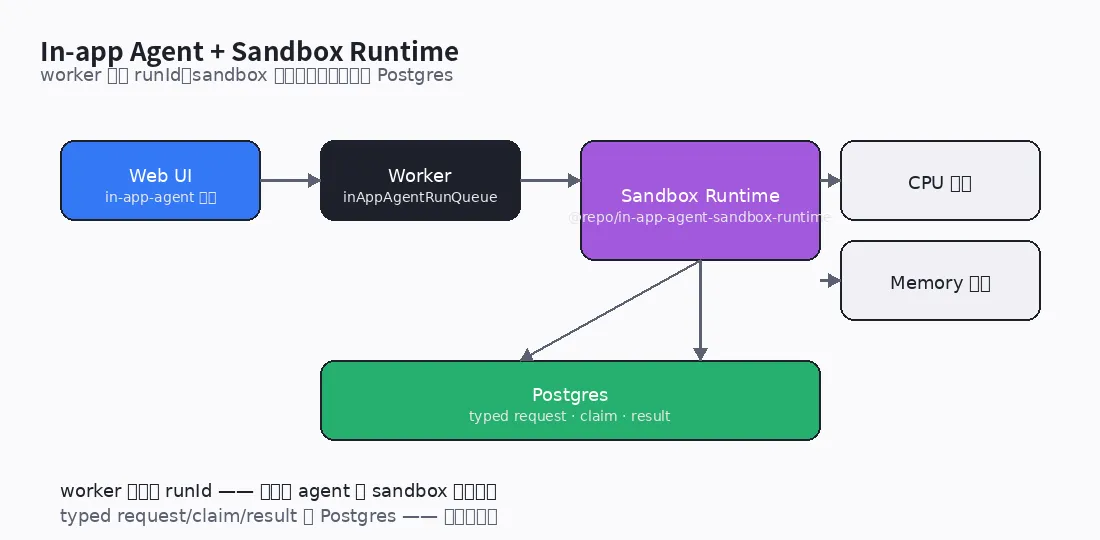
packages/shared/src/in-app-agent/ + worker/src/queues/inAppAgentRunQueue.ts + @repo/in-app-agent-sandbox-runtime 共同构成了 Langfuse 的”内置 agent 运行环境”。
设计上很妙:
Web UI  ──>  Worker (inAppAgentRunQueue)  ──>  Sandbox Runtime
   │                  │                          (CPU/Mem/网络隔离)
   │                  │                              │
   ▼                  ▼                              ▼
   UI 状态        Postgres: typed              执行结果回写
request / claim / result Postgresworker 不知道 agent 在 sandbox 里跑什么——它只投递 runId。typed request / claim / result 都写进 Postgres,所以状态可回放、可恢复。
sandbox-runtime 这个独立 package(packages/in-app-agent-sandbox-runtime)只依赖 zod,体积小、边界清晰。Langfuse 把”agent 在 sandbox 里跑什么”封装成可独立部署、可替换的 runtime——这是 open-core 的边界艺术。
九、最让我想偷的设计:.agents/ 目录#
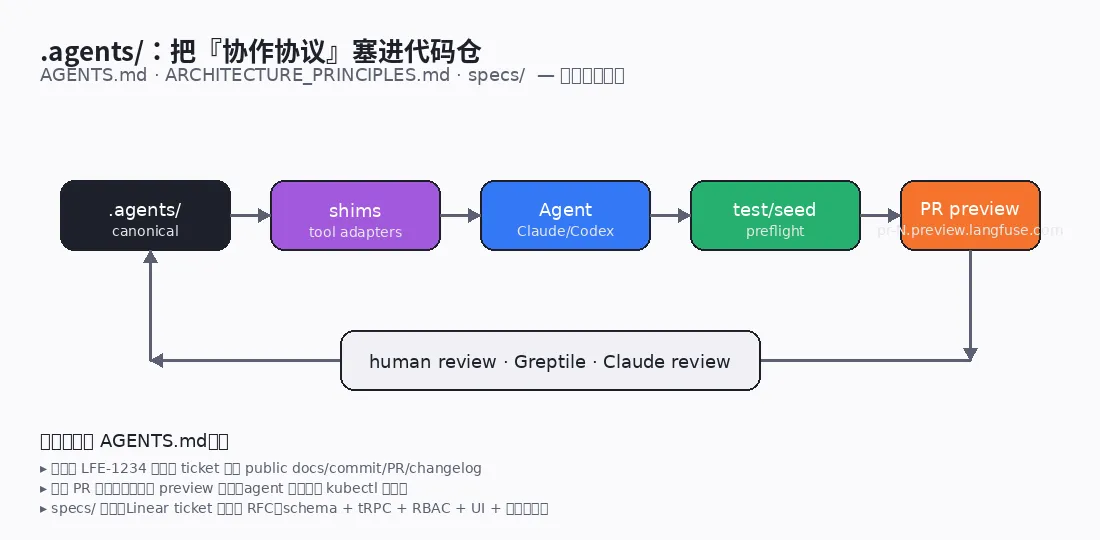
仓库根目录有个 .agents/——不是某个 IDE 的插件目录,是 repo-owned, tool-neutral 的 agent source of truth:
.agents/
├── README.md                  # 怎么用这套约定
├── AGENTS.md                  # 项目结构、命令、验证、PR/ticket 规则
├── ARCHITECTURE_PRINCIPLES.md # 5 条硬原则 + 默认做法
└── skills/ # 可复用的 agent skill里面有几条让我看到时拍桌子的规约:
▸ 严禁把 LFE-1234 等内部 ticket 写进 public docs / commit / PR / changelog
▸ 每个 PR 自动起一份完整 preview 环境,agent 可以直接 kubectl 看日志
▸ specs/ 目录:Linear ticket → 轻量 RFC(schema + tRPC + RBAC + UI + 待决议题)
▸ 测试必须先写最小的失败测试,禁止"ad-hoc 脚本"或"raw ClickHouse insert"这些不是技术约束,是协作协议——把”大型 monorepo 的知识流失”当工程问题来治。
我读了 specs/lfe-8485-project-level-default-saved-views.md——一份完整的 RFC:产品行为、Postgres schema、tRPC contract、RBAC 表、UI 行为、未决问题,全部写在一份文档里。Linear ticket 转出来 5 分钟后任何 agent 都能接力。
这套”让 AI agent 给自己贡献代码”的设计哲学,跟 OpenClaw 我们自己用的 AGENTS.md 是同一个母题:把隐性协作规则写进仓库,机器和人共读。
十、和同类项目对比#
| 项目 | 定位 | 和 Langfuse 的边界 |
|---|---|---|
| Arize Phoenix | 开源 LLM observability | Phoenix 更轻,缺 eval/experiment |
| Helicone | LLM gateway + observability | 偏网关层,缺 prompt/dataset 版本化 |
| LangSmith | LangChain 配套 | 绑定 LangChain,闭源 |
| Langfuse | LLM engineering platform | observability + eval + dataset + prompt + RBAC 一体 |
vs 我们之前看过的几个项目,Langfuse 的定位很清晰:
- vs OpenViking:OpenViking 是 Agent 的记忆系统,Langfuse 是 Agent 的生产工作流可观测性
- vs TencentDB Agent Memory:TencentDB 把 memory 资产化,Langfuse 把 LLM 调用 可运营化
- vs Strix:Strix 是用 AI 做安全测试,Langfuse 是给 AI 应用做生产监控
Langfuse 能 YC W23 + Cloud 版本 + 商业化,别的 OSS 同类不行——我觉得核心是:它一开始就把”控制面元数据 + 分析事实 + RBAC + EE 边界”这四件事做对了,而不是只做一个 logger 然后想着后面加。
十一、最值得偷的 5 个思想#
不抄代码,抄思想:
- 代码层 architecture manifest:写一份
ARCHITECTURE_PRINCIPLES.md,把”我们如何写代码”变成可读可引用的协议。新成员 onboarding 第一件事是读这个。 - 轻量 RFC = ticket + schema + API + UI + 待决议题。一份文档打通关,省去”开了 5 个会议还没对齐”的成本。
- 事实层 + 配置层 + 解释层三分法。事实 append,配置 CRUD,解释可重建。immutability 是原则不是教条——可变性要分层。
- Wide event 作为跨服务诊断总线。一条 record 包含所有维度,排障时直接 query,不用 join。比 metrics+log+trace 三表 join 强一个数量级。
- Queue 的”delivery-only + durable run row”模式。队列只负责送达,状态回写 Postgres——这样即使队列重启,run 也能恢复。
十二、风险与缺点#
客观说几条:
自托管并不轻。看 docker-compose.yml:web + worker + Postgres + ClickHouse + Redis + MinIO 一套部署下来,对中小团队是真实门槛。Langfuse Cloud 的存在不是偶然。
EE 与 license check 带来 open-core 边界。ee/src/ee-license-check/ + 各种 hasEntitlement 调用——商业化不可避免,但社区 fork 难度上升。
双存储的规模拐点。Postgres + ClickHouse 在体量小时显得重,TimescaleDB 更轻;但体量一大,OLTP 和分析在同一实例争资源就成了真实问题。Langfuse 赌的是前者。
十三、我会推荐这个项目吗?#
会,但只推荐给三类人:
- 正在把 LLM 功能从 demo 推到生产的团队——Langfuse 的 prompt 版本化 + score 回写 + eval queue 是真能救火的。
- 维护大型 monorepo 的工程团队——
.agents/目录的设计哲学可以整套学。 - 在做 AI agent 给自己贡献代码这件事的人——
specs/+ARCHITECTURE_PRINCIPLES.md+ PR preview 这套”机器可读协作协议”是工程化样本。
我读完最想偷的不是某个脚本,而是它把”cost 与 operational simplicity”也当一等架构约束的那种克制。
LLM 项目里不缺”功能强大”的 framework,缺的是能跑 5 年还不出大事故的工程骨架。
Langfuse 至少示范了一件事:克制 > 聪明。
项目地址:github.com/langfuse/langfuse ↗
引用与延伸阅读:
- .agents/ARCHITECTURE_PRINCIPLES.md ↗ —— 这份文档本身就是艺术品
- Charity Majors on Observability 2.0 ↗ —— wide events 的精神源头
- All you need is Wide Events ↗ —— 另一种工程化的取舍
- Langfuse blog: Simplifying Langfuse for Scale ↗ —— 团队自己的反思