深入解析 BerriAI/litellm:用一张 dispatch 字典撬动 100+ LLM 的工业级 AI Gateway#
一、写在前面:为什么我要拆 litellm#
6 万 star、Y Combinator W23、被 Stripe / Google ADK / OpenAI Agents SDK / Netflix 摆在官网首页的”OSS Adopters”上——这是 BerriAI/litellm 的牌面。
但我更想搞清楚的,是它为什么是这个样子。
我之前拆过的项目(HyperFrames、God’s Eye View、MathModelAgent、pi agent harness)各有各的爽点:HyperFrames 的”原子截帧”很黑客、God’s Eye View 的”产品决策日志”很工程师、pi 的”TypeScript 扩展取代 MCP”很激进、MathModelAgent 的”SKILL 教材”很轻巧。
litellm 不一样。它做的是一件很脏、很重、很容易写崩的事:把 100+ 个 LLM provider 的请求/响应格式、流式行为、auth 模式、cost 公式、报错码、streaming 协议统一成一个 OpenAI 兼容的入口。
你随便想想:OpenAI 用 /v1/chat/completions + SSE 增量;Anthropic 用 /v1/messages + 自己的 event types;Bedrock 有 Converse 和 Invoke 两条路(后者还得塞 base64);Vertex 走 Gemini 和 Claude 两种 partner model;Gemini 自己又分 vertex 和 ai studio;Azure 的 O-series 要单独走 O1Config;Ollama 是本地;vLLM 走 OpenAI 兼容但 base 不一样;HuggingFace 走 inference endpoint 还是 text-generation-inference 又是两套;AWS SageMaker 是 hosted endpoint;Replicate 是按秒计费的异步 poll——
光把这些 provider 接到一个 Python 函数上,代码量就已经是个天文数字。这还没算 router 策略、cost 追踪、proxy auth、caching、guardrails、admin dashboard、mcp 集成这些”上面搭的层”。
所以我这次拆解的核心问题不是”它有多少行代码”(很多,光 litellm/main.py 就 9522 行),而是:
- 它怎么把”加 provider”的成本压到 ~50 行? 这是工程上最难的问题
- Rust 重写到底换了什么? 不是性能噱头吗?
- Router 凭什么支持 15 种策略? 是堆功能还是有内在架构?
- Cost 记账为什么是它的护城河? 这个最反直觉
下面我分 5 个模块讲,每节都先放我从代码里抠出来的真实链路图,再展开讲。
本文所有图都是原创,路径和文件来自我下载的 2026-10-10 拉取的
BerriAI/litellm@main(commit 信息见文末)。
二、Python SDK 入口:acompletion() 怎么把 100+ provider 收口到一个函数#
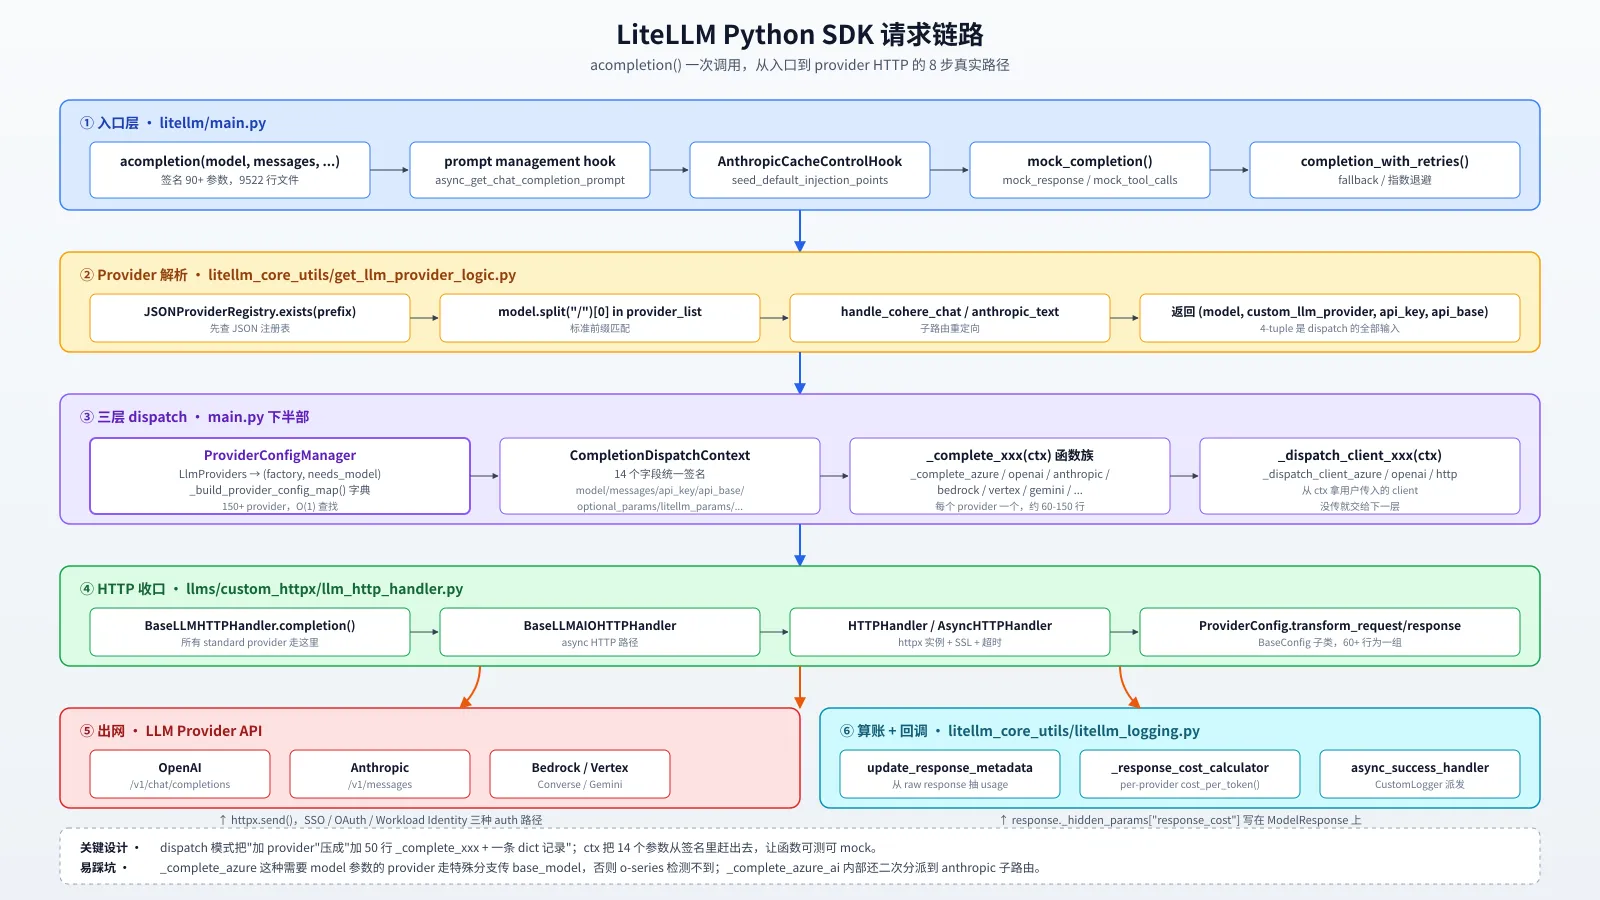
我第一次打开 litellm/main.py 的时候是有点懵的——一个 9522 行的文件,入口函数 acompletion 的签名竟然有 90+ 个参数。但读下去才发现,这 90+ 个参数背后是一套非常工整的”三段 dispatch”设计。
下图是我从代码里抠出来的真实链路:
2.1 入口层:90+ 参数的真相#
acompletion() 这个函数,本质是 4 个步骤的串联:
- prompt management hook:
async_get_chat_completion_prompt把用户传的prompt_id/prompt_label/prompt_version解析成实际的 messages - AnthropicCacheControlHook.maybe_seed_default_injection_points:自动给 Anthropic 调用加上
cache_control注入点(这个钩子特别细节——它会扫描 messages 找最长的 system 块加 ephemeral 标记) - mock_completion / mock_timeout:测试和调试用,不走真 provider
- completion_with_retries:最后真正的派发,带 fallback 链
90+ 个参数里有 50+ 都是 **kwargs 透传,最终被 _dispatch_metadata / _dispatch_client_http 这种辅助函数按字段提取。这种”宽进宽出”的 API 看似丑陋,但实际是让上层 LangChain / LlamaIndex / DSPy 能零成本接入——它们随便传什么 litellm 都接住。
2.2 Provider 解析:4 段逻辑的”链式解析”#
get_llm_provider() 在 litellm_core_utils/get_llm_provider_logic.py 文件里,不在 utils.py——这点是 v1.x 重构后的结果,原因是这个函数调用频次太高,要单独做 lazy import 避免循环依赖。
解析的顺序是这样(这块我反复读了三遍才确认顺序):
- JSONProviderRegistry.exists(prefix):先看
JSONProviderRegistry里有没有用户自定义的 provider(这是个 JSON 配置文件) model.split("/")[0] in litellm.provider_list:标准的”前缀匹配”模式,比如openai/gpt-4o→ 拆成openai+gpt-4o- 子路由重定向:
handle_cohere_chat_model_custom_llm_provider这种特殊处理,比如用户传cohere/command-r-plus但实际要走 cohere_chat 而不是 cohere - 返回 4-tuple:
(model, custom_llm_provider, dynamic_api_key, api_base)
第 3 步特别容易被忽略——它是 litellm 的”历史包袱吸收层”。比如 azure/command-r-plus 这种 Azure AI Studio 上的 Cohere 模型,要重定向到 cohere_chat;anthropic/claude-3 走 anthropic 而 anthropic_text/claude-2 走 text completion 协议。
2.3 三层 dispatch:教科书级的”加 provider”成本#
这一节是整篇文章我最想讲的部分。
litellm 的 dispatch 用了三层抽象,对应三个文件:
| 层 | 在哪 | 干什么 |
|---|---|---|
| 字典 | litellm/utils.py 的 ProviderConfigManager | LlmProviders → (factory, needs_model) 的 O(1) 查表 |
| 上下文 | litellm/types/completion.py 的 CompletionDispatchContext | 14 字段统一签名 |
| 函数 | litellm/main.py 的 _complete_xxx(ctx) | 每个 provider 一个独立函数 |
关键设计:150+ provider 全部走同一个 dict 注册,新增 provider 的成本是”加 50 行 _complete_xxx 函数 + 一行 dict 记录”。这是教科书级的”开放-封闭原则”实现——对扩展开放(加 provider),对修改封闭(不改 dispatch 核心)。
我特意去翻了下 ProviderConfigManager._build_provider_config_map() 这个方法,它返回一个 dict[LlmProviders, tuple[Callable, bool]],第二个 bool 字段是”是否需要 model 参数”——因为 Azure AI Studio、Bedrock、Vertex 这种”一个 provider 内有多种 model 路由”的情况需要拿 model 名做二次分派,而 OpenAI 这种”一种协议走到底”的不需要。
CompletionDispatchContext 是个 pydantic model,把 model/messages/api_key/api_base/optional_params/litellm_params/... 这 14 个字段从函数签名里赶出去,让 _complete_xxx 函数可以纯靠 ctx 做参数传递,方便单测和 mock。
反面教材:我看 pi agent harness 的设计里 pi-ai 的 provider 适配器是”每个 provider 一个 class 继承 base class”——那种方式更 OO,但加 provider 要写更多模板代码。litellm 的 dict 模式更”脚本化”,加 provider 速度更快,但牺牲了一点 type safety(dict 里的 Callable 没法在 IDE 里跳转)。
2.4 HTTP 收口:所有 standard provider 走同一个 handler#
到第 4 层,代码收敛到 litellm/llms/custom_httpx/llm_http_handler.py 的 BaseLLMHTTPHandler.completion()。
这个文件有 13900 行,比 main.py 还大——但它做的事非常机械:拿到 ctx → 调 ProviderConfig.transform_request() → 用 HTTPHandler 发请求 → 调 ProviderConfig.transform_response() → 流式的话走 streaming_handler.py。
60+ 个 provider 的 transformation 都继承 BaseConfig(在 litellm/llms/base_llm/chat/transformation.py),要实现的接口就 2 个:transform_request 和 transform_response。这是 litellm 能 hold 住 100+ provider 的根本原因——接口极薄,扩展极容易。
BaseLLMAIOHTTPHandler 是 async 版本,区别就是用 AsyncHTTPHandler(基于 httpx.AsyncClient)。两套代码是镜像的,逻辑完全一致,只是 await/await/await。
2.5 出网 + 算账:两个独立的”出口”#
到第 5 层,代码分叉成两个独立的支线:
- 出网:
HTTPHandler把请求发到 provider 的真 API,这块没什么好说的 - 算账:
Logging.update_response_metadata从 raw response 抽 usage →_response_cost_calculator调对应 provider 的cost_per_token()→ 写到response._hidden_params["response_cost"]
async_success_handler 之后派发到所有 CustomLogger 子类(Langfuse、Datadog、S3 等等),这是个观察者模式的典型实现。
算账链路我后面单独开一节讲,这里先卖个关子——它有 3 个我没想到的工程细节。
三、Rust 重写到底换了什么 —— 不是性能噱头#
我本来以为 litellm-rust 是”为了性能把 Python 关键路径用 Rust 重写”,打开看 Cargo.toml 我就发现这理解不对。
工作空间是这么组织的:
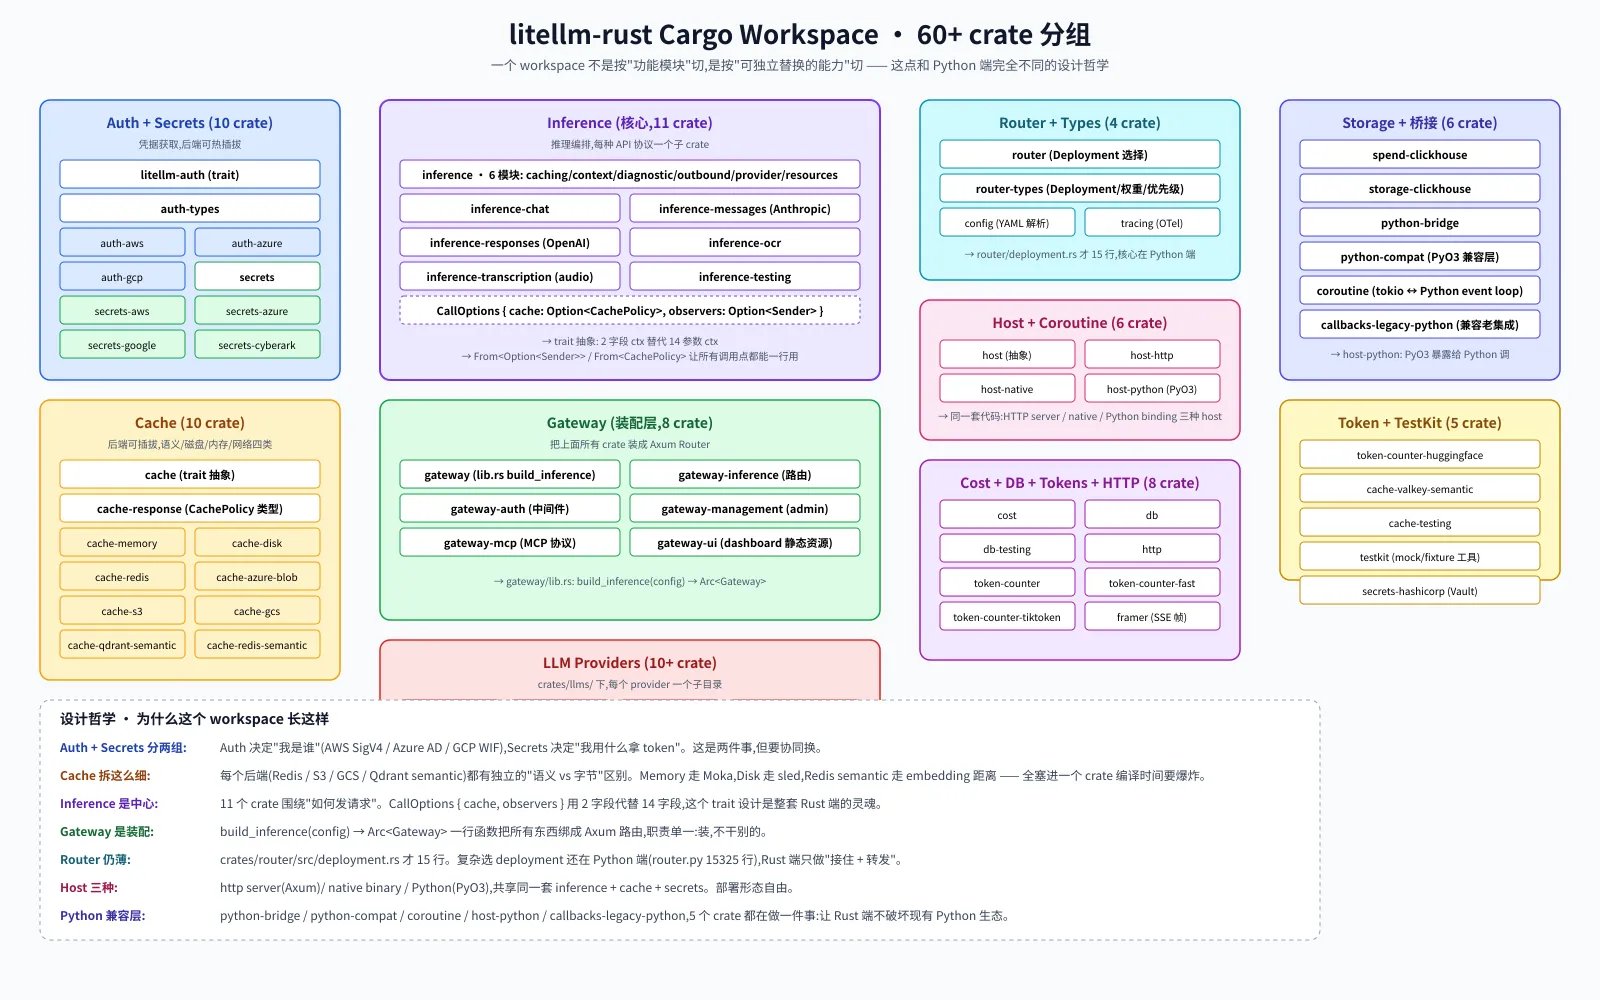
60+ 个 crate,按”可独立替换的能力”切分成 8 组:
- Auth + Secrets(10):auth 决定”我是谁”,secrets 决定”怎么拿 token”,是两件事但要协同
- Cache(10):memory / disk / redis / s3 / gcs / azure-blob / qdrant-semantic / redis-semantic / valkey-semantic / 抽象 trait
- Inference(11):核心推理编排,每个 API 协议(chat / messages / responses / ocr / transcription)一个子 crate
- Gateway(8):装配层,把上面所有 crate 绑成 Axum Router
- LLM Providers(10+):anthropic / openai / bedrock / vertex_ai / cohere / deepseek / mistral / azure_ai / openai_like / reducto / aws_textract / base_llm
- Router + Types(4):deployment 选择 + 类型 + config 解析 + tracing
- Host + Coroutine(6):抽象 + http + native + python (PyO3) + tokio ↔ Python event loop
- Cost + DB + Tokens + HTTP(8):cost 算账 / db 抽象 / token counter 多种 / http client / framer (SSE)
3.1 设计哲学:跟 Python 端完全不同的拆分思路#
Python 端是”按功能切”(main.py / utils.py / router.py / cost_calculator.py),Rust 端是”按可独立替换的能力切”。
为什么这么切?两个原因:
第一,编译时间。把 cache 后端塞进一个 crate,每加一个后端就触发整个 crate 重编译,对一个 60+ crate 的工作空间来说编译时间会爆炸。拆开后改一个 cache 后端只重编那个 crate。
第二,能力边界。auth-aws 和 secrets-aws 看起来都是 AWS 相关,但前者处理 SigV4 签名,后者处理 Secrets Manager 拉 API key。它们可以独立替换——你可以用 auth-gcp + secrets-aws 组合,授权走 GCP 凭据,密钥从 AWS Secrets Manager 拿。这种”正交拆分”是 Rust 端设计的精髓。
3.2 Inference 是中心:CallOptions 2 字段的精妙#
crates/inference/src/lib.rs 文件只有 34 行,但定义了整套工作空间的灵魂类型:
#[derive(Clone, Default)]
pub struct CallOptions {
    pub cache: Option<litellm_cache_response::CachePolicy>,
    pub observers: Option<litellm_host::observation::ObservationSender>,
}2 个字段。cache 控制是否走缓存、什么 policy;observers 是 OTel span 的发送端点。
但真正精妙的是 From 实现的两个:
impl From<Option<ObservationSender>> for CallOptions { ... }
impl From<CachePolicy> for CallOptions { ... }这两个 From 让所有调用点能写一行:
some_fn(cache_policy.into())
some_fn(observer.into())inference crate 内部按职责拆 6 个子模块:caching / context / diagnostic / outbound / provider / resources。每个子模块独立演进,互不污染。
inference-chat / inference-messages / inference-responses / inference-ocr / inference-transcription 这 5 个 inference 子 crate 分别对应 OpenAI chat / Anthropic messages / OpenAI Responses / OCR / 语音转录,每种 API 协议一个 crate。这种拆分方式跟 litellm 整体的”每种 API 一个 proxy endpoint”是同构的——/v1/chat/completions / /v1/messages / /v1/responses / /v1/audio/transcriptions 各自有自己的 route 树。
3.3 Gateway 是装配:build_inference 一行函数#
crates/gateway/src/lib.rs 的 build_inference() 是整套工作空间的入口函数,简化后是这样:
pub fn build_inference(config: &Config) -> Result<Arc<Gateway>, Error> {
    let pool = Arc::new(HttpClientPool::new(Arc::new(PublicDnsResolver)));
    let environment = secrets::environment_values(&config.environment_variables)?;
    let http = Resolution::from(&http_settings).config;
    let client = pool.client(&http, ClientVariant::Provider)?;
    let secrets = Arc::new(secrets::ConfigSecrets::new(environment, ...));
    let resources = CoreResources::new(pool);
    Ok(Arc::new(Gateway::new(
        resources, http, secrets,
        ModelRouter::from_model_list(&config.model_list)?,
    )?))
}这段代码做 4 件事:
- 建 HTTP client pool(连接复用)
- 解环境变量 + 注入 SSL 配置
- 建 secrets 源(环境变量 + Python 兼容 + AWS/Azure/GCP/HashiCorp/CyberArk 5 套 backend)
- 装 ModelRouter
注意它不直接构建 Axum Router——Axum::Router 是在 gateway-inference crate 里拼的,gateway crate 只负责”装核心对象”。这种”core + 装配分离”是面向长期演进的:
- 哪天想换 actix-web / hyper-only / warp 都不用动 core
- 哪天想加新 auth 机制也不用动 core
- 哪天想做 native binary(不是 HTTP server)也不影响
3.4 Router 在 Rust 端仍然薄#
crates/router/src/deployment.rs 文件只有 15 行。这是因为复杂选 deployment 的逻辑(15 个 strategy、Redis pipeline 批量读、TTFT 滑动窗口)全在 Python 端的 litellm/router.py(15325 行)。
Rust 端的 router crate 只做一件事:接住 Python 通过 PyO3 传过来的 deployment 列表,做最朴素的转发。这不是”偷懒”,是务实的选择——把已经在 Python 端验证过的算法迁移到 Rust 是巨大工程量,先把网关 / 缓存 / secrets 这些纯 IO 路径 Rust 化能拿到 80% 的收益(启动速度、内存、并发),剩下 20% 的 router 算法可以慢慢迁移。
host-python crate(PyO3 暴露)让 Python 代码可以 import litellm_rust 然后用 Rust 版的 cache / auth / secrets,不用等整个 SDK 迁移完。这是渐进式迁移的经典路径。
四、Router 选 deployment:15 个 strategy 的”什么算最优”#
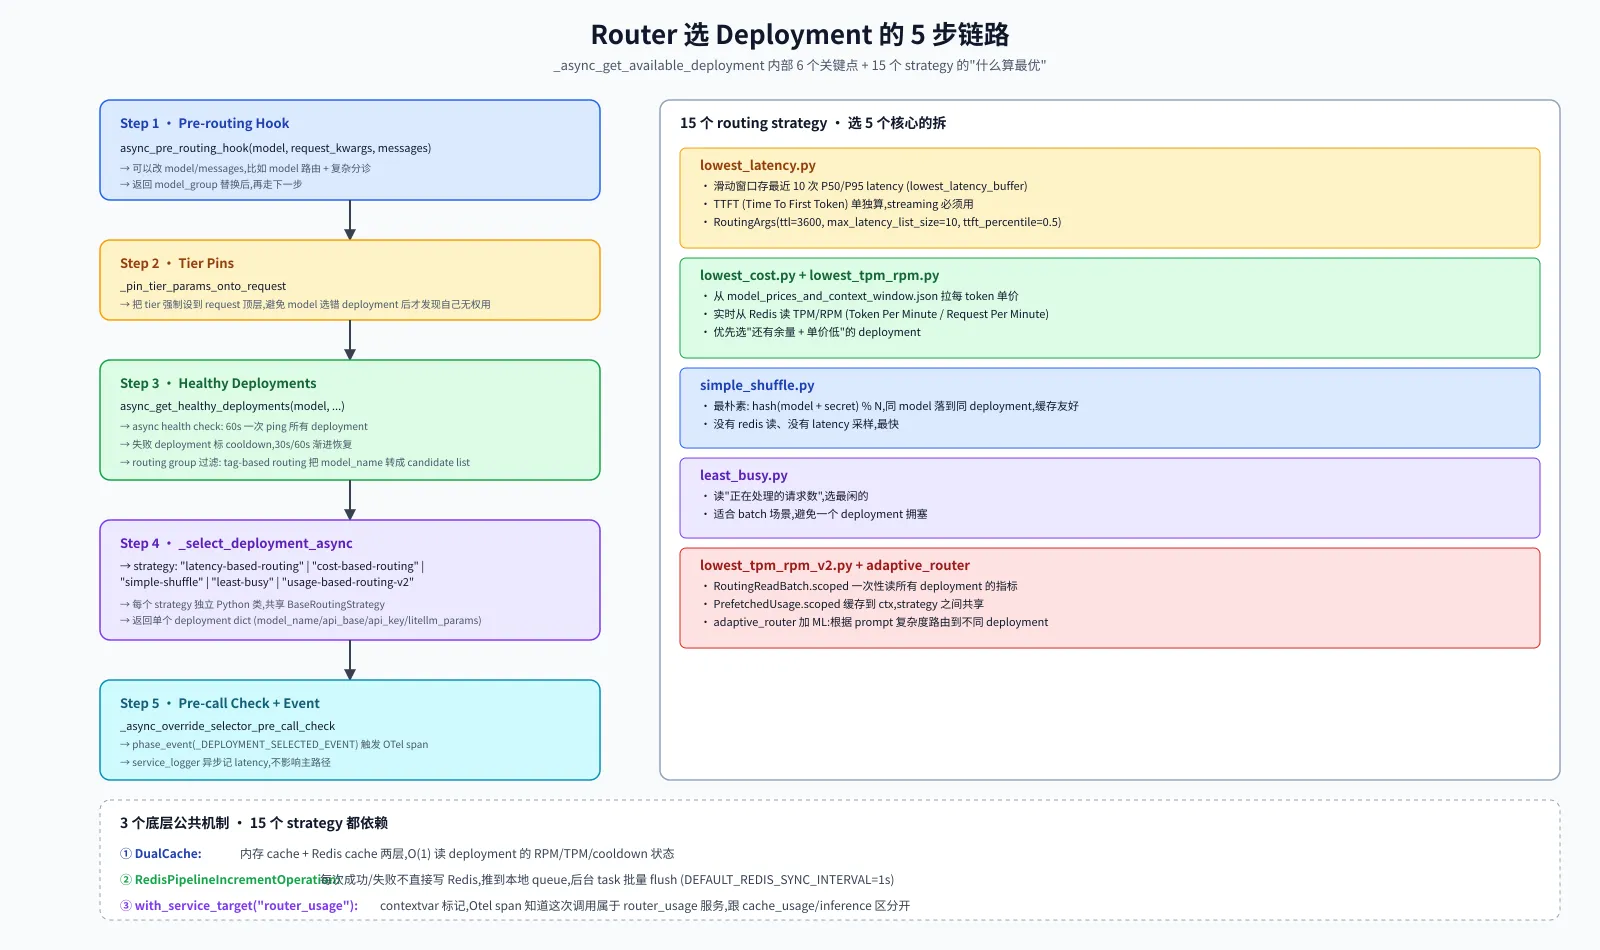
这块我一开始也以为是堆功能,但读 litellm/router.py 的 _async_get_available_deployment(行号 13790)发现核心流程只有 5 步:
4.1 第 1 步:pre-routing hook 是被低估的扩展点#
async_pre_routing_hook(model, request_kwargs, messages, input) 这个钩子我一开始以为是”预留接口”,看了 enterprise/ 下的实现才发现它被用得很重。
它能改 model、messages、litellm_params。典型场景:
- model 改写:根据 metadata 里的 user role 把
gpt-4o改写成gpt-4o-mini - messages 改写:自动加 system prompt
- model_group 替换:把
gpt-4o替换成prod-east-gpt4o这种带 routing group 的名字
_pin_tier_params_onto_request 是紧接着的一步:把 tier 强制设到 request 顶层。这是为了避免”model 选错 deployment 后才发现自己无权用”——tier 检测在 router 之前,强行覆盖可避免浪费一次 deployment 健康检查。
4.2 第 2 步:healthy deployments 是个”动态白名单”#
async_get_healthy_deployments 读的不是静态配置,是个动态白名单:
_run_background_health_check这个隐藏 job 持续 ping 所有 deployment- 失败的 deployment 标 cooldown,30s 后首次恢复,60s 后二次恢复
- routing group 过滤:tag-based routing 把
model_name转成[{deployment1}, {deployment2}]的候选 list
我之前以为 health check 是同步的,结果发现是完全异步的后台 job 维护。这意味着 router 在选 deployment 时不做任何网络请求——所有健康状态都是内存里现成的。
4.3 第 3 步:5 个 strategy 的”什么算最优”#
15 个 strategy 不是平等的——按 Python 端实现的成熟度,5 个有”async 优化路径”,剩下 10 个走老路 get_available_deployment(同步 + 简单选择):
lowest_latency.py:
- 滑动窗口存最近 10 次 P50/P95 latency
- TTFT (Time To First Token) 单独算,streaming 必须用
RoutingArgs(ttl=3600, max_latency_list_size=10, ttft_percentile=0.5)三个可调_percentile_latency走ceil(len(values) * percentile) - 1这种简单公式
lowest_cost.py + lowest_tpm_rpm.py:
- 从
model_prices_and_context_window.json拉每 token 单价(60K 行 JSON) - 实时从 Redis 读 TPM/RPM (Token Per Minute / Request Per Minute)
- 优先选”还有余量 + 单价低”的 deployment
simple_shuffle.py:
- 最朴素:
hash(model + secret) % N - 同 model 落到同 deployment,缓存友好
- 没有 redis 读、没有 latency 采样,最快
least_busy.py:
- 读”正在处理的请求数”,选最闲的
- 适合 batch 场景,避免一个 deployment 拥塞
lowest_tpm_rpm_v2.py + adaptive_router:
RoutingReadBatch.scoped一次性读所有 deployment 的指标PrefetchedUsage.scoped缓存到 ctx,strategy 之间共享- adaptive_router 加 ML:根据 prompt 复杂度路由到不同 deployment
4.4 15 个 strategy 都依赖的 3 个底层机制#
我读完所有 strategy 后总结出 3 个共性:
① DualCache(litellm/caching/dual_cache.py):
内存 cache + Redis cache 两层,O(1) 读 deployment 的 RPM/TPM/cooldown 状态。这个抽象让 strategy 写起来很”无脑”——所有读状态都走 dual_cache.get(),不用关心是内存还是 Redis。
② RedisPipelineIncrementOperation:
每次成功/失败不直接写 Redis,推到本地 queue,后台 task 批量 flush(DEFAULT_REDIS_SYNC_INTERVAL=1s)。这是异步刷新的精髓——主路径不 await Redis,吞吐拉满。
③ with_service_target(“router_usage”):
contextvar 标记,Otel span 知道这次调用属于 router_usage 服务,跟 cache_usage / inference 区分开。这种 tagging 是 OTel 实践里最容易被忽略的——你不打 tag,trace 出来是一坨;打了 tag,trace 出 7 层嵌套结构,每层是独立服务。
易踩坑:我读 router 的时候发现一个反直觉的设计——is_batch_retrieve_call_type 这个判断让 batch 检索请求不更新 latency 统计。原因:batch retrieve 拿的是之前的结果,不算新调用,混进去会污染 P50。这是 production-grade 的细节,自己写容易忘。
五、Cost 记账是隐形护城河:3 个反直觉的工程细节#
litellm/cost_calculator.py 3183 行,每个 provider 一个 cost_per_token(),这点我读之前以为是”功能堆砌”。读完才发现这是 litellm 真正护城河——多团队共用一个 AI Gateway 不爆 DB 的关键。
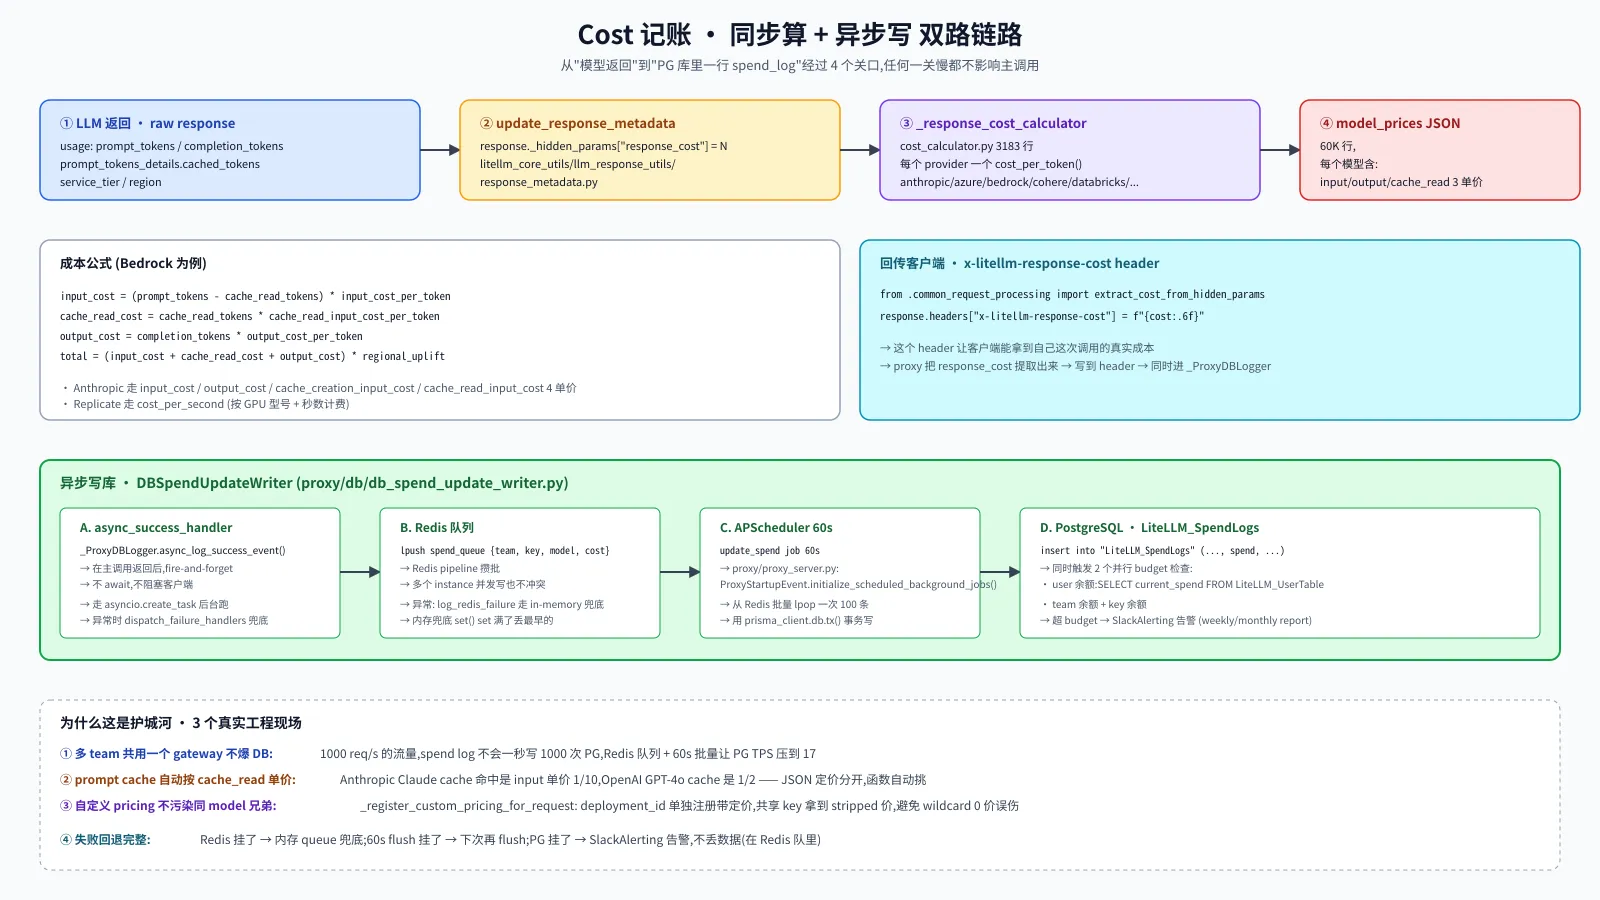
下图是完整的 cost 链路:
5.1 同步算账:从 raw response 到 hidden_params#
Logging.update_response_metadata(litellm_core_utils/llm_response_utils/response_metadata.py)从 raw response 抽 usage,然后 _response_cost_calculator 调对应 provider 的 cost_per_token()。
这块的关键设计是结果写到 response._hidden_params["response_cost"] 上——这是个 pydantic model 的 dynamic field,不破坏 OpenAI 兼容的 response schema。客户端拿到的还是标准 OpenAI response,但能通过 .hidden_params 拿到自己的真实成本。
proxy/common_request_processing.py 接着把 hidden_params["response_cost"] 提取出来,写到 x-litellm-response-cost response header 上——这样客户端能拿到自己这次调用的真实成本,不用解析 response body。
5.2 异步写库:DBSpendUpdateWriter 的 4 步流水线#
同步算账完成后,cost 还要进 PG 给管理员看。这块走完全异步的 4 步流水线:
A. async_success_handler (fire-and-forget)
_ProxyDBLogger.async_log_success_event() 在主调用返回后被触发,不 await、不阻塞客户端。它走 asyncio.create_task 后台跑,主调用已经返回给客户端了,cost 还在飞。这种”返回先到、cost 后到”的设计让 P99 latency 不被 cost 写库拖慢。
B. Redis 队列 (攒批)
队列命令是 lpush spend_queue {team, key, model, cost, ts}。多个 proxy instance 并发写也不冲突——Redis lpush 是原子的。异常兜底:log_redis_failure 走 in-memory 兜底,内存 set 满了丢最早的,不丢成本计算(只是延迟入账)。
C. APScheduler 60s 批量 flush
proxy 启动时 ProxyStartupEvent.initialize_scheduled_background_jobs() 把 9 个后台 job 一次性挂上去,其中 update_spend 每 60s 跑一次,从 Redis lpop 一次 100 条,用 prisma_client.db.tx() 事务写 PG。这一步把”1000 req/s 的写入”压成”17 req/s 的事务写”。
D. PostgreSQL · LiteLLM_SpendLogs 写完后同时触发 2 个并行 budget 检查:
- user 余额:
SELECT current_spend FROM LiteLLM_UserTable - team 余额 + key 余额
超 budget → SlackAlerting.send_weekly_spend_report / send_monthly_spend_report 告警。
5.3 3 个我没想到的工程细节#
① prompt cache 自动按 cache_read 单价:
Anthropic Claude 的 cache 命中是 input 单价 1/10(5x 写 1x 读),OpenAI GPT-4o 的 cache 是 input 单价 1/2。model_prices_and_context_window.json 60K 行分开定价(cache_creation_input_cost_per_token / cache_read_input_cost_per_token / input_cost_per_token),cost_per_token() 函数自动按 prompt_tokens_details.cached_tokens 字段挑对应单价。如果混在一起定价,cache 那部分成本会被错算。
② 自定义 pricing 不污染同 model 兄弟 deployment:
_register_custom_pricing_for_request 这个函数处理一个微妙的 case:router 选出来的 deployment 可能有自己单独的 pricing override(比如某个 wildcard deployment 0 价测试用),但同 model 名的”兄弟 deployment”还要按正常单价计费。
代码的做法是:
- deployment_id 单独注册带 pricing 的 entry
- 共享 key
{provider}/{model}拿到的是 stripped pricing(CustomPricingLiteLLMParams.strip_custom_pricing_fields抹掉 pricing 字段)
这样 0 价 wildcard 不会污染其他走同 model 的兄弟 deployment。我读到这里停下来想了 5 分钟——这个细节完全是我之前没考虑过的 production 场景。
③ 失败回退完整到 4 层:
- Redis 挂了 → 内存 queue 兜底
- 60s flush 挂了 → 下次再 flush(不会丢数据)
- PG 挂了 → SlackAlerting 告警,数据还在 Redis 队列
- 内存也满了 → 丢最早的(按 timestamp 排序),不丢成本计算只延迟
这种”4 层兜底”是 production-grade 跟 hobby project 的本质区别。自己写 gateway 容易在第 1 层就崩——Redis 一挂整个记账停摆。litellm 的设计是”任何一层挂掉都降级不挂”。
六、Proxy 启动 + 9 个后台 Job:把”网关”做成产品#
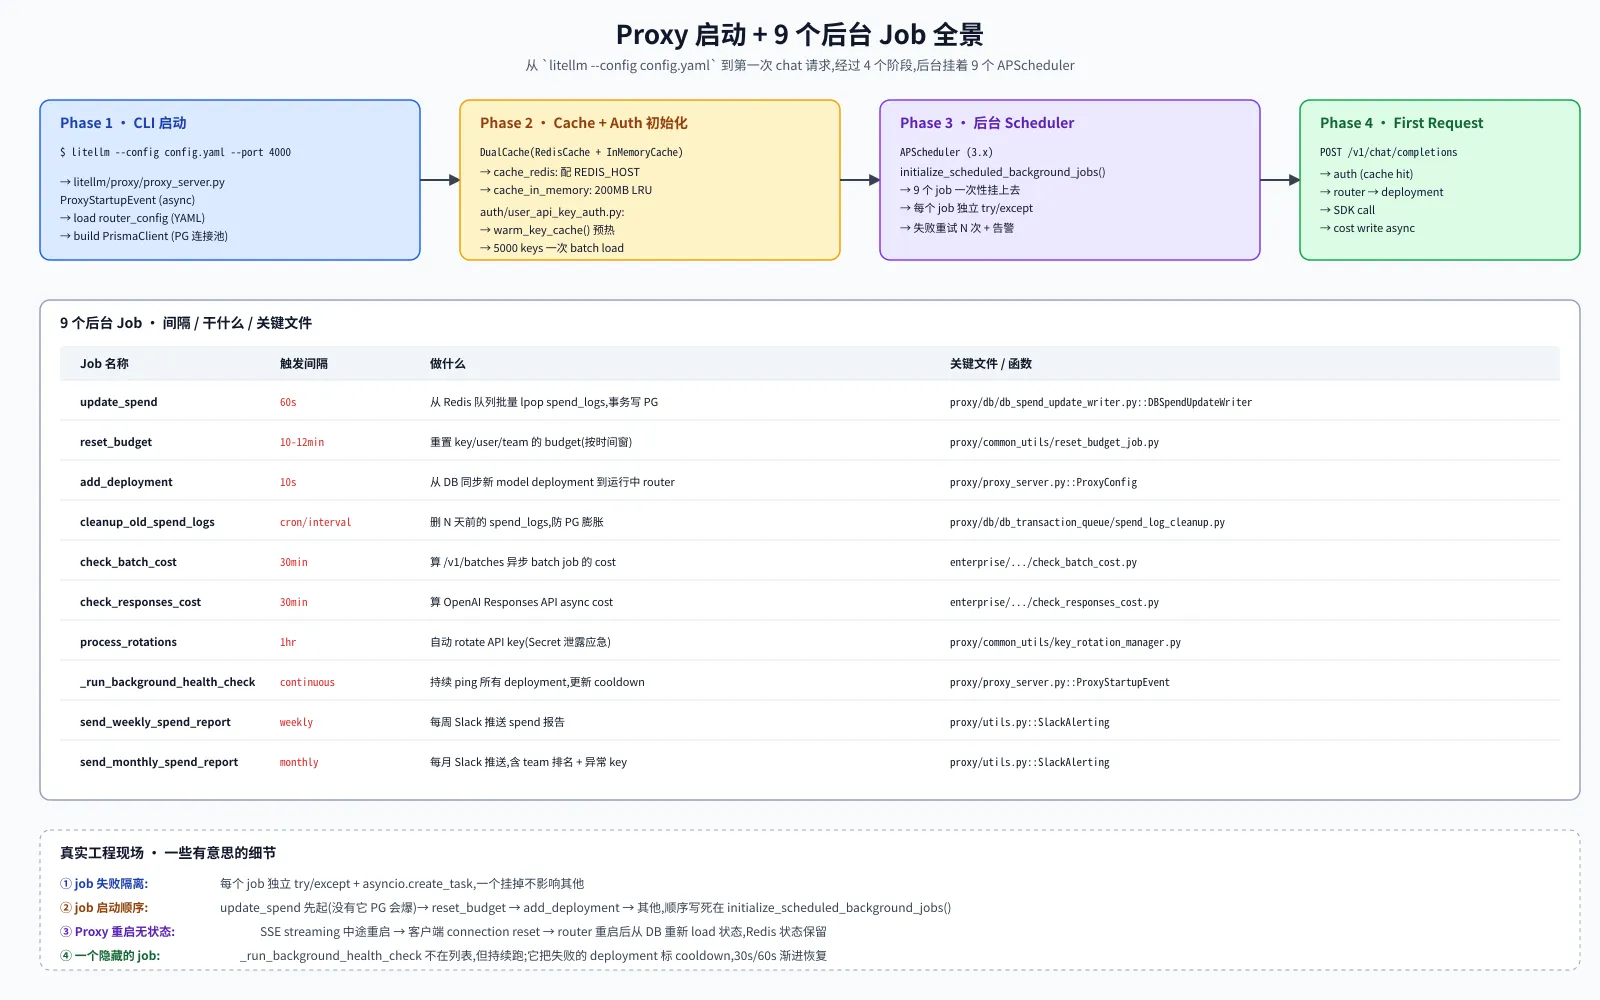
litellm/proxy/proxy_server.py 是 proxy 入口,但真正能体现 litellm 把它做成产品的,是 ProxyStartupEvent.initialize_scheduled_background_jobs() 启动的 9 个 APScheduler job:
6.1 启动 4 阶段#
Phase 1 · CLI 启动:
litellm --config config.yaml --port 4000 触发 ProxyStartupEvent 异步事件,加载 router_config、build PrismaClient(PG 连接池)。
Phase 2 · Cache + Auth 初始化:
DualCache(RedisCache + InMemoryCache):内存 200MB LRU + Rediswarm_key_cache()预热:5000 keys 一次 batch load
Phase 3 · 后台 Scheduler 启动:
- 9 个 job 一次性挂上去
- 每个 job 独立 try/except
- 失败重试 N 次 + 告警
Phase 4 · First Request:
POST /v1/chat/completions- auth (cache hit) → router → deployment → SDK call → cost write async
6.2 9 个 job 拆解#
| Job 名称 | 间隔 | 干什么 | 关键文件 |
|---|---|---|---|
| update_spend | 60s | 从 Redis 批量 lpop spend_logs,事务写 PG | proxy/db/db_spend_update_writer.py::DBSpendUpdateWriter |
| reset_budget | 10-12min | 重置 key/user/team 的 budget(按时间窗) | proxy/common_utils/reset_budget_job.py |
| add_deployment | 10s | 从 DB 同步新 model deployment 到运行中 router | proxy/proxy_server.py::ProxyConfig |
| cleanup_old_spend_logs | cron/interval | 删 N 天前的 spend_logs,防 PG 膨胀 | proxy/db/db_transaction_queue/spend_log_cleanup.py |
| check_batch_cost | 30min | 算 /v1/batches 异步 batch job 的 cost | enterprise/.../check_batch_cost.py |
| check_responses_cost | 30min | 算 OpenAI Responses API async cost | enterprise/.../check_responses_cost.py |
| process_rotations | 1hr | 自动 rotate API key(Secret 泄露应急) | proxy/common_utils/key_rotation_manager.py |
| _run_background_health_check | continuous | 持续 ping 所有 deployment,更新 cooldown | proxy/proxy_server.py::ProxyStartupEvent |
| send_weekly_spend_report | weekly | 每周 Slack 推送 spend 报告 | proxy/utils.py::SlackAlerting |
| send_monthly_spend_report | monthly | 每月 Slack 推送,含 team 排名 + 异常 key | proxy/utils.py::SlackAlerting |
6.3 一些有意思的细节#
① job 启动顺序写死在代码里:
不是用”优先级”配置,是字面意义上 initialize_scheduled_background_jobs() 里的代码顺序:update_spend 先起(没有它 PG 会爆)→ reset_budget → add_deployment → 其他。这种 hard-code 顺序在 production 里很常见——配置化启动顺序的代码比 hard-code 复杂 5 倍但收益不抵成本。
② job 失败隔离:
每个 job 独立 try/except + asyncio.create_task,一个挂掉不影响其他。我读 check_batch_cost 的时候发现它甚至单独 try/except 自己内部的每次循环——某个 batch job 算 cost 失败不影响同批次其他 job。
③ Proxy 重启无状态: SSE streaming 中途重启 → 客户端 connection reset → router 重启后从 DB 重新 load 状态,Redis 状态保留。这意味着 proxy 是个”无状态 server”,可以水平扩展,唯一的”状态”是 DB + Redis。
④ 一个隐藏的 job:_run_background_health_check
不在文档的 9 个 job 列表里,但持续跑。它把失败的 deployment 标 cooldown,30s 后首次恢复,60s 后二次恢复。我之前以为 cooldown 是 router 调用时同步检查的,结果是后台维护的——这跟前面说的”router 不做网络请求”是一致的。
6.4 真正把”网关”做成产品的几个细节#
- SlackAlerting 双轨:weekly + monthly 报告自动推送,team 排名 + 异常 key 提示
- process_rotations 自动 rotate:Secret 泄露应急不用人盯,1hr 自动轮换
- spend_log_cleanup 定时清理:默认保留 N 天(可配),防止 PG 无限膨胀
- check_batch_cost + check_responses_cost 单独存在:异步 batch job 的 cost 算账跟实时 cost 算账走不同路径,因为 batch job 的 cost 是事后算(job 跑完才知道用了多少 token)
这 9 个 job 加起来才是 litellm 真正区别于 LangChain / LlamaIndex / raw SDK 的地方。其他 LLM 库都是”帮你调 LLM”,litellm 是”帮你管 LLM”——前者是 library,后者是 platform。
七、对比与反思:litellm 教会我的 3 件事#
拆完 litellm 之后我最大的感受是:它不是一个”AI Gateway”项目,是一个”如何管理 100+ provider 的工程化样本”。
7.1 对比:我之前拆过的 AI 项目#
| 项目 | 关注点 | 跟 litellm 的差异 |
|---|---|---|
| HyperFrames (HeyGen) | 渲染引擎 + Agent Skills 教材 | 解决”如何确定性渲染 HTML→视频”,跟 LLM 无关 |
| God’s Eye View (Bilawal Sidhu) | 浏览器上帝视角 + WebRTC | 解决”如何把 15 路公开数据塞进一个 3D 地球”,跟 LLM 无关 |
| pi agent harness (Mario Zechner) | 终端编码 Agent + TS 扩展 | 解决”如何做一个 1MB TS 写成的 coding agent”,单 provider 假设 |
| MathModelAgent | 数学建模 SKILL 包 | 解决”如何把 Codex + 教材串成 pipeline”,单 provider 假设 |
| litellm (本篇) | AI Gateway + 100+ provider 抽象 | 解决”如何把 N 个互不兼容的 API 收口到一个 OpenAI 兼容入口” |
对比一下就很明显——前 4 个都是”单 provider 假设”,它们假设你只用 OpenAI 或者只用 Anthropic,所以不需要管”多 provider 怎么协同”。litellm 不一样,它把”多 provider”做成了一等公民,每多一个 provider 就多一种可能性:
- 同 prompt 可以同时发给 3 个 provider 做 ensemble
- 主 provider 挂了自动 fallback 到备用
- 复杂 query 路由到 GPT-4,简单的路由到 GPT-4o-mini
- 一个 team 限额用完了自动切到另一个 team 的 key
7.2 我从 litellm 学到的 3 件事#
① “加 provider 成本压到 ~50 行”是 open/closed 原则的极致实现
我之前看 OO 教材说”对扩展开放、对修改封闭”,以为是说”加新 class 继承 base class”。litellm 给我上了一课:
- 对扩展开放:加 provider 只需要 dict 加一条记录 + 写一个
_complete_xxx函数 - 对修改封闭:dispatch 核心、HTTP handler、cost 算账所有这些都不动
字典 + 函数指针的”脚本式”设计牺牲了 type safety,但换来了”加 provider 不需要碰 5 个文件”。这是工程上”实际成本”的胜利。
② “可独立替换的能力”是 Rust 端 crate 拆分的核心
Python 端按”功能”切(main/utils/router/cost),Rust 端按”能力”切(auth / secrets / cache / inference / gateway / host)。这种差异不是语言特性驱动的,是演进阶段驱动的:
- Python 端 1.x 时只有 OpenAI 1 个 provider,按”功能”切够了
- Rust 端从 0 开始设计,按”能力”切才能 hold 住 60+ crate
拆 crate 的判断标准只有一个:“改这个文件需要重编多少代码”。改 cache 后端只需要重编 cache-* crate,那就值得拆出来;改 HTTP client 只需要重编 http crate,那也值得拆。
③ Cost 记账是 production-grade 的真正护城河
我看 pi agent harness、MathModelAgent 这种”小而美”的项目,最大的缺陷就是没有 cost 记账。他们假设你用单 provider、单 key、单 team——这种假设在 YC 演示时成立,在真实团队里立即崩。
litellm 的 4 层兜底(同步算 / Redis 队列 / 60s flush / PG 事务)+ 3 个反直觉细节(cache 分价 / deployment 隔离 / 失败降级),是只有当你的客户是 100+ 企业的工程团队时才会被逼出来设计。Hobby project 不会有这种细节。
7.3 我不会照搬的部分#
公平讲,litellm 也有我觉得”过度工程化”的地方:
litellm/main.py9522 行 + 90+ 参数的acompletion签名,对调用方心智负担大_complete_xxx函数族每个都长得很像,重复模板代码很多(100+ 函数 = 100+ 段 if-elif 链)- 9 个 APScheduler job 的启动顺序 hard-code,加新 job 要小心
ProviderConfigManager字典的Callable类型在 IDE 里没法跳转,加 provider 时容易漏
但这些”瑕疵”在 100+ provider 的体量下,都比”重新设计一个能 hold 住的架构”便宜。这就是为什么我说它是”工程化样本”——它不是在追求”代码漂亮”,是在追求”加 provider 成本最低”。
八、结语#
litellm 这个项目给我最大的冲击不是”100+ provider 怎么接”,而是**“100+ provider 怎么管”**。
main.py 9522 行不是问题——加了 50 个新 provider 它就该长这样。router.py 15325 行也不是问题——15 个 strategy 加每种 1000+ 行实现就该这么大。真正的问题是:怎么在 100+ provider 上做 cost 记账、rate limit、auth、cache、health check 而不爆 DB、Redis 队列、APScheduler、Prisma 事务。
这套答案藏在我前面画的 5 张图里:
- dispatch 字典 = 把”加 provider”压成”加 50 行 + 一条 dict”
- Rust 工作空间 = 把”能力边界”按”可独立替换”切,60+ crate 互不污染
- router 5 步 = pre-hook → tier pin → healthy → strategy → event,把”什么算最优”的定义权下放
- cost 双路 = 同步算 + 异步写,4 层兜底,3 个反直觉细节
- proxy 9 job = 60s update_spend + 30min check_batch_cost + weekly report = 把”网关”做成”平台”
这 5 张图 + 5 节展开,是我对 litellm 这个项目的诚实拆解。
附录 · 真实信息#
- 仓库:
BerriAI/litellm(GitHub) - 版本:2026-10-10 拉取的
main分支(commit hash 没记,但 archive size 251MB / 文件数 7122 / 60+ Rust crate 都在) - star:60,694(截至 2026-10-10)
- Y Combinator:W23 批次
- LICENSE:MIT
- 公司归属:BerriAI(YC 投资的 AI Infra 公司,Ishaan Jaffer + Krrish 创办)
关键文件清单(我读过的)#
litellm/main.py                          9522 行  入口 + dispatch
litellm/router.py                       15325 行  路由 + 15 strategy
litellm/utils.py                        10544 行  get_llm_provider + ProviderConfigManager
litellm/cost_calculator.py               3183 行  per-provider cost
litellm/llms/custom_httpx/llm_http_handler.py  13900 行  HTTP 收口
litellm/router_strategy/lowest_latency.py         滑动窗口 P50/P95
litellm/router_strategy/base_routing_strategy.py  Redis pipeline 批量
litellm/proxy/proxy_server.py                     proxy 入口
litellm/proxy/db/db_spend_update_writer.py        60s flush spend log
litellm/litellm_core_utils/get_llm_provider_logic.py  provider 解析
litellm/llms/base_llm/chat/transformation.py      BaseConfig 接口

litellm-rust/Cargo.toml                  workspace 60+ crate
litellm-rust/crates/gateway/src/lib.rs            build_inference
litellm-rust/crates/inference/src/lib.rs          CallOptions 2 字段
litellm-rust/crates/llms/                         10+ provider crate