写在前面#
这篇论文挂在 arXiv 上还不到三天(v1:2026-10-08),但读完有一种「这个坑终于有人把它量齐了」的踏实感。作者是慕尼黑工业大学 TUM-DSE 的 Ilya Meignan—Masson、Martin Fink、Masanori Misono、Dimitrios Stavrakakis 与 Pramod Bhatotia,SIGMOD 2027 的扩展版(22 页正文 +附录 B 一份可复现的 LLM 分类协议),artifact 全部开源在 TUM-DSE/memsafedb ↗。
它回答的是一个直觉上都知道、但一直没有系统答案的问题:C/C++ 写的数据库系统,能不能在不重写成 Rust 的前提下,靠硬件辅助把内存安全拉到一个生产可用的水平?如果能,要付多少性能代价、改多少代码? 答案是分两条岔路——Arm 的 MTE 已经「基本能用」,CHERI 的 purecap 路线则被「显著有效但代价过高」拦在产线之外。
这篇笔记会按论文自己的四层结构(硬件 → 数据结构 → DBMS → 编译器 / 运行时 / OS)走一遍,把最值得记住的几个数字和最反直觉的几条结论串起来。
一、先回答一个前置问题:内存安全漏洞真的还重要吗?#
在 Android、Chromium 把内存安全漏洞占比从 70% 砍到 24% 的今天,「数据库系统还吃内存安全的老亏」听起来像上一代故事。但作者用 GPT-OSS-120B 对 2015–2025 七款主流开源数据库的 87,934 个 issue + 1,448 条 CVE 做了三轮交叉分类(同一 LLM 在三个独立 run 里一致才计),结果如下:
| 系统 | 总 issue | 内存安全相关 | 占比 |
|---|---|---|---|
| DuckDB | 5,981 | 549 | 9.2% |
| Redis | 3,433 | 393 | 11.4% |
| RocksDB | 2,432 | 227 | 9.3% |
| ClickHouse | 22,295 | 1,681 | 7.5% |
| MySQL | 21,503 | 614 | 2.9% |
| LevelDB | 306 | 13 | 4.2% |
| MariaDB | 30,536 | 3,290 | 10.8% |
| 合计 | 87,934 | 6,859 | 7.8% |
这条 7.8% 的横线很值得停下来看一眼。两个反直觉点:
- 新系统也跑不掉。 DuckDB 是 2018 年才立项的现代系统,9.2% 的内存安全 issue 占比并不比二十多岁的 MySQL 低;ClickHouse 也是同期作品,7.5%。Fuzzing、SQLancer、Pivoted Query Synthesis 都没能让这条线往下掉——和 Android 报告的下降趋势完全相反。
- 后果不是 crash 那么简单。 论文把 5,955 条确认的 bug 按「首次表现出的影响」分了 8 类(Table 1):Crash 占 87%、Resource exhaustion 11%、Incorrect query results 9%,还有 Data corruption(141 条)、Concurrency hazard(156 条)、Data loss(1 条)。换句话说,87% 的内存安全 bug 表面上是崩,但底下还埋着 13% 的「悄悄改了你的数据」「查出来是错的」「数据丢了」——对数据库这种带 ACID 承诺的系统来说,这层才是真正的代价。
把这条 7.8% 当背景噪音忽略是不行的。作者一句话点得很准:「a single erroneous memory access can corrupt an in-memory index before flushing to storage, return wrong query results, exhaust resources, expose sensitive records, or allow unauthorized writes」。一次错访就够把一致性 / 可靠性 / 安全性 / 持久性这四根柱子一起撬掉。
二、Database Trilemma:把问题正式化#
论文最干净的贡献,是把大家嘴上讨论的「安全 / 性能 / 移植性不可兼得」形式化成了三条轴,并明确告诉读者:软件方案、内存安全语言、硬件方案分别落在三角的哪个角。
| 方案 | Safety | Performance | Portability | 落地位置 |
|---|---|---|---|---|
| ASan / RSan(软件插桩) | 高(精确) | 极差(read 路径砍到 23%) | 高(-fsanitize=… 即可) | 仅调试 / 测试 |
| Rust(重写) | 高(编译期) | 高 | 差(需整体重写) | 新项目或内核模块 |
| MTE | 中高(概率 89% OOB 检出) | 高(≈ 5–10%) | 高(仅改分配器) | Armv8.5+ 已商用 |
| CHERI(purecap) | 最高(确定) | 较差(20–60%) | 差(ABI 全改) | Morello 研究板 |
表格数据来源:论文 Table 8、Table 12 与 Figure 16 综合整理。
我自己读完之后最想留住的就是这张图。论文 Figure 16 把它画成了一张三角图——MTE 是当前唯一一个同时站在「安全 / 性能 / 可移植性」三角重心附近的解。论文给它的定语是「终于接近可用于生产数据库系统的成熟度」。
三、四层评测之一:硬件层——CHERI 的能力有多大,MTE 的标签多便宜#
这一节主要回答「这两种扩展在 CPU 里到底长什么样」,是后面所有性能数字的根。
3.1 CHERI:用 capability 替换指针#
Morello 实现的 CHERI 把 64-bit 指针换成 128 + 1-bit capability:在地址之外多塞 31-bit bounds + 18-bit permissions + 15-bit object type + 8-bit flags + 1-bit validity。任何对 capability 的「擦写」都会清掉 validity bit;新 capability 必须从已有 capability 派生(narrowing)——这就把 C 里那段「指针 + cast + 算数」的元凶区给焊死了。
Morello 支持两种编译模式:
- purecap:所有指针都是 capability,ABI 全改,运行时链接 musl-cap。
- hybrid:只对显式标注的指针生效,兼容旧二进制。
3.2 MTE:用 tag 给内存上色#
Arm 的 MTE 设计上比 CHERI 朴素得多:把内存切成 16-byte granule,每个 granule 带 4-bit allocation tag(存在内存里、和数据同行);指针高 4 位(56–59)嵌入 logical tag。每次访问比对 tag,一致放行、不一致就 fault。
MTE 的两种粒度决定了它的覆盖范围:
- 空间安全:相邻 granule 分配不同 tag,就能挡住 OOB。
- 时间安全:free 时把内存 tag 清零,旧指针再来访问就 mismatch,等于「概率性 UAF 检测」。
但 MTE 是概率性的:tag 只有 4 bit,16 个值,碰撞概率在密集分配场景下不可忽略。论文里专门给了一句限制——不能检测同一个对象内部的越界(intra-object overflow),也没有 sub-object narrowing。
3.3 微观代价#
这部分是论文 Table 2 + Table 3 + Figure 6–10 的精华。我把最关键的几条整理出来:
CHERI 在 64-bit 数据通路上跑 128-bit capability 的硬成本:
- 一次
ldr(cap)的吞吐和ldr(64-bit int)一样,都是 2 inst/cycle——单条不慢。 - 但
stp(cap)只有 0.5 inst/cycle,比stp(64-bit int)的 1 inst/cycle 慢一倍。指针越密、store 越多,就越亏。 - pointer chasing(图 6a):list 一半条目就在 cache miss 处的延迟被 capability 撑平,但容量减半——cache line 同样是 64-byte,capability 占了 16-byte,等于 pointer-heavy 数据结构的有效缓存容量砍掉一半。
- atomic(图 6c):concurrent CAS / SWP 性能被 capability 版本拽到原来的 1/14(0.07 vs 1.00)。这是后面 lock-free 数据结构失守的根源。
MTE 的不对称成本:
- read 几乎免费:allocation tag 和数据同时返回,MTE on/off 读吞吐基本一致。
- write 翻车:store 必须先 fetch 现有 tag 再写,等于一次隐式 read-before-write。Table 4 给的 D-cache miss 数从 179.4 M 跳到 468.1 M,翻了 2.6 倍。
- glibc malloc(图 8):小分配走 sbrk 扩展的时候本来 O(1),MTE 一上变 O(n)——整个新分配的 region 必须打 tag,逐行 evict cache line。论文原话:「Large, short-lived allocations may benefit from different protection mechanisms (e.g., guard pages).」
- 选对初始化指令很关键:图 10 里
memset + stg这种朴素写法在 32 MB region 上 cycle 数是stzg(同时打 tag + 清零)的 1.5×(2.48 × 10⁹ vs 1.6 × 10⁹ cycles),cache miss rate 95.87% vs 0.08%。
第一段微观层面的 take-away:CHERI 是「把指针体积的代价一次性付清」,MTE 是「读写不对称的渐进税」。前者对 cache 不友好,后者对 cache 友好但写路径难受。这两套完全不同的人设,决定了它们在不同 DBMS 上的最终账单。
四、四层评测之二:数据结构——TRL 表背后的真相#
论文 §4 的核心,是把 B+Tree / ART / CLHT / Skip list / Queue / Linked list 这 6 类数据库常见结构,按 read / insert / update / scan 四种操作各跑一遍。我把最有代表性的几组数字拎出来。
B+Tree(来自 Leanstore,optimistic lock coupling):
- 单线程:MTE +25%、CHERI +33%(insert / update);scan 只 +10%(MTE)/+14%(CHERI)——4 KiB 节点一次装下 100-key scan range,cache 命中率高。
- 64 线程:MTE 全部操作都掉到「统计上不显著」。cache-coherence 和 lock-coupling 的争用把 tag-check 开销稀释掉了。
- CHERI 这边没做多线程:B+Tree 用 C++ exception 做 lock-coupling,purecap 模式下异常展开跑不起来。这就是论文第 6 章讲的 unwindable 坑,下文会展开。
ART(Adaptive Radix Tree):
- insert:MTE +38%,CHERI +200%。节点扩张触发的随机访问 + rebalance 对 capability 是双重打击(多写 + 跨页重定位)。
- read / scan:MTE 5–18%,CHERI 18–54%——温和。
CLHT(cache-line aligned hash table,无锁):
- insert:MTE +39%,CHERI +81%。CAS 在 capability 上的吞吐只有原生 CAS 的 1/14(前面算过),无锁结构踩在最大痛点上。
- read 64 线程:CHERI +43%(capability 加载也要校验)。
Skip list:
- scan:MTE 无统计显著影响(head + index 在 cache 里跑得欢);CHERI +56%。
- insert:CHERI +32%。
Queue(Boost 实现):整个数据集里最戏剧性的一行。
- MTE ≈ baseline——queue 存的是整数,integer 不参与 tag 检查,几乎零成本。
- CHERI 单线程 +858%,4 线程 +149%。原因:purecap 模式下 produce / consume 的 lock-free CAS 全部 capability 化,原本一个 4-cycle 的 CAS 退化成 capability-CAS(cycle 数除以 14)。
注:单线程 858% 这个极端值在 4 线程下降回 149%,是因为 head / tail 的争用把单次 lock-free 操作的等待时间稀释掉了。这不是说 4 线程更快,而是「858% 这种倍数在分母变大之后变小」。
**Linked list:**写多读少;MTE +33–62%,CHERI insert +150%。
把这一层抽成一个性能指纹:
| 结构 | MTE 主要开销处 | CHERI 主要开销处 |
|---|---|---|
| B+Tree | insert / update 时的随机写 | lock-free 优化路径(无);多线程扫不到 |
| ART | insert(节点扩张 + rebalance) | insert(同上 + capability store 翻倍) |
| CLHT | atomic CAS | atomic CAS + capability 校验 |
| Skip list | scan(cache miss 时) | scan(pointer chasing 链) |
| Queue | 几乎零(整数) | lock-free CAS(独此一家 858%) |
| Linked list | pointer chasing 时 cache miss | insert(write 加重) |
一句话:MTE 的「performance tax」取决于数据结构的写密度;CHERI 的「performance tax」取决于数据结构的 lock-free / pointer-chasing 密度。后者是个长期赌注。
五、四层评测之三:DBMS 层——六个真实系统的迁移账本#
这是论文最像「工程交付物」的一节。Table 7 列了 6 个系统的 LoC 改动 + 测出来的端到端吞吐。我把它整理成「一行一眼」的版本。
5.1 Redis(in-memory KVS)#
- CHERI:+140 / -33 行。需要替换 pointer cast 到
(u)intptr_t,强制 16-byte capability 对齐。一个非典型坑——Redis 利用argv[0]..argv[argc]的地址连续性写共享 buffer,capability 模型禁止,必须收紧到只访问argv[0]。 - MTE:+61 / -22 行,主要是改 jemalloc:分配时
irg生成 tag、释放时 tag 清零;tag 0 留给 freed region,1–15 分配给活对象。 - YCSB 吞吐:MTE +1%、CHERI +5%(在 1 个 client 下测的,Redis 单线程原生就到顶)。
5.2 LevelDB(persistent KVS / LSM tree)#
- CHERI:+12 / -9 行。CMake toolchain 文件改一下链接 musl-cap + LLVM libc++。
- MTE:0 行代码改动——只用 MTE-aware glibc +
GLIBC_TUNABLES=glibc.mem.tagging=3。 - YCSB:MTE 均值 +7%(10M 64-thread 在某些 case 还出现统计不显著的反超),CHERI 均值 +53%、insert-heavy workload(D / E)最差。
5.3 MySQL(OLTP server)#
- CHERI 跑不起来:依赖 OpenSSL 提供 TLS / crypto,当时没有 purecap 端口,作者主动放弃。
- MTE:+56 / -5 行,改 MySQL 自定义内存分配器——分配时打 tag、free 时重新打 tag + 探测 double-free。
- sysbench OLTP:MTE 最多 -6%(最小表 64 client 满缓存场景),其他配置 ≤1%。
5.4 SQLite(embedded OLTP)#
- CHERI:+35 / -3 行。坑:SQLite 的分配器在每次分配前多塞 64-bit 元数据,capability 默认覆盖整段,包括元数据;需要分配器自己留一份「特权 capability」操作元数据。
- MTE:+15 / -3 行。SQLite 是嵌入式库,
prctl必须恰好初始化一次——要么宿主程序做,要么库自己先查状态。 - py-tpcc:MTE / CHERI 全部跑在 baseline 置信区间里,不到 ±2%。
5.5 DuckDB(OLAP)#
- CHERI:+225 / -10 行,但只跑通了简单 query。三件事:① Musl 没有的
strtoll_l()等要写 shim;② 5 处「指针恰好 8 字节」假设要改成容纳 16-byte capability;③ yyjson 把 const 通过size_t强转丢了 capability bit。 - MTE:改 jemalloc,外加一个特殊修复——DuckDB 把密码学 salt 塞在指针高位,恰好和 MTE tag 撞车,要重新选 bit 位置。
- TPC-H:MTE 几何平均 +5%,但 Q1 单查询 +55%——Q1 聚合基数低、行的全表扫描,97% 新增 cycles 落在聚合方法里;Q8 / Q12 也聚合到两种状态,但因为先做 join / selective filter 把输入量砍掉了,只 +3–4%。
5.6 LadyBugDB(graph)#
- CHERI:+55 / -10 行。需要手动关 SVE(Morello 没实现,但构建系统不识别);之后无代码改动跑通。
- MTE:+63 / -2 行,把 buffer manager 的
getFrame()注入irg+stg。 - LDBC SNB:MTE 几何平均 +9–14%,随线程数上升;CHERI 几何平均 ≈ 0%(negligible)——图查询里大部分是整数 + CSR,没多少 capability 校验。
- 异常点:变长字符串属性的 query +10%,定长数值 +4%。55% 新增 cycles 在 dictionary scan、29% 在 allocator(每次 alloc 必须 tag / re-tag)。
把 6 个系统摊平来看:
| 系统 | MTE 端到端 | CHERI 端到端 |
|---|---|---|
| Redis | 1% | 5% |
| LevelDB | 7% | 53% |
| MySQL | ≤6% | 跑不通(OpenSSL) |
| SQLite | 统计不显著 | 0%(统计不显著) |
| DuckDB | 5%(Q1 例外 55%) | 简单 query 通过 |
| LadyBugDB | 9–14% | ≈0% |
注:表中「统计不显著」指 MTE / CHERI 端口 95% 置信区间与 baseline 重叠。
迁移成本的视觉化(图 1 给的「门面图」)——以 LevelDB 为例:
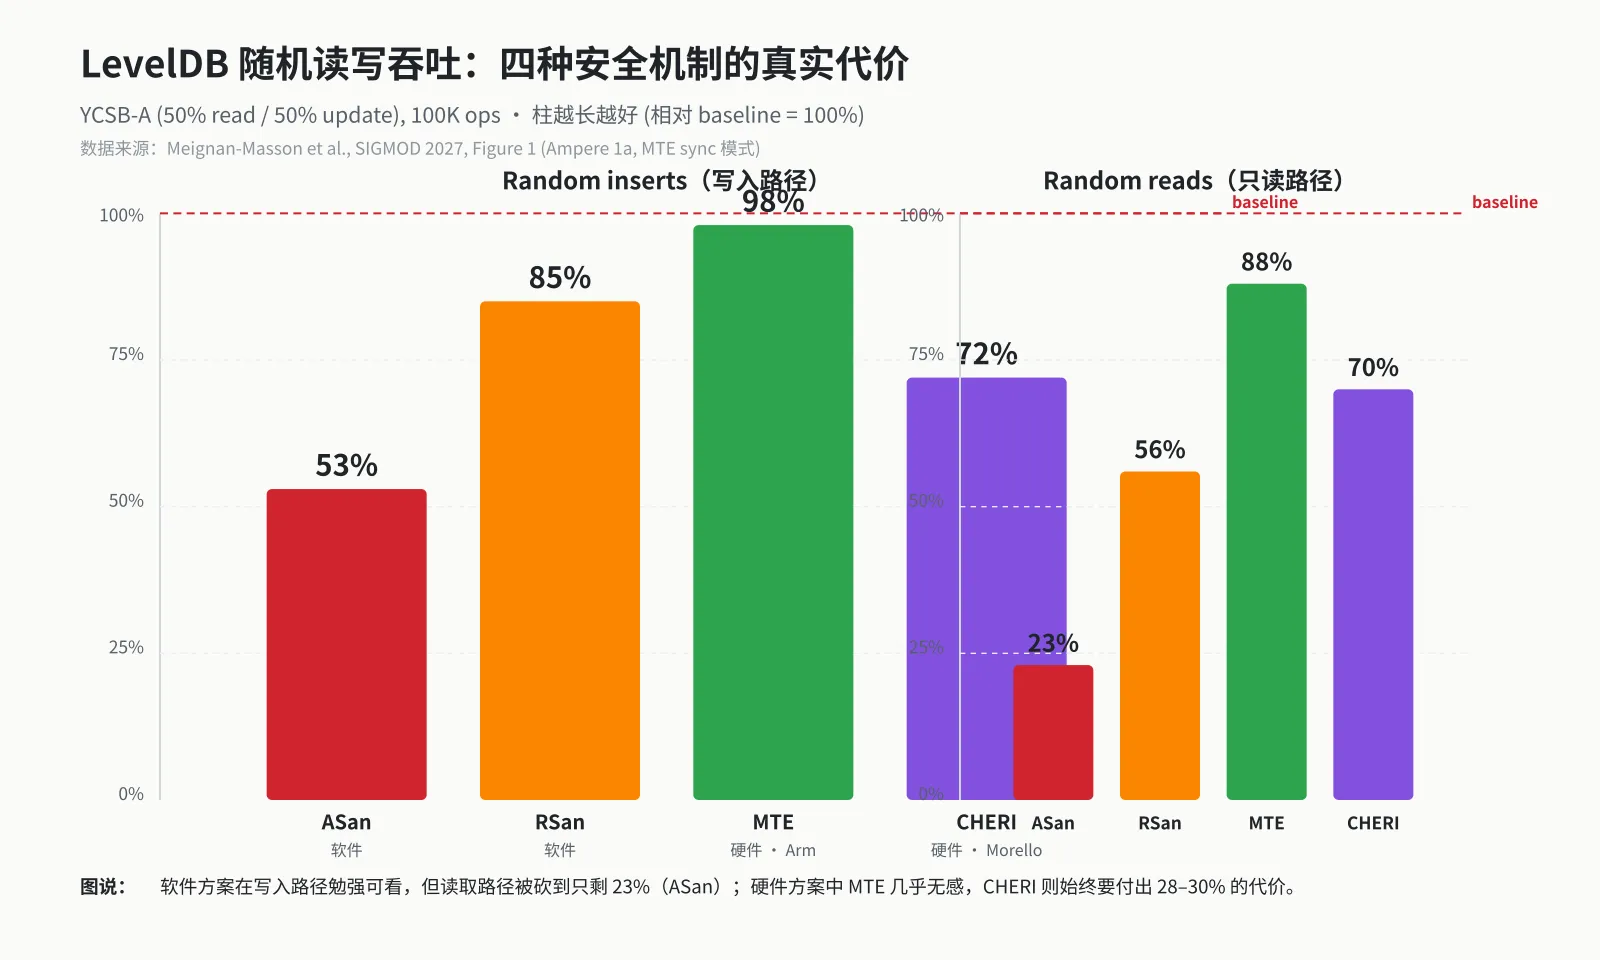
柱越长 = 越接近 baseline 性能。软件方案(ASan / RSan)在写入路径勉强可看,read 路径被砍到只剩 23%(ASan);硬件方案中 MTE 几乎无感(read 88%、insert 98%),CHERI 则始终要付出 28–30% 的代价。
图里最值得记住的对比是 read 路径 ASan 23% vs MTE 88% vs CHERI 70%。软件方案在 read 上基本不能上生产,硬件方案里 MTE 是唯一能维持 90% 以上 read 吞吐的。
六、四层评测之四:编译器、运行时、OS——两套工具链的真实差距#
这一节回答「为什么 MySQL / DuckDB 没法接 CHERI,但都能接 MTE」。论文用 Figure 13 + Table 10 把 6 个数据库编译产物的指令分布全部拆开看了。
6.1 CHERI:把 60% 以上的指令都重写了#
把 6 个库编译产物加在一起:
| 指令类别 | 占比 | 含义 |
|---|---|---|
| scbnds(set capability bounds) | 65.6% | 每次 capability 操作都要算 bounds |
| clrperm | 17.4% | 清权限(重置 capability 子域) |
| scvalue | 7.6% | 设 capability value |
| seal / gcvalue / gctag / gclen … | 9.5% | 其余能力操作 |
也就是说,CHERI purecap 编译产物的「被改写的指令」里,65.6% 都和 capability bounds 有关。再加上 ldr / str 退化成 capability 版本(176,152 条 ldr 占 26.7%、mov 15.2%、str 10.3%),整个二进制的语义都和原生 AArch64 不一样了——gdb、objdump、perf、静态分析工具全部要 capability-aware 才能读。论文 §6.1 给了个例子(图 14):LLVM 在 capability 比较时只比地址不看 tag,把不同 tag 的 capability 误当作可别名。
6.2 MTE:新指令全部活在 glibc 里#
同样的 6 个库:
| 指令类别 | 占比 | 含义 |
|---|---|---|
| irg(generate random tag) | 47.9% | 4,391 条 · 全在 glibc 分配器 |
| stg(store allocation tag) | 47.9% | 4,386 条 · 同样在分配器 |
| ldg / st2g / stz2g / gmi / stzg | 4.2% | 385 条 |
业务二进制里几乎看不到 MTE 指令。MTE 把 tag 藏在指针高 4 位(56–59),ABI 不变,依赖库不用重编。这就是为什么 MySQL / DuckDB 接 MTE 只需要改一行环境变量 + 一点点 jemalloc patch,而接 CHERI purecap 要重写整个工具链。
6.3 工具链差异的视觉对比#
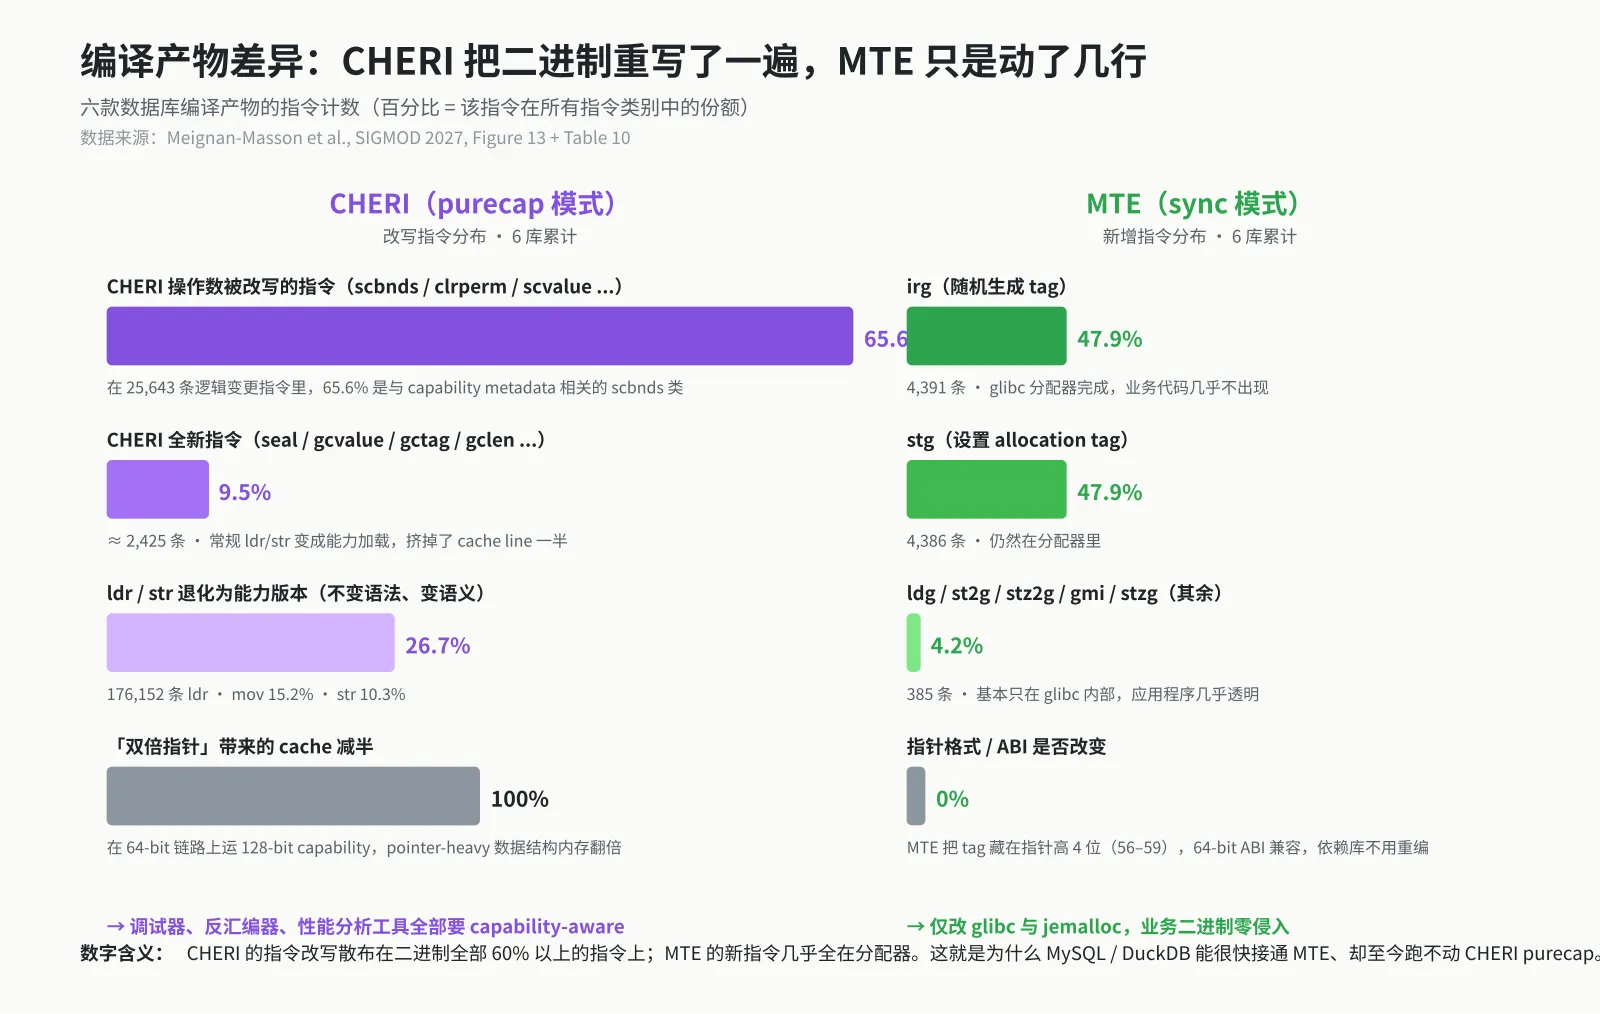
左:CHERI purecap 把 60% 以上的指令都重写了;右:MTE 的新指令几乎全在 glibc,业务代码完全透明。
6.4 一个不容回避的细节:CHERI 的 unwinding 还没跑通#
论文 §6.2 提到一个值得记下来的硬限制:purecap 模式下,stack unwinding 没法直接读返回地址处的指令——因为 PC 携带的是 execute 权限而不是 load 权限,把代码当数据访问会 fault。unwinder 必须通过 syscall 间接拿字节,这是个跨 glibc / libunwind 的工程改造。论文 B+Tree 那段没跑出多线程 CHERI 数据,原因就在这里。数据库主线编译都用 -fno-exceptions,现实里基本没事;但其它 C++ 系统就会撞到这堵墙。
6.5 MTE 的两个 OS 级硬约束#
- MTE 只能盖 anonymous mmap。file-backed mmap(数据库常用的 mmap IO)Linux 内核不给 tag。这意味着 MTE 的「保护网」目前还盖不到那些走 mmap 走 file 的 page cache;论文原话:「data must be copied into an anonymous memory region, which may result in undesirable performance and memory penalties」。
- MTE 在 Linux 上不能保护 stack 和 globals。这部分 Android 有端到端支持(编译器 + dynamic linker 全套),但 upstream Linux 还没有——意味着业务代码里如果栈缓冲区溢出,MTE 当下也抓不到。
把这节压缩成一句话:MTE 是「几乎透明的胶水」、CHERI 是「整盘手术」。
七、Database Trilemma:把这四层拼回去#
论文最后一节(§8 + Figure 16)把上面四层合到一起,提出三个 take-away:
7.1 Trilemma 三角的位置图#
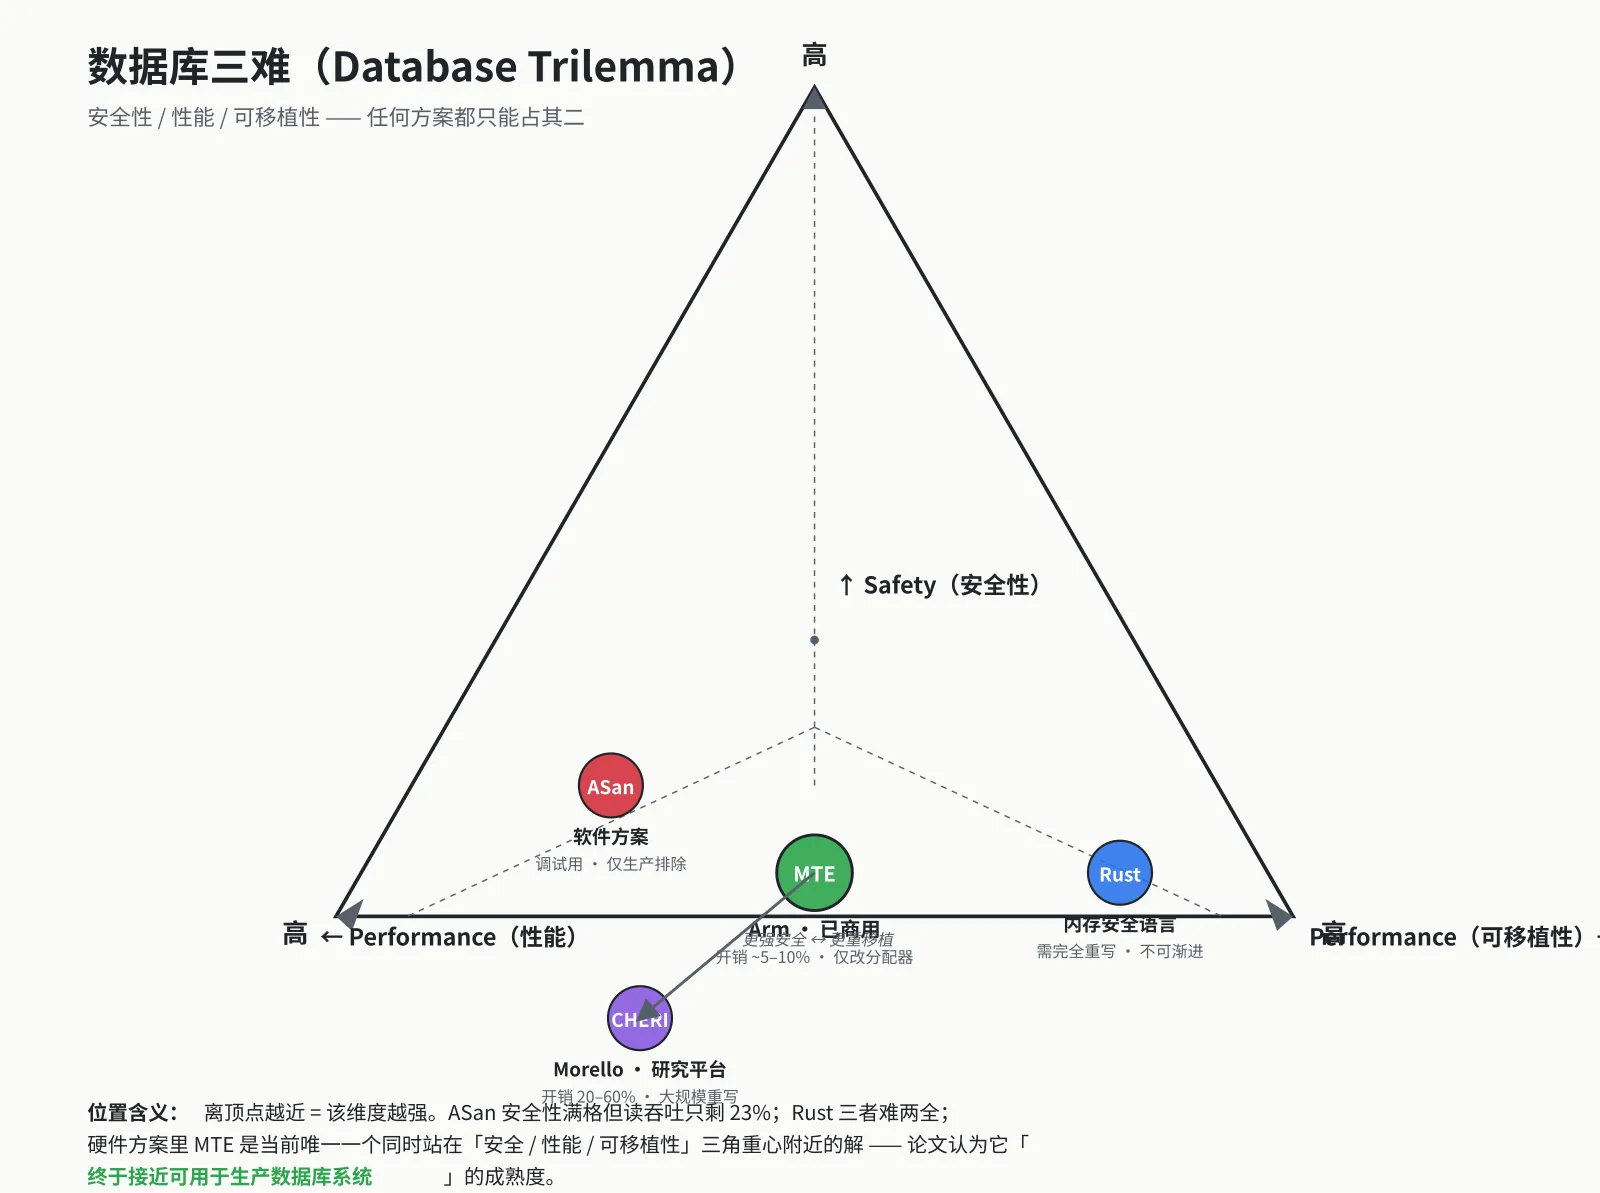
离顶点越近 = 该维度越强。ASan 安全性满格但读吞吐只剩 23%;Rust 三者难两全;硬件方案里 MTE 是当前唯一一个同时站在「安全 / 性能 / 可移植性」三角重心附近的解。
这张三角图是整篇论文最值得截图保存的一张。我重画时保留了论文 Figure 16 的核心结构(三角 + 4 个圆点),但把 MTE 那一颗圆点放大了一档——这是论文自己强调的「near-production maturity」。
7.2 Bug class 覆盖矩阵(Table 11)#
论文做了 200 次每类的最小复现,把 6 类内存安全 bug 在不同机制下的检出能力拍平:
| Bug class | Baseline | MTE | CHERI |
|---|---|---|---|
| Heap buffer overflow | ✗ | ✓ (跨对象 89%) | ✓ |
| Stack / global overflow | ✗ | ✗ | ✓ |
| OOB read / write | ✗ | ✓ (89%) | ✓ |
| Integer overflow → corruption | libc | ✓ | ✓ |
| Use-after-free | ✗ | ✓ (88%, 概率性) | ✓(需 OS revocation) |
| Double / invalid free | libc | ✓ (double-free only) | ✓ |
| Null pointer deref | OS | OS | ✓(capability fault) |
| Uninitialized memory | ✗ | ✗ | ✗ |
两个差异点很关键:
- Stack / global 上 MTE 完全看不见。这和 §6.5 的 OS 限制呼应,是 MTE 当下最显眼的盲区。
- UAF 上 MTE 是 88% 概率性,CHERI 是 deterministic 但要靠 revocation。概率性意味着快分配场景下 tag 撞车会让 UAF 漏检——论文建议加 quarantine 减少碰撞,但要付内存代价。
7.3 论文给的六条实践 take-away(Table 12 压缩)#
我把它压成六条最实用的:
- 先看读写比。 read-heavy 的 OLTP / OLAP 适合先上 MTE——read 几乎零开销。
- write-heavy 的 KVS 要小心。 CHERI 在 write-heavy workload 上 20–60%,LevelDB / Redis 这种业务模型要先评估。
- allocator 是入口。 改 jemalloc / ptmalloc 的
malloc/free加 tag 生成和清零,绝大多数 MTE 移植就完成了。 - 大对象慎用 MTE tag。 短生命周期大对象用 guard page 更划算;图 8 那条 1 KiB 拐点要记住。
- lock-free 数据结构慎用 CHERI。 atomic CAS 在 capability 模式下退化 14×,写路径不要赌。
- MTE 移植优先于纯 C 重构。 在引入 MTE 之前不要急着 Rust 化——MTE 的工作量和 ROI 都明显占优。
八、给读者的几条延展#
论文自己留了一条「未来工作」没说死的事值得读者自己琢磨:跨层之间的耦合。比如 MTE 的 16-byte granule 直接绑死了 allocator 对齐策略,而自定义分配器(MySQL / DuckDB)又恰好是性能优化里的关键武器——MTE 的「最小代价」和这些优化经常正面撞车。论文给出的取舍是「加 quarantine 减少 tag 碰撞」,但代价是内存增长。
还有一个细节作者点得也很坦诚:MySQL 安全 issue 数量偏低(2.9%),很可能是因为 MySQL 主动 redact 了安全相关 issue,导致 LLM 拿不到完整上下文。这个 bias 让他们的「bug study」更像「motivating estimates」而非「精确统计」——他们也老老实实在 limitation 里写了。
最后说回最关键的那条边:截至论文发表,MySQL / DuckDB 都没能跑通 CHERI purecap,6 个系统全部跑通 MTE。前者卡在 OpenSSL 没端口、自定义分配器语义、unwinder 实现;后者卡在「找不到一个没法接」的 DBMS。MTE 的成熟度曲线已经爬到了可以放心讨论「先在某些非关键路径上做灰度」的阶段,CHERI 的 purecap 路线则被绑死在 Morello 这块研究板上,离「用于生产」还有一段不短的距离。
如果你是数据库内核工程师:先量一下你的 workload 是 read-heavy 还是 write-heavy,再决定要不要试 MTE。 如果你是做硬件 / OS 的:CHERI 的 unwinder、ABI 兼容、allocator 改造这三座大山,是把 purecap 推到产线前必须先啃的硬骨头。
参考#
- Ilya Meignan—Masson, Martin Fink, Masanori Misono, Dimitrios Stavrakakis, Pramod Bhatotia. Should Your Database Systems Use Hardware-Assisted Memory Safety Extensions in Production? Proc. ACM Manag. Data 4, 6 (SIGMOD), Article 378, December 2026. arXiv:2610.11525 ↗ · DOI: 10.1145/3856373 ↗
- Artifact: github.com/TUM-DSE/memsafedb ↗