[论文解读] NosRacer: 用两阶段动态分析在工业级 NOS 里挖出 21 个真 race condition#
论文: NosRacer: Dynamic Detection of Race Conditions in On-Device Network Operating Systems 作者: Runze Wu, Jingbo Zhai, Shanming Ping, Lingzhi Ouyang, Hua Duan, Qin Zou, Chengcheng Huang, Bingshe Liu, Xudong Lang, Xiaoxing Ma, Yu Huang 单位: 南京大学 + 华为 会议: SIGOPS ATC 2026, 11 月 15-18, 香港 链接: https://arxiv.org/abs/2610.11875 ↗ 分类: cs.DC (分布式) + cs.SE (软件工程)
写在前面:为什么 race condition 在 NOS 里特别难抓#
生产路由器和交换机上跑的网络操作系统(NOS),不是 Linux 那种”内核加用户进程”的形态——它更像一个事件驱动的微内核:Cisco IOS XR、Juniper JunOS、华为 VRP、SONiC 这些商用 NOS,控制平面都是 200+ 个松耦合组件通过异步消息互相协作。
这种架构对 race condition 极不友好:同一组有序的配置命令,在不同的执行中可能因为消息送达顺序不同,得到完全不同的结果。论文里给了一个例子——VLAN del/add 任务,组件 MGR 顺序发 unsub_vlan 和 sub_vlan 给 ARP 组件,两条 ACK 到达的时序不同,ARP 内部的 vlan.status 可能停留在”已订阅”或”已取消订阅”,而外部观察完全一致。
更糟糕的是,这类 race condition 不会立刻表现为用户可见的异常,而是悄悄留下”订阅丢失、状态陈旧、通知错过”这些延迟暴露的副作用。到严重网络故障发生时,再去回溯根因几乎不可能。
论文作者调研了一家大型商用 NOS 在 2021~2024 的真实部署:53 个”消息时序相关”的 issue 中,27 个被确认是 race condition 引起的。这就是 NosRacer 要解决的问题。
但问题不止”难抓”——还有更难的一面:100M+ LOC、200+ 组件、每个组件 5K+ 变量、10K+ 函数。现有的两条路,静态分析和动态分析,在这个量级上都崩了。
- 静态分析:需要 over-approximate 所有可能的执行路径,组合爆炸;在工业代码上精度也低,200+ 组件相互异步消息所有可能 interleaving 根本算不出来
- 动态分析:能拿到 concrete execution 但要 cover 异步消息所有 interleaving 空间,系统执行成本炸裂
NosRacer 的破局思路是两阶段设计——用 concentration 缩分析范围,用 perturbation 提升 race 触发概率。下面展开。
一、形式化:happen-before 的 4 种边#
要检测 race condition,首先得把”什么算 race”形式化。论文给了一个针对 on-device NOS 量身定制的 happen-before 模型。
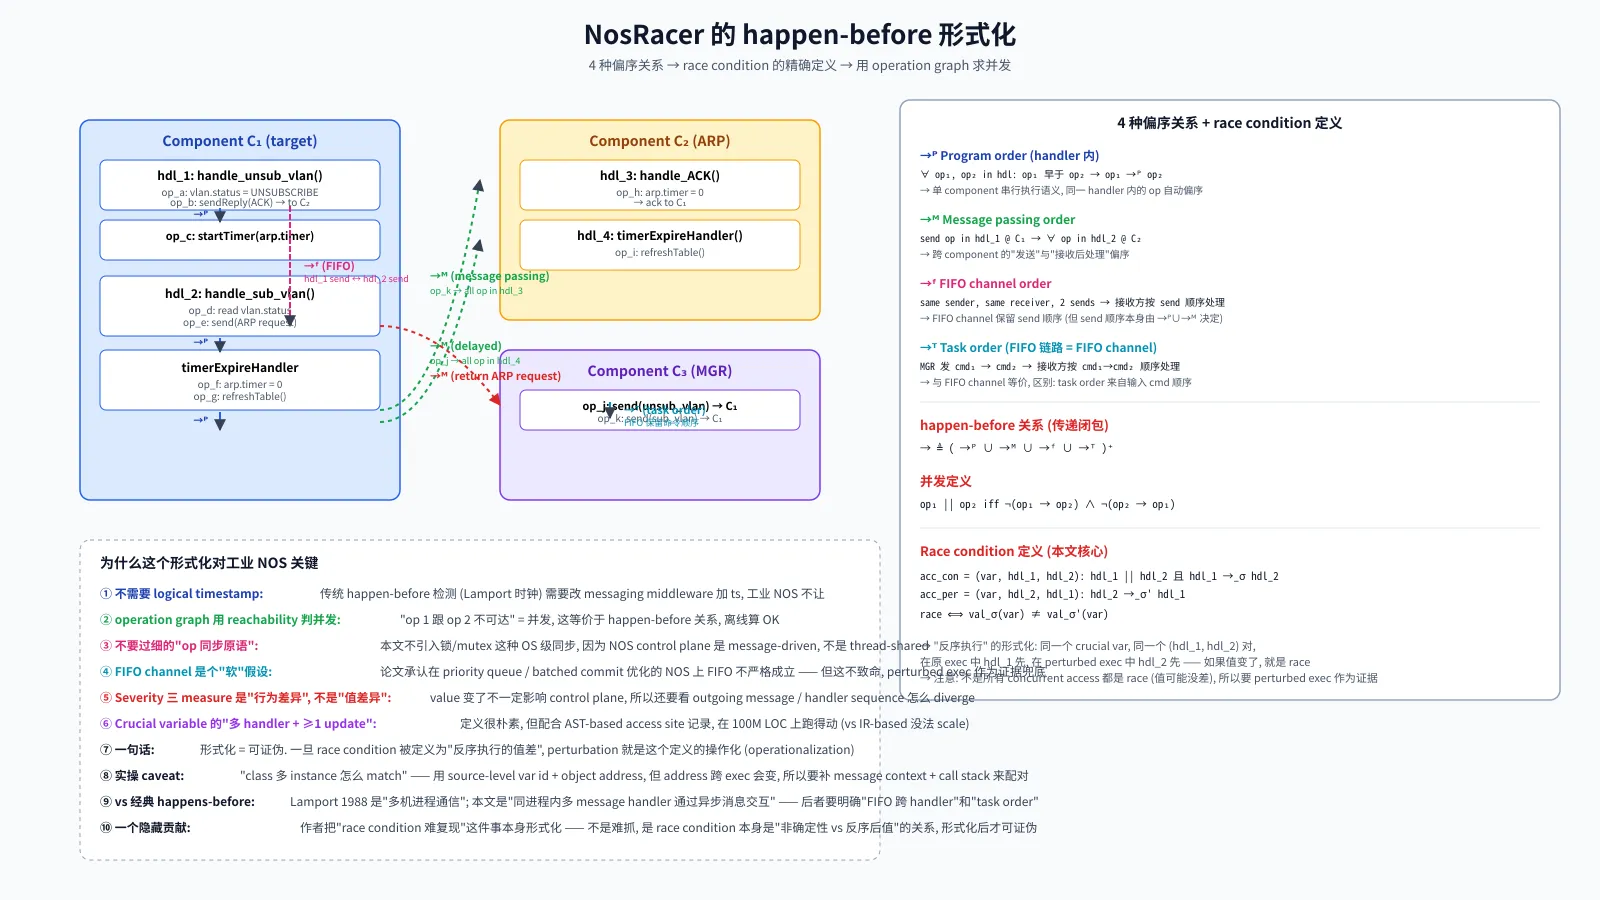
4 种偏序关系:
| 符号 | 名称 | 含义 |
|---|---|---|
| →ᴾ | Program order | 同一 message handler 内的操作按源码顺序执行 |
| →ᴹ | Message passing | send op 在 C₁ → 所有 op in 接收方 C₂ 的 handler |
| →ᶠ | FIFO channel | 同一 sender-同一 receiver 的两条 send,接收方按 send 顺序处理 |
| →ᵀ | Task order | MGR 发 cmd₁ → cmd₂,接收方按 cmd₁→cmd₂ 顺序处理 |
happen-before 关系是这 4 种的传递闭包:
→ ≜ ( →ᴾ ∪ →ᴹ ∪ →ᶠ ∪ →ᵀ )⁺并发定义:op₁ || op₂ 当且仅当两者互相都不可达(happen-before 既不成立)。
Race condition 的精确形式化#
论文的核心贡献是把 race condition 定义为”反序执行的值差”:
acc_con = (var, hdl_1, hdl_2)   # 原始 exec σ: hdl_1 →_σ hdl_2
acc_per = (var, hdl_2, hdl_1)   # 扰动 exec σ': hdl_2 →_σ' hdl_1
race ⟺ val_σ(var) ≠ val_σ'(var)这定义的妙处在于可证伪。传统 race detection 只能告诉你”这里有个 concurrent access”,但你不确定值真的会变。NosRacer 的定义是”给我两个 execution,一个是反序,值不一样就是 race”——这个能证伪,因为 perturbed exec 可以被实际跑出来当作证据交给开发者。
实操 caveat:论文承认 class 多 instance 的情况很难 match,所以用 source-level var id + object address + message context + call stack 一起配对跨 exec 的 access。这是一个工程上必须的妥协。
为什么不用 logical timestamp:传统 happens-before 检测(Lamport 时钟)需要改 messaging middleware 加 timestamp,工业 NOS 不给这个权限。NosRacer 改用 operation graph 的 reachability 离线判并发,效果等价但不侵入系统。
二、Concentration 阶段:三次筛选把分析范围缩到能跑#
核心观察(论文 §3.1 引言):在 27 个真实的 race condition bug 里,每个 task 涉及的 component 不超过 8 个,80% 不超过 5 个。换句话说,NOS 虽然有 200+ 组件,但一次配置更新任务实际只用到一小撮。
这个观察是 NosRacer 整个 framework 的 foundation。没有它,perturbation 根本跑不动——因为要在所有 200+ 组件的所有消息组合里找 race condition,interleaving 空间是天文数字。
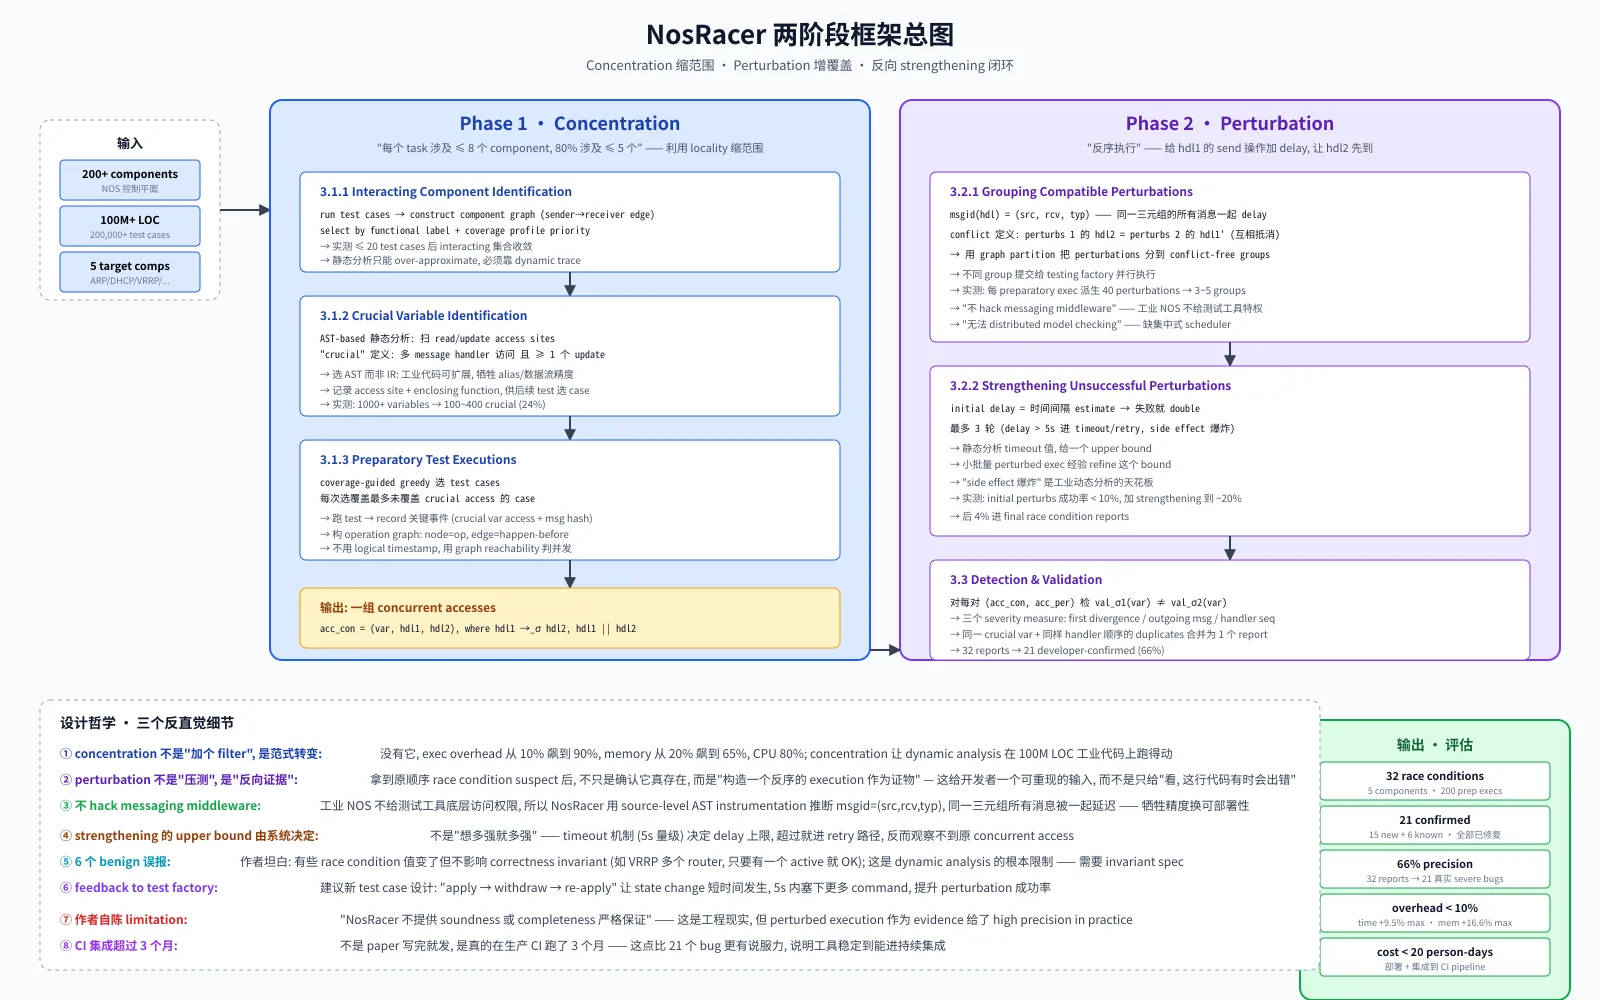
下面是 framework 总图,左边是 Concentration 三步,右边是 Perturbation 三个机制:
2.1 第一步:识别 interacting components (§3.1.1)#
方法不复杂:
- 跑少量与目标 component 相关的 test case(用 functional label 筛选)
- 用 coverage statistic 给这些 test case 排序,优先跑覆盖度高的
- 从动态执行 trace 里构造 component graph:节点是 component,有向边从消息 sender 指向 receiver
- 目标 component 的直接前驱 + 直接后继就是 interacting 集合
- 迭代加 test case 直到这个集合收敛——论文说不超过 20 个 test cases 就收敛
这里有一个关键的设计取舍:纯静态分析不够。原因不是”静态分析做不了”,而是”组件间的交互很大程度上取决于运行时消息路由、系统状态、异步执行顺序”。静态分析只能 over-approximate 出一个过大的集合,反而失去缩放收益。所以 NosRacer 用动态 trace 来精确定位 interacting components。
2.2 第二步:识别 crucial variables (§3.1.2)#
一个 component 通常有 1000+ 变量,但跟 race condition 相关的可能就几十到几百个。crucial variable 的定义是:
多个 message handler 访问且至少一个是 update 操作。
识别方法用的是AST-based 静态分析(而不是 IR-based)。论文给的 trade-off 是:
- AST-based:保留源码结构,工程和计算成本低,可扩展到工业级代码库;但 alias、跨过程数据流、同步原语精度有限
- IR-based:能精确推理语义,但在百万行生产系统上部署和分析成本过高
100M LOC 的工业 NOS,可扩展性比精度更重要。这是一个工程现实的妥协——精度损失的部分由后续 perturbation 的”反序证据”兜底。
每个识别出的 variable 还要记录:access site + enclosing function + 运行时 instance 标识。运行时 instance 用 source-level var id + object address 区分(跨 exec 时 object address 会变,所以补 message context + call stack)。
2.3 第三步:preparatory test executions (§3.1.3)#
有了 component 集合和 crucial variable 集合,接下来是跑预备执行:
- 用 coverage 信息从 test case 库里贪心挑选——每次选覆盖最多未覆盖 crucial access site 的
- 跑 test,记录关键事件(crucial var 的 read/update + message hash)
- 构造 operation graph:节点是 op,有向边是 happen-before
- 不用 logical timestamp,用 graph reachability 离线判并发
- 检出所有 concurrent accesses → 输出给 Perturbation 阶段
实测每个 component 跑 200 个 preparatory executions,每次派生平均 40 个 perturbations。
2.4 缩放效果(Table 6 关键数据)#
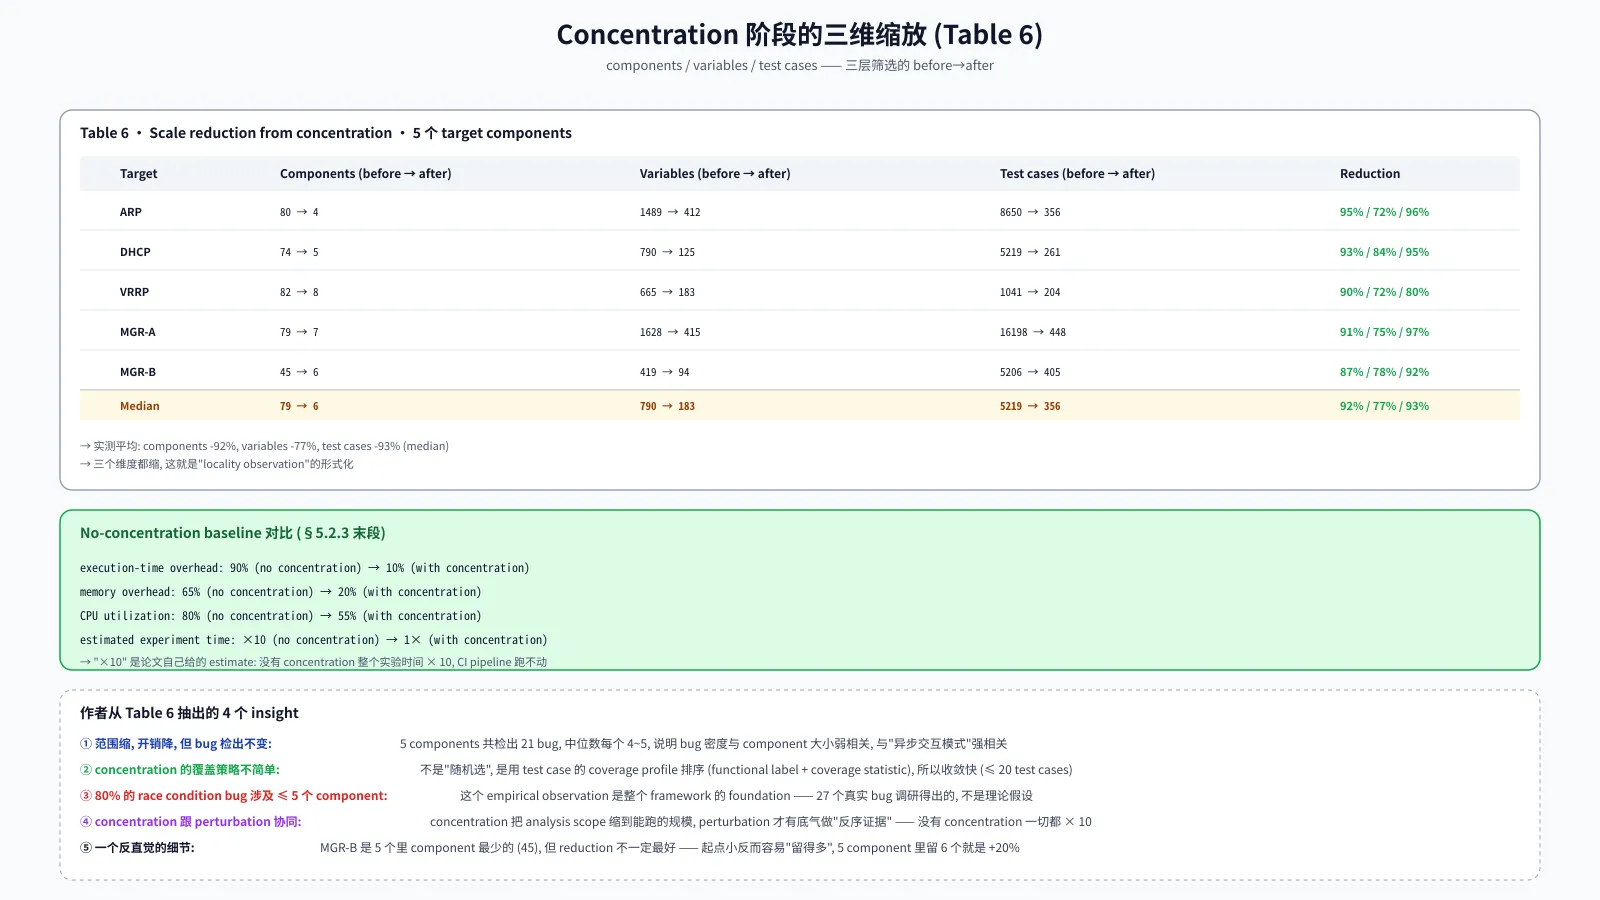
下面是 Concentration 在 5 个目标 component 上的实测效果:
| Component | Components (前→后) | Variables (前→后) | Test cases (前→后) |
|---|---|---|---|
| ARP | 80 → 4 (95%) | 1489 → 412 (72%) | 8650 → 356 (96%) |
| DHCP | 74 → 5 (93%) | 790 → 125 (84%) | 5219 → 261 (95%) |
| VRRP | 82 → 8 (90%) | 665 → 183 (72%) | 1041 → 204 (80%) |
| MGR-A | 79 → 7 (91%) | 1628 → 415 (75%) | 16198 → 448 (97%) |
| MGR-B | 45 → 6 (87%) | 419 → 94 (78%) | 5206 → 405 (92%) |
| Median | 79 → 6 (92%) | 790 → 183 (77%) | 5219 → 356 (93%) |
三维同时缩,中位数:components -92%, variables -77%, test cases -93%。
没有 concentration 是什么样子?论文自己给的 baseline 对比:
execution-time overhead:    90% (no)   →   10% (with)
memory overhead:           65% (no)   →   20% (with)
CPU utilization:           80% (no)   →   55% (with)
estimated experiment time: ×10 (no) → 1× (with)×10 是论文自己给的 estimate:没有 concentration,实验时间 × 10,CI pipeline 根本跑不动。这就是为什么”locality observation”不是 nice-to-have,而是整个 framework 能落地的核心前提。
三、Perturbation 阶段:主动构造反序执行作为证据#
核心思想:拿到一组 concurrent access 之后,不停留在”这里可能 race”,而是主动构造一个反序的 execution,如果反序后值变了,就是 race,而且这个反序 exec 可以作为可重现的输入交给开发者。
3.1 Perturbation 的具体动作(§3.2 引言)#
给定 concurrent access acc_con = (var, hdl_1, hdl_2),在原始 exec σ₁ 中 hdl_1 →_σ₁ hdl_2。Perturbation 的目标:构造 perturbed exec σ₂,使得 hdl_2 →_σ₂ hdl_1。
实现方法:给 hdl_1 的 message-sending 操作注入一个 delay。这样 hdl_2 就有更大概率在 hdl_1 之前处理完,从而拿到反序。
两个约束条件必须满足:
- 任务输入(命令顺序)保持不变
(hdl_1 →_σ₁ hdl_2) ∧ (hdl_2 →_σ₂ hdl_1)
Race condition 确认:在 perturbed exec 中,如果 val_σ₂(var) ≠ val_σ₁(var),就是 race。
3.2 Grouping compatible perturbations(§3.2.1)#
工业 NOS 缺一个关键能力:没有中心化调度器可以精确控制消息的延迟,也无法 hack messaging middleware(工业代码不给测试工具底层访问权限)。所以 NosRacer 只能在源代码层 instrument,通过识别 message-sending 点,在前面插入 delay 代码。
这带来一个精度损失:
在 source-level,一次 send 操作可能产生多个运行时消息实例(不同 runtime context 触发)。所以 source-level instrumentation 只能延迟”一组”消息,而不是”单条”。
论文用一个三元组标识:
msgid(hdl) = (src, rcv, typ)所有 (src, rcv, typ) 相同的消息会被一起延迟。
这是 NosRacer 的核心工程妥协:为了可部署性,牺牲了单消息级别的精度。
接下来是 grouping 阶段。多条 perturbation 可能有冲突:
如果 perturbation 1 要 delay 的
hdl_2恰好是 perturbation 2 要 delay 的hdl_1',两次 delay 互相抵消(都让对方先到,等于没做)。这种 perturbation pair 是 conflicting 的,不能放在同一个 test exec 里。
算法是把所有 perturbations 分成互相兼容的 groups:
- 同 group 内两两 compatible(不冲突)
- 不同 group 之间独立,提交给 testing factory 并行执行
论文实测:每个 preparatory exec 派生 40 个 perturbations,平均只分成 3~5 个 conflicting groups。这意味着大部分 perturbation 是可以 batch 的,系统开销不会爆炸。
3.3 Strengthening unsuccessful perturbations(§3.2.2)#
不是每次 perturbation 都能成功拿到反序 exec。失败的 perturbation 怎么办?
Adaptive strengthening:把 delay 翻倍,重跑。最多 3 轮。
为什么是 3 轮而不是无限? 这里有个工业动态分析的天花板——delay 的 upper bound 由系统的 timeout 机制决定。论文观察到:
当 delay 超过约 5 秒,系统会进入 timeout / retry 路径。这时候 perturbed exec 已经”跑偏”了——不再是原 concurrent access 的扰动,而是”在 timeout 压力下的另一个行为”。反过来,NosRacer 还观察不到原来的 concurrent access 了。
所以 strengthening 的 upper bound 是由系统决定的,不是”想多强就多强”。论文同时用静态分析 timeout 值和小批量 perturbed exec 经验估计来 refine 这个 bound。
3.4 Detection & Validation(§3.3)#
Perturbation 拿到 paired (acc_con, acc_per) 之后,做三件事:
- 确认 race condition:对比两个 exec 中同一 crucial var 的值,如果不等,报告
- Severity 评估:三个 measure——
- First point of divergence:原 exec 和 perturbed exec 最早出现行为差异的位置(给开发者定位起点)
- Outgoing-message sequence divergence:受影响 component 后续发出的消息序列差异(影响范围)
- Message-handler sequence divergence:消息处理函数调用序列差异(执行路径)
- 合并重复:同一 crucial var + 同一 (hdl_1, hdl_2) pattern 的 race condition 合并为 1 个 report
注意:没有 strict soundness 或 completeness 严格保证——这是论文自己坦白的。但 perturbed execution 作为 evidence 给了 high precision in practice(实测 66% 精度)。
3.5 Perturbation 成功率的问题#
论文坦白:即使加了 3 轮 strengthening,只有 19% 的 concurrent accesses 能成功配到 perturbed access(157 out of 824)。
为什么这么低?作者检查了时间间隔分布:
- < 10% 的命令间隔在 1~5 秒
25% 在 510 秒- > 60% 超过 10 秒
长间隔等于”扰不动”——delay 注入影响有限,而且容易被系统本身的 timeout 机制吞掉。论文提出的解决方向:写新的 test cases 把状态变化塞进短时间窗口,比如 “apply → withdraw → re-apply” 模式。这是给测试工程师的具体建议,不是工具的承诺。
四、Evaluation:21 个真 bug 的实证#
实验对象是一家商用、正在开发中的 on-device NOS——具体品牌论文里没明说,只说”a commercial, actively developed NOS”。每个 component 超过 50 万行代码,testing factory 提供超过 5000 个相关配置更新 test case。
4.1 总体数据(Table 2 + Table 3)#
| Target | #CAs | Init. PAs | Final PAs | Reports | Prep. Execs | Pert. Execs |
|---|---|---|---|---|---|---|
| ARP | 173 | 21 (12%) | 38 (22%) | 8 (5%) | 200 | 711 |
| DHCP | 127 | 8 (6%) | 18 (14%) | 5 (4%) | 200 | 686 |
| VRRP | 154 | 16 (10%) | 27 (18%) | 6 (4%) | 200 | 716 |
| MGR-A | 231 | 19 (8%) | 49 (21%) | 7 (3%) | 200 | 710 |
| MGR-B | 139 | 11 (8%) | 25 (18%) | 6 (4%) | 200 | 651 |
| Total | 824 | 75 (9%) | 157 (19%) | 32 (4%) | 1000 | 3474 |
CAs 是去重后的 concurrent accesses;PAs 是配上 perturbed access 的 CAs。
几个关键数字:
- 824 → 32 (4%):大部分 concurrent access 在扰动后值不变,被过滤掉
- Initial 9% → Final 19%:strengthening 把 perturbed access 配对率从 9% 提到 19%
- 5 components × 200 prep execs = 1000 次预备执行,总时长 65.19 小时
- 3474 次 perturbed execs,总时长 314.02 小时
- 单次 prep 3
5 分钟,单次 perturbed 56 分钟 - 每个 component 整个扰动规划 < 1 天,没有 concentration 是 ×10
4.2 32 个 reports → 21 个确认(66% 精度)#
开发者评审结果:
- 15 个新发现的 race condition(之前没人知道)
- 6 个已知但 open 的(最近上报还没修)
- 21 个全部已修复
精度 66% 听起来不算特别高,但论文强调:“21 个确认 = 21 个开发者签字认账的 severe bug”。32 个 reports 中 11 个被分类为 benign,下面 §5.3.1 会详细讲为什么。
4.3 Severity 的 3 个 measure(§3.3)#
论文给了具体例子:ARP#1 是图 1/图 2 的 motivating example,场景是 VLAN del/add:
- Crucial variable:
vlan.status(subscription state) - Task: 取消订阅然后重新订阅
- 扰动后:第二条 sub_vlan 因为读到陈旧的”已订阅”状态被忽略,ARP 错误地处于”已取消订阅”
- Severity:outgoing message sequence divergence(“add request skipped”)
- Consequence:interface unsubscribed(VLAN 接口无法转发包)
- Status:new/fixed
每个 bug 报告都按三个 measure 评估,这样开发者能直接定位:
- “行为从哪里开始不一致”(first divergence)
- “不一致怎么传播到下游 component”(outgoing message)
- “组件内执行路径怎么变了”(handler sequence)
21 个 bug 都有具体的 outgoing-message / handler-sequence 差异证据,这是 perturbed execution 作为”可重现输入”价值的体现——开发者拿到的不是”看, 这行代码有时会出错”,而是”看, 这个测试输入能 100% 复现这个 bug”。
4.4 Overhead 数据(Table 4 + Table 5)#
启用 NosRacer tracing 的开销(对未启用 baseline 的相对值):
| Target | Time Δ | Mem Δ | CPU Δ |
|---|---|---|---|
| ARP | +6.8s (+2.8%) | +543MiB (+6.3%) | +0.3 |
| DHCP | +1.4s (+0.6%) | +334MiB (+3.9%) | +0.5 |
| VRRP | +13.9s (+7.4%) | +1397MiB (+16.6%) | +1.7 |
| MGR-A | +22.2s (+9.5%) | +1080MiB (+12.8%) | +7.4 |
| MGR-B | +2.1s (+0.8%) | +1005MiB (+11.9%) | +3.0 |
| Median | +6.8s (+2.8%) | +1005MiB (+11.9%) | +2.5 |
- Time overhead < 10%,内存 < 20%,CPU 增加 < 10 个百分点
- 实测可以集成到现有 testing factory,3 个月生产 CI 验证
- 每个 component 部署 < 30 分钟 + < 20 person-days 总成本
Offline trace analysis 开销:
- 单次 exec trace 10.4MB (median)
- 单次分析 22.5 秒
- 摊到每个 report 上 trace 120.8MB / 7.9 分钟(中位)
- 跟预备 + 扰动几十小时的执行时间相比几乎可以忽略
五、Discussion:作者自己讲的 4 个 limitation#
论文 §5.3 不是粉饰太平的”future work”,而是作者明确承认的边界。这一节是全文最有学术诚意的地方。
5.1 Benign race conditions(§5.3.1)#
32 个 reports 中,21 个确认 severe bug,11 个被分类为 benign。不是工具精度问题——是 race condition 本身有时候值变了但不影响 correctness。
作者归纳了两类原因:
第一类:正确性不变量本身是”模糊的”。比如 VRRP switchover 任务[30],多个物理路由器配置成同一个虚拟路由器共享一个虚拟 IP,正确性不变量是”恰好有一个是 active”。一个 router 上 role 值变了,如果组里仍然只有一个 active,开发者就认为这是 benign。
第二类:周期性同步/重试会”自我修复”。有些 component 用定时同步或 retry 跟上游/configuration database 保持一致。值变了可能造成一个短暂的中间异常状态,但后续同步会重写这个变量、恢复正常。开发者不把它当 bug。
解决方向:论文建议 offline analysis 提供一个invariant specification interface,让开发者声明”我对哪些变量声明了哪些 invariant”,然后用这些 invariant 过滤 benign report。这跟 model checking 里 user-provided invariant 思路一致——dynamic analysis 没法自己判断”值变了严不严重”,必须借 domain knowledge。
5.2 Perturbation effectiveness 瓶颈(§5.3.2)#
只有 19% 的 concurrent access 能配上 perturbed access(157 / 824)。
核心瓶颈是时间间隔太长:> 60% 的命令间隔 > 10 秒。delay 注入在这种长间隔下影响有限,而且容易进 timeout 路径。
论文提出的测试设计建议(不是工具承诺):
写新的 test case 把状态变化塞进短时间窗口。比如 “apply → withdraw → re-apply” 模式,让 3 个命令在 < 5 秒内执行完。这样 NosRacer 才有 perturb 的余地,side effect 也可控。
这个建议很工程——不是”我给你一个 magical perturbation”,而是”你给我写更好的 test case”。
5.3 工具自身的限制(§3.4 讨论)#
作者主动列了 3 个 simplification:
- 只监控 simple crucial variables——不处理复杂数据结构(链表、树、数据库 entry)作为 race condition 主体
- 不监控跨 component invariant / configuration consistency——只能看 crucial var + 行为差异,不能看”这两个 component 状态不一致但 var 没变”
- 只扰动消息 delay——不能 controlled message reordering(整条消息换顺序),也不能依赖 messaging middleware runtime support
作者明说:“enhancing the perturbation mechanism 需要 a broader assessment of its system-wide impact”——这是真不知道有多难,不是搪塞。
5.4 不严格 sound / complete(§3.3 末段)#
“In real-system deployments, NosRacer does not provide strict soundness or completeness guarantees.”
直白讲就是:漏检不可避免,误报不可避免。论文没有装作这是个形式化验证工具。但 perturbed execution 作为 evidence 让 precision 达到 66% in practice——这是”工程上够用”的论证,不是”理论上严格”的论证。
做工程的人都懂这个:对 100M LOC 工业系统谈 soundness,跟对编译器谈”绝对不 crash”一样不现实。能给的是”在 21 个真 bug 上有用,在 production CI 跑了 3 个月不挂”——这已经够强了。
六、对我的启发:工程现场的几个反思#
读这篇论文让我重新理解了 3 件事:
6.1 “Locality”是 dynamic analysis 能 scale 的根本#
不是算法优化,不是 IR/LLVM 加速,不是并行化——是对问题域的 empirical observation 拯救了这件事。论文第一句观察(“每次 task 涉及 ≤ 8 个 component”)就决定了 framework 的形态。
这个观察的来源也很工程:对 27 个真实 bug 的分析,不是从理论推出来的,是从生产事故数据库里数出来的。这种”先去看 27 个 bug 长什么样,再设计工具”的方法论,跟”先写 paper 假设一个 framework 再去找证据”是反过来的。
6.2 “Perturbation as evidence”是 dynamic analysis 的可证伪性#
传统 race detection 是”我怀疑这里 race”,开发者拿到的报告是”这里有 concurrent access,可能 race”,然后开发者要花时间验证。
NosRacer 是”我证明这里 race,因为我构造了一个反序 exec 而且值真的变了”。这个反序 exec 是可重现的输入,开发者能直接拿去回归测试。
这种”工具不仅指出问题,还提供可重现输入”的设计,是 production-grade 工具的核心标志。它把”分析工具”和”测试用例生成”合并成了一件事。
6.3 “不 hack 底层”是工业可部署性的灵魂#
NosRacer 反复强调:
- 不改 messaging middleware(不给权限)
- 不假设中心化调度器(distributed model checking 的标配)
- 用 AST 而非 IR(因为 IR 部署成本高)
- 用 source-level instrumentation(而不是单消息精确控制)
每一条都”我能做得更精确,但我选择不做”。理由都是同一个:工具必须能部署到生产 CI,精度不够的部分用 perturbed execution 兜底。
这种”克制”是工业系统研究者最稀缺的能力——学术 prototype 喜欢追求精度,生产工具必须追求可部署。NosRacer 在两者之间找了一个 sweet spot。
七、一些零碎但重要的细节#
- 3 个月生产 CI 部署 — 论文不是”实验室跑通”,是真的在生产管道跑了 3 个月。这点比 21 个 bug 更有说服力,说明工具稳定到能进持续集成
- 成本 < 20 person-days — 整个 framework 部署 + 集成到 5 个 component + 跑 3 个月 < 20 person-days,这个数字很真实(不是”3 年研究项目”)
- 9,000 行 C/C++ + 25,000 行 Python — 实现量级。Clang-based source instrumentation(9000 行)做 runtime tracing,Python(25000 行)做 offline analysis
- 作者会扩到其他 NOS — 论文末尾说”applying NosRacer to more control-plane components in our target NOS, as well as to other production NOSes having similar architecture”——SONiC 这种开源 NOS 大概率是下一个目标
- 附录里有详细的 testing factory 描述 + orchestrator workflow — 论文 18 页,正文只占 12 页,附录 6 页描述怎么落地。这是工程 paper 的标志,不是”丢个公式就完事”
八、结语#
NosRacer 这篇论文让我对 race condition detection 有了三个新认识:
- 形式化不是目的, 可证伪才是目的。把 race condition 定义为”反序执行的值差”——这个定义不是为了学术漂亮,是为了让 perturbed exec 能作为可重现证据交给开发者
- Locality observation 是 dynamic analysis 能 scale 的根因。不是算法,是 empirical fact(每次 task ≤ 8 component)决定 framework 形态
- 不 hack 底层 + 牺牲精度换可部署。这是工业生产 CI 跟学术 prototype 的根本分水岭
对一个 100M+ LOC、200+ component、5K+ 变量/component 的工业 NOS,21 个开发者签字的 severe bug、66% precision、< 10% overhead、3 个月生产 CI 验证——这不是 paper 数字,是部署成果。
读这篇论文学到的不只是 race condition detection,还有**“工程上怎么把动态分析做到生产可用”**这个更大的命题。
附录 · 论文关键信息#
- arXiv: https://arxiv.org/abs/2610.11875 ↗
- DOI: https://doi.org/10.1145/3828523.3857055 ↗
- 会议: SIGOPS ATC 2026, 11 月 15-18, 香港
- 提交日期: 2026-10-08 v1 (412 KB)
- 作者单位: 南京大学(State Key Laboratory of Novel Software Technology)+ 华为
- 代码规模: 9,000 行 C/C++ + 25,000 行 Python
- License: CC BY-NC-ND 4.0
论文主要贡献(原文摘要)#
- 提出 NosRacer——一个针对工业级 on-device NOS 的 race condition 动态分析框架
- 实现并集成到现有 testing factory,CI 跑 3 个月
- 在 5 个 component 上检出 21 个 confirmed bug(15 new + 6 known),全部已修复
- 精度 66%,overhead < 10%,cost < 20 person-days
关键数据快查#
- 5 components × 200 prep execs = 1000 次预备执行,总时长 65.19 小时
- 3474 次 perturbed execs,总时长 314.02 小时
- 824 → 157 (19%) → 32 reports → 21 confirmed (66%)
- concentration 缩放: components -92% / variables -77% / test cases -93% (median)
- overhead: time +2.8% / mem +11.9% / CPU +2.5 (median)
- 21 个 bug 涉及 ARP/DHCP/VRRP/MGR-A/MGR-B 5 个 component,每个 4~5 个 race condition