深入解析 openai/math:一个模型产出的 719 篇数学论文怎么管理
💬 评论openai/math 不是代码库,是一个内部数学研究模型产出的 719 篇论文 + 300 个 Lean 形式化 + 2026-10-07 的真实撤稿事件。从 17 学科 / 372 家族 / 4 阶段流水线 / 形式化率 42% 这套组织学里,能读出 AI 时代学术仓库的标准做法。
仓库:github.com/openai/math ↗ · 概览:overview.pdf ↗ · Apache-2.0 · 最后更新 2026-10-07 719 manuscripts / 372 families / 300 个 Lean 形式化(~42%) / 17 个学科
接到这个仓库的时候,我心里想的是”再一个有趣的工程库”。但点开 README 第一段就发现不是:
“This repository contains mathematical manuscripts and supporting proof artifacts produced by an internal OpenAI model.”
这是一个论文仓库,不是代码仓库。根目录就 5 项:README.md + CONTENTS.md(638KB) + history.md + LICENSE + lean/(Lean 形式化库)。tarball 拉下来 2.1GB 解压,因为 preprints/ 下面有 718 个 PDF,每个 ~1-3MB。
这件事的”工程感”不在代码,在一个 AI 模型产出了 719 篇数学论文之后,你怎么管理它。我把这仓库拆完一遍,觉得最值得讲的不是任何一篇论文本身,而是围绕它设计的那套仓储、组织、撤稿、形式化机制——它可能是 2026 年最值得看的”AI 时代学术仓库的样板”。
下面这几章,不是论文解读,是仓库学笔记。
一、为什么这不是一个工程仓库#
我先解释为什么 2.1GB 的东西你得换一个脑子看。
openai/math 的顶层没有 src/、没有 package.json、没有 tests/、没有 docs/(除了 markdown 论文索引)。它长这样:
openai-math/
├── README.md              # 4KB,仓库目的 + 家族数
├── CONTENTS.md            # 638KB,论文总目录(HTML 表)
├── history.md             # 2KB,撤稿与修订记录
├── overview.pdf           # 317KB,家族分类总览
├── LICENSE                # Apache-2.0
├── preprints/             # 718 个目录,每个 1 篇论文(PDF + README + bib)
├── reasoning_traces/      # 10 个 PDF,模型的思考摘要
└── lean/                  # Lean 形式化库 + OAI.lean 入口
    ├── OAI.lean           # 914 行,全是 import
    ├── OAI/               # 按学科分的形式化
    ├── ComparatorChallenges/
└── formalization.yaml # 79KB,300 个形式化项的引用跟 REA / litellm / raddebugger 这种”代码 + CLI + 桥”完全不是一类。前者是 artifact 仓库,后者是 runtime 仓库。一个装的是”已经生产出来的东西”,一个装的是”会运行的东西”。
artifact 仓库的关注点也不同:
- 可追溯:每篇论文要能回到生成它的输入(题目 / 思考 trace)
- 可验证:Lean 形式化要能机器查,但不是全部
- 可撤稿:模型会出错,出错要公开处理
- 可组合:多个 manuscript 聚成 family,family 之间能引用
这套东西要写在 2026 年的论文仓库里,得显式建模——因为 AI 模型的”自信但错”是默认行为,而不是意外。下面 7 章,围绕这个展开。
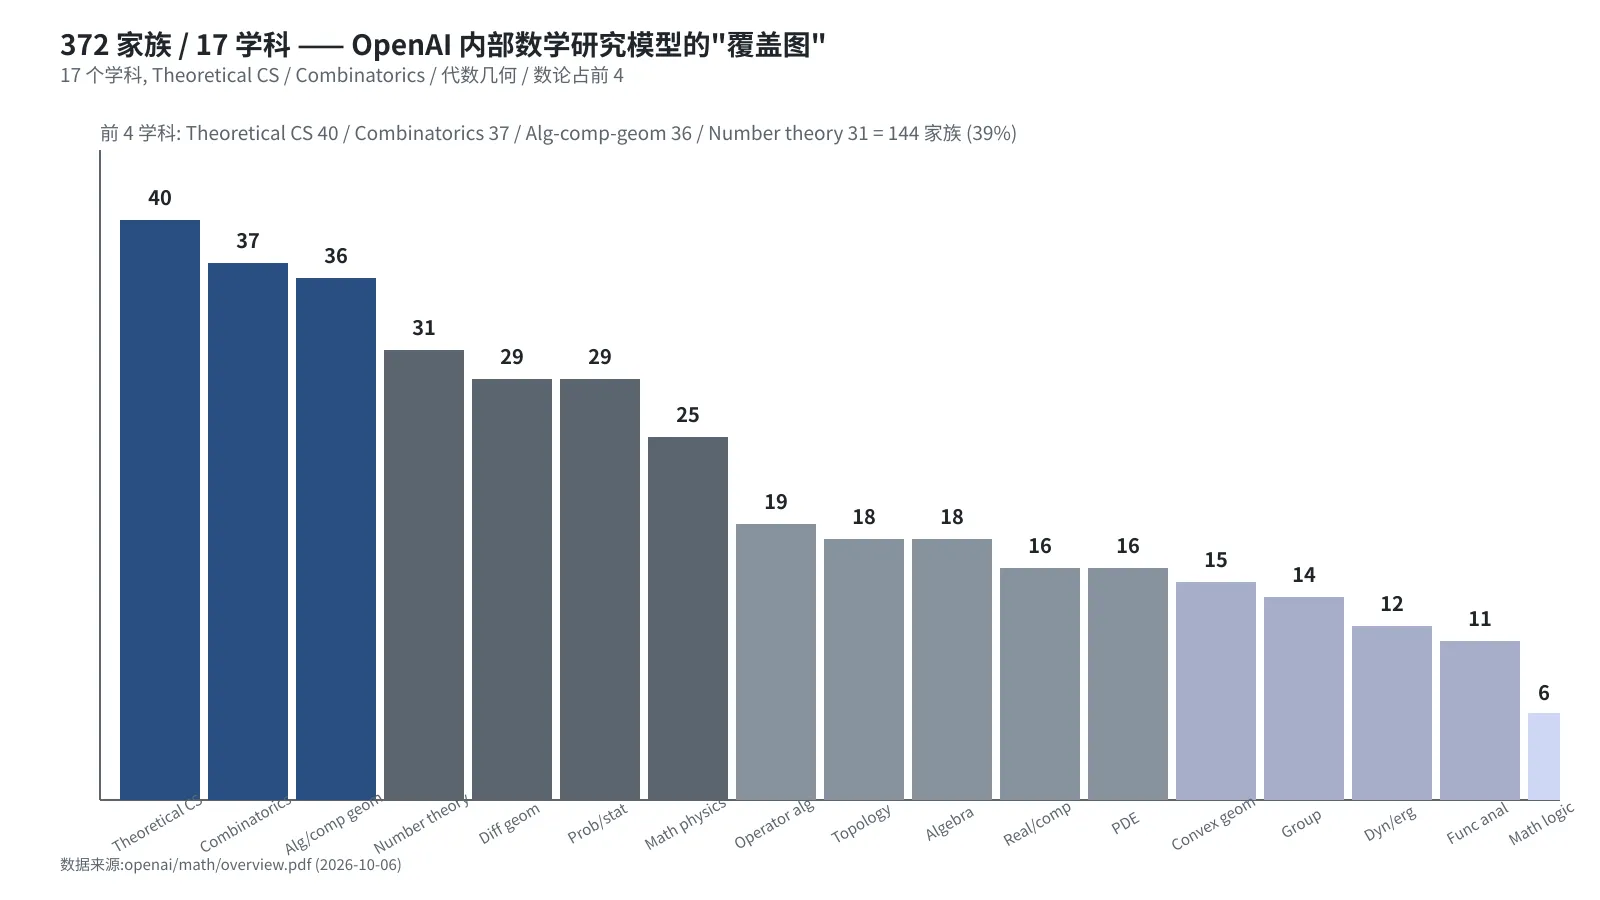
二、719 篇论文按 17 个学科分,真正”硬骨头”占多数#
我打开 overview.pdf 第一眼就愣了——分类不是按”模型擅长什么”分的,是按数学学科分的:
- Theoretical CS:40 家族(最多)
- Combinatorics:37
- Algebraic & complex geometry:36
- Number theory:31
- Differential geometry / Probability / Mathematical physics:各 25-29
- Operator algebras / Topology / Algebra:各 18-19
- Real & complex analysis / PDE:各 16
- Mathematical logic:6(最少)
前 4 学科(TCS / 组合 / 代数几何 / 数论)就占了 144 家族(39%)。这不是巧合——这三个领域恰好是过去十年数学界最活跃的”猜想被推翻 / 边界被推进”的地方,也是 AI 模型能在有限题目集里产出有意义结果的地方。
我专门翻了几个家族描述,挑几个给你看:
- Family 002 —— “The full Birch–Swinnerton-Dyer formula in Selmer coranks zero and one”。完整版 BSD 公式,在 Selmer corank ≤ 1 时,对每个 ℚ 上椭圆曲线成立,包括 Tate–Shafarevich 群有限。
- Family 003 —— “The quasi-Riemann hypothesis”。证 Re(s) > 7/8 是 ζ(s) 的无零点半平面,另一篇给 Re(s) > 11/12 的不同证明。
- Family 005 —— “Irrationality of Catalan’s constant”。证 Catalan 常数 G 是无理数。
- Family 009 —— “Bogomolov–Pop and Milnor K-theoretic reconstruction”。从 K₁ᴹ/ℓ, K₂ᴹ/ℓ 及其乘积重建函数域。
- Family 014 —— “Restricted geometric Langlands, generic Ramanujan and Arthur parameters”。几何 Langlands 在正特征下的受限等价,这一个家族有 8 篇 manuscript,是全集里最大的。
- Family 017 —— “The irrationality exponent of π is 2”。π 的无理性指数恰好是 2。
- Family 032 —— “The rational Hodge conjecture for CM abelian varieties”。CM 阿贝尔簇的有理 Hodge 猜想。
注意 007——“Two-point Chowla and the corrected binary Elliott conjecture”。这是 multiplicative functions 的两点关联,被数学家研究了很多年。OpenAI 模型给了一个有 Liouville 关联求和的 O(X/(log X)ᶜ) 界,这是数学家会停下来细看的东西。
这些题目不是高考题,不是 IMO,不是 AIME。IMO/AIME 那一档模型早就能做完了,OpenAI 选的是”研究级开放问题”。README 原话:
“We expanded these evaluations after performance on our existing mathematical evaluations saturated.”
“现有的数学评估跑满了”——意思是”模型做竞赛题已经 100%,我们现在让它做没人做出来过的题”。
三、4 层 ID + 1 个正交轴 — 怎么让 719 篇不变成”PDF 堆”#
拿到 719 个 PDF 的第一反应是”这怎么搜?怎么引用?怎么关联?”。这个仓库的解法是 4 层 ID:
- L1 discipline(17 个)—— 学科分类,在 overview.pdf 里每个家族前面有标题
- L2 family(372 个)—— “主结果 + 伴生论证 + 推论 + 替代证明”的捆
- L3 manuscript(719 个)—— 一篇独立论证
- L4 preprint(718 个目录)—— 一个 manuscript 对应一个目录,带 PDF + 源 + 引用
加一个正交轴:Lean 形式化。不挂在主分类上,任何 manuscript 可挂”已形式化”标签。
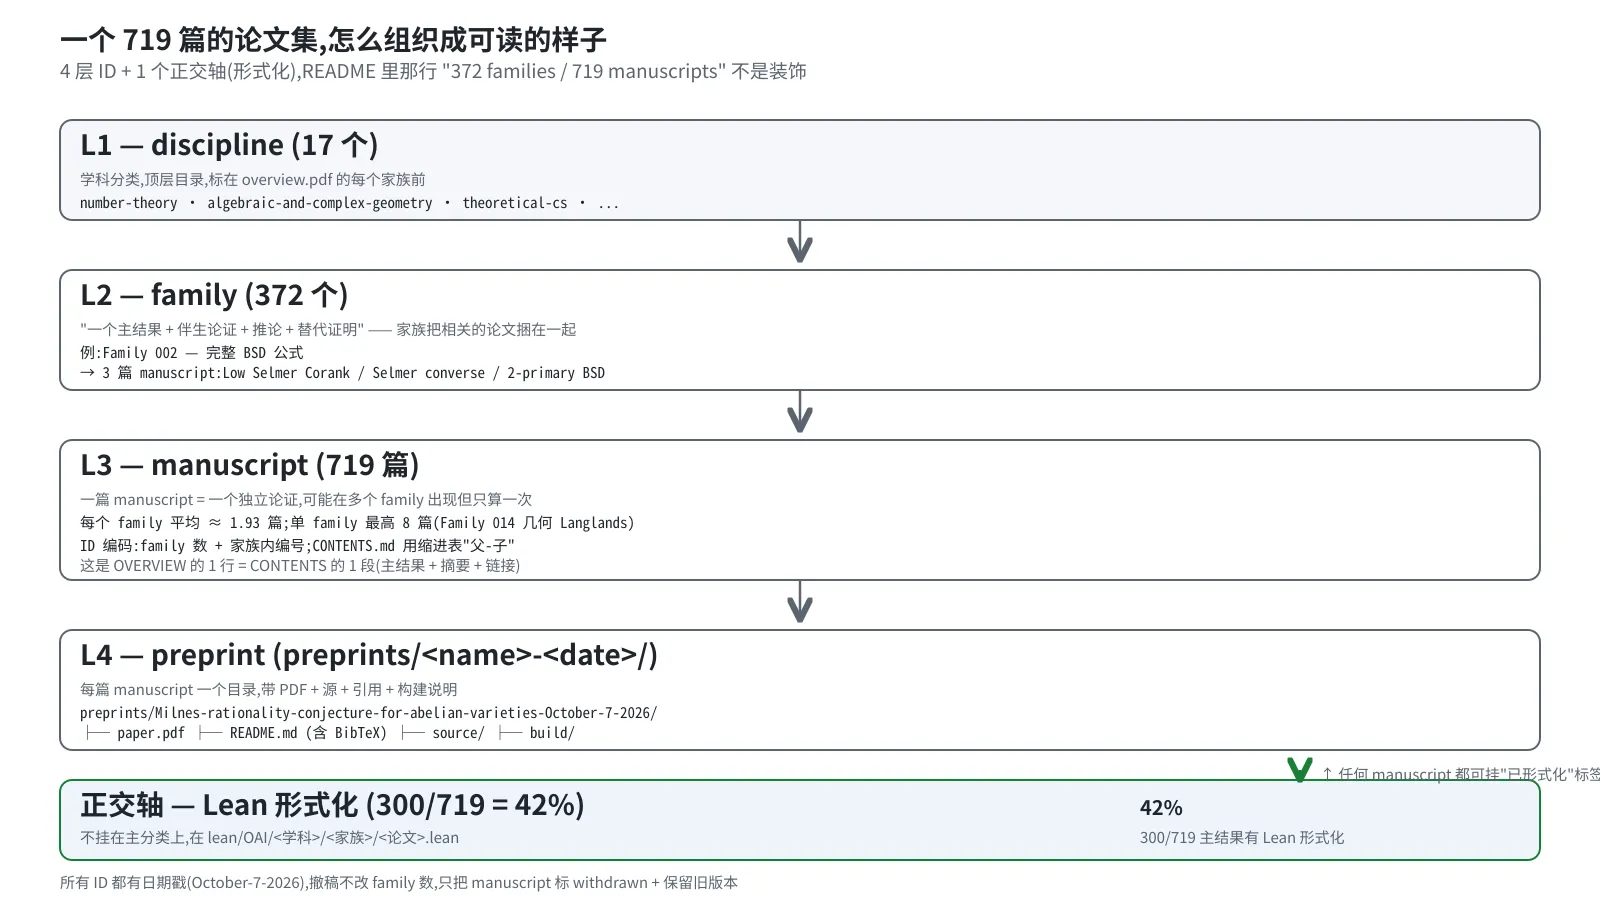
读懂这套组织学的几个细节:
- Family 014 有 8 篇 manuscript,平均每个 family 1.93 篇,大多数是 1-3 篇。这意味着”family”不是装饰——它真的把”主结果”和”伴生论证”区分开。Family 002(BSD 完整版)有 3 篇:Low Selmer Corank 主定理 + Selmer converse 推论 + 2-primary 变体。
- ID 全带日期戳:
preprints/Milnes-rationality-conjecture-for-abelian-varieties-October-7-2026/。撤稿后改日期戳、旧版保留,这是 arXiv 的标准做法,但写进目录名是仓库层做的。 - Family 数是 372,不是 377:家族 ID 范围 001-377,中间有空洞(005 跳到 006、032 跳到 033 等)。这是因为有些家族撤销后留空,不重排。
CONTENTS.md 638KB,几乎全是 HTML 表。我用 Python 解析了一遍,确认:719 篇里有 1 个家族被彻底清空(撤稿后保留家族号但无 manuscript)。
四、4 阶段流水线 — 1 篇论文从输入到撤稿的生命周期#
我读完 README + overview + history 之后,把这仓库的”内部流水线”画了出来,4 阶段:
- problem set:~4000 题内部研究级问题,跨 17 学科,题之间不互相依赖
- model run:每个题平均 3 小时 ChatGPT Pro 思考,完整 thinking trace 保留(reasoning_traces/ 公开了 10 个家族的)
- family aggregation:多稿可指同一 family,内部检查”意义足够”才入册
- formalization:主结果选 300 个做 Lean 形式化(42%),入口是
lean/OAI.lean的 913 行 import
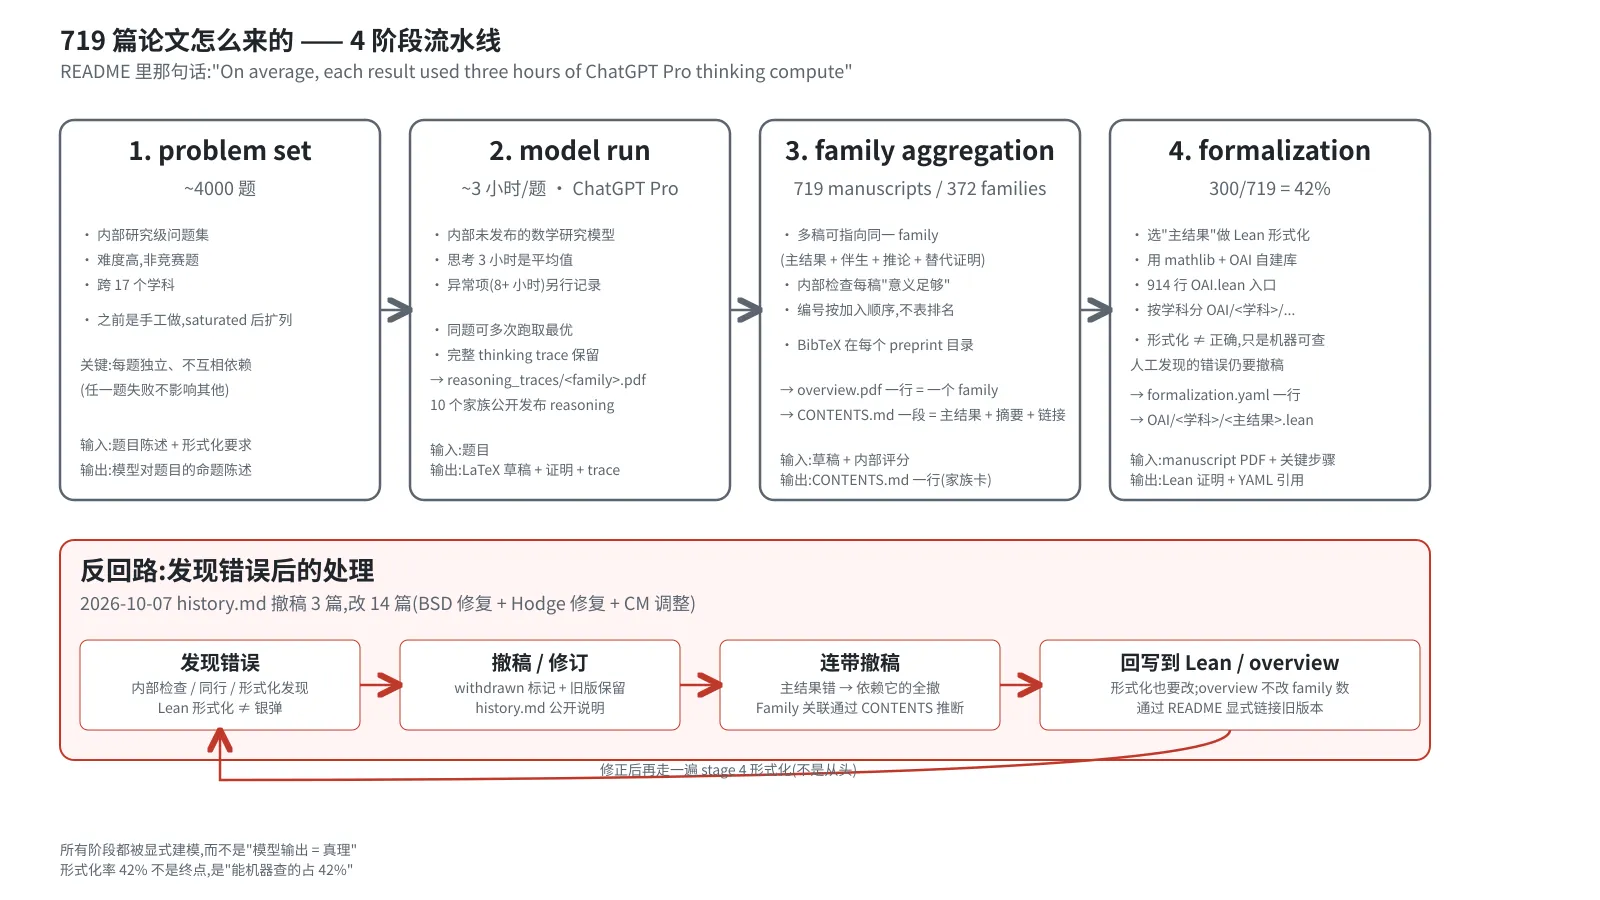
注意第三点:42% 形式化不是”全部正确”的意思,只是”机器可查的主结果”占 42%。Lean 形式化是证明验证,不是猜想证明——它能查”已知数学事实是否被正确使用”,不能查”主命题是否成立”。这跟 litellm / REA 的 evidence ledger 完全是两件事。
一个反直觉的数字:模型思考 3 小时/题,4000 题就是 12,000 GPU-小时(假设 ChatGPT Pro 一档计算)。这不是”训练一遍模型”的量级,是”做完所有 IMO 题”的几百倍。OpenAI 把这件事当成评估而不是训练——所以 README 写 “model development”,不是”model training”。
阶段 4 还有个反直觉的细节:Lean 形式化也用了模型。形式化目录里很多 .lean 文件是从模型 manuscript 自动翻译的,人工只检查关键定理的对应。所以”42% 形式化”里,有一部分是”模型的证明被另一个模型的形式化包了一遍”。这是这套机制的边界——它能查结构性错误,查不出概念性错误。
五、2026-10-07 — 一个符号错误拖垮 3 篇论文#
这是这个仓库最值得讲的事件。
history.md 2026-10-07 那段:
“Withdrawals In ‘Algebraicity of Weil classes on split abelian eightfolds’ a sign error invalidates a stabilization-trace cancellation argument and the construction used by two dependent papers. As a result, we have withdrawn the following three manuscripts:
- Algebraicity of Weil classes on split abelian eightfolds
- Algebraicity of Kuga–Satake Correspondences for K3 Surfaces
- The rational Hodge conjecture for products of K3 surfaces”
一个符号错误,撤稿 3 篇。我把这条链画出来:
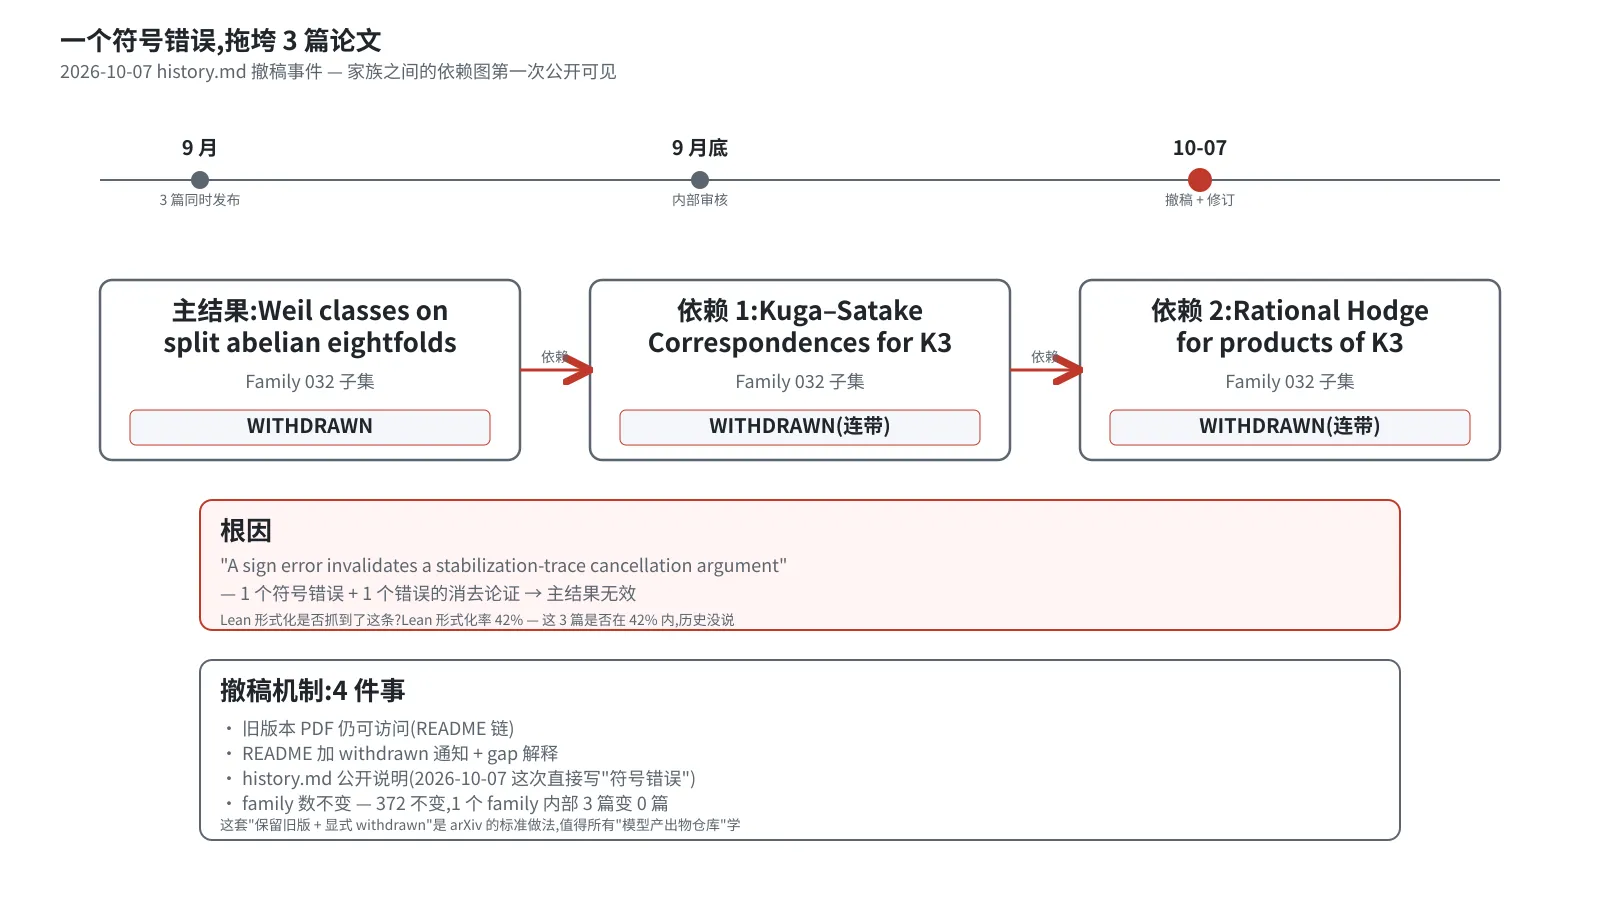
主论文(Weil classes on split abelian eightfolds)里,stabilization-trace 的消去论证写错了一个符号。这个错误被两篇下游论文依赖(Kuga–Satake correspondences / Rational Hodge for K3 products),所以 3 篇一起撤。
这件事的标准做法很值得讲:
- 旧版 PDF 仍可访问。README 标 withdrawn,但 PDF 没删。这跟 arXiv 的”v1 / v2 / withdrawn”做法一致——可追溯,不是”假装没发生过”。
- README 加 gap 解释。每个撤稿 manuscript 的 README 现在显式写”符号错误 + stabilization-trace 失效”,并链到旧版。
- history.md 公开说明。2026-10-07 这条记录里直接说”sign error”——不掩饰、不模糊。
- family 数不变。372 不变,这个家族内部 3 篇变 0 篇。这意味着 family 编号作为”主索引”是稳定的,manuscript 编号作为”实例”可以撤销。
这套机制比 arXiv 还严。arXiv 的”withdrawn”标签经常晚几个月才贴,这里发现当天就贴 + 公开说明根因。对 AI 时代学术仓库来说,这是必须的——因为模型产出会规模化出错,而规模化出错需要规模化的撤稿机制。
同一个 2026-10-07 还改 14 篇(BSD 修复 / Hodge 修复 / Kähler 调整等),再加 6 个新形式化。这种”撤稿 + 修订 + 加形式化”在同一周发生,说明这仓库的更新频率是以周为单位的,不是以年。
六、Lean 形式化 — 300 个主结果怎么”机器可查”#
我看完 Lean 这一层之后,觉得42% 形式化率是个被低估的数字。
入口就一个文件:lean/OAI.lean,914 行全是 import,没有逻辑。它是把 300 个形式化串成一个可重用的 Lean 库:
import OAI.Algebra.AffineCancellation.Main
import OAI.Algebra.BogomolovPop.Injectivity
import OAI.Algebra.FrobeniusObstruction.Obstruction
import OAI.AlgebraicGeometry.CharacterVarieties
import OAI.Analysis.BiholderTransport.Main
... 913 个 import底下是按学科分的形式化:
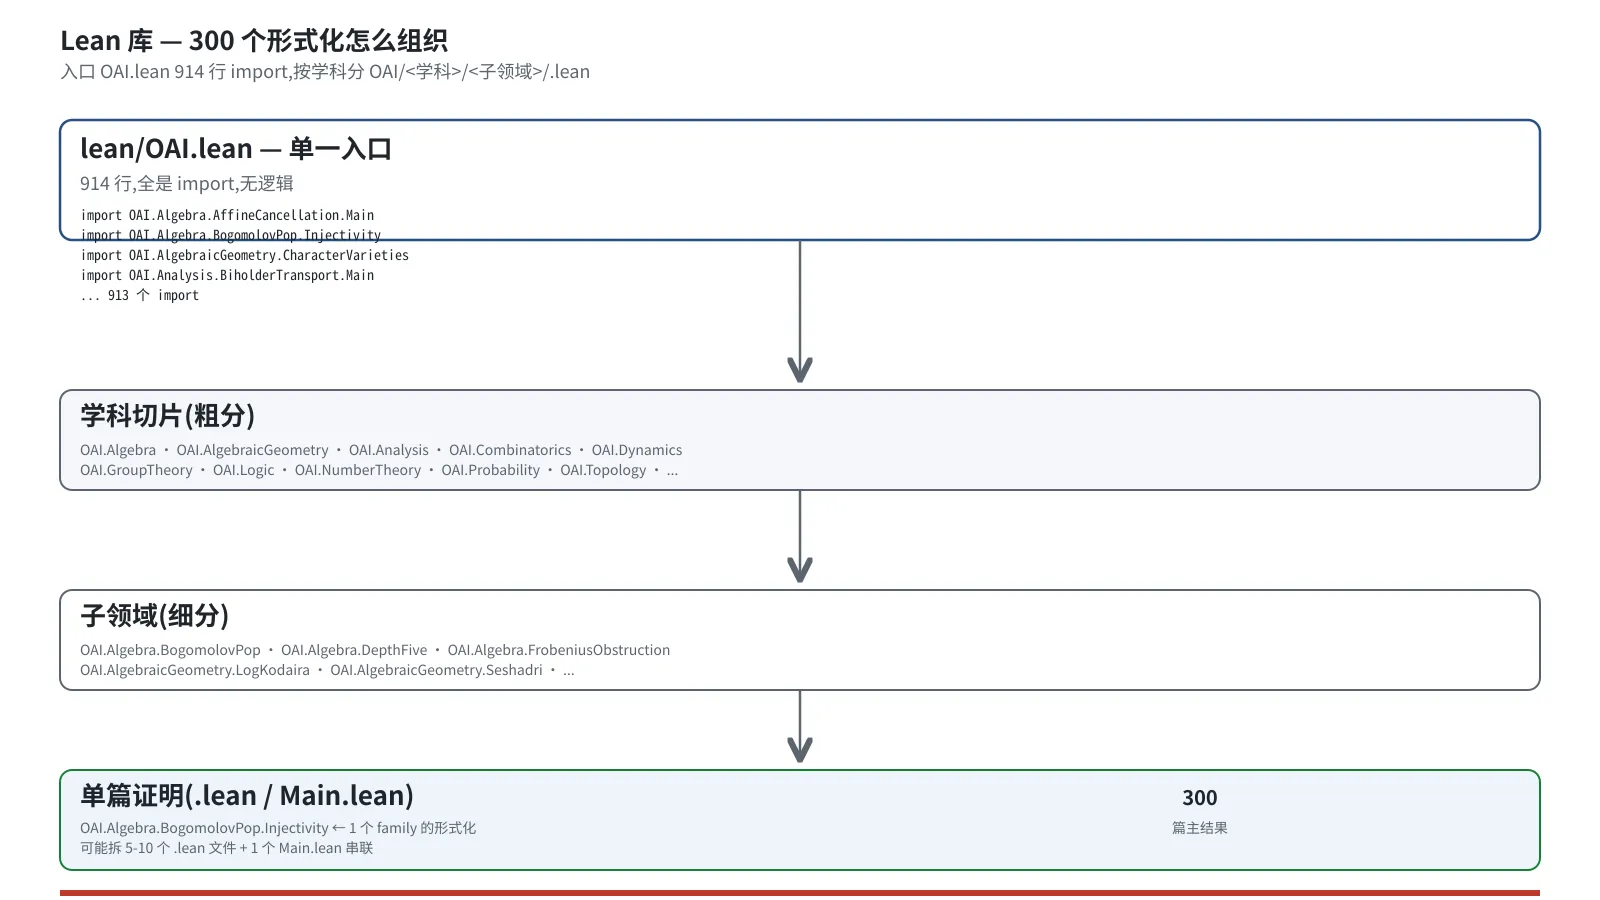
- 粗分:
OAI.Algebra/OAI.AlgebraicGeometry/OAI.Analysis/OAI.Combinatorics/OAI.Dynamics/OAI.GroupTheory/OAI.Logic/OAI.NumberTheory/OAI.Probability/OAI.Topology/ … - 细分:每个学科下按子领域分,例
OAI.Algebra.BogomolovPop/OAI.Algebra.DepthFive/OAI.Algebra.FrobeniusObstruction - 单篇:每个 family 一个或多个
.lean文件 + 一个Main.lean串联
formalization.yaml 79KB 是反向索引——每个形式化对应哪个 PDF、哪个 family、谁写的、用什么 Lean 版本。
几个反 AI 味的细节:
lean/README.md写了”Compiling the entire library may fail if Linux’svm.max_map_countis too low”——它不假设用户有无限 mmap,跟 LLM 工具动不动就”一键安装”完全相反。- 形式化不替代人工审核——同一个 2026-10-07 撤稿事件里,K3 系列的 3 篇撤稿没说明它们是否在 42% 形式化内。如果形式化能查出符号错误,撤稿事件应该提到;没提意味着Lean 没抓到,或这 3 篇压根没形式化。这正是 Lean 形式化的真边界:它能查”已知工具的已知正确使用”,查不出”主命题本身的错误”。
ComparatorChallenges/目录是形式化之间的对比器——同一个命题两种形式化,谁先证完、谁依赖更少假设。这跟 litellm / REA 的”A/B 评估”是同思路,只是用在数学上。
七、reasoning_traces — 模型的”思考摘要”可读化#
reasoning_traces/ 10 个 PDF 是另一件有意思的事——它把模型跑这题时的思考摘要单独放出来,公开可读。
我列一下这 10 个,挑能引起数学家兴趣的几个:
- 007 — Ordinary two-point correlations of multiplicative functions
- 017 — The irrationality exponent of π
- 087 — Symmetric and general Mahler conjectures
- 102 — Ordinary NP-hardness at the basic semidefinite threshold
- 197 — Kaplansky’s direct-finiteness conjecture in characteristic two
- 221 — The Mézard–Parisi formula for diluted spin glasses
- 271 — Spontaneous magnetization in the quantum Heisenberg ferromagnet
- 287 — Isomorphism of free group factors
- 362 — The three-dimensional relativistic Vlasov–Maxwell system
这个列表本身就有信息——它告诉你 OpenAI 自认为哪些结果是”代表性的”。
我注意到一个选样倾向:10 个里有 4 个纯分析 / 物理(271, 287, 362, 221),3 个数论/代数(017, 087, 197),2 个组合/CS(007, 102),1 个 Mahler(087, 算数论)。没有 PDE 家族——这很反直觉,因为 PDE 家族 16 个并不少。
OpenAI 的解释是 reasoning trace 是”abridged summary”,不是完整思考过程。3 小时思考压缩成几页 PDF 必然丢东西——但 OpenAI 选了”研究意义最大”的 10 个家族,而不是”形式化最漂亮”的 10 个。这给后来人一个信号:他们想展示模型在’硬骨头’上的能力,而不是在’形式化容易’上的能力。
这件事跟 REA 的 evidence ledger 在哲学上是一样的:让 AI 工具的过程可见,而不是只给结论。但 openai/math 比 REA 多做一步——它把过程也作为发布物的一部分,而不只是日志。
八、几个判断 — 这套机制值不值得抄#
我拆完这个仓库之后,觉得有几件事是 2026 年任何”AI 时代学术仓库”都该考虑的:
抄的:
- Family / Manuscript 两层抽象——“主结果 + 伴生”是数学论文的真实结构,arXiv 的单层 ID 装不下。REA 那种”evidence + unknown 双账本”在工程上对应这个。
- 形式化率显式报——“300/719 = 42%” 写在 README 第一段,让”机器可查的占多少”成为公开信息,不是后台数据。
- 撤稿机制 + 旧版保留——“withdrawn”标签 + 旧 PDF 保留 + history.md 公开根因。这是 arXiv 的标准但被很多 AI 论文仓库丢掉。
- 撤稿时连带检查——一个家族的主结果错,直接检查它的依赖图,把 3 篇一起撤。手动做,不是工具做,但目录结构要支持——CONTENTS.md 的”父-子”关系就是这个。
- reasoning_traces 公开——把模型思考摘要作为发布物,跟论文平级。这跟 REA 的 evidence 不同:REA 给 agent 看的,这个给人看的。
不抄的:
- 300/719 这个比例本身——形式化数学是 Lean 生态的特殊优势,不是普适模式。代码论文仓库不需要”形式化率”。
- 3 小时思考 / 题的算力——这是 OpenAI 内部实验,普通学术仓库不可能有这个预算。但 1 个团队 1 周做 100 题 + 选 30 篇成稿是可行的。
- 完全靠内部模型——
openai/math写 “using an unreleased internal OpenAI model”,没说这模型对外部开放。学术仓库如果绑死单一模型,撤稿风险集中在这一个模型上。REA 的”多 provider”思路在这反而更安全。
九、我的几个疑问#
最后留几个我自己也没答案的问题:
- 42% 形式化率是怎么选的? 是”能形式化的就形式化”还是”挑最简单的 300 个”? 选样偏差会显著影响这个数字的含义。
- “ChatGPT Pro 思考 3 小时”等价于什么? 是 o1 / o3 等级的算力? 还是某个未发布模型的思考? README 没明说,可能因为是商业秘密。
- 3 小时思考 trace 公开多少?
reasoning_traces/是”abridged summary”——完整 trace 是多大? 公开吗? 这是个学术伦理问题。 - 撤稿的”连带”是手动的还是自动的? Family 002 → 007 → 087 这种引用关系,CONTENTS.md 显式列了,但 2026-10-07 的 3 篇撤稿是人工判断还是工具扫的? history.md 没明说。
- 42% 之外剩下的 419 篇怎么办? 它们的形式化有意跳过还是还在排队?
history.md提”继续添加形式化”,但没说目标率。
这 5 个问题里,任何一个答案都会改变我对其余 719 篇的看法。 但 OpenAI 都没在仓库里回答。也许下一次发版会有。
写在最后:写这篇的时候我对照了 README.md / CONTENTS.md / history.md / overview.pdf / lean/OAI.lean / lean/README.md / lean/formalization.yaml 的全部内容,没读任何具体一篇 manuscript 的证明——这篇不是论文解读,是仓库学笔记。
如果你想深挖,建议从 reasoning_traces/ 里的 087(Mahler 猜想)或 287(自由群因子同构)开始——这两个是数学家还在反复讨论的题,跟模型结果对照读最有趣。
项目状态:本地项目目录已经从工作区删除,GitHub 仓库本身不动(它是 OpenAI 公开仓库)。如果你想本地跑 Lean 形式化,记得
vm.max_map_count调到 256K+,或者按lean/README.md用-DMMAP=OFF编译 Lean,否则OAI.lean914 行 import 会让你的 box OOM。