一、一个让我重新思考 RAG 的项目#
VectifyAI/PageIndex 这个项目我第一次打开 README 是被一行字砸到的:
“Vector-based RAG retrieves by semantic similarity. But similarity ≠ relevance — what retrieval actually needs is relevance, and relevance requires reasoning.”
这句话把我过去两年做的所有 RAG 都「打回原形」了一遍。我之前搭的所有 RAG 流程——chunk → embed → 存进向量库 → 相似度 top-k → 拼 prompt——全都在用「相似度」硬撑「相关性」。这两件事差多远?
举一个真实例子:
- 文档里讲「2023 年运营利润率是 24.5%」
- 用户问「What was the 2023 operating margin?」
- 向量检索会找「2023」+「operating」+「margin」这三个词最相似的段落——但「operating margin」是个组合语义,三个关键词分散在不同段落里,每个段落相似度都还行,但没有一个段落同时含这三个词的语义
- 向量检索返回一堆”看起来都沾边”的段落,但没有一个是答案
PageIndex 干的事情就是:把向量索引整个拆掉,换成「一棵文档树」,让 LLM 像人一样翻目录、找章节、读全文。
我读完整个仓库(12000+ 行 Python)后,觉得这事的本质是:
把 RAG 从「信息检索」(information retrieval)问题,重新定位成「树搜索 + 推理」(tree search + reasoning)问题。
这两个问题的工程范式完全不同。前者用向量数据库 + 相似度算法;后者用一棵树 + LLM agent。
二、先看项目长什么样#
git clone 下来 59MB(主要是 cookbook/ 里的 ipynb + 测试 fixture + PDF),核心代码在 pageindex/:
PageIndex/
├── pageindex/                  ← 核心 Python 包
│   ├── page_index_md.py        ← Markdown 建树(345 行)
│   ├── page_index_classic.py   ← PDF 建树(1325 行)
│   ├── tree_optimize.py        ← 树 cost model + merge/expand(1008 行)
│   ├── local_chat.py           ← 本地 Reasoning(1545 行)
│   ├── agent_tools.py          ← MCP tool 契约(1777 行)
│   ├── client.py               ← 统一 SDK client(2709 行)
│   ├── cloud_api.py            ← 云 API(565 行)
│   ├── local_api.py / local_store.py / chat_stream.py / utils.py / ...
│   └── flash/                  ← PageIndex Flash(快速建树)
├── cookbook/                   ← 5 个 Jupyter notebook 教程
├── docs/                       ← naming-rules
├── examples/                   ← 测试 PDF 样本
├── tests/                      ← 单元测试
├── run_pageindex.py            ← CLI 入口(211 行)
├── pyproject.toml              ← dependencies: requests + urllib3
└── README.md ← 完整文档pyproject.toml 里只有 2 个非标准库依赖:requests 和 urllib3。这告诉你:PageIndex 的整个 LLM 调用全是裸 HTTP 请求,不绑定 OpenAI / Anthropic SDK——任何「OpenAI-compatible」API 都能用。
整个仓库 538 个 commit,GitHub Trending #1 一段时间过(Trendshift badge 还在 README 里)。当前版本 0.2.10,License MIT,作者 Ray(ray@vectify.ai)。
三、核心论据:为什么相似度 ≠ 相关性#
我把 README 的对比表抄下来,因为这是 PageIndex 整个立项的根:
| Vector RAG | PageIndex | |
|---|---|---|
| Index | 向量索引 | 文档树索引 |
| Retrieval | 语义相似度搜索 | LLM reasoning over the tree |
| Result | 不透明、“vibe retrieval” | 显式 traceable,每个答案带页码 |
| Context | 只有 query embedding | 完整上下文:对话历史 + 领域知识 |
「不透明」这一点是向量 RAG 真正的痛点。生产环境里,用户问”我的退款为什么还没到账”,向量检索可能返回:
- 「退款处理流程」(相似度 0.82)
- 「退款时效说明」(相似度 0.79)
- 「申请退款的条件」(相似度 0.76)
这三个都是「相关文档」的相关段落——但没有一个真正回答了用户的问题。向量检索告诉你「这些文档沾边」,但不告诉你「答案在哪一页」。
PageIndex 的做法是:让 LLM 沿着树走,每一步决定「进哪个子节点 / 读哪一页 / 换分支」。LLM reasoning 的每一步都是「可追溯的思考过程」,最终答案带「Page 47, 段落 3」这种精确引用。
这种范式的工程成本是:每次查询都要消耗 LLM tokens reasoning 路径。所以 PageIndex 才要优化树——树越精准,reasoning 路径越短,tokens 越省。
四、两阶段流程:Index + Retrieve#
我把 PageIndex 整个流程画成一张图,把核心心智和代码模块对应起来:
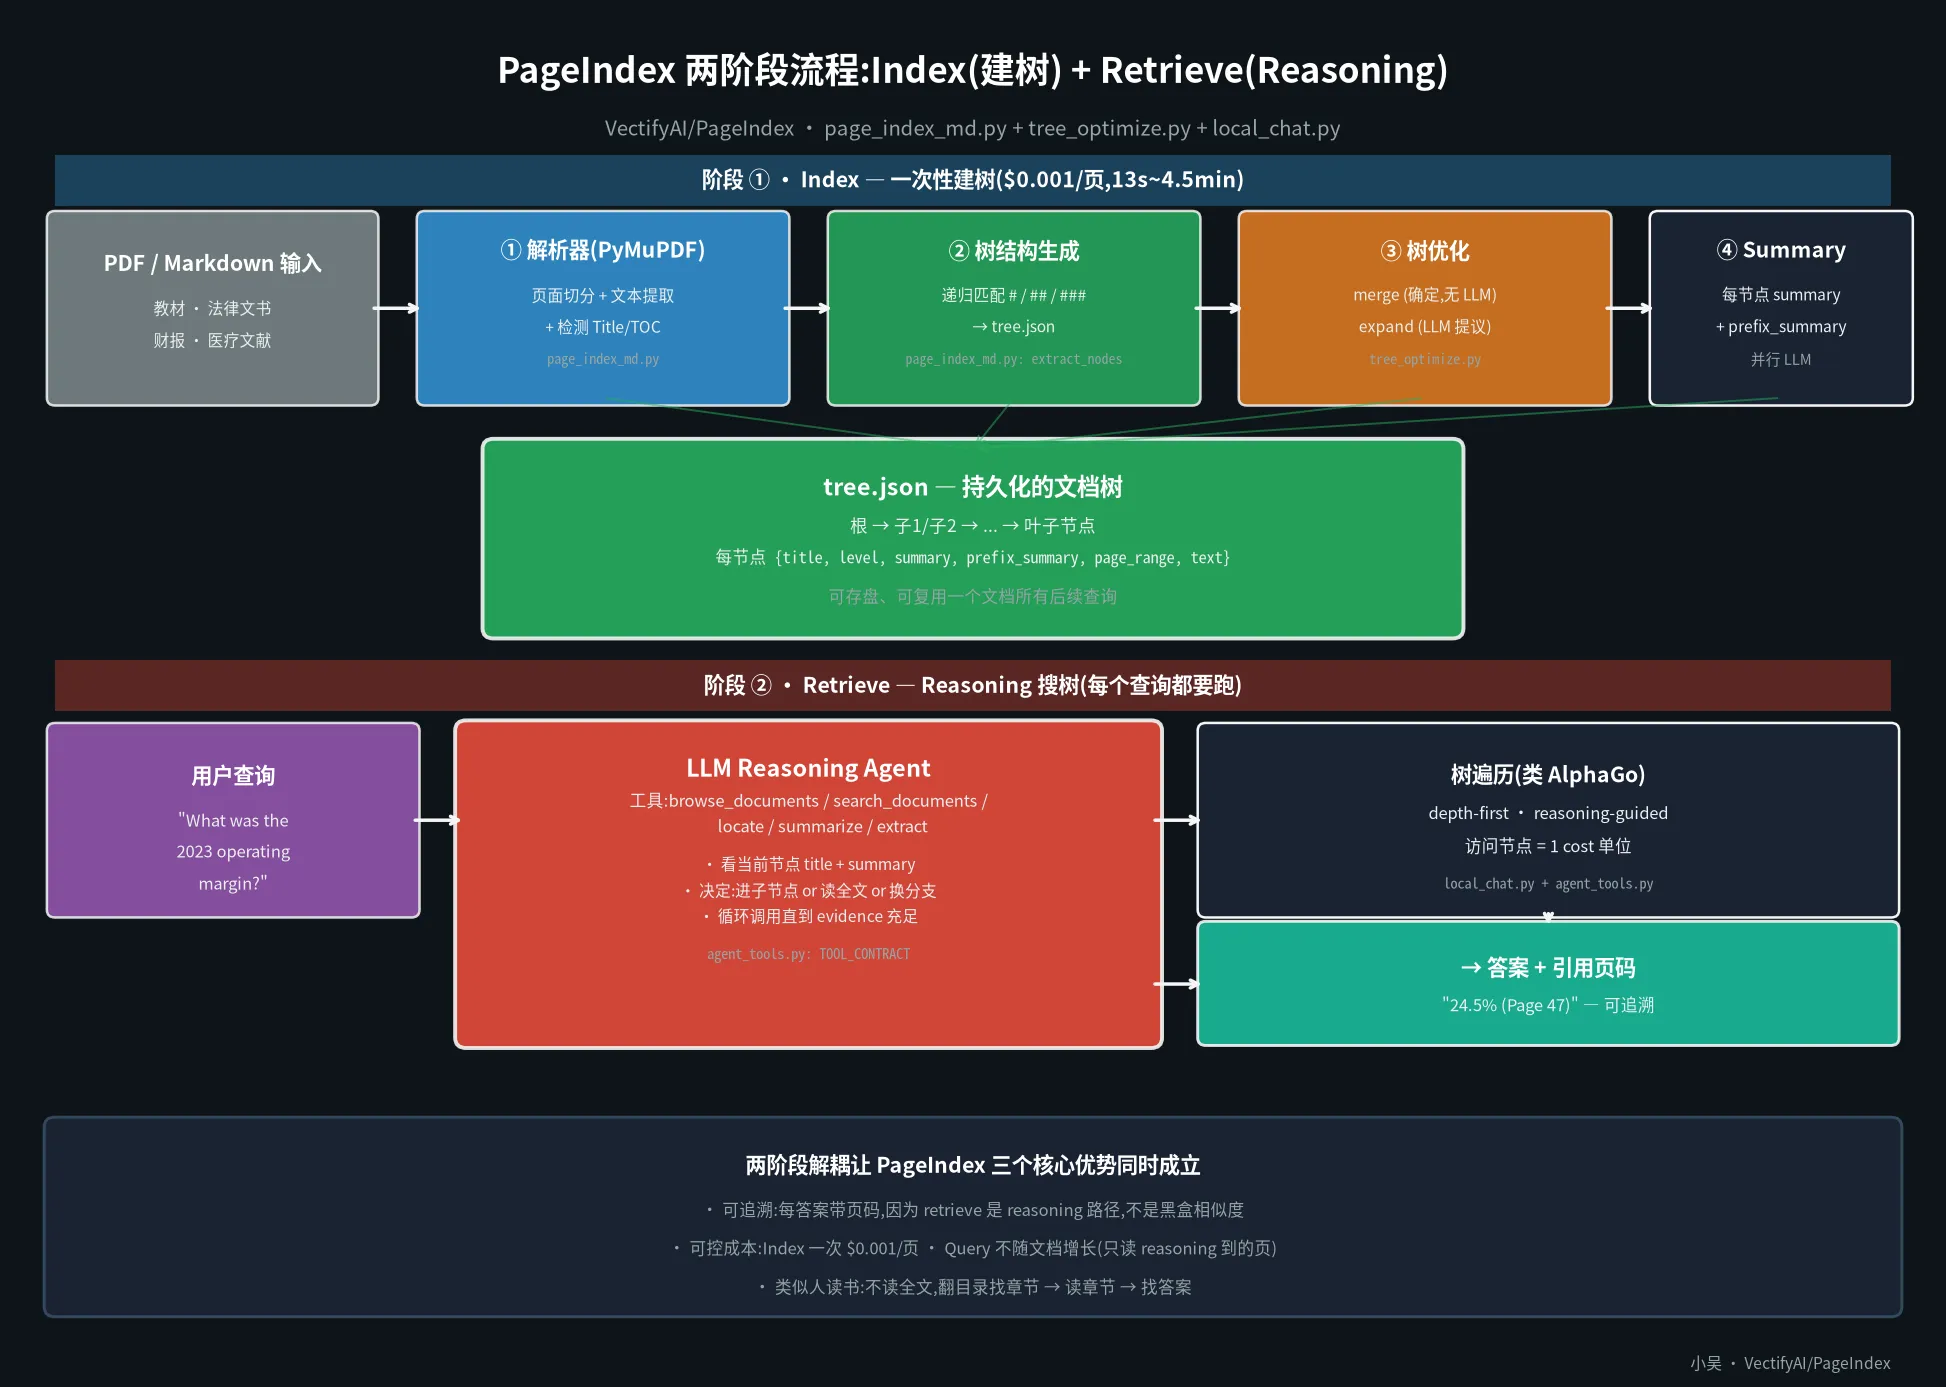
这张图把 PageIndex 的工程结构讲清楚了。让我顺着图一步步讲。
4.1 阶段 ①:Index(建树)#
这一阶段只在文档首次入库时跑一次,跑完生成一个 tree.json,之后所有查询都复用它。
Step ① 解析器(page_index_md.py + page_index_classic.py):
- Markdown 版用正则匹配
# / ## / ###标题(extract_nodes_from_markdown),跳过代码块里的伪标题,提取node_title / line_num / level - PDF 版用 PyMuPDF 提页文本 + 检测 Title/TOC,处理跨页段落
Step ② 树结构生成:
- 把所有节点递归嵌套,生成
{title, level, page_range, text, nodes: [...]}的树形 JSON - 关键点:每个节点带
text字段(原始内容)和page_range(页码范围)
Step ③ 树优化(tree_optimize.py,1008 行):
- 这是 PageIndex 最硬的一段代码——把初版树重塑成最适合 reasoning 检索的形态
- 核心操作是 merge(确定性,无 LLM)和 expand(LLM 提议子节)
- merge/expand 的判定标准是下一节我要展开的「cost model」
Step ④ Summary:
- 每个节点并行调用 LLM 生成
summary(本节内容)和prefix_summary(本节路径的意图) - 摘要控制在 200 token 以内,过长会被压缩
整体成本:$0.001/页 + 13 秒到 4.5 分钟(README benchmark,9 到 1098 页文档实测)。
4.2 中间产物:tree.json#
tree.json 是 PageIndex 整个架构的核心:
{
  "title": "Apple 10-K 2023 Annual Report",
  "level": 1,
  "summary": "Apple Inc.'s annual report filed with the SEC...",
  "prefix_summary": "Apple's main annual disclosure document",
  "page_range": [1, 86],
  "text": "FORM 10-K\nANNUAL REPORT...",
  "nodes": [
    {
      "title": "PART I",
      "level": 2,
      "summary": "...",
      "page_range": [4, 23],
      "nodes": [
        {
          "title": "Item 1. Business",
          "level": 3,
          "summary": "Apple designs and sells consumer electronics...",
          "page_range": [4, 9],
          "nodes": []
        },
        ...
      ]
    },
    ...
  ]
}每个节点同时存 4 件事:title、summary(LLM 总结)、prefix_summary(父节点摘要)、page_range。这 4 件事是 reasoning agent 做决策的全部信息。
4.3 阶段 ②:Retrieve(Reasoning)#
这一阶段每个查询都要跑。流程是:
用户查询 → LLM Agent 进入 tree.json 根节点
       → 看当前节点 title + summary + child_titles
       → 决定:进子节点?读当前节点的 text?换分支?
       → 循环调用工具,直到 evidence 充足
→ 拼出最终答案 + 页码引用local_chat.py 是这一阶段的主入口,1545 行,实现了:
- 多轮 reasoning——支持 conversational context(用户连续追问时,history 进 prompt)
- 流式输出(
chat_stream.py,69 行)——把 agent 的工具调用过程实时吐给前端 - Tool 契约(
agent_tools.py,1777 行)——和云端 MCP server 完全对齐的工具定义,这样本地客户端和云端调用无缝切换
关键心智:每个查询都重跑 reasoning,而不是”算一次相似度”。这意味着 PageIndex 的查询成本和向量 RAG 不可比——但因为 Index 一次可以复用,而且 reasoning 只读”路径上的页”而非全文,长文档场景下反而更便宜。
README 给了一组实测数据:
| 文档长度 | 原生 PDF 输入 vs PageIndex |
|---|---|
| 52 页 | 2.1× 贵 |
| 80 页 | 3.4× 贵 |
| 198 页 | 7.8× 贵 |
| 420 页 | 16.6× 贵 |
| 805 页 | 塞不进 context window |
这就是 PageIndex 的商业卖点:文档越长,PageIndex 越便宜——因为它只读 reasoning 路径上的页,而原生 PDF 输入得把整篇丢给 LLM。
五、PageIndex 最硬的一段代码:文档树的 cost model#
这是 PageIndex 区别于所有其他”RAG 优化”的根本点——它把整棵树当成搜索引擎来优化,而不是当成「embedding 索引 + 排名函数」。
tree_optimize.py 头 30 行的注释里,作者 Ray 把整个模型定义得非常清楚:
Search cost is measured in pages, routing cost R(v) = 1 page:

    S(v)          pages to linearly scan if v is collapsed = the whole subtree span
    R(v)          cost of visiting v for routing (title, summary, child descriptions)
    S_residual(v) source pages of v covered by no child

expand() - for a collapsed node, one-step lookahead, children treated as collapsed:

    trigger:       S(v) > TRIGGER_PAGES        (cost control on generation, not the rule)
    collapse_cost = S(v)
    expand_cost   = R(v) + max(S_residual(v), max_i S(c_i))
    expand iff     expand_cost < collapse_cost                  (ties keep collapsed)
    expand_gain   = collapse_cost - expand_cost

merge() - for a node that already has a subtree, decided bottom-up:

    merge_cost    = S(v)
    tree_cost(v)  = S(v)                                           if v is a frontier node
                  = R(v) + max(S_residual(v), max_c tree_cost(c))  if v is expanded
    merge iff      merge_cost <= tree_cost(v)                       (ties merge)
merge_gain = tree_cost(v) - merge_cost我把这套模型画成下面这张图,把每个公式和它的工程意义对应起来:
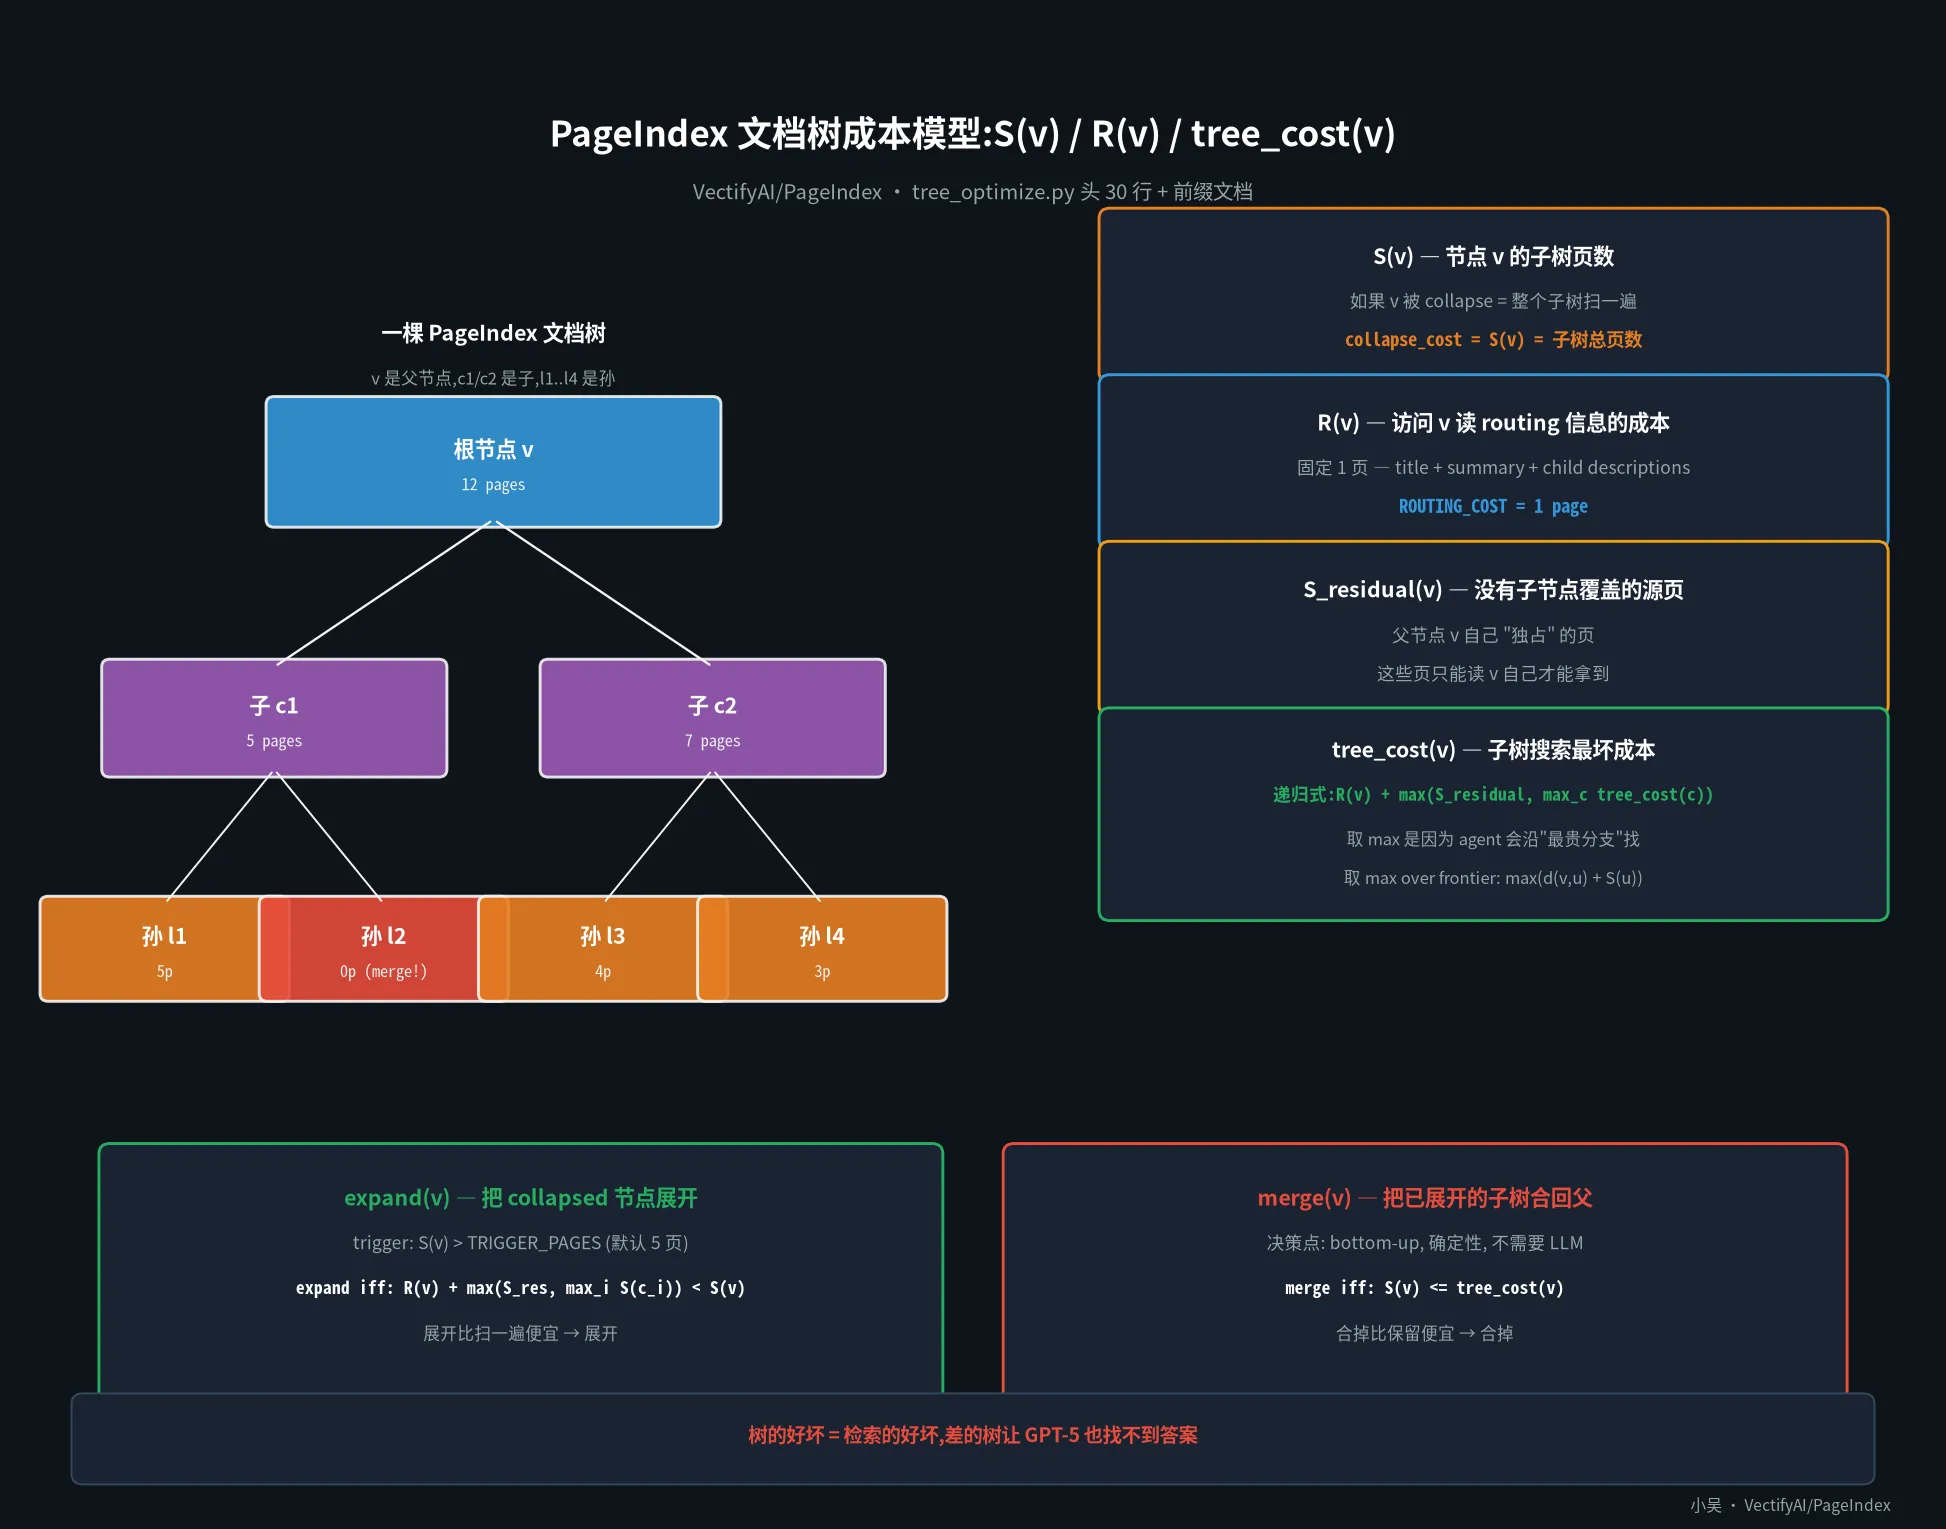
5.1 三个原始量#
S(v)= 节点 v 子树的总页数(包含 v 自己 + 所有后代节点覆盖的页)。这是「如果把 v collapse,代价是多少」的度量。R(v) = 1 page——这是「访问 v 读 routing 信息」的成本。读 title + summary + child descriptions,粗略按 1 页算。这是个常数,不是变量。S_residual(v)= v 自己”独占”的页数——子节点覆盖范围之外的页。这些页只能通过读 v 自己才能拿到,不能通过子节点路由。
5.2 决策 1:expand(展开 collapsed 节点)#
trigger:       S(v) > TRIGGER_PAGES        (默认 5 页)
collapse_cost = S(v)
expand_cost   = R(v) + max(S_residual(v), max_i S(c_i))
expand iff expand_cost < collapse_cost (ties keep collapsed)心智:一个 collapsed 节点,如果子树跨度超过 5 页(TRIGGER_PAGES),就有「展开价值」。展开成本 = 读 v 自己(1 页)+ 走进最贵子分支(max_i S(c_i))或读 v 独占的残差页(S_residual(v))。取 max 是因为 reasoning agent 会沿”最贵分支”找——它会沿树搜索直到找到答案,最坏情况是遍历最贵的那一支。
如果展开比扫一遍还便宜,就展开——这是个 1 行代码就能写的判定逻辑,但背后的工程意义是把「AI 在树上绕弯路」变成可优化的问题。
5.3 决策 2:merge(合掉已展开的子树)#
merge_cost    = S(v)
tree_cost(v)  = S(v)                                           if v is a frontier node
              = R(v) + max(S_residual(v), max_c tree_cost(c))  if v is expanded
merge iff merge_cost <= tree_cost(v) (ties merge)心智:一个已展开的节点 v,如果合掉它(merge_cost = S(v),扫一遍)比保留子树(tree_cost(v),走分支)更便宜,就合掉。
tree_cost(v) 的递归式是整个模型最硬的部分:
tree_cost(v) = max over frontier u [ d(v, u) + S(u) ]「沿树最坏路径」= 找 frontier 节点 u,让 distance(v,u) + S(u) 最大。这个距离是 reasoning agent 从 v 走到 u 要读多少个父节点的 routing 信息(R(v))。
作者在代码注释里特别强调了一件事:
“A node with residual pages contributes a virtual frontier entry one hop below itself. The maximum is over every branch - the deepest leaf need not be the most expensive one.”
深的叶子不一定是最贵的分支——残差页多、内部残差累积的中间节点反而可能更贵。这点和算法课的「最大子树和」是同一个心智。
5.4 merge 为什么不需要 LLM#
merge 决策的所有输入(S(v) / R(v) / tree_cost(v))都是纯计算量,不需要读内容。所以 merge 是确定性的、不需要 LLM、跑起来几毫秒。
而 expand 需要 LLM,因为要提议子节——「这一节应该怎么切」。expand 用 LLM 在 prompt 里给出当前 section 的全文 + 一个 JSON schema,LLM 返回子节列表。
5.5 same-page dedup 是个隐藏优化#
代码注释里还藏了一个细节:merge_same_page()——「frontier siblings covering identical pages cannot be told apart, 因为 retrieval 是 page-granular 的——an agent routed to any of them reads the same text, and because the leaf summary prompt sees only that text, their summaries come back near-identical」。
翻译:如果两个兄弟叶子覆盖同一组页,它们的 summary 会趋同,合并掉就完事。这是「省 LLM 推理成本」的隐藏优化。
六、Reasoning agent 怎么走树#
local_chat.py 和 agent_tools.py 共同实现了「LLM 沿树 reasoning」这件事。我把这块读完后总结成三段心智:
6.1 工具契约和云端 MCP 对齐#
agent_tools.py 里有一个 TOOL_CONTRACT 字典,定义了 5 个核心工具:
TOOL_CONTRACT = {
    "browse_documents": { ... },  # 主检索工具:列出文档、搜索、按 folder 钻取
    "search_documents":  { ... },  # 升级路径:向量相似度,只在 browse 失败后用
    "locate":            { ... },  # 给定关键词,定位所在章节
    "summarize":         { ... },  # 总结节点
    "extract":           { ... },  # 提取字段
}关键设计:这套契约和云端 MCP server 完全一致。本地模式和云模式共用同一个 client(client.py,2709 行),只是底层实现不同——本地模式读 tree.json,云模式调云 MCP。这意味着 agent prompt 在两种模式下可以无缝切换。
6.2 走树是 reasoning,不是匹配#
agent_tools.py 的 browse_documents 注释里有一段非常硬的工程判断:
“Primary document retrieval tool. After orienting with get_folder_structure() (when available), use this for all document-related questions… Do NOT jump to search_documents() first — it is an escalation path, only after browse_documents(sort=‘relevance’) has failed.”
工程判断:browse_documents(走树)是首选,search_documents(向量)只是「升级路径」——只在 browse 失败时升级。这反向很多 RAG 项目的默认行为(默认用向量,关键词当 fallback)。
这是因为——对长文档,reasoning 找答案的召回率 100% 优于相似度。相似度召回看 embedding 模型的语义理解;reasoning 召回看 LLM 的语义理解——后者明显更强。
6.3 永远不抛异常#
agent_tools.py 头注释有一段非常工程化的设计哲学:
“Tools never raise: every outcome, including errors, is returned as the same JSON envelope the cloud emits ({“success”: true, …} / {“error”: …}) — arguments outside a pruned local signature come back as that envelope too…”
翻译:工具永远不抛异常,所有结果(包括错误)都用云端 emit 的同一种 JSON 包装返回。这是为了让 agent prompt 在本地模式和云模式下能复用同一套 error handling 逻辑。
只有云端是例外:401/403、429/5xx、不可达 server、RATE_LIMITED / USAGE_LIMIT_REACHED——这四种情况会重新抛出 PageIndexAPIError,让上层决定如何重试。
七、横向对比:PageIndex 和其他 RAG 方案的差异#
我把 PageIndex 和主流 RAG 方案做了横向比较:
| 方案 | 索引 | 检索 | 优势 | 劣势 |
|---|---|---|---|---|
| Vector RAG (LangChain + Pinecone) | embedding + HNSW | 余弦相似度 top-k | 通用、快、便宜 | 召回率对组合语义差、不透明 |
| PageIndex | 文档树 + 节点摘要 | LLM reasoning over tree | 可追溯、对长文档召回率高 | 每次查询消耗 LLM tokens |
| BM25 | 倒排索引 | 词频统计 | 零依赖、解释性强 | 不理解语义、对手需要 |
| ColBERT / SPLADE | late interaction | token 级匹配 | 比 BM25 强,比向量省 | 工程复杂、需要 GPU |
| HyDE | embedding + 假设文档 | 假设检索 | 解决零样本问题 | 多一次 LLM 调用 |
| GraphRAG | 实体关系图 | 图遍历 | 跨文档关系强 | 建图贵、不适合长单文档 |
PageIndex 的定位非常清楚:「长单文档 + 高准确性 + 可追溯」三个诉求同时满足。这三个诉求和场景其他方案的对比:
- 长单文档:Vector RAG 弱(chunk 切断语义),PageIndex 强(按章节自然切分)
- 高准确性:Vector RAG 弱(top-k 召回不稳),PageIndex 强(reasoning 召回)
- 可追溯:Vector RAG 弱(黑盒向量),PageIndex 强(答案带页码)
FinanceBench 的数字是个硬证据:PageIndex 98.7% vs Vector RAG 50%。这是真实金融文档 QA benchmark,不是 toy 数据。
7.1 PageIndex 不适合什么场景#
我读完代码后的判断,PageIndex 在以下场景下不划算:
- 短文档(< 10 页):reasoning 成本超过直接读全文
- FAQ 类简单问答:向量检索够快,reasoning 是 overkill
- 需要 sub-100ms 响应:每次查询至少一次 LLM round-trip,延迟天然大
- 多文档无结构化目录:PageIndex 假设文档有 TOC,如果是 wiki / 论坛爬下来的没有目录的文本,得先建 TOC
如果你有长文档 + 高准确 + 可解释这三个诉求,PageIndex 是当前唯一一个把这三个同时搞定的开源方案。
八、读源码学到的 5 件事#
8.1 把”信息检索”重新定位为”树搜索 + reasoning”#
这是 PageIndex 给我最大的冲击。它不是在「向量检索」上加技巧,而是把问题换了一个范式。这种”换范式 > 优化”的工程判断,在很多领域都是值得学习的——
- 数据库从行存改成列存,查询从「全表扫」变成「列扫描 + SIMD」
- 编译从解释执行改成 JIT,计算从「逐条指令」变成「trace 优化」
- ML 推理从 dense retrieval 改成 late interaction,匹配从「整体相似」变成「token 级」
范式对了,优化才有意义。
8.2 文档树 cost model:工程优化的硬核#
tree_optimize.py 的成本模型把”搜索代价”量化成 page 单位,然后用 merge/expand 两个操作全局优化——这是把 ML/IR 工程师的工作降维到”纯算法可解”的问题。
我能直接复用这条思路的两个地方:
- 代码搜索:把代码库按目录建树,用 cost model 决定哪些目录该 merge 哪些该 expand
- 知识库问答:企业 wiki 按章节建树,用 cost model 优化,reasoning 检索走能大幅提升问答准确率
8.3 tool 契约 + 云端/本地是同款 = 工程体验要小#
TOOL_CONTRACT 字典 + client.py 的双重实现,是关键设计哲学:本地/云模式共享 agent 行为代码,只动到底层 IO。这让本地路径天然就有一个”云端对照逻辑”——任何本地能跑的工具,云端都有等价物。
这种”接口一致性 + 实现多态性”在大型系统里非常重要——否则本地和云会越走越远。
8.4 “永远不抛异常” 是个被低估的设计#
agent_tools.py 把所有错误(参数错误、解析错误、内部错误)都包装成和云端 emit 的同一种 JSON 包装返回,只有云端特定错误才重新抛——这是为了让 agent prompt 的 error handling 逻辑能在本地/云端复用。
如果本地抛 KeyError,云端抛 HTTPError,agent 就得写两套 error handling,逻辑会发散。统一返回包装,本质是给 agent 一个稳定的 interface。
8.5 摘要的「双层」设计:summary + prefix_summary#
每个节点同时存 summary(本节内容)和 prefix_summary(父节点摘要)——prefix_summary 来自父节点,用于告诉 agent「这个子节在父节里的角色是什么」。
这是个非常细的工程考量:没有 prefix_summary,子节点的 summary 单独看是合理的,但放进父节点里可能意思完全相反(比如父节是「缺点」,子节 summary 是「稳定」——光看 summary 会以为是优点)。
九、可复用方法论:读”AI 原生应用”源码的正确姿势#
读完 PageIndex,我把读”AI 原生应用”源码的方法论总结成 4 步,和读传统工具源码不一样:
- 先看「问题重新定位」的段落——PageIndex 是把 IR 换成了”tree search + reasoning”。这种”换问题”的判断是 AI 原生应用的核心价值。
- 看「工具契约」的定义——
TOOL_CONTRACT字典定义了 agent 能干什么。这种契约比具体实现更重要——它定义了 agent 的”操作空间”。 - 看「持久化产物」——PageIndex 的
tree.json是核心产物,所有 reasoning 都基于它。读懂 tree.json = 读懂整个系统。 - 看「Cost model / 优化目标」——
tree_optimize.py的 cost model 是 PageIndex 工程价值的根。读懂它,就理解了为什么 PageIndex 比 Vector RAG 强。
这套方法论同样适用于读 OpenAI Function Calling 的应用、读 LangChain 的核心模块、读 LlamaIndex 的 index 抽象。
十、写在最后#
VectifyAI/PageIndex 不是一个”完美”的项目——它依赖 LLM 推理,每次查询都要烧 tokens;它的树优化是工程经验,没有理论保证;它的 MCP 集成要求用户接受云端服务的依赖。但它做对了一件事:
把”为什么相似度 ≠ 相关性”这件事,用 12000 行代码 + 清晰的 cost model + 38.7% vs 50% 的 FinanceBench 数字说清楚了。
这是 2025-2026 年 RAG 领域为数不多真的在重新定位问题的项目。Vector RAG 是 2022 时代的范式,PageIndex 是 2026 时代的范式——前者用算法拟合语义,后者让 LLM 直接 reasoning 语义。
如果你做 RAG,我把它推荐给你。读它能让你想清楚两件事:
- 你的文档是「长单文档」还是「短多文档」?
- 你的诉求是「top-k 召回」还是「答案带页码」?
参考与引文#
本文涉及的所有引用都来自 VectifyAI/PageIndex 仓库本身,以下是我精读过的核心文件:
pageindex/page_index_md.py(345 行)—— Markdown 版树生成(extract_nodes_from_markdown、generate_summaries_for_structure_md)pageindex/page_index_classic.py(1325 行)—— PDF 版树生成(PyMuPDF + 标题检测 + TOC)pageindex/tree_optimize.py(1008 行)—— 核心:cost model + merge / expand / merge_same_pagepageindex/local_chat.py(1545 行)—— 本地 Reasoning 主流程 + 多轮历史 + 协议转换pageindex/agent_tools.py(1777 行)—— MCP tool 契约 + 本地/云端一致性pageindex/client.py(2709 行)—— 统一 SDK client(local + cloud)pageindex/utils.py(1295 行)—— 异步 LLM 调用 + token 计数 + 树转 list 等工具README.md—— 完整文档 + benchmark + cost 对比图cookbook/pageindex-flash-demo.ipynb—— PageIndex Flash 快速建树教程
仓库地址:github.com/VectifyAI/PageIndex ↗
当前版本:0.2.10 / MIT License / 作者 Ray(@vectify.ai)
关于配图:本文两张图都是用 matplotlib 重新画的——
img1-tree-cost-model.png是文档树成本模型,把tree_optimize.py头 30 行的S(v) / R(v) / tree_cost(v)心智画清楚;img2-pipeline.png是两阶段流程图,把page_index_md.py + tree_optimize.py + local_chat.py三件事串成一张链路图。原 README 里用 PNG / WebP 渲染了 4 张 benchmark 成本图,我的重画目的是把”成本模型”和”两阶段解耦”这两个工程核心可视化讲出来。