深入解析 quiche:一个 Rust 馅饼,怎么装下 Cloudflare 的传输层
💬 评论Cloudflare 的 QUIC/HTTP3 实现 quiche:11 个 crate、14 万行 Rust、一个 86 字段的 Connection。从 3 倍反放大预算、PMTUD 二分搜索到零拷贝发包,拆解一个生产级传输协议库的工程内涵。
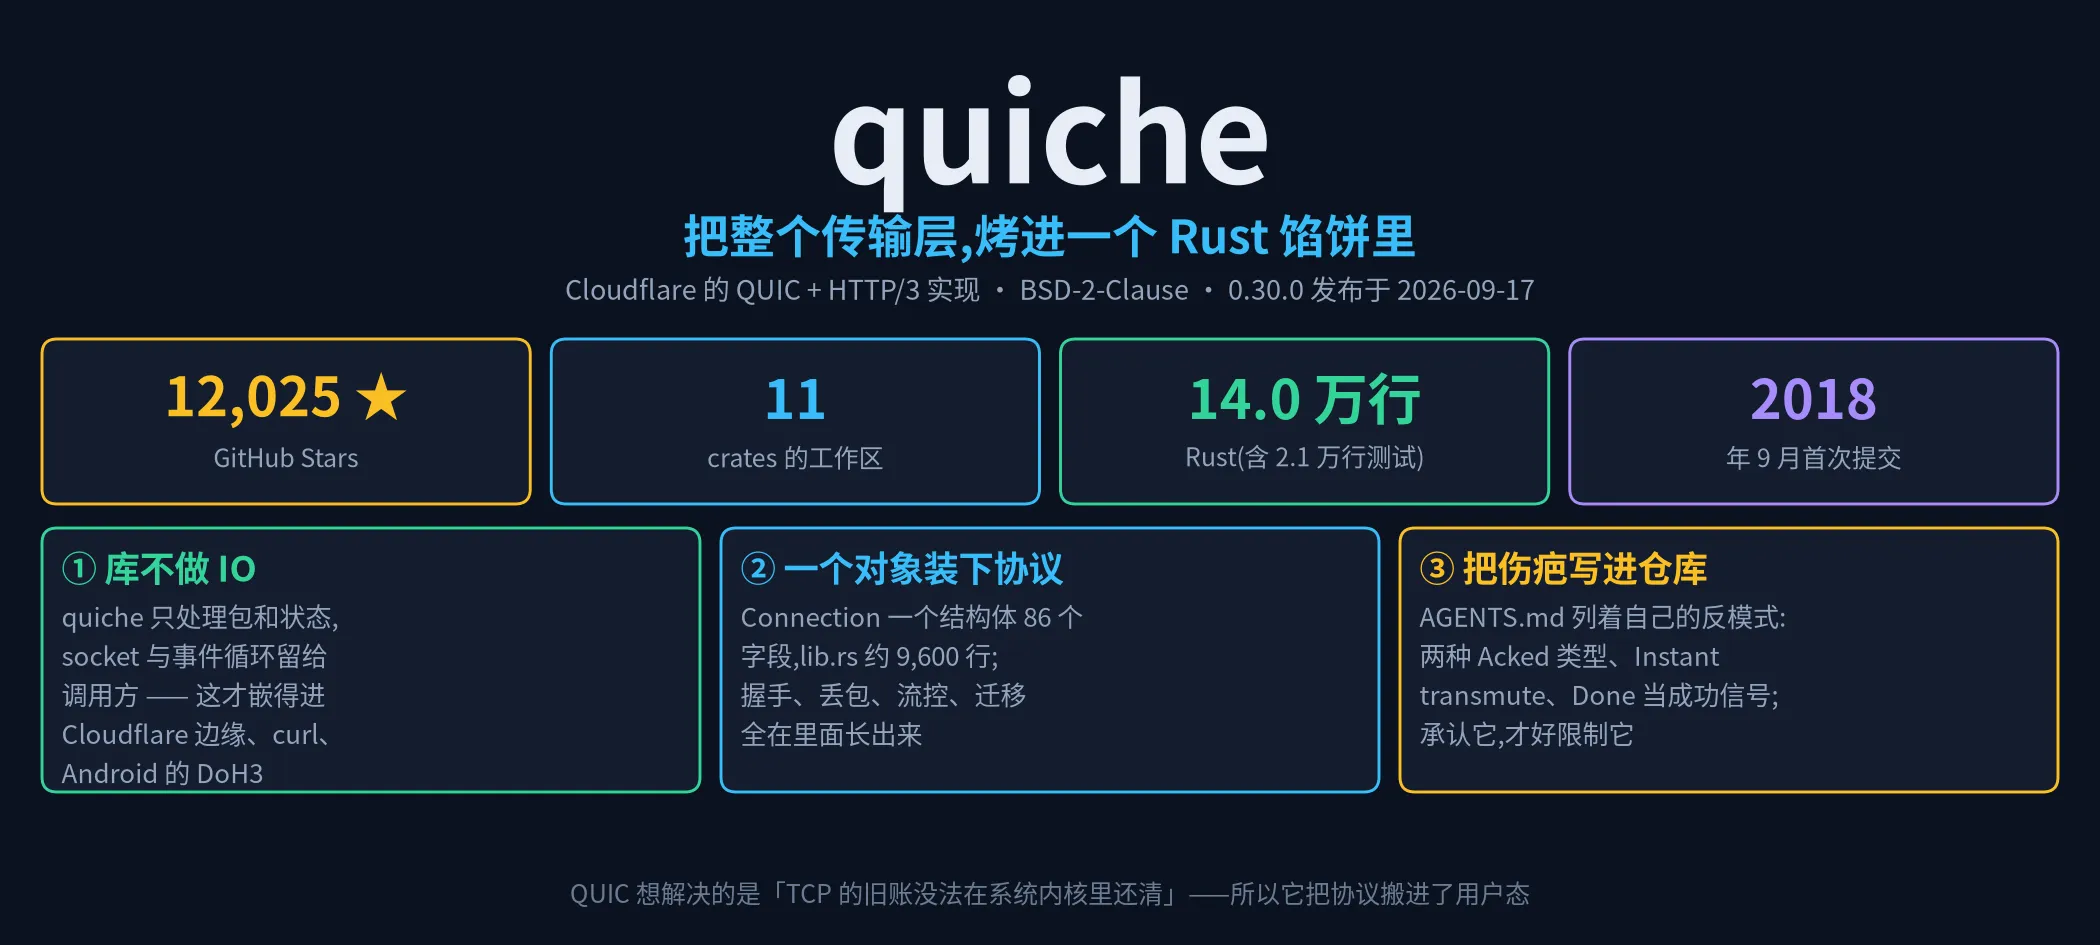
仓库:cloudflare/quiche ↗ BSD-2-Clause · 0.30.0 发布于 2026-09-17 · 12,025 stars / 1,117 forks(2026-09-20 抓取) 11 个 crate · 228 个
.rs文件 · 14.0 万行 Rust(含 2.1 万行测试)· 210 个源文件带着 BSD 版权头
先讲一个”改不动”的故事#
想理解 quiche 为什么存在,得先接受一件稍微反直觉的事:TCP 已经改不动了。
不是没人想改。1981 年的 RFC 793 定下了 TCP,TCP 快速重传、SACK、窗口缩放、时间戳、拥塞控制算法(CUBIC、BBR)……四十年里每一代都加了东西。问题是这些东西全都在操作系统内核里,而内核的升级周期是按年算的:一个新特性要先进 Linux,再进各大发行版,再进各种 Android 分支,再等设备换代。数据中心里升级内核相对容易,但你手机里的 TCP 栈呢?你家路由器里的呢?
更麻烦的是”协议僵化”(ossification)。那些你看不见的中间盒——防火墙、NAT、负载均衡、运营商的各种加速设备——会偷偷假设 TCP 报文长什么样。任何改动只要看起来”不像 TCP”,就会被丢掉。于是协议演化变成了一场和世界中立设备的谈判。
HTTP/2 试过一条折中路:把多路复用做到应用层。结果呢?所有流还是共享同一条 TCP 连接,一个包丢了,所有流一起等,这就是队头阻塞。你在 TCP 上打补丁,永远解决不了 TCP 自己的问题。
QUIC 的答案是:不谈判了,把传输层搬到用户态重写一遍。它有 TCP 的重传与流控、有 TLS 1.3 的握手、有 HTTP/2 级别的多路复用,并且强制加密——加密意味着中间盒想插手也得先解开,而它解不开。协议住在应用自己的进程里,想改就改,一次发布就是一个新版本。
代价也很实在:每个字节的收发都要你自己处理,每一条连接的状态都要你自己维护,每一个定时器都要你自己管。于是问题来了——一个生产级的 QUIC 实现,到底该把哪些东西交给调用方,又该自己扛住什么?
quiche 是 Cloudflare 的答卷。它 2019 年 1 月 22 日随博客文章《Enjoy a slice of QUIC, and Rust!》开源,作者是 Alessandro Ghedini。名字不是缩写,就是一种法式咸派——不过用”馅饼”来比喻一个协议库倒挺贴切:协议规范里那些零零碎碎的规则,最后都得被塞进一张皮里烤熟。
一、先看家底:它被谁用,又被用在什么位置#
判断一个协议库值不值得细读,有个很快的办法:看它的使用者是”谁,在什么环境下”。因为协议库最怕的不是功能少,而是被塞进一个它没设想过的环境之后,崩得莫名其妙。
quiche 的 README 自己列了三类使用者,而且这三类几乎没有交集:
- Cloudflare 边缘网络:quiche 直接支撑 Cloudflare 边缘的 HTTP/3 支持。边缘意味着什么?一台机器上几十上百万条连接,CPU 核数有限,任何一个”顺手多复制一次内存”都会变成账单。
- Android 的 DNS 解析器:它用 quiche 实现 DNS over HTTP/3(Google 安全博客 2022 年那篇讲的就是这件事)。手机上是完全不同的世界:网络随时切换、IP 地址随时变、电量敏感。
- curl:curl 可以把 quiche 当中一个实验性的 HTTP/3 后端接进来。
一个库同时服务 CDN 边缘、手机系统组件和命令行工具,这件事本身就决定了它的 API 形状。往下看你会反复看到同一个设计选择:能交出去的责任就交出去,只把真正需要集中管理的东西留在库里。
先把数字放在一起,后面所有讨论都建立在这张表上:
| 维度 | 数字 |
|---|---|
| 首次提交 | 2018-09-29(仓库创建) |
| 最新版本 | 0.30.0,2026-09-17 发布 |
| Stars / Forks | 12,025 / 1,117 |
| Crate 数量 | 11 个(含 1 个已废弃) |
| Rust 代码 | 140,396 行(其中 21,118 行在测试文件里) |
| 许可 | BSD-2-Clause(源码文件逐个带版权头,210/228) |
quiche/src/lib.rs | 9,612 行,含 86 个字段的 Connection 和 158 个 pub fn |
注意最后两行:lib.rs 里塞了 9,600 行。这不是”没来得及拆”,而是一个深思熟虑过的取舍——我们后面会专门聊这件事。
到这里只是知道了它是谁。真正有意思的问题从下一节开始:一个这样的库,应该向调用方暴露什么?
二、第一条设计原则:库不碰 socket,但敢借你的时钟#
如果你写过 TCP 或 UDP 的代码,习惯的动作是这样的:创建 socket、bind、recv、send、select/epoll……socket 是你的事,协议栈是内核的事,两者之间那条线清清楚楚。
QUIC 把协议栈搬到了用户态,这条线就必须重新画。画偏一点点,库就废了——要么管得太多,嵌不进别人的事件循环;要么管得太少,什么都要调用方自己实现。
quiche 在 2019 年那篇开源博客里把这条线说得很直接(原文引自 Cloudflare 博客):
The quiche API can process QUIC packets received from network sockets and generate packets to send back, but will not touch the sockets themselves.
The application also needs to handle timers, with quiche telling it when to wake-up.
翻译成大白话:包怎么收怎么发,是你的事;但这些包意味着什么,是我的事。 这条线在代码里体现为三个小结构:
/// Ancillary information about incoming packets.
pub struct RecvInfo {
    pub from: SocketAddr,   // 这个包从哪来
    pub to: SocketAddr,     // 落到哪个本地地址上
}

/// Ancillary information about outgoing packets.
pub struct SendInfo {
    pub from: SocketAddr,
    pub to: SocketAddr,
    pub at: Instant,        // 这个包应该在哪一刻发出去
}RecvInfo 好理解:QUIC 的连接可能迁移,同一份连接数据从不同源地址来是天生合法的,库必须知道地址才能判断”这是不是一个新路径”。真正值得多看一眼的是 SendInfo.at。
其他协议库的常见做法是:库自己 sleep、自己定时发送。quiche 反过来——它算出时间点,把时间点交给你。原因是 QUIC 需要做 pacing(按带宽估计把包均匀铺开,而不是一拥而出),而”怎么等待”在不同环境里差别巨大:边缘网络上百万条连接共用一个事件循环,手机上要尽量少唤醒 CPU。库强行 sleep,等于把自己的调度策略强加给所有人。
同样的逻辑延伸到定时器:
/// Returns when the next timeout event will occur.
///
/// Once the timeout Instant has been reached, the [`on_timeout()`] method
/// should be called. A timeout of `None` means that the timer should be disarmed.
pub fn timeout_instant(&self) -> Option<Instant> {
    if self.is_closed() { return None; }
    if self.is_draining() { return self.draining_timer; }

    let path_timer = self.paths.iter()
        .filter_map(|(_, p)| p.recovery.loss_detection_timer()).min();
    let key_update_timer = self.crypto_ctx[packet::Epoch::Application]
        .key_update.as_ref().map(|ku| ku.timer);

    [self.idle_timer, path_timer, key_update_timer]
        .iter().filter_map(|&x| x).min()   // 取最近的那个
}一个 min() 里藏着三个来源完全不同的定时器:空闲超时(多久没流量就断开)、每一条路径各自的丢包检测定时器(要重传了)、密钥更新定时器(要不要换密钥)。谁最近就返回谁,调用方只需要按这个时间去叫 on_timeout()。
这就是”库到底该管什么”的一个好答案: 协议内部的复杂性(密钥轮换、丢包判定、路径状态)全部留在库里;与外部世界交互的部分(IO、调度、时钟)全部交出去。库不具备”等待”这个能力,只具备”告诉你什么时候该来”这个能力。
这个选择带来的回报,就是它后来能被塞进三个完全不同的地方:边缘上那个至今还是 C 写的 nginx 分支、Android 系统里的网络组件、以及 curl。为了后面这一类使用者,quiche/src/ffi.rs 提供了 148 个 extern "C" 函数,把 Rust API 一对一映射成 C API——quiche_conn_recv、quiche_conn_send、quiche_conn_timeout_as_nanos……形状和 Rust 侧完全一致。
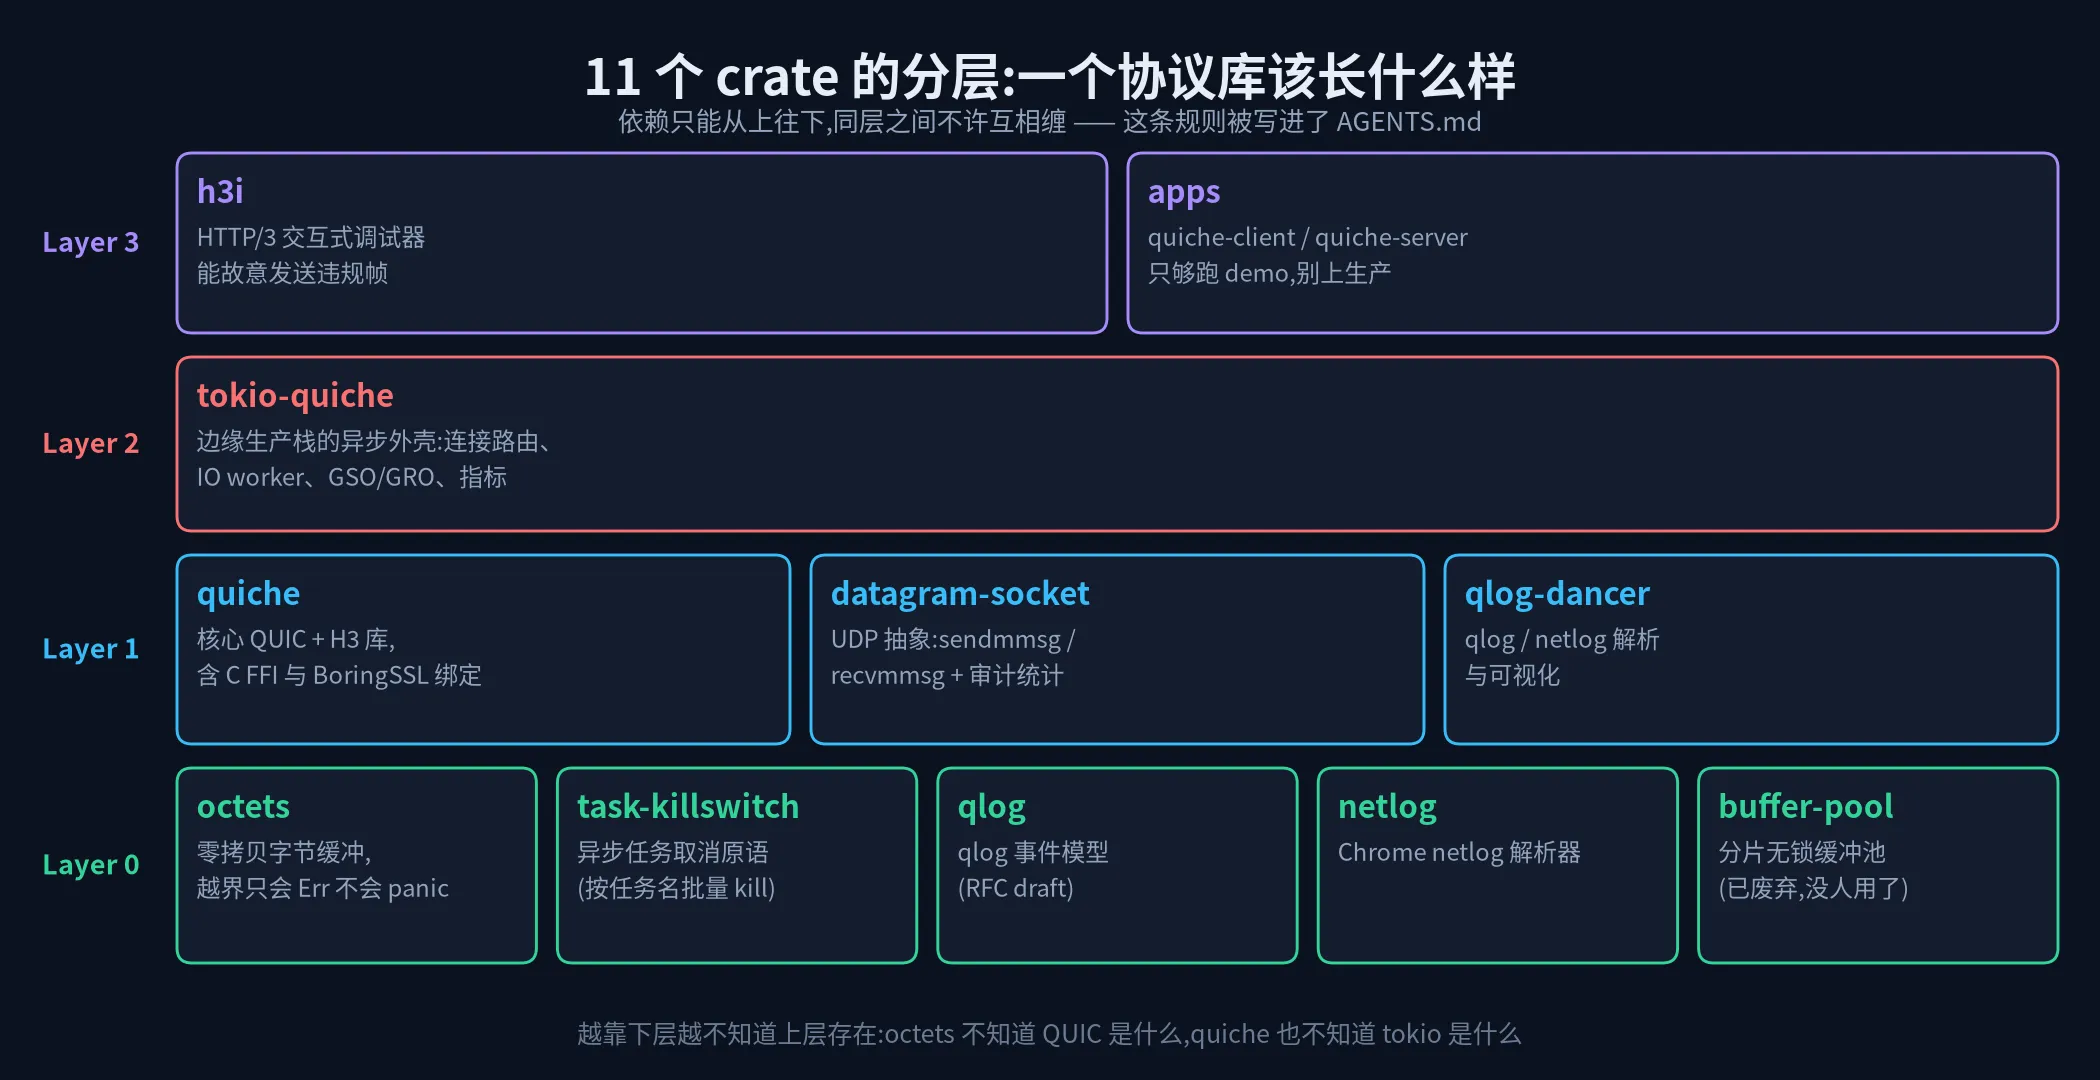
上面这张图是整个工作区的俯视图。有意思的不是”有 11 个 crate”,而是它们的分层规则:依赖只能从上往下,同层之间不许互相缠。这条规则不是我猜的,它写在仓库的 AGENTS.md 里。
- Layer 0(不依赖工作区内任何 crate):
octets(字节缓冲与解析)、task-killswitch(异步任务取消)、qlog(日志事件模型)、netlog(Chrome 网络日志解析)、buffer-pool(已废弃的分片缓冲池,仓库里明写着”没人用了”)。 - Layer 1(协议本体):
quiche核心、datagram-socket(UDP 抽象层,提供了sendmmsg/recvmmsg封装和审计统计)、qlog-dancer(日志解析与可视化)。 - Layer 2(异步外壳):
tokio-quiche,Cloudflare 边缘生产栈的 tokio 形态:连接路由、IO worker、GSO/GRO、指标。 - Layer 3(端到端工具):
h3i(HTTP/3 交互式调试器,能故意发违规帧)、apps(命令行 demo,README 里专门提醒”不适合生产”)。
这个分层的洁癖有个副作用:你可以在完全不引入 tokio 的情况下用最底层的 octets,也可以在完全不理解 QUIC 的前提下用 qlog-dancer 看别人的日志。一个协议项目最容易腐坏的地方就是所有东西缠在一起,而它的抗体就是这条分层规则。
三、一个 UDP 包进来之后,依次发生什么#
现在把视角放到最小单位上:一个 UDP 数据报被 recv() 收进来,quiche 要做什么?
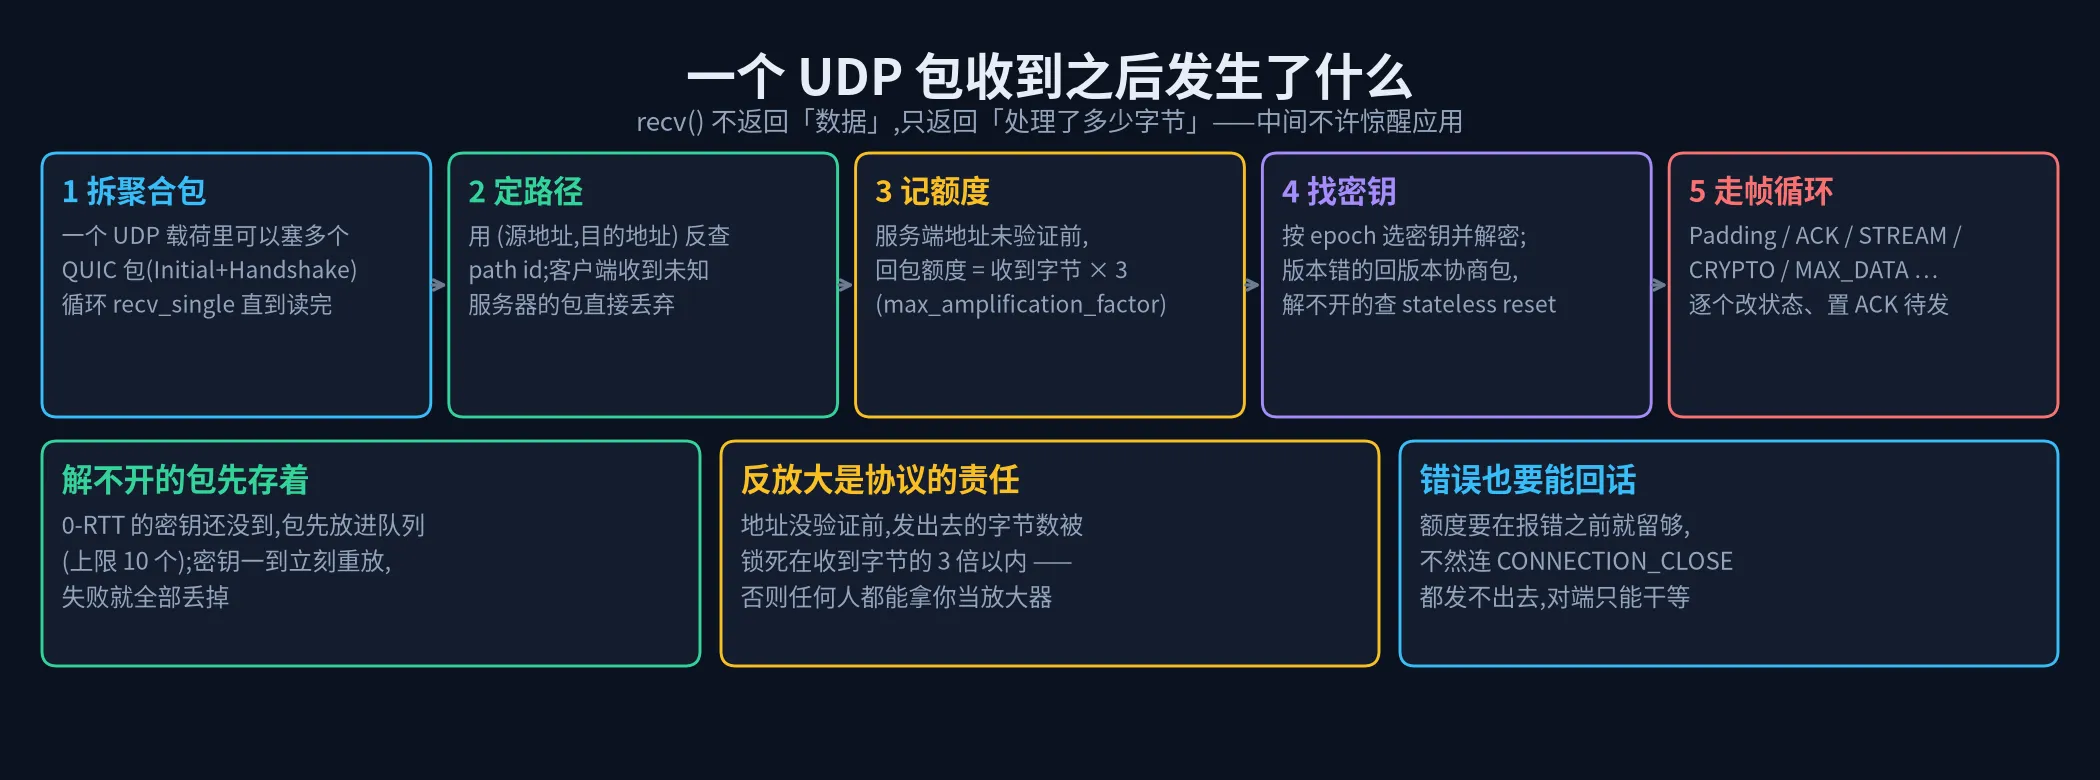
第一步:拆聚合包。 一个 UDP 载荷里可以塞好几个 QUIC 包(典型场景是客户端把 Initial 和 Handshake 拼在一个数据报里发)。recv() 会循环调用 recv_single(),直到把缓冲区读完。这里的返回语义被刻意设计过两次:recv() 返回的是处理了多少字节,不是”数据”——QUIC 是流协议,数据要另外从流里读;而 recv_single() 返回的 Error::Done 也不是错误,是”这个数据报剩下的部分不用处理了”的信号。
第二步:定路径。 用 (info.to, info.from) 反查路径 id。如果查不到:
} else if !self.is_server {
    // If a client receives packets from an unknown server address,
    // the client MUST discard these packets.
    return Ok(len);   // 丢弃,但算作"处理过了"
}服务端这边则相反——它必须接受来自新地址的包,因为那可能是连接迁移。同一个条件,两个方向两种处理,这是 QUIC 状态机的常态。
第三步:记额度。 这一段的注释值得原样抄下来,它把”为什么”讲透了:
// Keep track of how many bytes we received from the client, so we
// can limit bytes sent back before address validation, to a
// multiple of this. The limit needs to be increased early on, so
// that if there is an error there is enough credit to send a
// CONNECTION_CLOSE.
//
// It doesn't matter if the packets received were valid or not, we
// only need to track the total amount of bytes received.
if self.is_server && !recv_path.verified_peer_address {
    recv_path.max_send_bytes += len * self.max_amplification_factor;
}默认放大系数是 3。这条规则防的是放大攻击:攻击者伪装成受害者的 IP 发送一个小请求,服务器回一个大响应,受害者被淹没。所以”在对端地址被验证之前,回包总量不能超过收到总量的 3 倍”。
注意上面注释里的第二句理由:额度必须提前加,而不是等验证通过再加。因为如果后面发现包有问题,服务器还得能把这个错误告诉对端——而发 CONNECTION_CLOSE 也要花额度。一个细节:如果额度记晚了,连接就只能在沉默中失败。
第四步:找密钥。 用包头的 DCID 长度等字段解析出 Header,再按 epoch(Initial / Handshake / 0-RTT / 1-RTT)选对应的密钥解密。三种”异常输入”在这里被分门别类:
- 版本对不上 → 回一个版本协商包(
negotiate_version()),并用did_version_negotiation标记避免重复回应同一轮协商。判定用的是掩码0xfafafafa:符合这个形状的版本号是”自己人埋的雷”(greasing),按约定必须忽略——那为什么还要专门写一段逻辑去匹配它?因为忽略也是有成本的,至少要能快速认出它、不去做无用的协商。 - 包太短或对不上任何 token → 可能是
stateless reset(对端已经忘了这条连接,用一个随机令牌告诉你”别再发了”)。quiche 的判定是:buf_len < 21直接丢,否则用固定时间比较函数比对末 16 字节的令牌——比较必须用常量时间的函数,否则这里会变成一个可测量的信号。 - 包解不开,但看起来像 0-RTT → 先存起来,别丢。
最后这条是 QUIC 一个很有意思的设计后果。客户端可以在第一次握手的”第二个来回”就带着 0-RTT 数据发过来,但服务器此时可能还没收到自己发出的 0-RTT 密钥。包就在门口了,怎么办?
fn process_undecrypted_0rtt_packets(&mut self) -> Result<()> {
    if self.crypto_ctx[packet::Epoch::Application].crypto_0rtt_open.is_some() {
        while let Some((mut pkt, info)) = self.undecryptable_pkts.pop_front() {
            if let Err(e) = self.recv(&mut pkt, info) {   // 注意:重新进 recv
                self.undecryptable_pkts.clear();
                return Err(e);
            }
        }
    }
    Ok(())
}密钥一到,把缓存的包重新喂回 recv()。所以 recv() 实际上是可以重入的,而重入的深度被一个上限管住:MAX_UNDECRYPTABLE_PACKETS = 10。10 个包听起来很小,但这是刻意的小——缓存的每一个包都是一份内存,而它对应的连接可能永远不会完成握手。在服务器上,每一个”先存着”的队列都是一份可以被滥用的资源。
第五步:走帧循环。 解密之后的载荷是一串帧,recv_single() 里的循环逐个处理:Padding 跳过、ACK 喂给恢复模块、STREAM 写进流、CRYPTO 喂给 TLS、MAX_DATA 更新流控窗口……处理完的副作用不是立刻发包,而是标记状态,等 send() 时统一结算。
把这五步放在一起看,会发现它们的共同点:每一步都在处理”这个世界不守规矩”的情况——包是坏的、地址是假的、密钥还没到、版本是别人埋的雷。协议库的绝大部分代码不是写”正常流程”,而是写”异常流程要怎么办”。这也解释了为什么它的测试有 2 万多行。
四、Connection:为什么一个结构体装下了整个协议#
quiche/src/lib.rs 有 9,612 行。其中 Connection 这一个结构体有 86 个字段、158 个 pub fn。第一次看到这个数字,职业本能是皱眉:这不就是”上帝对象”吗?
想反对这个判断,得先看它到底装了什么。
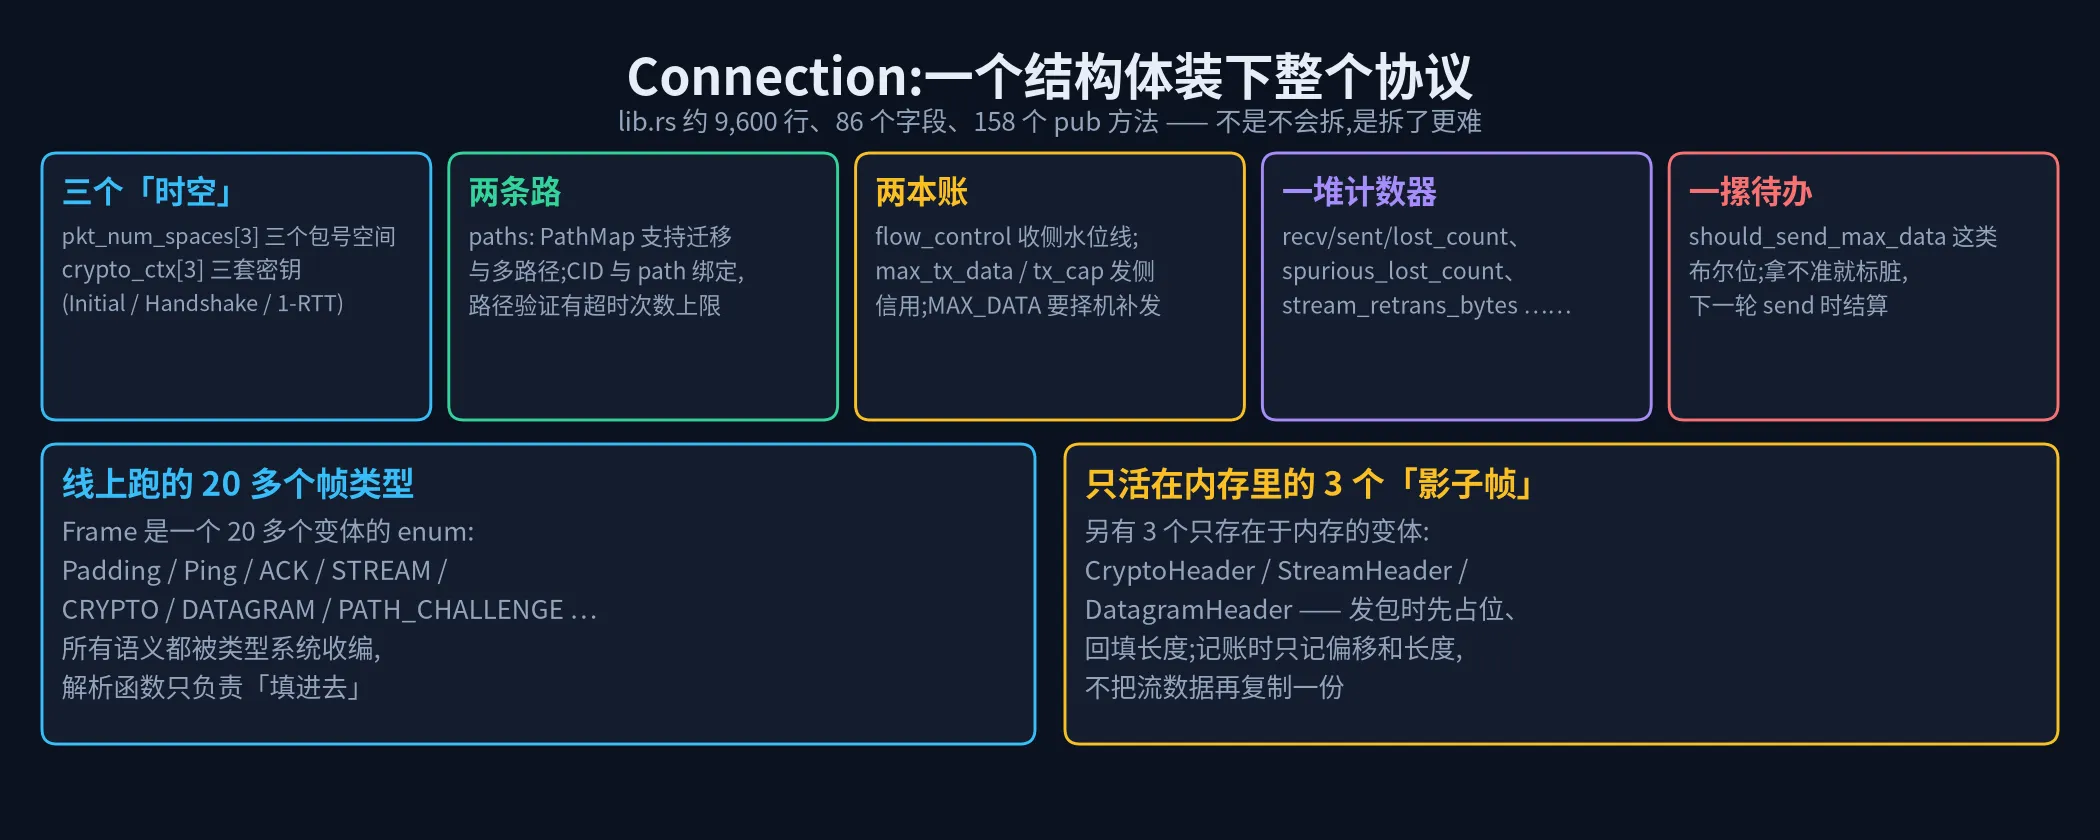
拆开来看,86 个字段大致分五类抽屉:
- 三个”时空”:
pkt_num_spaces[3]与crypto_ctx[3]。QUIC 有三个互不干扰的包号空间与密钥世代(Initial / Handshake / 1-RTT),丢失与重排都在各自空间里独立判定。 - 两条路:
paths: PathMap支持连接迁移与多路径。CID 与 path 绑定,路径验证有超时次数上限(MAX_PROBING_TIMEOUTS = 3),探测包最小长度是 25 字节——正好是PATH_CHALLENGE帧 (9 字节) + AEAD tag (16 字节)。 - 两本账:收侧是
flow_control的水位线,发侧是max_tx_data/tx_cap这类信用。连接级窗口最大 24 MiB,且必须比流级窗口大,倍数写死为CONNECTION_WINDOW_FACTOR = 1.5。 - 一堆计数器:
recv/sent/lost_count、spurious_lost_count(被误判丢失的包数)、stream_retrans_bytes…… - 一摞待办:
should_send_max_data这种布尔位。收包过程中拿不准要不要发帧,就先标脏,等下一轮send()时统一结算。
这五类抽屉之间的关系是:它们几乎两两之间都会互相影响。收到一个 ACK,会改计数器、可能腾出流控信用、可能解除路径验证、可能触发密钥更新;而任何一个状态变化都可能让之前”不该发”的帧变成”该发”的。
把这样一堆东西拆成十个对象、互相通过接口调用的代价是什么?是每一次状态判断都要跨模块、每一个共享的计数都要考虑借用冲突,而 Rust 的借用检查器会把这种痛苦诚实地放大给你。所以 lib.rs 的作者选了另一条路:把状态集中在一个结构体里,把复杂性控制在”可读”而不是”可组合”。
这个选择不代表代码是拍脑袋堆上去的。恰恰相反,里面有几个很讲究的细节。
细节一:Frame 有 27 个变体,其中 3 个只活在内存里。
线上跑的 24 个帧类型(Padding、Ping、ACK、STREAM、CRYPTO、NEW_TOKEN、MAX_DATA、PATH_CHALLENGE、NEW_CONNECTION_ID、DATAGRAM……)都是有线格式的。此外还有三个影子变体:
CryptoHeader { offset: u64, length: usize },
StreamHeader { stream_id: u64, offset: u64, length: usize, fin: bool },
DatagramHeader { length: usize },它们不对应任何线格式,存在的理由是记账。当 quiche 发一个 STREAM 帧时,流数据早就躺在发送缓冲里了,如果为了”等下可能丢包重传”再把这段数据复制一份记到已发包列表里,内存就会被复制一遍——在每秒几百万包的场景里这是不可接受的。所以记账时只记偏移和长度,真要重传时再回头从缓冲里取。
细节二:发帧是”先写正文,再回填表头”。
// Write stream data into the packet buffer.
let (len, _) = crypto_ctx.crypto_stream.send
    .emit(&mut crypto_payload.as_mut()[..max_len])?;

// Encode the frame's header.
//
// Due to how `OctetsMut::split_at()` works, `crypto_hdr` starts
// from the initial offset of `b` (rather than the current
// offset), so it needs to be advanced to the initial frame offset.
crypto_hdr.skip(hdr_off)?;
frame::encode_crypto_header(crypto_off, len as u64, &mut crypto_hdr)?;为什么要绕这一步?因为帧头里要写”这段数据有多长”,而长度只有把数据写进去之后才知道。同时长度又会决定这个包还能不能装下这个帧——装不下就得整个放弃,不能只写一半。
这两件事被一个 12 行的宏管住:
macro_rules! push_frame_to_pkt {
    ($out:expr, $frames:expr, $frame:expr, $left:expr) => {{
        if $frame.wire_len() <= $left {
            $left -= $frame.wire_len();
            $frame.to_bytes(&mut $out)?;
            $frames.push($frame);
            true
        } else {
            false      // 放不下就是不放,由调用方决定后面怎么办
        }
    }};
}细节三:范围集合为绝大多数连接省下一次分配。
ACK 要记录”我收到了哪些包号”,丢包检测要记录”哪些区间已经确认”。这些数据结构在形态上很相似,都是”不重叠的区间集合”。quiche 的实现有两种:
const MAX_INLINE_CAPACITY: usize = 4;

pub enum RangeSet {
    Inline(InlineRangeSet),   // SmallVec<[(u64, u64); 4]>,不分配堆内存
    BTree(BTreeRangeSet),     // BTreeMap,装任意多
}绝大多数连接的丢包区间不超过 4 个,所以默认用内联数组,超了才退化成 B 树。另一个细节是容量溢出时淘汰最小的区间——RangeSet::new(capacity) 的文档直接写了”When the length of a RangeSet overflows capacity it will remove the smallest range”。ACK 区间的容量是 MAX_ACK_RANGES = 68,注释解释了这个数字的来源:
// This represents more or less how many ack blocks can fit in a typical packet.也就是:能塞进一个典型数据报的 ACK 块数量。再多的区间也用不上,因为发不出去。
细节四:CID 的回收是一条流水线。
QUIC 允许对端给你一串连接 ID 备用,每条连接最多可以换几次,于是必须有一套”发出去、等对端退休、再复用”的机制。quiche 里是 BoundedConnectionIdSeqSet,里面有 RETIRED_CONN_ID_LIMIT_MULTIPLIER = 3 这样的倍数,还有 retire_prior_to 语义(对端一句话退休掉一批旧的),以及一个 link_scid_to_path_id 的映射——把连接 ID 和路径绑起来,这样包从一个新地址来的时候,库能立刻判断这是”迁移”还是”有人在乱发”。
看完这些细节,前面那个”为什么 9,600 行”的问题就有了答案:这个文件的规模不是失控,而是一种关于”共享状态”的立场——协议状态机里几乎每个决策都依赖别的状态,与其用十层抽象假装解耦,不如把状态放在一起、把复杂性花在”让每个字段都有明确的所有者与生命周期”上。
顺便说一句,这大概也是这个项目最值得学的一点:架构的干净程度不等于拆分的数量。有些系统适合拆,Connection 这种”每一秒都要做上万次全局判断”的东西,拆开只会让复杂度从”读代码的成本”变成”理解调用图的成本”。
五、拥塞控制:把”换算法”这件事从内核里解放出来#
如果你只从 TCP 时代继承一个印象,那大概是:拥塞控制算法是最难换的东西。原因很简单,它住在内核里。想试一个新算法,得改内核、编译、重启、灰度,还要担心它会不会把线上搞挂。
QUIC 把这一层也搬到了用户态,于是”换拥塞控制”变成一个配置项:
pub enum CongestionControlAlgorithm {
    Reno            = 0,
    CUBIC           = 1,   // 默认
    Bbr2Gcongestion = 4,
}注意那个数字上的缺口:0、1、4,中间少了一个 2。源码里的注释解释了原因——被删掉的变体不能让后面的编号顺移,因为枚举值要跨 FFI 边界,还要能从字符串解析("cubic", "bbr2"),编号一旦漂移,这些接口全部失控。这就是”协议库的接口不是内部接口”的具体体现。
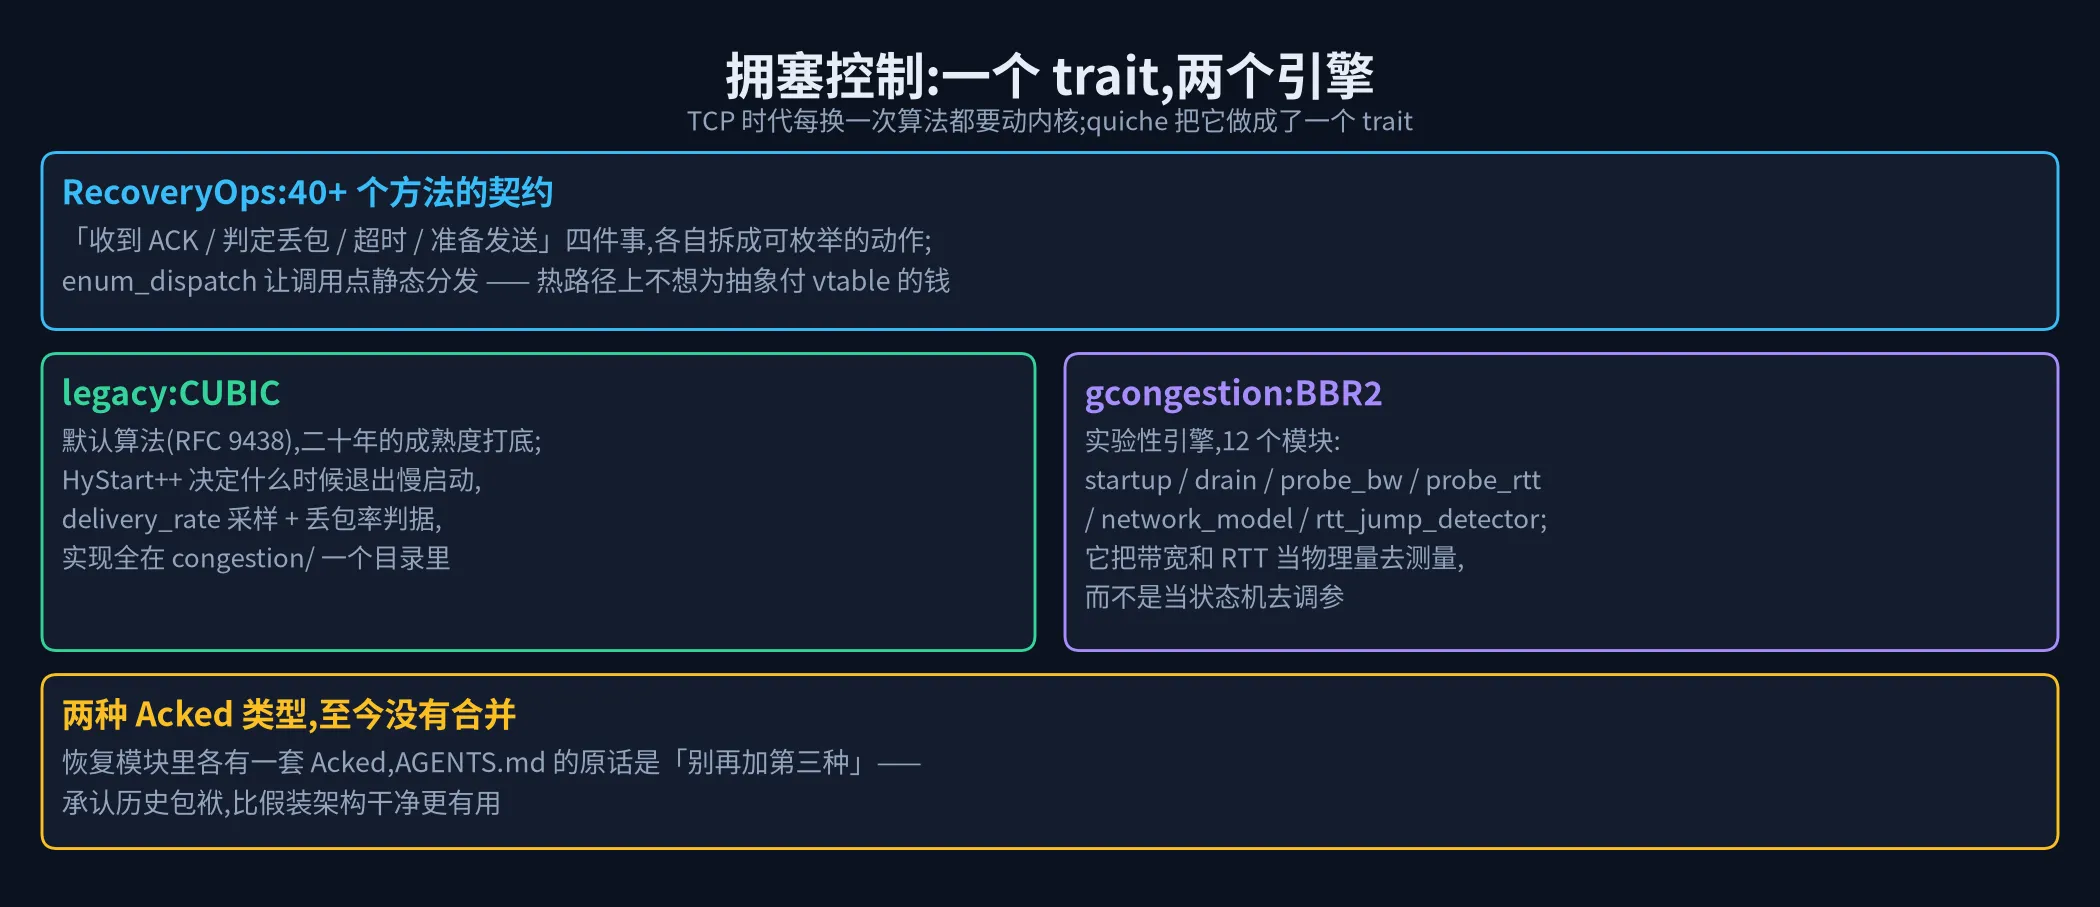
更有意思的是实现的组织方式。恢复模块里有一套 40+ 个方法的 RecoveryOps trait,把”收到 ACK / 判定丢包 / 超时 / 准备发送”这几件事各自拆成可枚举的动作,然后用 enum_dispatch 在 LegacyRecovery 和 GRecovery 两个实现之间静态分发。
为什么不用 dyn?因为这是热路径——每个包都要过一遍。enum_dispatch 的展开结果是 match 加内联调用,不留虚表跳转。在一个每秒处理几百万包的库里,抽象是有价格的,而”用宏把动态分发变成静态分发”是把价格压到最低的常见手法。
两套实现的”代沟”也很有意思,而且作者没有假装它们不存在。模块自己的 AGENTS.md 写得很坦白:
congestion/是老一代:Classic vtable 风格,一个CongestionControlOps结构体里塞静态函数指针(RENO、CUBIC),外加 HyStart++ 慢启动退出、delivery rate 采样、CUBIC 曲线。gcongestion/是新一代:BBR2,从 Google 的 QUIC 实现移植过来,拆成startup/drain/probe_bw/probe_rtt/network_model/rtt_jump_detector六个子状态,加一个令牌桶 pacer。它的世界观和老一代不一样:不是”遇到丢包就缩窗”,而是把带宽和 RTT 当物理量持续测量——RTT 突然跳高就怀疑路径变了,带宽估计要周期性主动探测。
而两套实现并存带来的最难堪的事,写在反模式清单的第一条:Acked 结构体有两个,一个在 congestion/recovery.rs,一个在 gcongestion/mod.rs,至今没有合并。
怎么处理这种”历史包袱”?两份 AGENTS.md 给出的是同一种态度:不修,但登记在册,并且禁止扩散。
Two
Ackedstructs … NOT unified. Do NOT create a third.
这句话我认为比代码本身更值得记下来。绝大多数项目的问题不是”有历史包袱”,而是”历史包袱没有身份”——它散落在代码里,下一个人看到就会照着写第三份。给它一个名字、一条注释、一句”别再加第三种”,它就从一个陷阱变成了一个已知边界。
同一条思路也用在 PMTUD 上。
路径 MTU 发现要解决的问题朴素得让人心疼:包太大了会被网络悄悄丢掉,而且不会告诉你为什么。1500 字节是绝大多数以太网的信仰,但隧道、PPPoE、某些云网络会把上限压得更低。你不知道上限,就只能靠”发大一点试试,看它回不回”。
quiche 的做法是二分搜索,而且把过程写成了一串可验证的断言:
1500 → 1350 → 1275 → 1237 → 1218 → 1209 → 1204 → 1202 → 1201 → 1200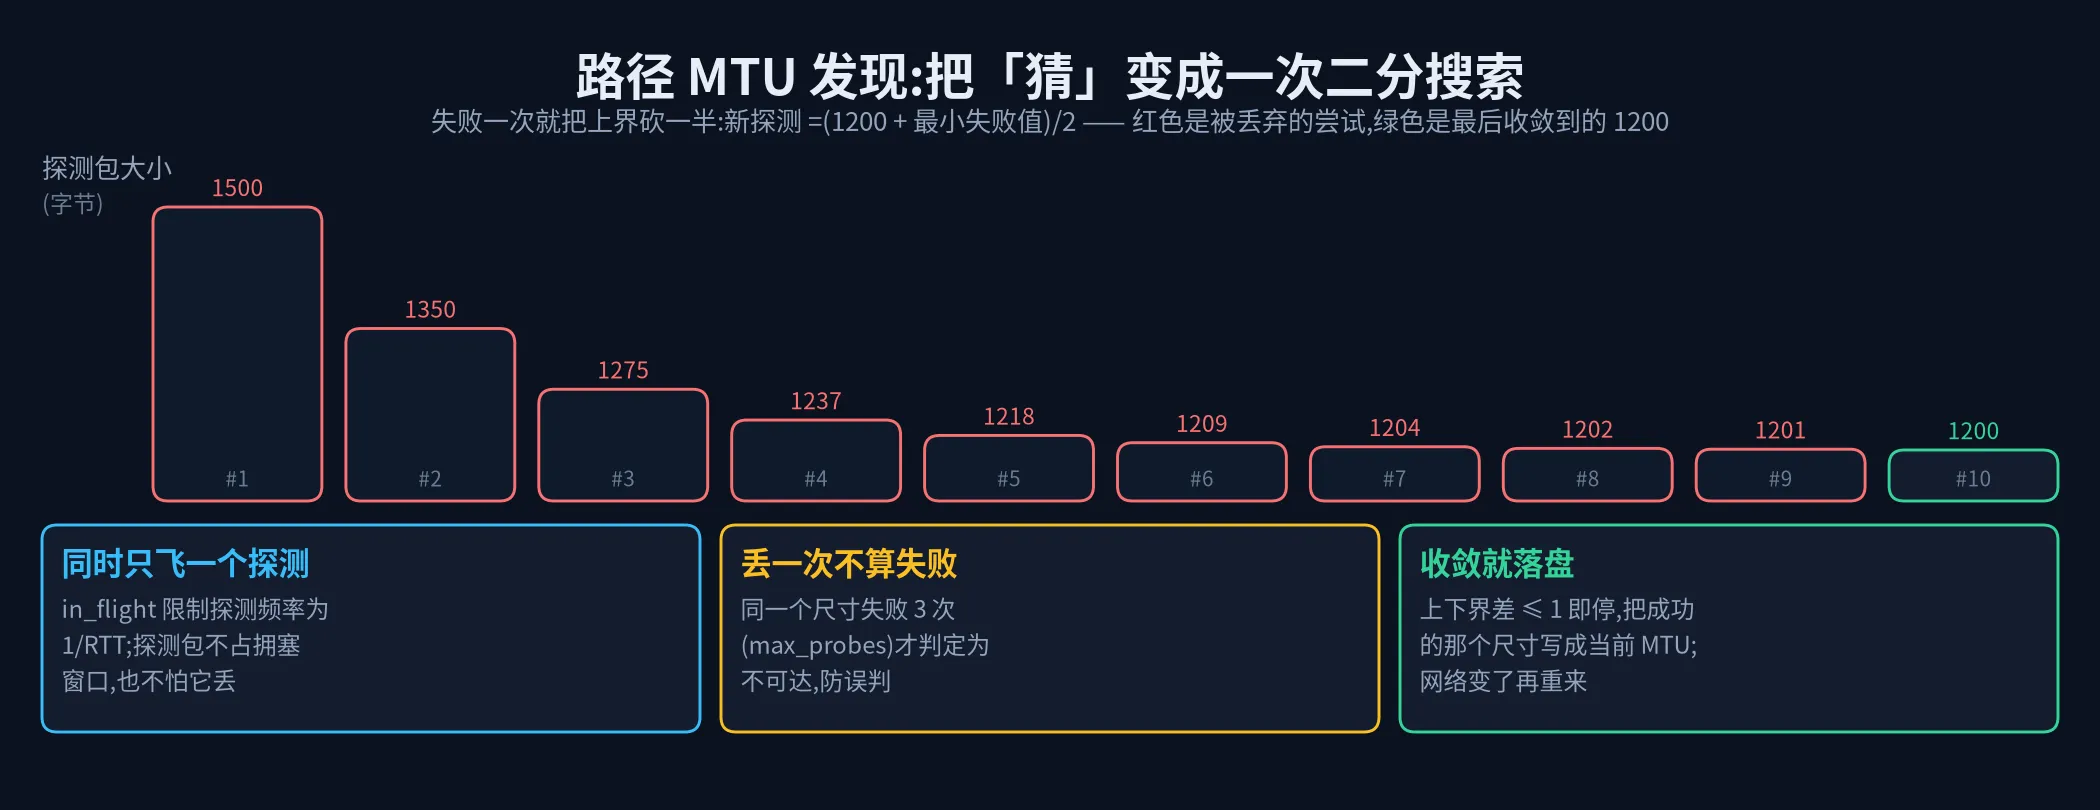
失败一次,就把上界砍一半:新探测 =(最小下界 + 最小失败值)/ 2。最小下界写死在 1200(因为 QUIC Initial 包必须至少 1200 字节,这是协议的硬约束),所以这个搜索永远不会探到荒谬的小值。
三个约束让这个搜索不会变成”自己 DDoS 自己”:
- 同时只允许一个探测在飞:
in_flight限制探测频率为 1/RTT。探测包不占拥塞窗口(它不是为了传数据),但也不允许连发——否则一个丢包的路径会被探测包刷满。 - 失败三次才算失败:
max_probes默认 3。单次丢包太常见了,如果拿去当”MTU 太小”的证据,搜索结果会在噪声里乱跳。 - 收敛后落盘:上下界差 ≤ 1 就停止,把成功的那个尺寸写进路径状态。
这套逻辑最容易被忽略的地方是”谁来触发下一次探测”。答案是:没有专门的定时器线程,它挂在 on_timeout() 里——也就是前面说的,库不睡觉,只在你的时钟上借一个位置。
六、把系统调用和内存当稀缺资源#
到这里,quiche 的”内部”讲得差不多了。但一个在边缘上跑的东西,内部再优雅,只要它跟内核的交互方式不讲究,一样会死在吞吐上。
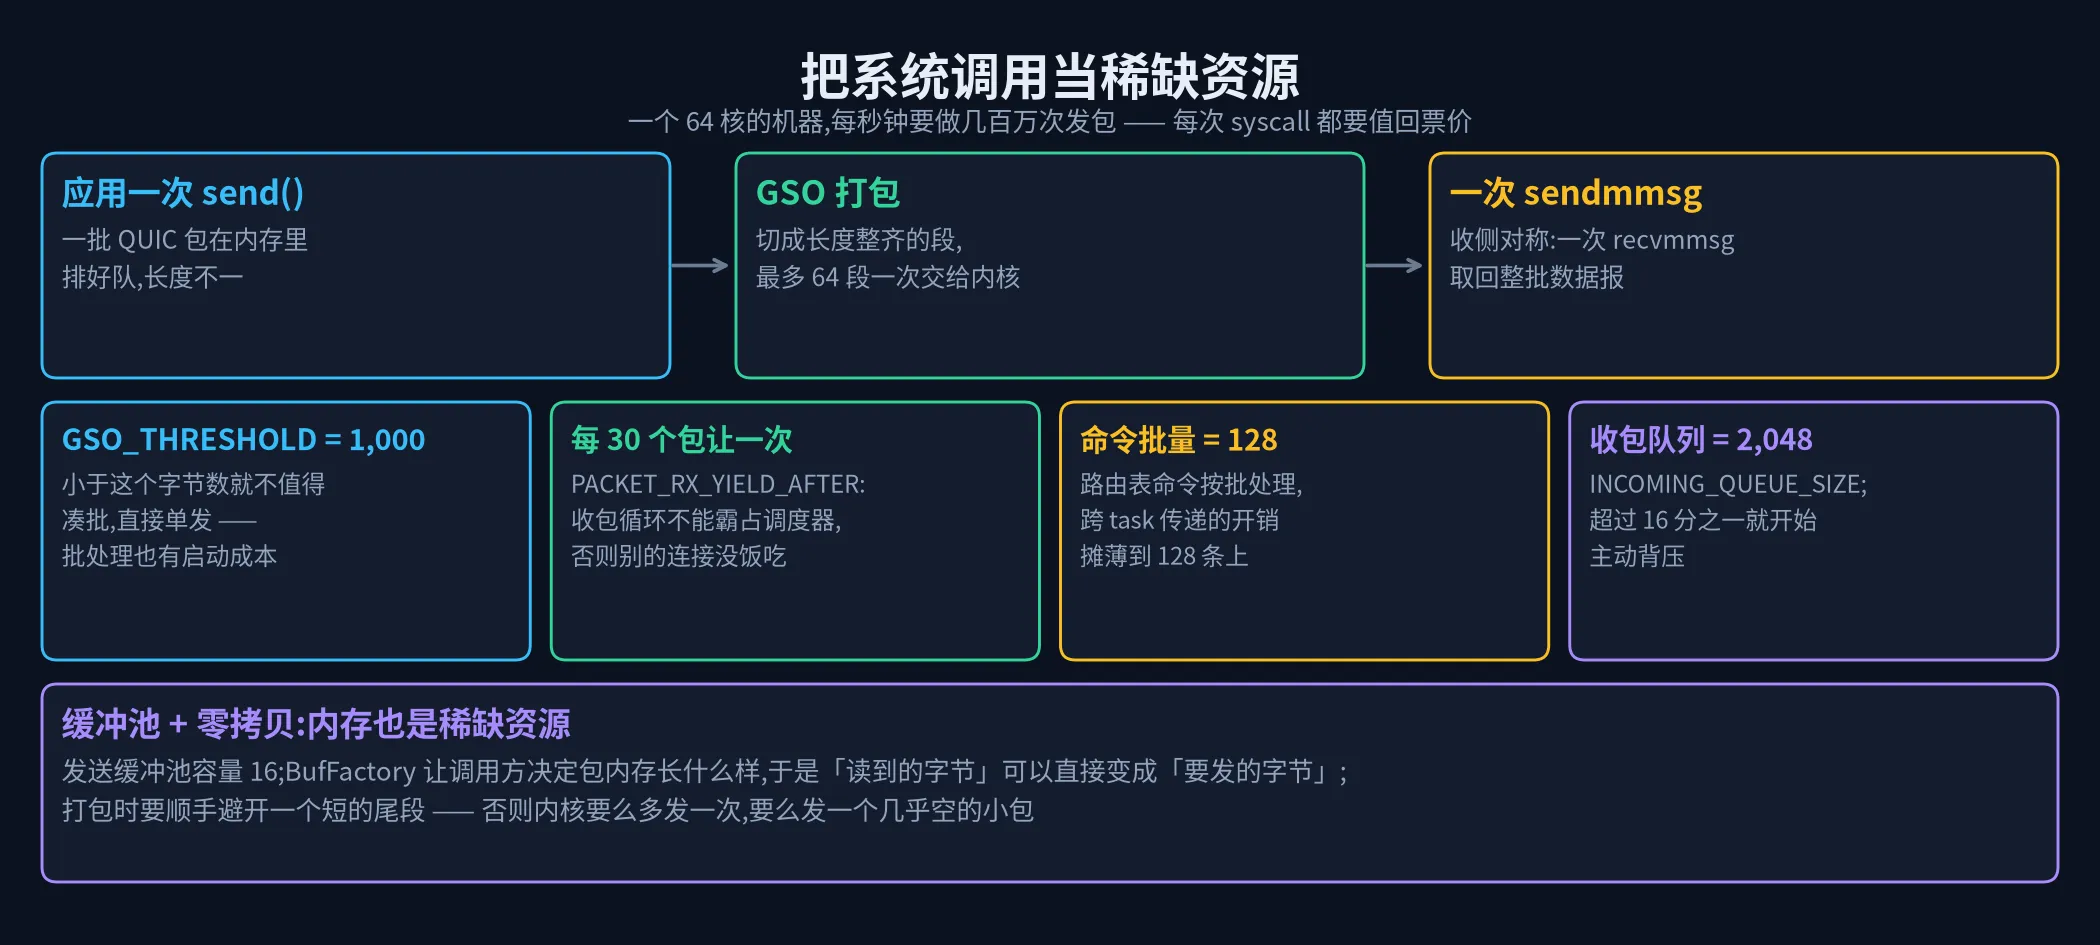
一个包一次 sendto(),在 64 核机器上意味着每秒几十万到上百万次系统调用——每次都要陷入内核、拷贝数据、返回用户态。这笔账在边缘上是算不过来的,所以 tokio-quiche 这一层专门做批处理:
- 发送侧:GSO(Generic Segmentation Offload)。把切好的多个 UDP 段一次交给内核,由网卡硬件去分段,单次最多
UDP_MAX_SEGMENT_COUNT = 64段。 - 接收侧:GRO(Generic Receive Offload),对称地把一批数据报一次收回来。
- 底层
datagram-socket提供的是sendmmsg/recvmmsg这类批量系统调用的封装,而不是循环调用单包版本。
批处理不是免费午餐,所以有几个数字特别能说明”他们在为什么付费”:
const GSO_THRESHOLD: usize = 1_000;

/// Returns a new max send buffer size to avoid the fragmentation
/// at the end. Maximum send buffer size is min(MAX_SEND_BUF_SIZE,
/// connection's send_quantum).
///
/// - max_send_buf = 1000 and mss = 100, return 1000
/// - max_send_buf = 1000 and mss = 90,  return 990
///
/// not to have last 10 bytes packet.
pub(crate) fn tune_max_send_size(...) -> usize {
    if let Some(mss) = segment_size { max_send_buf_size / mss * mss }
    else { max_send_buf_size }
}两个细节值得抠一下。
第一,GSO_THRESHOLD = 1_000:小于 1000 字节的批次不值得凑。凑批本身有成本(要切段、要组辅助数据),如果只有两三个小包,直接单发更快。“批量优化”也有启动成本,这个阈值就是承认它。
第二,tune_max_send_size():不要留一个短的尾段。如果一批总共 1000 字节、每段 90 字节,凑 11 段会剩 10 字节的尾巴——内核要么多发一次,要么发一个几乎空的小包,两种都亏。所以直接把上限砍到整数倍(990)就好。这是个特别典型的”只有在生产环境里才会长出来”的优化:它不是协议问题,是成本和内核行为的问题。
内存也是同一种资源。 tokio-quiche 给每个 worker 线程配一个发送缓冲池:
/// holds at most [`SEND_BUF_POOL_CAP`] buffers per worker thread.
const SEND_BUF_POOL_CAP: usize = 16;而缓冲池的内存占用注释写得很清楚:上限是 SEND_BUF_POOL_CAP × SEND_BUFFER_SIZE,与连接数无关。这一句的价值在于可预测性:边缘上一条连接的内存开销被压缩到最小,缓冲这种”临时但高频”的东西由固定大小的池子周转,池子满了就丢弃而不是无限增长。在服务器代码里,“峰值内存可预测”比”平均内存更省”重要得多。
再往下一层是 BufFactory:包的内存不再是库自己 Vec 出来的,而是由调用方决定类型。这带来一个很实用的效果——读到的字节可以直接变成要发的字节,少一次拷贝。而 Octets 的解析接口是越界安全的:解析失败返回 BufferTooShortError,不会 panic。把”解析”和”崩溃”解耦,是任何要处理不可信输入的程序都该做的第一件事。
最后是一个容易被忽略、但生产环境一定需要的原语:task-killswitch。它是一个独立的、不依赖任何工作区 crate 的小库,做的是”按名字取消一批异步任务”。为什么 QUIC 服务需要它?因为一条连接在 tokio-quiche 里通常是一组协作的任务(收发、定时器、应用逻辑),要关连接的时候必须把它们全清掉。用 Drop 挨个等不一定可靠,用粗暴的 abort 又会打断收尾。优雅关闭这件事,在连接数上百万的系统里是一门独立的学问,它值得有一个自己的 crate。
顺便说一个很有”人味”的细节:gso.rs 里有一行注释
// https://wiki.cfdata.org/pages/viewpage.action?pageId=436188159那是一个 Cloudflare 内部 wiki 链接。开源仓库里留着指向内网的注释,说明这段代码是从生产环境里长出来、然后被搬过来的——它没有为了开源而”洗干净”,我觉得这反而是它可信的地方。
七、怎么测一个”没有网络的网络”#
写协议库最难的地方从来不是”把它写对”,而是证明它是对的,并且在别人改坏它的时候能立刻发现。
这件事在 QUIC 上格外难,因为需要验证的东西横跨三个维度:字节级的有线格式、状态机的时序(超时、重排、丢包)、以及一个”敌人”——任何不可信的输入都不能让它崩溃或耗尽资源。三条维度没有一个可以直接用”跑一下试试”覆盖。
第一件武器:在内核里造一条假网线。
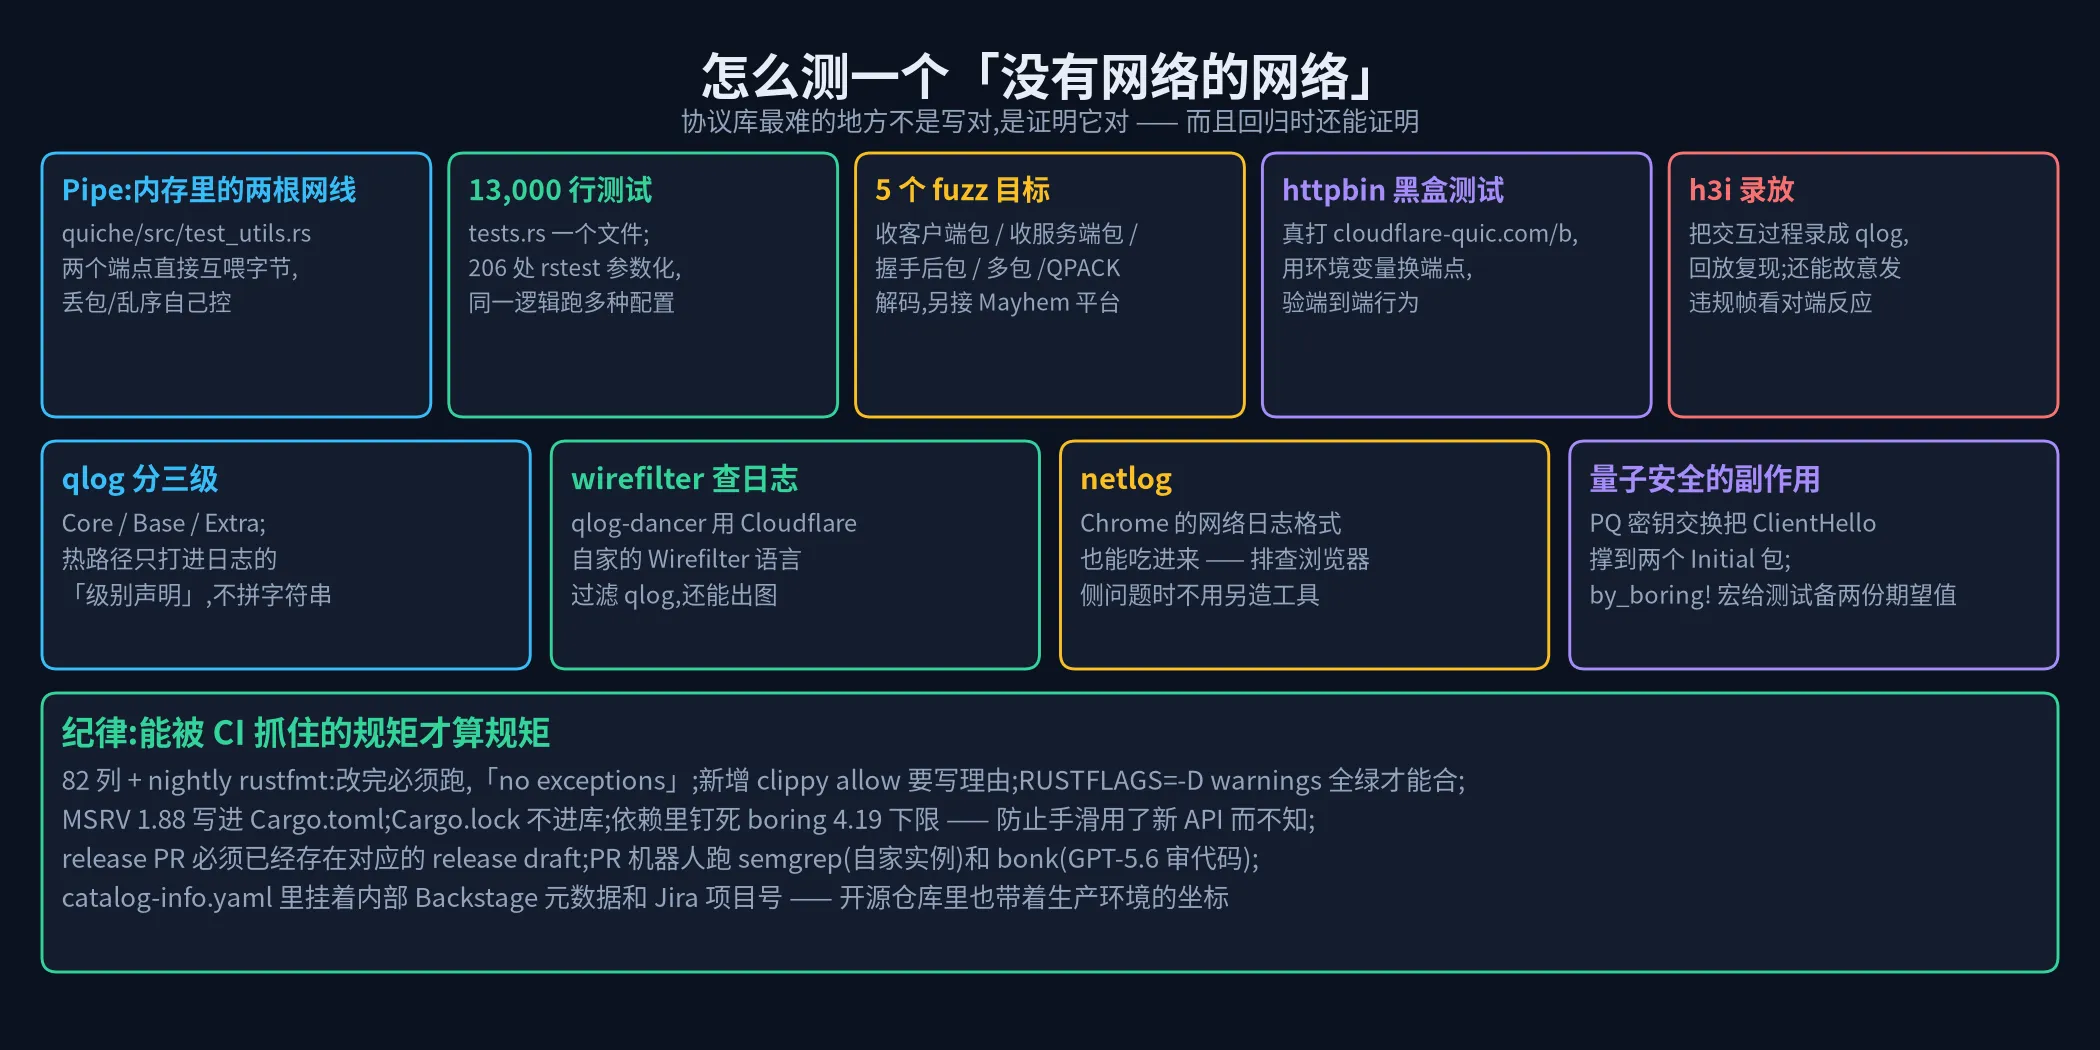
quiche/src/test_utils.rs 里有一个叫 Pipe 的东西:它把两个 quiche 端点直接连起来,一端的输出直接变成另一端的输入,不经过任何 socket。
impl<F: BufFactory> Pipe<F> {
    pub fn handshake(&mut self) -> Result<()> { ... }   // 两个端点互相握完手
    pub fn advance(&mut self) -> Result<()> { ... }     // 推进一轮收发
    pub fn send_pkt_to_server(...) -> Result<...> { ... }
}它的价值在于可控:想测丢包,就不调用 advance(),包自然就”丢”了;想测乱序,就调整投递顺序;想测超时,就把时间推进到超时点。真实网络是不可重复的,而协议 bug 恰恰只在特定时序里出现。
靠着这条假网线,tests.rs 一个文件写了 13,384 行测试,全仓 710 个 #[test],再加上 267 处 #[rstest] 参数化——同一个测试逻辑跑多组配置变体。这个规模说明的是一个判断:协议的正确性是配置空间的正确性,单跑一条主线路径说服力有限。
第二件武器:把不可信输入喂到死。
fuzz/ 下有 5 个 fuzz 目标,分工很清楚:收客户端包、收服务端包、握手后的包、多个包连续处理、QPACK 解码。前四个打的是状态机,最后一个打的是压缩算法(HTTP/3 的头部压缩有一张动态表,是典型的”状态 + 输入”攻击面)。
更有意思的是它接了 Mayhem 平台集成——也就是说 fuzzing 不是”本地偶尔跑跑”,而是有基础设施持续跑。能不能持续跑,决定 fuzzing 是仪式还是防线。
第三件武器:拿真实服务器当靶子。
tools/http3_test/ 是一组黑盒测试,默认直接打 cloudflare-quic.com(端点可以用环境变量换)。它的定位和前面两个完全不同:前面测”我对不对”,这里测”我和真实世界说不说得通”。协议实现最阴的 bug 往往出现在互操作的缝隙里——双方都按自己的理解实现了规范里含糊的那句话。
第四件武器:录下来,回放。
h3i 是 HTTP/3 的交互式调试器,它有两个其他工具少见的特性:一是能把一次交互录制成 qlog,之后回放复现;二是它被设计成可以故意违规——主动发出畸形的帧,看对面怎么反应。一个协议库如果连”怎么优雅地拒绝坏输入”都测不了,那它对坏输入的容错基本靠运气。
而所有这些测试都共用一条观测管道:qlog。
qlog 是 QUIC 的标准日志格式(RFC 还在 draft 阶段),quiche 的实现放在独立的 qlog crate 里。这里有个细节很见功力:
macro_rules! qlog_with_type {
    ($ty:expr, $qlog:expr, $qlog_streamer_ref:ident, $body:block) => {{
        #[cfg(feature = "qlog")]
        {
            // 只有开启了 feature、配置了 writer、且这个事件的
            // importance 在配置级别之内,才会执行 $body
            ...
        }
    }};
}关键在那个 importance。日志事件分了三个级别,热路径上只做”级别声明”这一步判断,不去拼接字符串。这是所有高性能系统都会遇到的取舍:日志要么在关键路径上留下成本,要么在需要的时候没有信息。按级别声明、按需格式化,是同时要两头的一个折中。
日志之后的工具链也很完整:qlog-dancer 用 Cloudflare 自家的 Wirefilter 表达式语言来过滤 qlog(这个语言原本是给 WAF 写规则的),还能把结果画成图;netlog 则能解析 Chrome 的网络日志格式——排查浏览器侧问题时不用另造工具。观测性不是”加个 log”,它是一条从事件模型到查询语言再到可视化的完整链路。
最后讲一个我特别喜欢的小故事,它把”测试”和”现实”的关系摆得非常清楚。
某天 BoringSSL 升级,BoringSSL 默认启用了后量子密钥交换(X25519MLKEM768)。后量子密钥分享的尺寸大得多,于是客户端的 ClientHello 一个 Initial 包装不下了,变成了两个包。
对协议本身,这是个好消息:更强的前向安全。但对那些”按字节数写死期望值”的测试来说,这是一场集体地震:包数变了、字节数变了、太多断言要改。
quiche 的处理方式是这样的:
/// Several tests were written against a pre-PQ world where the ClientHello
/// fit in a single Initial packet; those tests opt out of PQ to keep that
/// invariant. See [`config_no_pq`].
const NO_PQ_CURVES: &str = "X25519:P-256:P-384";再加上一个给测试用的 by_boring! 宏,让期望值能按 BoringSSL 大版本给出两套:b4: ..., b5: ...。
我看到这段的时候想了很久:它没有选择”把断言放宽”(那会永久削弱测试),也没有选择”全面重写”(那会丢掉这些断言原本的价值),而是明确区分了”协议行为”和”密码学实现带来的副作用”,给后者开了一个可以随时关掉的口子,并且把这个口子写进了文档。
测试的敌人从来不是”改需求”,而是”含糊的期望”。 这段代码把含糊消掉了:哪些断言依赖 PQ、为什么可关、在哪个条件下生效,全在注释里。
八、纪律:能被执行的东西,才叫规范#
前面七节讲的都是”它做了什么”。最后一节想聊一个更少被讨论、但决定一个项目能不能活十年的问题:它靠什么保证明天不会变烂?
在 quiche 里,这个角色主要由两样东西承担。
8.1 一份 11 个文件、750 行的”项目知识库”#
仓库里有 11 个 AGENTS.md,顶层那份开头写着 Generated: 2026-02-20、Commit: 89d1850f——也就是说它是跟随具体提交生成的快照,不是随手写的 README。
它的结构很像一份给”新来的工程师(或 AI)“准备的入职手册:OVERVIEW、依赖图、WHERE TO LOOK(想改 X 去看哪个文件)、CODE MAP(关键类型在哪)、CONVENTIONS、ANTI-PATTERNS、FEATURE FLAGS、COMMANDS。
最值得看的是 ANTI-PATTERNS 那一节,它是这么写的:
- Do not add clippy
#[allow]without justification — 33 existing overrides all have documented reasons.- Two
Ackedtypes exist inrecovery/congestionandrecovery/gcongestion— not unified, don’t create a third.connection_not_present()returnsTlsFail— misleading sentinel, don’t propagate this pattern.Error::Doneused as success signal in H3 driver write path — non-obvious, don’t replicate.transmuteofInstantingso.rs— fragile, platform-dependent, don’t extend.
这五条里,除了第一条是规范,其余四条全是承认自己身上有疤:用了错误的哨兵值当”连接不存在”;把 Error::Done 这个”结束”信号当成”写成功”用;用 transmute 把 u128 位模式硬转成 Instant(为了拿一个”零时刻”常量)。
大多数项目遇到这类代码,只有两种做法:要么当作没看见(于是下一个人照着写第三种),要么开个技术债单子写”待重构”(然后永远不重构)。
quiche 选了第三种:照原样留着,但在最显眼的地方写下”我们知道,别扩散”。
我越想越觉得这是对的。transmute 那行代码在平台相关性上确实脆,但它换来的效果是”零时刻常量可以是一个 const”。改掉它的收益有限、风险不小(要动热路径),那就不改——但必须让所有人知道这里有雷。技术债不是靠还清来管理的,是靠标记来管理的。
8.2 一堆能在 CI 里被抓住的规矩#
CONVENTIONS 里第一条就很有性格:
MANDATORY: run
cargo +nightly fmtafter every code change, no exceptions — this includes trivial edits like renames, comment changes, or single-line fixes.
一个协议库强制用 nightly 版的 rustfmt,还要”连改个注释也得跑”,理由是格式导致的 diff 噪声会污染 review——而协议代码的 diff 一旦被格式噪声淹没,真正危险的改动就藏进去了。行宽 82 列、注释 80 列、每个 use 单独一行、每个 .rs 必须有 BSD 版权头,这些都被机械化了。
更有意思的是那些为了”防手滑”而存在的措施:
- 依赖里钉死 BoringSSL 的下限:
boring = { version = ">=4.19, <6" },并且build.rs通过boring-sys导出的DEP_BORINGSSL_VERSION_MAJOR检测大版本,给出cfg(boring_v5)。为什么要这么麻烦?因为如果开发机上用的是新版,你不小心调了一个 5.x 才有的 API,4.x 的用户就会在你完全没察觉的地方挂掉。把下限钉死,等于让 CI 替你记住”我们还支持老版本”。 Cargo.lock不进库(库项目),doc test 单独跑(cargo test --all-targets不跑 doc test,这是 cargo 的老问题)、RUSTFLAGS="-D warnings"全绿才算过、cargo machete检查无用依赖、semgrep扫描(走 Cloudflare 自家的cloudflare.semgrep.dev实例)。- CI 矩阵覆盖 Linux(新老 BoringSSL 两套)、macOS(Intel + Apple Silicon)、iOS、Windows 四个目标架构。一个在 BSD 许可下要被嵌进各种环境的库,跨平台不是加分项,是入场券。
- 发布流程被写死成规则:bump 版本号的 PR 必须已经存在对应的 release draft,否则 CI 直接拒绝。README 里说得很直白——“PRs that do not follow this will be closed”。
- PR 机器人里有个叫 bonk 的,用
cloudflare-ai-gateway/openai/gpt-5.6-sol这样一串模型标识来跑 AI 代码审查。看到这一行的时候我笑了一下:2026 年的开源仓库,连 code review 这一环都开始有”AI 同事”了。 - 还有
catalog-info.yaml:里面挂着 Cloudflare 内部 Backstage 的组件元数据、Jira 项目号(FLPROTO)、负责人团队,以及一个software-excellence-opt-in: true。开源仓库里带着生产环境的坐标——它在提醒你:这份代码不是实验室作品,它是靠一套线上规范养着的。
把这些东西放在一起,我看到的是一句很朴素的话:规范如果不能被执行,它就只是愿望。
写在最后:六条可以带走的东西#
quiche 是个 14 万行的协议库,细节多得看不完。但如果要把它最值得学的东西压缩成六条,我会选这些:
- 边界决定价值。 一个库好不好用,不取决于它功能多全,而取决于它把”责任线”画在哪里。quiche 把 IO、调度、时钟全部交出去,自己只留协议状态——这才让它同时进得了边缘、手机和 curl。
- 把时间也交出去。
SendInfo.at和timeout()是很罕见的设计:库不 sleep,只告诉你什么时候该来。它把”等待”这种强环境相关的行为还给了应用。 - 异常路径才是主体。 反放大额度、常量时间比较、0-RTT 包缓存上限、stateless reset 判定——协议库的绝大部分代码是在处理”世界不守规矩”。写业务代码也一样:真正的工程质量藏在错误分支里。
- 可预测比更省更重要。 缓冲池上限 16 个、队列 2048、收包 30 个让出一次调度。这些数字都在换同一件事:在百万连接下,峰值行为可预测。
- 测试要造一个世界。 内存里的 Pipe、5 个 fuzz 目标、打真实服务器的黑盒测试、能录放的交互调试器、qlog 分级日志。它们针对的是三种完全不同的失败:逻辑错、时序错、互操作错。
- 把疤写下来。 两种
Acked、TlsFail哨兵、Done当成功、Instant的transmute——全部挂着”别扩散”。一个项目的成熟度,不看它有没有历史包袱,看它知不知道自己的历史包袱在哪。
QUIC 的设计初衷是”把传输层从内核里解放出来”,而 quiche 最动人的地方在于:它把这件事做得非常克制——没有顺手把调度、IO、时间也一起管起来。
一个馅饼的皮,决定它能不能盛住馅。