RustFS 深度解析:一群 Rust 工程师,把技术债钉在了墙上
💬 评论33k Star、Apache 2.0、刚发布 1.0 的 RustFS 想用 Rust 重写 MinIO。真正让人服气的不是性能数字,而是它把架构债、兼容欠条、事故复盘全写进了仓库。
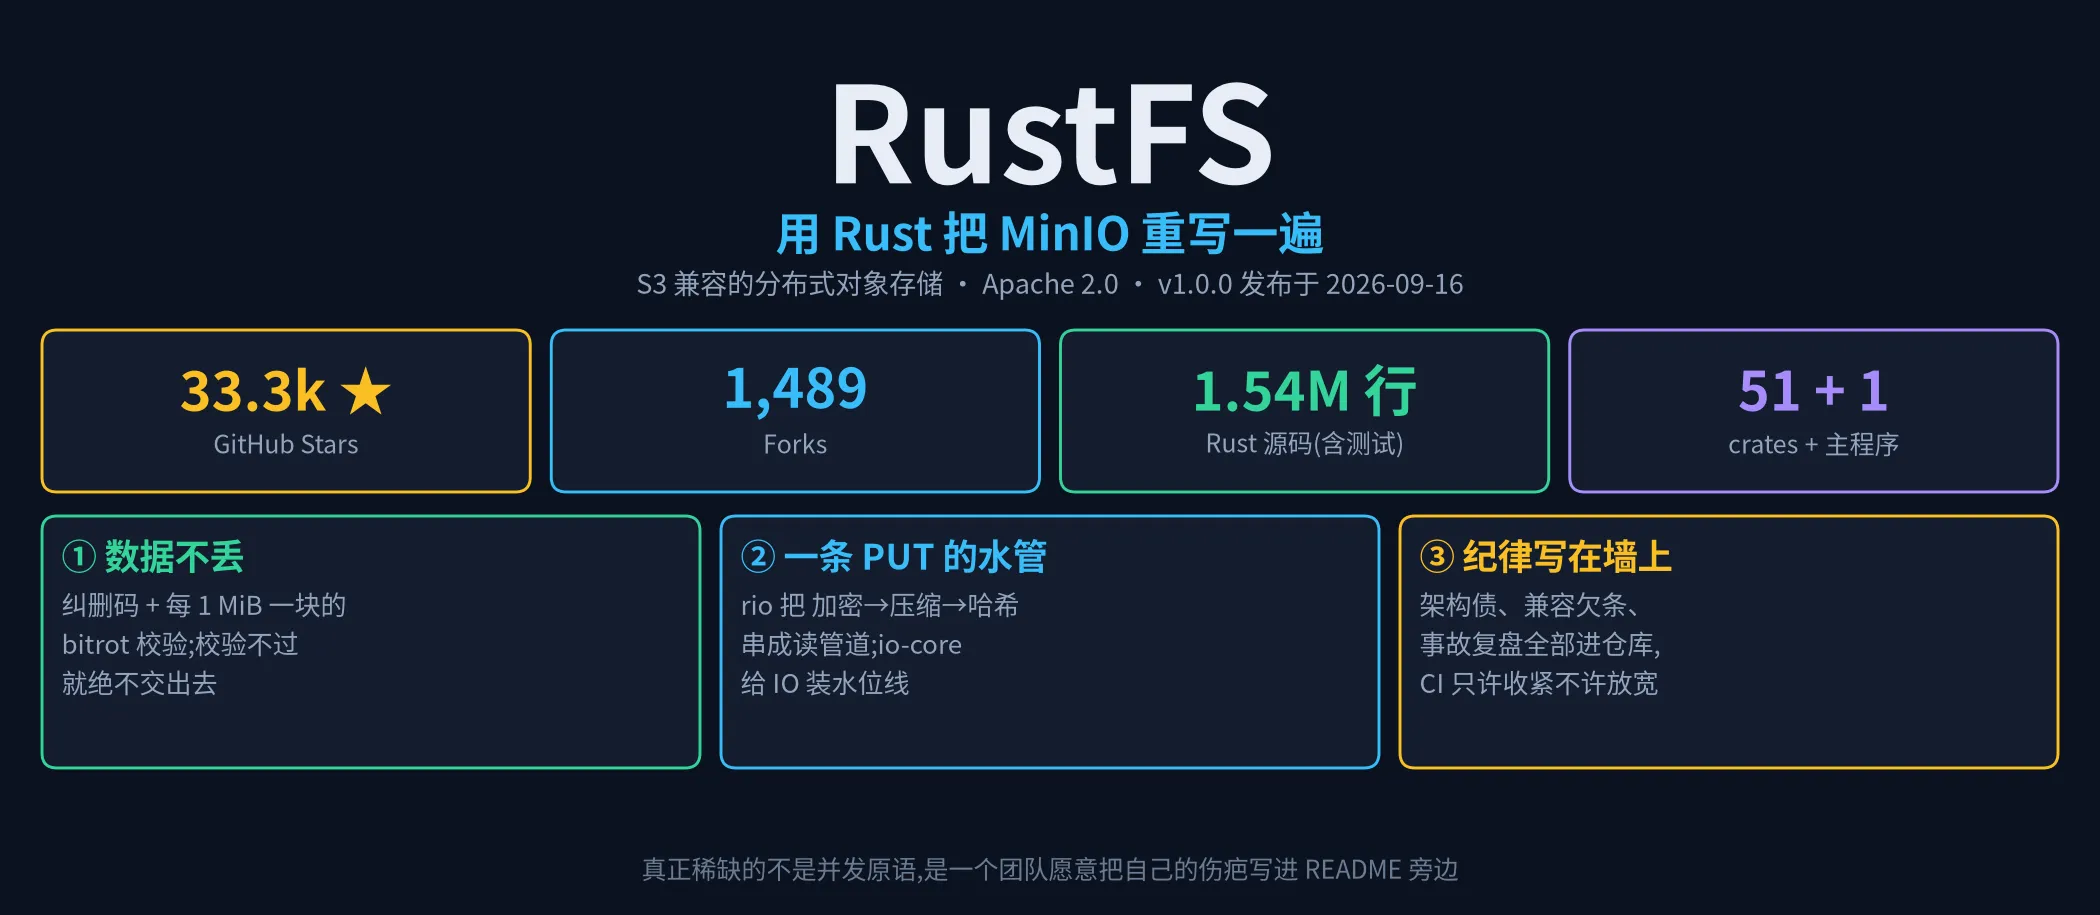
仓库:rustfs/rustfs ↗ Apache-2.0 · v1.0.0 发布于 2026-09-16 · 33.3k stars / 1,489 forks / 169 contributors(统计于 2026-09-19) 51 个 crate + 1 个主程序 · 1,898 个
.rs文件 · 154 万行 Rust(含测试) · 254 篇设计文档
先问一个问题。
如果一个人跟你说:我要再写一个对象存储。你的第一反应大概是”图啥”。
这个领域的轮子实在太多了。2006 年 Amazon S3 定下 API 标准,此后二十年,开源的、闭源的、分布式的、单机的、Go 写的、C 写的、C++ 写的、Rust 写的——你能想到的组合都有人做过了。MinIO 占了 S3 兼容对象存储的大半江山,Ceph 扛着块/文件/对象三合一的航母,SeaweedFS、Garage、JuiceFS 各占一块地盘。
在这种赛道里再开一个新项目,通常只有两种结局:要么是”又一个轮子”,要么是”作者看到了别人没看到的东西”。
RustFS 是后者。但它看到的东西,和大多数人以为的不一样。
大部分人提到它,会先聊性能——README 里那张 RustFS vs MinIO 的压测图确实很吸睛。但读完它的仓库之后,我真正被说服的不是那些数字。是另外三件事:
- 它把”读不懂别人的盘”这道坎,拆成了一份可验证的兼容契约;
- 它把”数据不能丢”翻译成了几行可以算出来的算术题;
- 它把团队自己的技术债、事故复盘、以及对 AI 编码助手的要求,全都写进了仓库。
第三条听起来最不像技术,但在我看来最值钱。这篇文章就按这三条线索走。
一、先说它想替换掉什么,以及它自己承认不能替换什么#
判断一个”重写类”项目值不值得看,我有个笨办法:先读它的许可和它承认的边界,再读它的性能表。
原因是前者很难撒谎。性能可以挑机器,兼容性可以挑用例,但许可协议和”我们不支持什么”这两件事,写下来就是要被用户拿放大镜看的。
RustFS 的 README 把这两件事都摆在了第一屏。
许可:License 也是一张产品设计图#
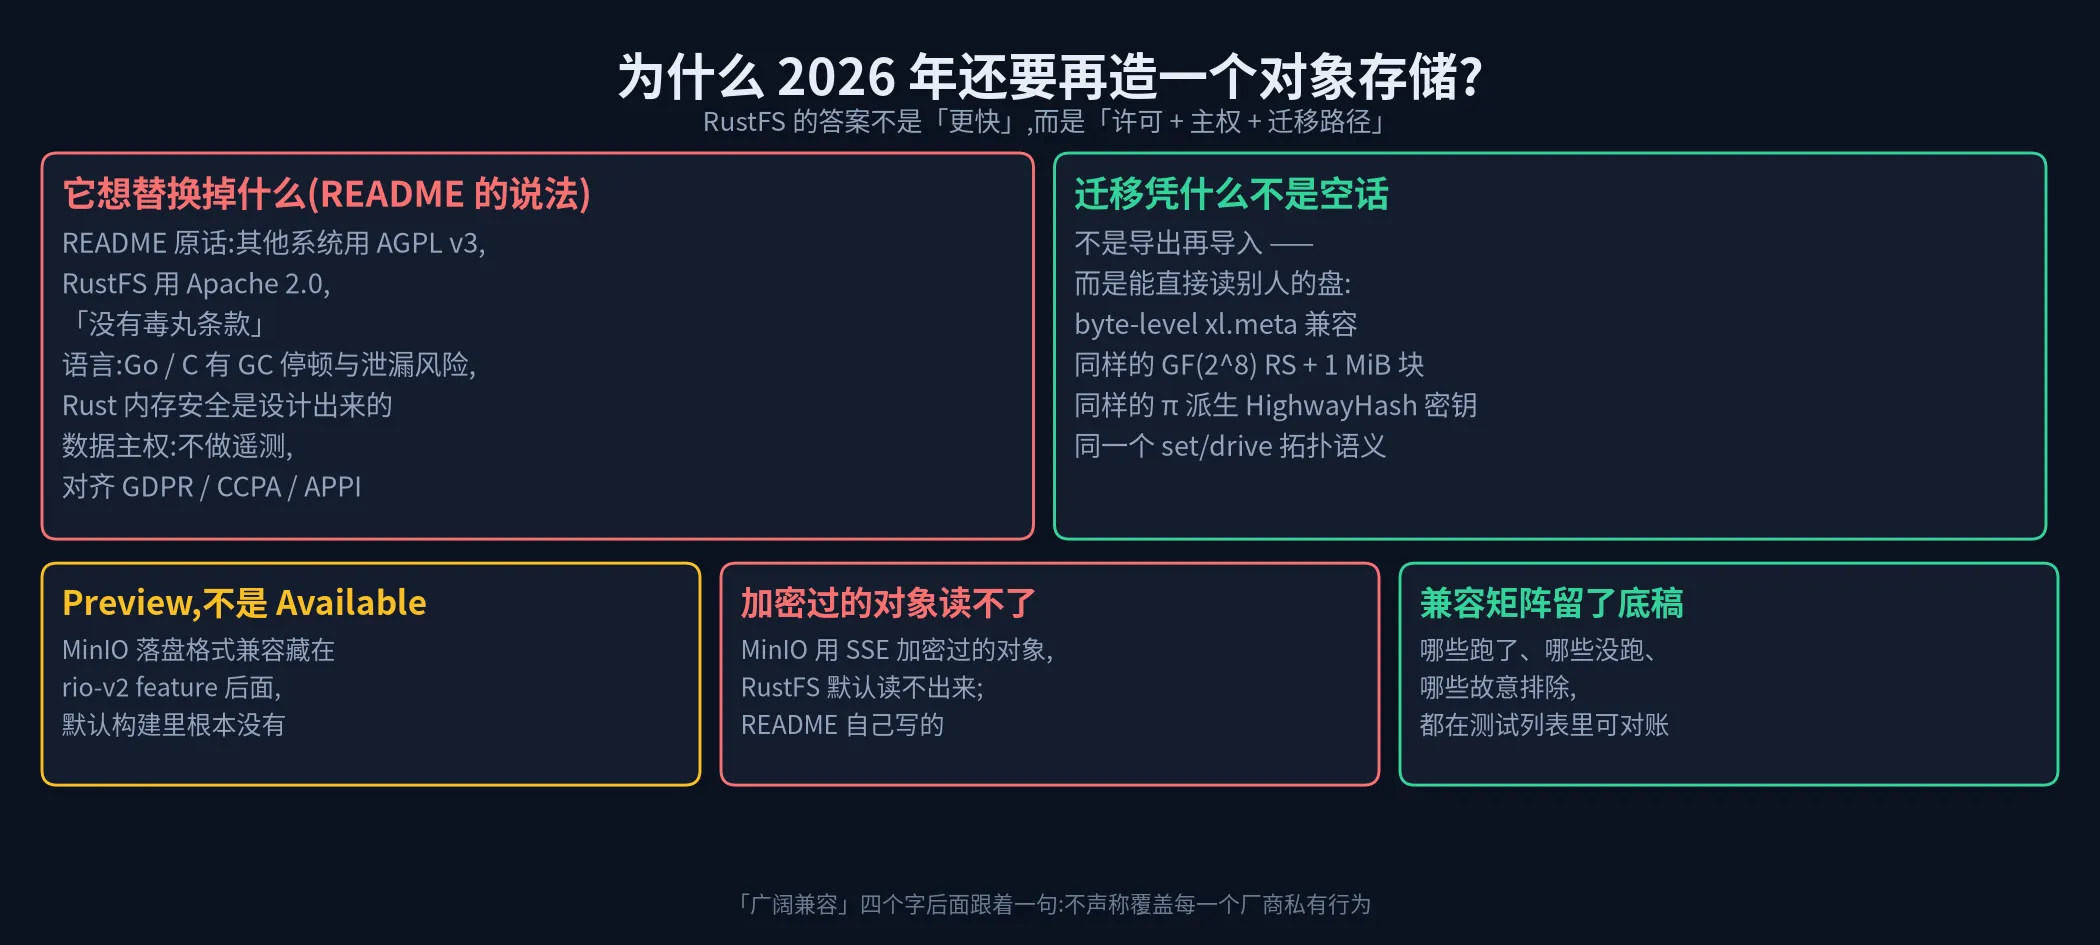
它的原话大意是:很多同类系统采用 AGPL v3,而 RustFS 用 Apache 2.0,没有”毒丸”式的条款约束。对一个要把存储塞进自家产品里的团队来说,“我能不能闭源分发我基于它做的发行版”这个问题,常常比”它快 15% 还是慢 15%“重要得多。
另一个它反复强调的点是数据主权:不做遥测,不把使用数据回传给厂商,并把它与 GDPR / CCPA / APPI 这类合规框架对齐。这同样是产品设计的一部分——存储是离数据最近的那一层,信任比吞吐量更难建立。
再就是语言选择。Go 有 GC,大内存堆上的停顿和”内存迟迟不还给系统”是运维的老朋友;而 Rust 把内存安全做成了编译期问题。RustFS 用 Rust 重写,本质上是在赌:对象存储的瓶颈往往不在算法,而在”长时间高负载下不犯低级错误”这件事上。这个赌注是否划算,后面几节的代码细节会更说明问题。
迁移:真正难的不是导出导入,是”读得懂别人的盘”#
这一点是我认为 RustFS 最硬的地方。
大多数”兼容 S3”的存储,兼容的是 API——你的客户端能连上、能 PUT/GET。但如果你想把一个已经在跑的 MinIO 集群平移过来,API 兼容帮不了你:你得一桶一桶地导出,再一桶一桶地导入。TB 级、PB 级的数据量下,这就是一次停机迁移。
RustFS 选了另一条路:让新的进程直接读懂旧的盘。
这件事为什么难?因为你要复刻的不是接口,是字节级布局。而 RustFS 的架构文档把这份契约写得很直白——它的行业对齐清单是:GF(2^8) 上的 Reed-Solomon、Vandermonde 生成矩阵、1 MiB 纠删块、以及密钥由 π 推导出来的 HighwayHash-256 校验和。这些参数一个不对,读出来的就是垃圾。
关于那个 π 派生的密钥,值得多说一句:校验和密钥本可以是一个随机常量,但那样的话”别人写下的块”就没法验证。用 π 的十进制数字推导出的公开常量,意味着任何按同一规则实现的系统都能对上账。这一个小细节,才是”迁移”从口号变成工程的前提。
但它同时写下了边界,而且是写在最显眼的位置#
读到这里你可能会想:那是不是可以无缝切换、零成本上云了?
RustFS 自己的答案是不。而且它写得很具体:
- MinIO 落盘兼容默认是关掉的。 这条能力藏在
rio-v2这个 crate feature 后面。文档原话是:rio-v2既不在default也不在full构建里。也就是说,默认装出来的 RustFS,压根没有这条读路径。要用,你得显式地编译它、并接受它是一个独立的构建变体。 - 被 SSE 加密过的对象,默认读不出来。 README 里直接写了 MinIO 用服务端加密写过的对象,RustFS 默认无法读取。架构文档补充了原因和态度:密文永远不会被当成明文端出去,拒绝时返回的是一个非可重试的类型化错误,并且明确指出你需要哪个读路径。
- 有些格式明确列为”不在范围内”。 反向回读(让 MinIO 再读 RustFS 的盘)、以及 MinIO 单节点多盘(SNSD)从未写过的那些格式(CORS、public-access-block、bucket-ACL、transitioned 的
xl.meta),都被显式排除。迁移是单向的:MinIO → RustFS。
这就是我最欣赏的一点:“广阔兼容”四个字后面,紧跟着一句”仅限受支持的功能”。愿意在第一屏写出”我哪里不行”的项目,通常比把边界藏在 FAQ 第 17 条的项目可信得多。因为边界写在明处,你才敢把数据托付给它。
二、数据是怎么活下来的:一道 8 盘 4+4 的算术题#
现在进入正题。
任何存储系统都只有两个结局:要么数据还在,要么数据没了。中间那些”偶尔读不出来""读出来是坏的”的状态,才是最要命的。所以看一个对象存储,我习惯从它的几何看起:数据被切成几份、放在几块盘上、坏掉几块还能活。
从池到盘:四层嵌套的收纳结构#
RustFS 的收纳逻辑是四层:
- Pool(池):一组磁盘的集合,通常对应一次硬件扩容采购。一个集群可以有多个池。
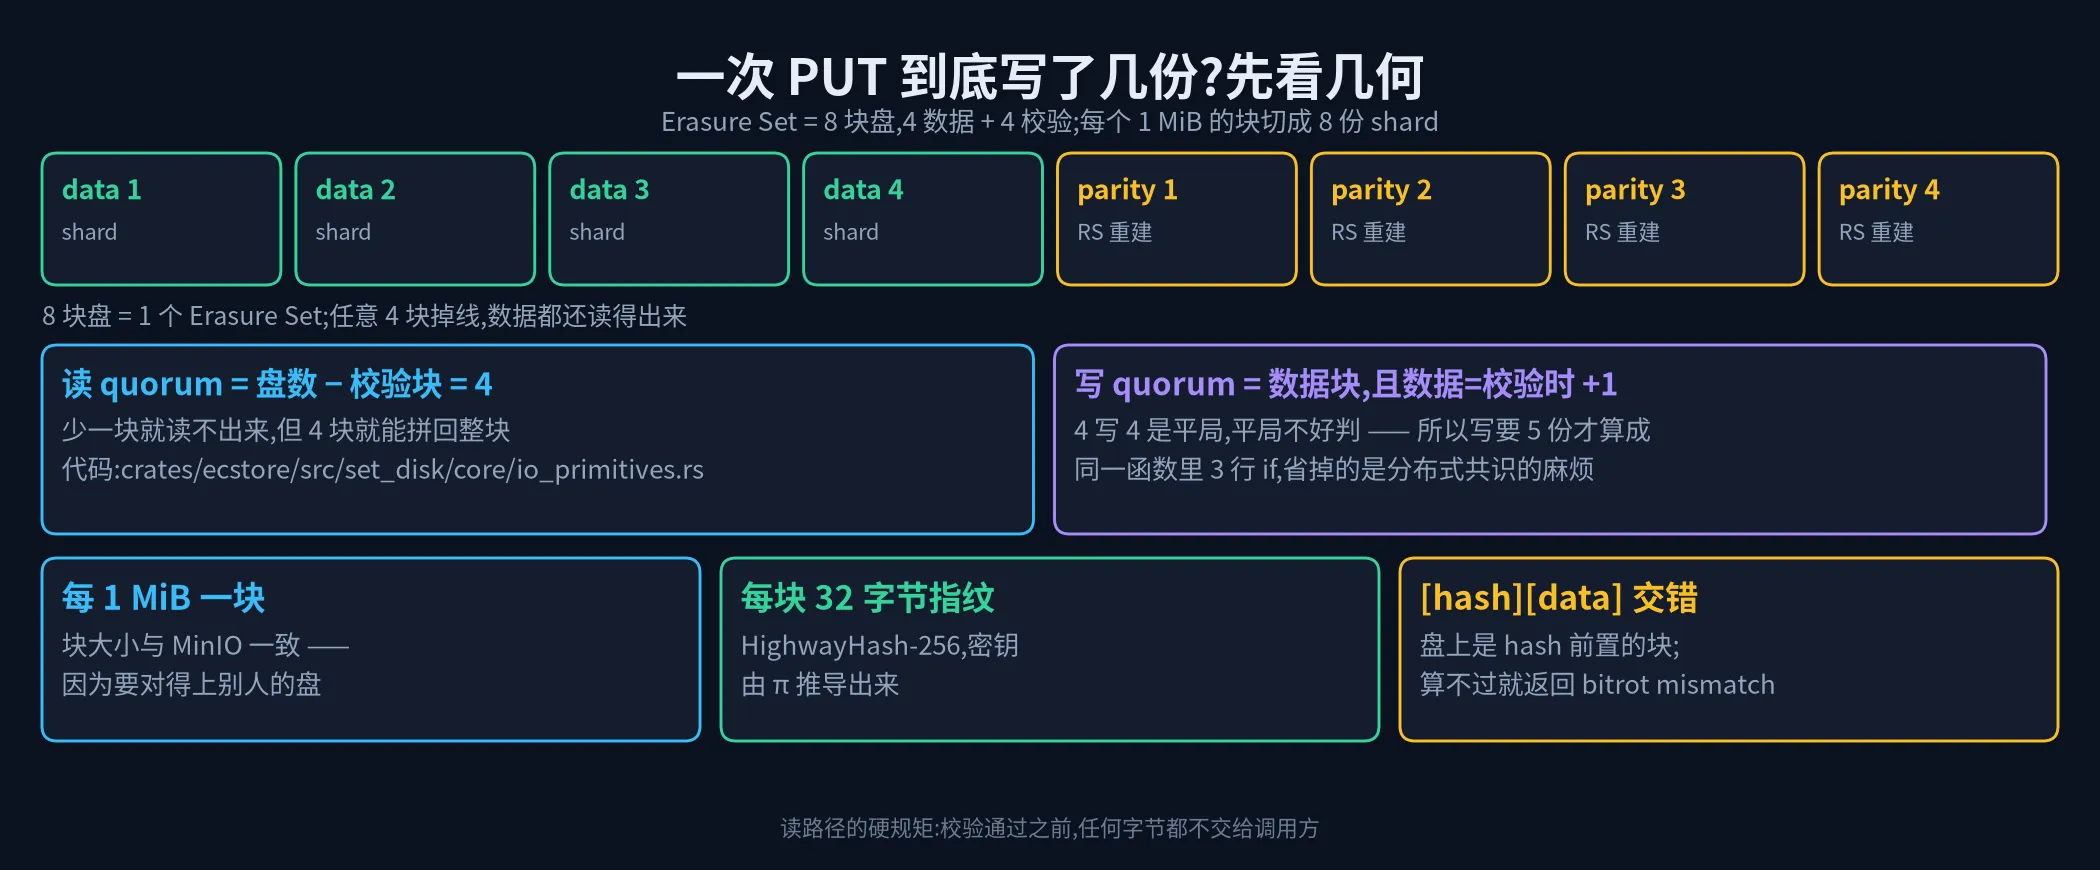
- Set(纠删集):池内部再切分,纠删码的运算单位是 Set。一个 Set 必须是 8 块盘(默认),最大不超过 16。
- Drive(盘):单块物理盘或挂载点。
- Block / Shard(块 / 分片):对象被切成 1 MiB 的块,每块再切成
data_blocks份数据分片 +parity_blocks份校验分片。
以一个 8 盘的 Set、4 数据 + 4 校验为例:一个 1 MiB 的块,会被切成 4 份等长的数据分片(每份 256 KiB),再用 Reed-Solomon 算出 4 份校验分片。8 份分片分别写到 8 块盘上。
这套编码是 MDS(Maximum Distance Separable) 的:任意 4 份分片就能还原出完整的原始数据。换句话说,你可以在同一时刻失去 4 块盘,数据依然读得出来——不是靠副本,是靠算术。
那两个 quorum,和一个只有三行的 if#
接下来是 quorum(法定票数),分布式存储里最容易被写错、也最容易在事故复盘里被点名的东西。
RustFS 的读 quorum 很简单:
读 quorum = 盘数 − 校验块数8 盘 4 校验的情况下,读 quorum = 4。少一份就读不出来,但只要凑够 4 份就能拼回整块。
写 quorum 更有意思。它等于数据块数量——但如果数据块数量正好等于校验块数量,就再加 1:
pub(crate) fn default_write_quorum(&self) -> usize {
    let mut data_count = self.set_drive_count - self.default_parity_count;
    if data_count == self.default_parity_count {
        data_count += 1
    }
    data_count
}8 盘 4+4 的情况下,数据块 = 校验块 = 4,于是写 quorum = 5:同样一次 PUT,写要 5 份才算成功,读却只要 4 份。
为什么要多这一份?因为 4 比 4 是平局。当”确认写入的数量”和”允许丢失的数量”相等时,系统就活在一个尴尬的边界上——任何一次抖动都可能同时踩到两边。多要一份,是用一点点写入成本,换掉一类永远说不清的边界情况。
三行代码,省掉的是一整套分布式共识的麻烦。 这就是我喜欢读存储代码的原因:它不追求理论上的漂亮,它追求的是一年之后凌晨三点不会有人被叫起来。
校验和:一个由 π 推导出来的密钥#
纠删码解决了”整块盘没了”,但没解决另一个更阴险的问题:盘还在,上面的字节悄悄变了。
这叫 bitrot(位腐烂)。它不是”盘坏了”这种能被 SMART 提前预警的事件,而是某些扇区在某个时刻读出来的值,和你当初写进去的不一样了。
RustFS 的对策是每个分片文件自带校验:
- 算法:HighwayHash-256(流式版本,32 字节摘要);
- 密钥:
MAGIC_HIGHWAY_HASH256_KEY,由 π 推导(这也正是它能和 MinIO 落盘对上的原因之一); - 布局:每 1 MiB 块在盘上是
[32 字节哈希][数据]交错排列的——哈希前置在数据之前,一次向量化写完成; - 规矩:校验通过之前,数据不交给调用方。校验失败返回一个明确的
bitrot hash mismatch;分片被截断,即便调用方要求跳过校验,也照样报UnexpectedEof。
最后那条”verify before use”是整个读路径的灵魂。因为对于存储来说,一个安静的错值,比一次响亮的失败危险得多。失败了调用方会重试、会告警、会来找你;读到一个坏值但系统说”一切正常”,错误会顺着你的数据管道流下去,等你发现时已经不知道该从哪一层修起。
还有一层:校验和的校验和#
bitrot 的 [hash][data] 有个已知的盲区:如果攻击者或某次诡异的写入,把一整帧替换成另一个长度相同、且自身校验也合法的帧,那么自校验是过不了的——它能过。
RustFS 对此的回答是”独立分片承诺”(independent shard commitments):给每个 part 生成一份独立于纠删码、也独立于 HighwayHash 的 SHA-256 承诺,包含随机 UUID、part 号、精确编码长度、纠删几何、编解码模式、stripe 数量和一个 Merkle 根;每个叶子提交一个 stripe 内全部编码分片的摘要;根还额外承诺整个 part 的最终大小。
它做得很克制——这套机制默认对新写入是关闭的,要同时打开 RUSTFS_SHARD_INTEGRITY_WRITE 和 RUSTFS_SHARD_INTEGRITY_FLEET_CONFIRMED 两个开关才会对新数据生效。原因也很实在:额外的元数据、额外的 IO、额外的复杂度;只有当你的威胁模型里真的包含”完整帧替换”时才值得付这个代价。
能加而不急着加,并且把加的代价和条件写清楚——这比”我全都要”要成熟得多。
最后,是把”能忍”和”不能忍”分清#
上面讲的是”怎么防”。但一个成熟的存储系统还必须回答另一半问题:读到一个不认识的元数据时,该报错还是该猜?
这一题最容易做错的地方在于:两种倾向听起来都很有道理。“宽容一点,别让一点点格式差异就拒绝用户的数据”和”严格一点,别把损坏的数据当成正常数据读出来”——如果你只讲其中一句,你就是错的。
RustFS 的做法是把规则拆成两层,写进了纠删码文档里:
| 情况 | 处理 | 理由 |
|---|---|---|
| nil UUID、epoch 时间戳、未知的 map 键、空集合 vs 缺失集合、外来/超长 tier id | 容忍,降级为 None 或默认值 | 这些是值级的可恢复形状 |
必需的并行数组长度不一致、CRC / bitrot 不匹配、版本号高于当前最大值、versions_len 超出 blob 大小、必需标识符长度不是 16 字节 | 失败(fail closed) | 这些是结构性损坏,猜下去就是在掩盖问题 |
文档里有一句话把态度说得非常清楚:把结构性的 guard 改成宽容的默认值,是在隐藏损坏。
这一节最后留一个判断,你可以带走:一个存储系统最重要的品质不是快,是错的时候不要安静地错。 你去看它的失败模式设计,你就知道它能不能托付数据。
三、一条 PUT 的旅程:七层,一层都不许回头#
搞清楚了”数据长什么样”,下一个问题是:它怎么走进去、又怎么走出来。
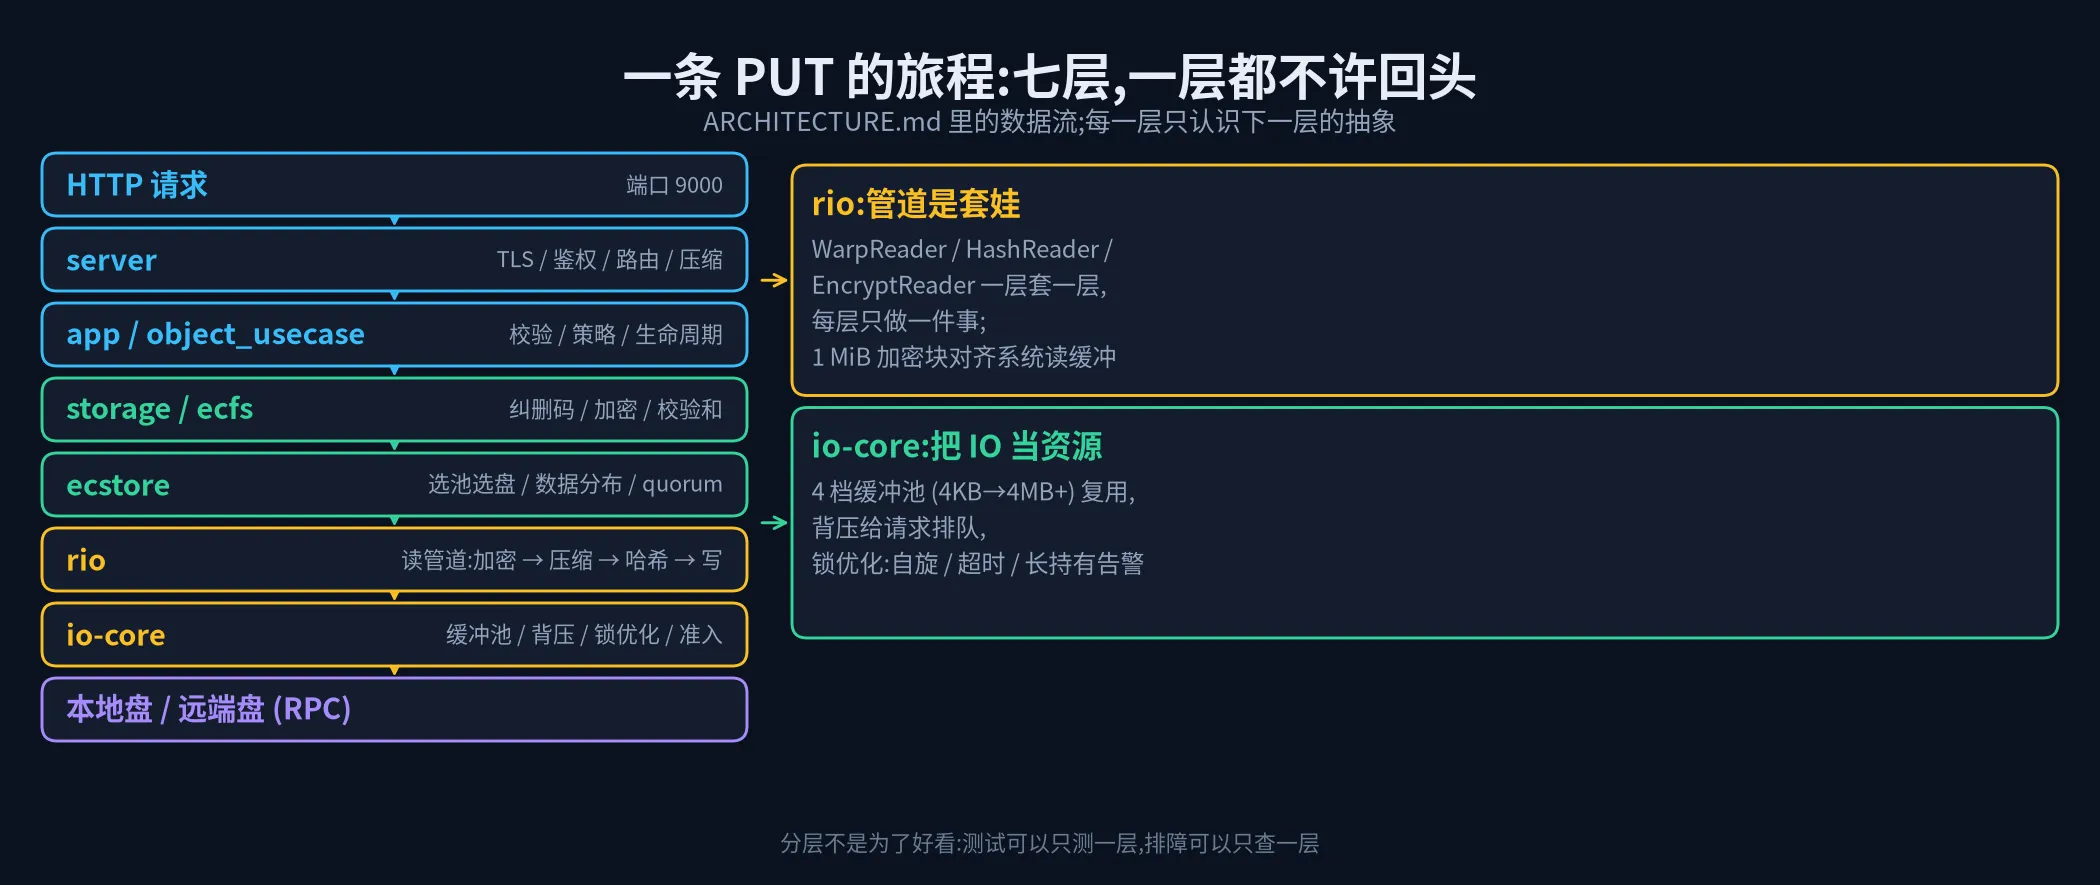
RustFS 的架构文档把数据流画成一条纵向的链表,从 HTTP 请求一路到底层磁盘,中间经过七层:
| 层 | 职责 |
|---|---|
| HTTP 请求 | 端口 9000,S3 协议入口 |
| server | TLS、鉴权、路由、请求/响应压缩 |
| app / object_usecase | 参数校验、桶策略、生命周期决策 |
| storage / ecfs | 纠删码、加密、校验和的落地 |
| ecstore | 选池选盘、数据分布、quorum 判定 |
| rio | 读写管道:加密、压缩、哈希、限流 |
| io-core | 缓冲池、背压、锁管理、准入控制 |
| 本地盘 / 远端盘(RPC) | 物理落盘 |
你可能会问:为什么要切这么多层?直接一个大函数写到底不是更快吗?
答案是:分层的收益不在跑得快,而在”局部可测”与”局部可查”。
想象一个真实故障:用户上传 100MB 的文件,每 10 次里有 1 次失败。如果没有分层,你要在几万行代码里找一个竞态。而有了分层,你可以先问:是协议层的问题吗(换个客户端还复现吗)?是加密层的问题吗(关掉加密还复现吗)?是选盘的问题吗(换一个池还复现吗)?每一层都是一个可以独立验证的假设。 排障的本质,就是把一个巨大的搜索空间切成若干个小的、可以回答的问题。
rio:一个”读管道”的套娃#
rio 这个 crate 做的事很纯粹:它是一堆可以互相套的 Reader / Writer 适配器。
EncryptReader/DecryptReader:DEFAULT_ENCRYPTION_BLOCK_SIZE是 1 MiB,注释里直接写了原因——和系统默认读缓冲对齐;CompressReader/DecompressReader:压缩与解压;HashReader:边读边算,还带 trailer 处理尾部校验;EtagReader:算 ETag;LimitReader/HardLimitReader:限流与硬上限;HttpReader/HttpChunkReader:处理分块传输;WarpReader:把上面这些串起来的那一层”外壳”。
于是数据在内存里的样子是一层套一层的:最外面是 HTTP 的字节流,往里剥一层是校验,再往里是解密,再往里是解压,最里面才是对象数据。 每一层只认识它下面那一层,不知道也不需要知道更下面的东西。
这种设计有一个我特别喜欢的副作用:顺序即正确性。加密块和读缓冲对齐、哈希在解密之后算、限流在解压之前判——这些顺序一旦被写死在一个稳定的抽象里,就很难被人无意中改错。相比之下,一段把这几件事混在一起的过程式代码,每一次改动都要重新论证一遍顺序。
io-core:把 IO 当成一种要配额的资源#
io-core 是我认为最”不像存储、倒像操作系统”的一个 crate。它管四件事:
第一,分档的缓冲池。 不是”每次都 Vec::with_capacity”,而是按尺寸分成四档复用:
| 档位 | 尺寸范围 |
|---|---|
| Small | 4 KB – 64 KB |
| Medium | 64 KB – 512 KB |
| Large | 512 KB – 4 MB |
| XLarge | > 4 MB |
分配时按需要的尺寸自动选档。为什么要分档?因为内存分配器对”大小混杂、频繁申请释放”的模式最没辙。把尺寸归一化到几档、把释放的缓冲放回池子,是让 GC-free 的语言真正跑出 GC-free 水平的关键一步。
第二,背压(backpressure)。 请求进来不是无脑往下冲,而是要先通过准入判断。这一点在对象存储里格外重要:一个 4KB 的 GET 和一个 5TB 的 PUT,如果被平等对待,那小请求的延迟会被大请求直接拖死。
第三,锁优化。 包括自适应自旋、获取超时、以及**“锁持有了多久”的告警**。最后这条特别值得学:大多数锁相关的事故不是”死锁”,而是”某个路径不小心把锁多拿了 200 毫秒”,在没有告警的系统里,它就会表现为”偶发变慢”,然后被所有人忽略,直到某天变成事故。
第四,死锁检测。
把这四件事抽出来放在一个独立的 crate 里,而不是散落在存储逻辑中,意义在于:并发控制变成了一等公民,而不是”顺便写的那几行”。
四、坏掉之后:自愈闭环,和一把锁#
前面聊的都是”正常路径”。但存储系统的成色,是在不正常的时候才显出来的。
盘会坏、扇区会烂、进程会被 kill、机器会掉电。面对这些,RustFS 的答案是两条并行的流水线:scanner(扫描) 负责发现,heal(自愈) 负责修复。
一条闭环#
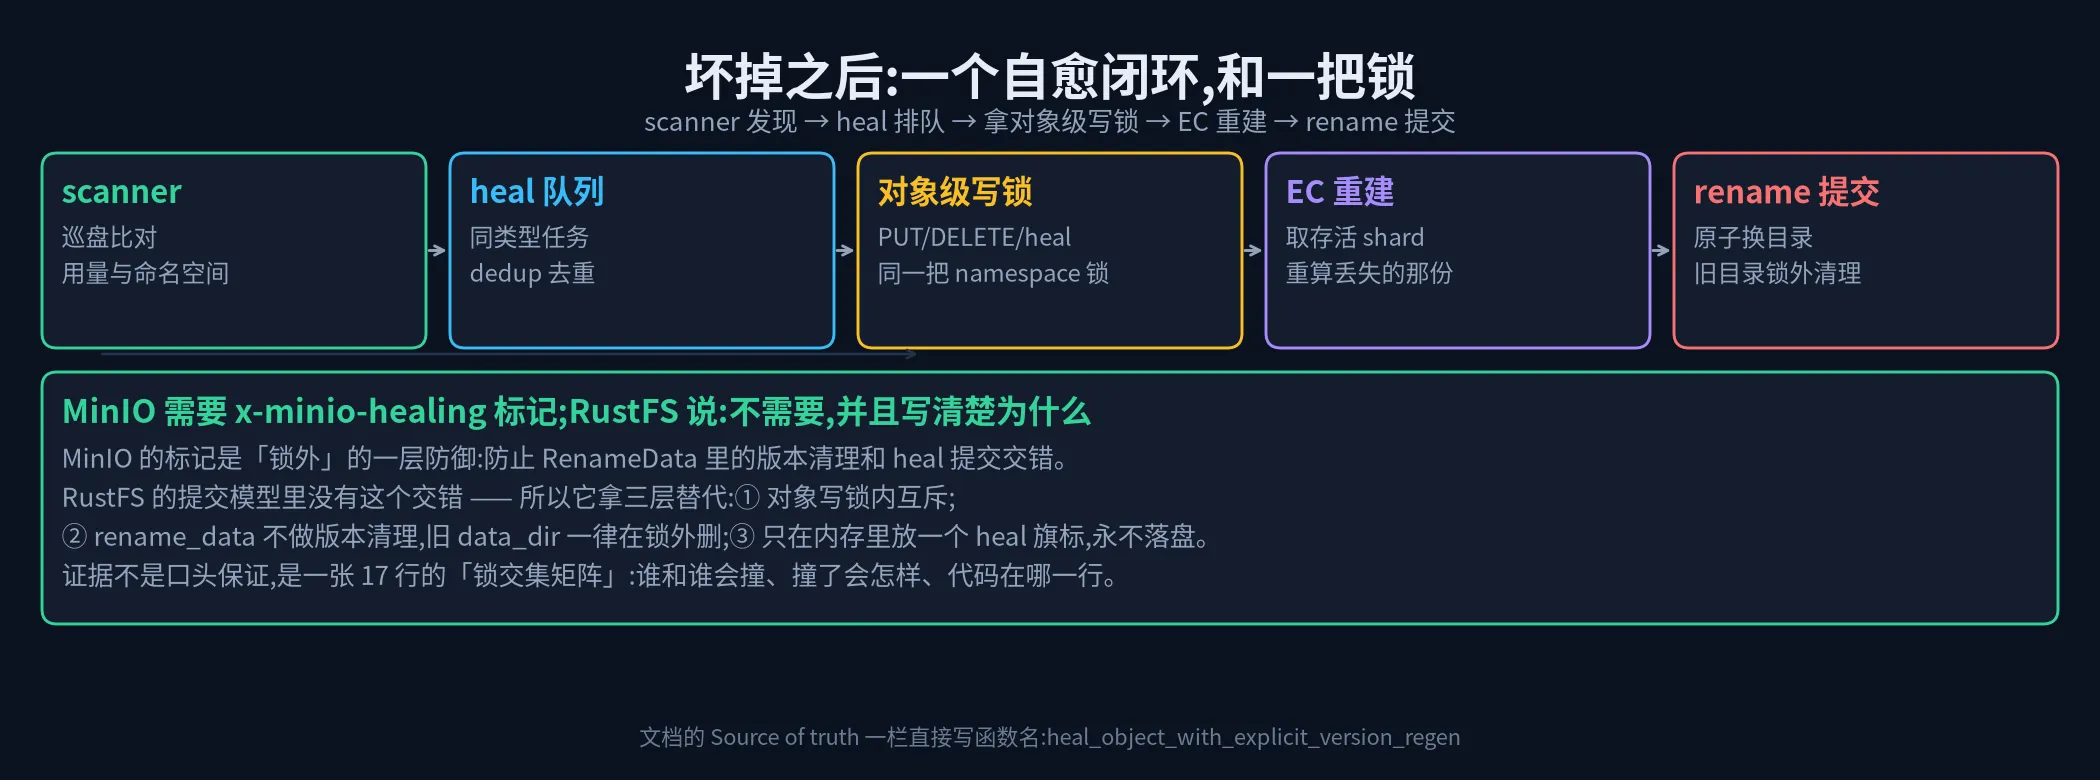
- scanner 定期巡盘,把”命名空间里有的”和”磁盘用量统计到的”做比对,找出失踪的分片、多余的残留、对不上的配额;
- heal 队列 接收修复任务,并按
HealType做 dedup——同一个对象、同一类修复,排队里只留一份; - 对象级写锁:这是整个闭环的核心。自愈并不是一条”特权路径”,它和前台 PUT / DELETE 抢的是同一把
(bucket, object)命名空间写锁; - EC 重建:从存活的 shard 里把丢失的那份算回来;
- rename 提交:用目录重命名做原子提交,而被替换掉的旧目录在锁释放之后才清理(文档里管这叫 commit tail);
- 最后,校验通过,孤儿目录被回收。
这个设计里最值得注意的一句话是:heal 不是特权路径。很多系统会给后台修复开一条”快车道”,因为”它很急”;但快车道意味着它绕过了前台路径的互斥规则,也就意味着你多了一套需要单独论证的并发模型。RustFS 的选择是让自愈老老实实排队拿锁——慢一点,但只需要一套正确性证明。
一个”不做”的决定#
这里有个我觉得特别能说明团队水平的细节。
MinIO 有一类东西叫 x-minio-healing 标记:在对象元数据上打一个旗标,告诉别的路径”这个对象正在自愈中”。它是锁外的一层防御,用途是防止 RenameData 内部的版本清理逻辑,和 heal 的提交过程交错在一起。
RustFS 的架构文档专门有一节讨论这件事,结论是:不需要这个标记,而且 x-minio-healing 在它的 crates/ 与 rustfs/ 里一次都没出现。
它凭什么不需要?因为它换掉了前提。文档给出的理由是:MinIO 需要这个标记,是因为它的 RenameData 里带着版本清理逻辑,会和 heal 提交交错;而 RustFS 的提交模型里,根本不存在这个交错。于是那个防御性标记失去了一半的存在理由。
但它没有停在”所以我们不需要”这一句上。它用三层机制替代了那个标记:
- 锁内互斥:heal 和所有写路径的提交点,持同一把
(bucket, object)命名空间写锁; - 提交模型隔离:
rename_data里没有任何可能和 heal 交错的版本清理;旧data_dir的物理删除放在锁释放之后,且只针对已被新提交取代、且不再共享的目录; - 瞬态旗标:heal 提交时,在内存里的
FileInfo上打一个内部键,rename_data通过它清掉目标位置上陈旧的、非空的data_dir(因为原地修复会复用目录,而rename(2)无法覆盖非空目录)。这个键永不落盘。
然后,最有说服力的部分来了:文档给了一张 17 行的”锁交集矩阵”。它把每一条可能与 heal 并发的路径列出来——PUT 提交、PUT 的旧目录尾清理、DELETE、批量 DELETE、CompleteMultipartUpload、AbortMultipartUpload、ILM 过期、数据搬迁、CopyObject、另一个 heal 任务、管理员 heal 且 nolock=true、过期 multipart 清理……对每一条,它回答三个问题:它持有什么锁?结果是串行、无锁但语义安全、还是资源不相交?代码在哪一行?
| # | Concurrent path | Lock held by that path | Outcome | Where |
| 1 | PUT commit | object write lock; rename_data inside it | serialized | ops/object.rs put commit |
| 2 | PUT old data_dir tail cleanup | none (runs after the lock is dropped) | unlocked, semantically safe | core/io_primitives.rs |
| 7 | AbortMultipartUpload | upload-path lock in the multipart bucket only | disjoint resources | ops/multipart.rs |
| 16 | Admin heal with nolock=true | caller bypasses the lock | unlocked by operator choice | rustfs/src/admin/handlers/heal.rs |
| 17 | Stale multipart cleanup | upload-path lock in the multipart bucket | disjoint resources | bucket_lifecycle_ops.rs |这才是”我们不需要那个标记”这句话的正确说法。 它不是一句断言,它是一份可以被逐行反驳的论证:你可以指着第 16 行说”这里绕过了锁,凭什么安全”,文档就会告诉你那是操作员显式选择的、以及在什么前提下它才安全。
我在这张表上停留了很久。因为大多数项目的文档到这里会写一句”heal 与写路径通过锁保证互斥”,然后结束。把”我为什么不需要别人需要的那层防御”写成一张可审计的矩阵,是一种罕见的自我要求。
到这里,前四节回答的是”它怎么工作”。但一个 154 万行的系统能长期不变烂,靠的不是这些设计,而是设计之外的纪律。这是我认为 RustFS 最值得一读的部分,也是下一节的内容。
五、真正稀缺的部分:纪律#
前面四节讲的全是”设计”。设计是可以学的:纠删码的数学、缓冲池的分档、锁的粒度,任何一个合格的工程师读完文档都能复述出来。
但一个 154 万行、几百个 crate、几十个人协作的系统,它真正的难点从来不是某个设计不够聪明,而是两年之后它还能不能保持聪明。
这一节是这篇文章我最想推荐给项目负责人的部分。RustFS 在”防止自己变烂”这件事上,做了六件我认为非常值得抄的事。
5.1 把已知的违规,写进架构文档#
大多数项目的 ARCHITECTURE.md 是一份理想宣言:“我们的分层是 A → B → C,依赖必须向下流动。”
问题是,现实中的代码库几乎从不满足宣言。于是文档变成装饰,没人再看第二遍。
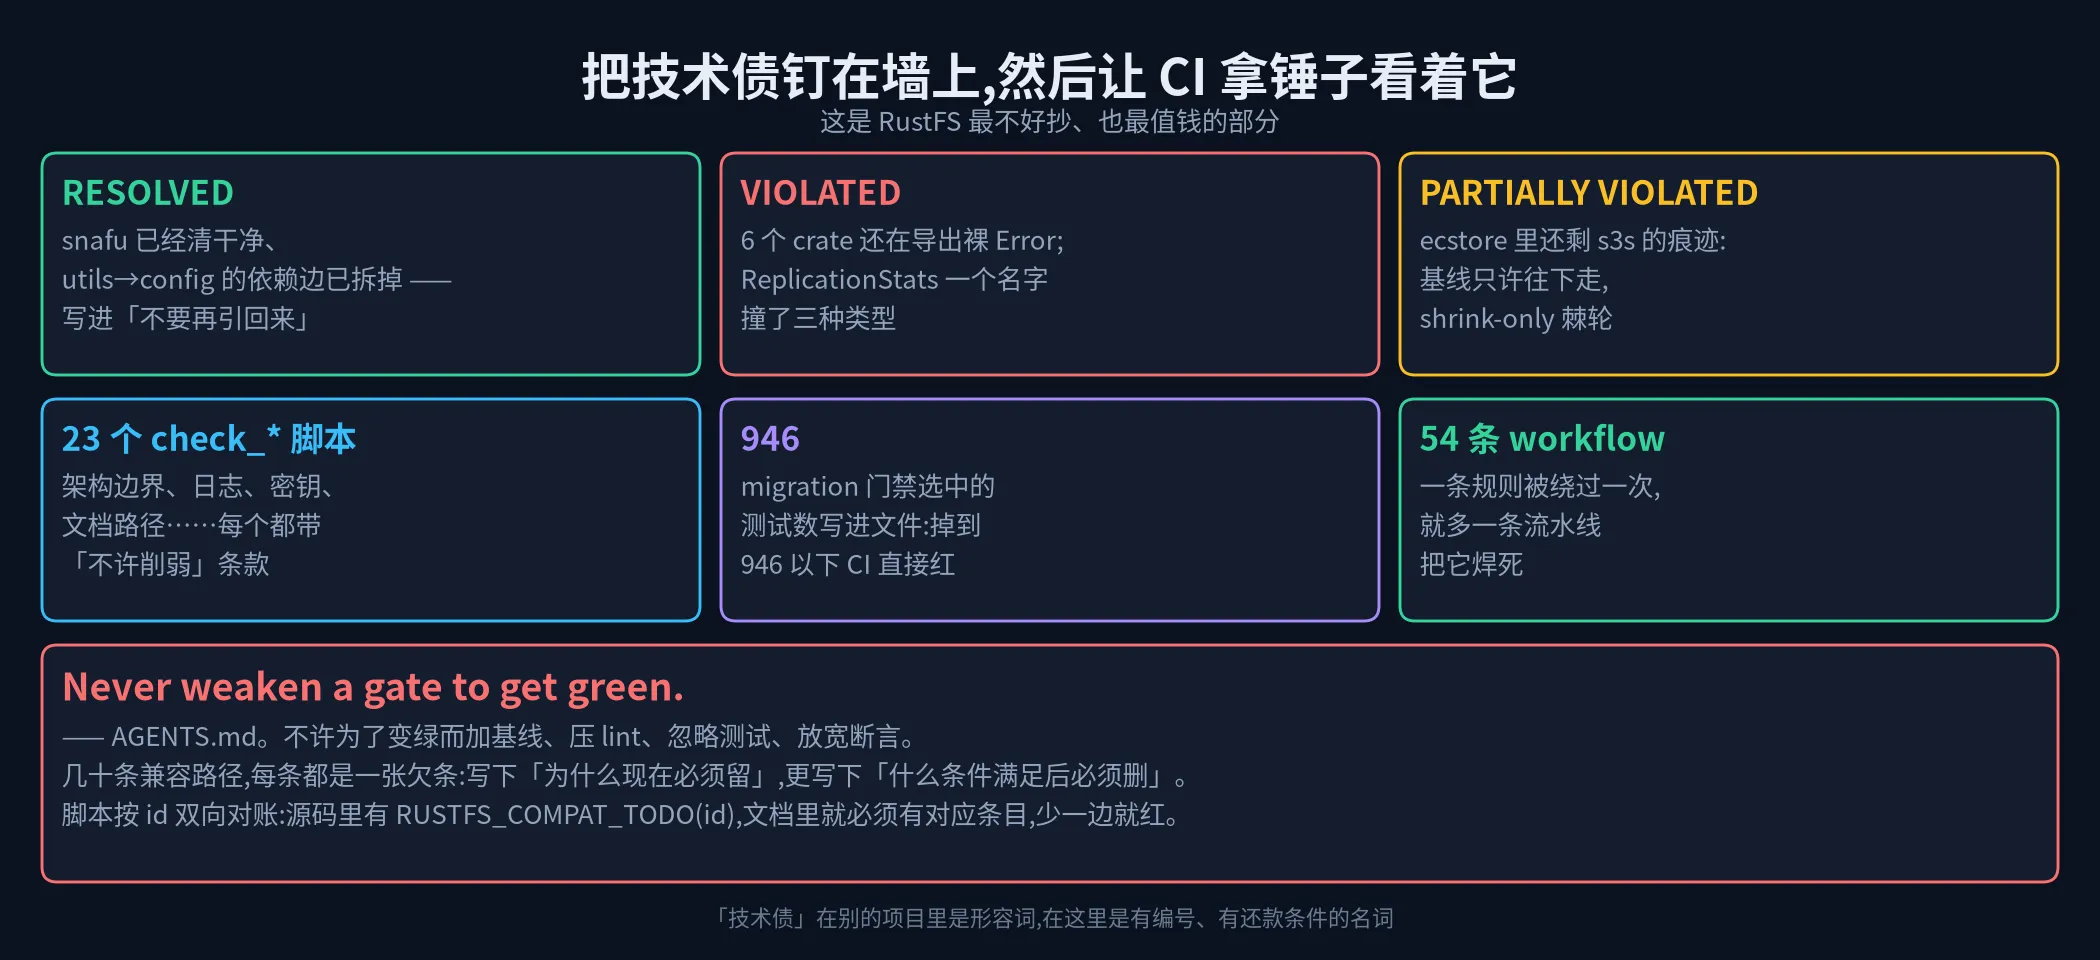
RustFS 的做法很反直觉。它的架构文档里有一条明确的规则——它把”理想的规则”和”当前的违规”放在同一页,并且用 ✅ / ⚠️ 标出来:
- ✅ RESOLVED:历史上
utils → config、common → filemeta的依赖边已经被拆掉了,现在写在这里是为了”不要引回来”。 - ⚠️ VIOLATED:
ReplicationStats这个名字,在三个 crate 里其实是三个毫不相干的类型——一个命名冲突,不是复制粘贴,重命名挂在backlog#1847。 - ⚠️ VIOLATED(命名):还有 6 个 crate 在导出裸的
pub enum Error(crypto、filemeta、heal、iam、policy、replication),它们都已经是thiserror派生的,但名字还没改。 - ⚠️ PARTIALLY VIOLATED:ecstore 里还残留着服务端的
s3s痕迹,数量由scripts/check_s3s_footprint.sh只减不增地盯着,目标是基线归零、并把s3s从Cargo.toml里删掉。
文档开头有一句注,把这套做法的动机说得明明白白:
这些是代码库应该遵守的规则。其中一部分当前是被违反的(用 ⚠️ 标出)。把它们写在这里,是为了让违规显式且可追踪。
这句话是整个仓库里我最喜欢的一句。 因为它承认了一件大多数团队不愿意承认的事:架构文档的价值不在于描述”我们有多干净”,而在于把”我们哪里脏、脏到什么程度、打算什么时候洗”变成一份公开的账。
违规只要写在明处,它就是技术债;只要藏在暗处,它就是技术债 + 谎言。
5.2 每一条兼容,都是一张欠条#
上一节说的”兼容路径”,在 RustFS 里有一条专门的登记制度。
仓库里有一份 compat-cleanup-register.md,登记着 39 条仍在生效的兼容路径。它的规则是这样的:
- 每引入一条临时兼容路径(回退逻辑、包装、转导出、旧编解码器),源码里必须留下一个标记:
rust// RUSTFS_COMPAT_TODO(<task-id>): <why this compatibility path exists>. Remove after <specific condition>. - 文档里必须有一条对应的
## Open Items条目,写清楚它为什么现在不能删、以及什么条件满足后必须删; - 二者由
scripts/check_architecture_migration_rules.sh双向对账:源码里有标记、文档里没条目 → 红;反之亦然。
你去看那 39 条的措辞,会发现”删除条件”从来不是”以后有空”这种话,而是可判定的:
rustfs-5509(FileInfo 的位置式 MessagePack 解码):beta.11 序列化了 28 个字段,beta.12 在中间插入了过渡字段、序列化成 30 元素数组。两个版本不兼容。所以新版本写命名 map、但同时保留两种旧数组的读取器。删除条件:当所有受支持的直接升级版本都写命名 map、且不再有任何 RPC 载荷可能是 map 之前的数组。tonic-013-status-render(对端 RPC 失败分类):1.0.0-alpha.38 及更早用的是 tonic 0.13,它把 gRPC 状态渲染成status: Unavailable, message: ...;tonic 0.14 渲染成code: 'The service is currently unavailable', message: ...。因为老节点只会把文本转发给你,所以两种形式都要匹配,否则会把一个不可达的对端误判成在线。删除条件:当最低支持的 RustFS 对端版本都用 tonic 0.14 或更高。
tonic-013-status-render 是我最喜欢的一条。注意它兼容的不是什么”历史格式”,而是上游依赖的一次错误信息措辞变化。这种坑,通常只会变成某人脑子里的一段口口相传的经验,然后在下一次升级时被踩第二次。而 RustFS 把它变成了一条带编号、带删除条件、被脚本盯着的记录。
所谓”兼容债”,最危险的不是它存在,而是它没有还款日期。
5.3 棘轮:门禁只许收紧,不许放宽#
有了登记,还需要有人盯着。RustFS 用了一个在编译器和 refactoring 工具里常见的技巧:棘轮(ratchet)。
- ecstore 里的
s3s痕迹数量,由一个基线文件记录,只减不增; - 另一个脚本盯着”错误处理写法”的调用点数量,同样只减不增;
- 数一数仓库里
check_*开头的脚本:23 个。它们的名字说明了它们各自在看什么:架构分层依赖、文档路径有效性、内嵌密钥、leaf crate 的依赖白名单、日志规范、unsafe 白名单、FIPS 措辞、甚至”不许提交一次性计划文档”;
check_layer_dependencies.sh 里藏着这套体系最锋利的地方:leaf crate 只允许依赖外部 crate,而允许的例外是两个被”钉死”的名字——io-metrics 只准依赖 rustfs-s3-ops,madmin 只准依赖 rustfs-signer。这两个钉子写在脚本的允许清单里,任何其他内部依赖都会让门禁失败。也就是说,连”哪些违规例外是被批准的”都入库了。
然后是测试数的硬地板。.config/migration-gate-floor.txt 里写着一个数字:946。
# Committed floor for the number of tests selected by the migration-critical
# CI gate ...
# CI fails if the selected count drops below this number, so renames or
# removals that thin the gate must update this file in the same PR.这 946 是”数据搬迁 / rebalance / 下线 / 源清理 / delete marker”这几类关键测试被门禁选中的精确条数。测试数掉到 946 以下,CI 直接红。文件注释里还有一句很妙的话:加测试不需要改这个文件,但改这个文件会让门禁变紧。
.config/ 里还有一份 security-smoke-floor.txt,记录着安全负向鉴权测试的条数地板:28。同一个套路,管的是安全。
5.4 “不许为了变绿而放宽门禁”#
上面这些机制,最终收敛到 AGENTS.md 里的一句硬规矩:
Never weaken a gate to get green:不许为了变绿而加基线、压 lint、忽略测试、放宽断言,除非”改这条策略”本身就是这次被评审的任务。
我读到这里的时候停了一下。
因为这句话几乎是在描述每个工程师都干过的事:CI 红了,你看了看,觉得”这不就是个边界情况吗”,然后加了一行 #[ignore],或者把断言从 assert_eq! 换成 assert!。单次没有恶意,但它有个特点:它是复利。 每一次放宽都是永久性的,而每一次收紧都需要勇气和论证。
把”不许放宽”写成仓库级的硬规则,等于把每一次”心软”的成本抬到了最高——你要么真的去修,要么得专门开一个 PR 来论证”这条策略该改”。
5.5 事故复盘:写到能教会别人#
docs/postmortems/ 里目前有一篇。我把它完整读了两遍,因为它几乎是一份”事故报告该怎么写”的范本。
事情本身不复杂:有人为了修一个 Bug(#6853:某个目标端会原样保存 aws-chunked 分帧),把对外复制请求的 SDK 校验和策略从 WhenSupported 改成了 WhenRequired。这个改动顺手取消了一个没人写下来的副作用:SDK 自动算的 CRC32,同时也在满足 S3 的一条隐含规则——带 Object Lock 头的 PutObject,必须携带 Content-MD5 或 x-amz-checksum-*。
校验和没了,于是所有带保留期或法定持有的对象复制,都被 AWS 兼容的 Object Lock 目标端拒绝。事故在 rc.5 发布,两天后被客户报上来。
报告的写法让我 Respect 的地方在于三件事。
第一,它把时间线摊到分钟,并且不美化。
2026-08-29 14:49  问题从第二轮真实 VM 实验被发现
2026-08-30 14:24  PR 打开
2026-08-30 17:43  PR 合并(GitHub 上零条 review,对抗性验证在会话内完成)
2026-08-31        rc.5-preview.1 打标签
2026-09-01 17:35  rc.5 打标签
2026-09-02 20:29 客户报障“零条 review”这五个字是作者自己写上去的。从自己实验室发现问题到公开发布候选版,三天,中间没有任何一个 Object Lock 目标端被真正跑过。
第二,它说的是”四层防御为什么全都漏了”,不是”某人疏忽”。
- 变更设计层:一个适用于所有目标端的默认值,被改成了只为一类目标端服务。PR 只考虑了”已经带校验和的对象会怎样”,从没反过来问:哪些目标端的规则,依赖这个校验和必须存在?
- 测试层:新加的单测断言的是”修复生效了”(不再有
x-amz-trailer),而不是”契约被满足了”(目标端接受了这次 PUT)。而那个假目标端,既没有模拟”原样保存aws-chunked”,也没有模拟”带锁的 PUT 必须带校验和”。 - 评审层:兼容性评审清单里只有入向和落盘的关注点(
xl.meta、proto、MinIO 夹具),一条关于出向目标端行为的都没有。所以那轮评审在主攻方向上通过了,却对这一整类问题盲了。 - 发布层:两个新的环境变量逃生开关,没写文档。而客户后来的第二个问题恰恰就是”有没有配置项能绕过”——有,但没人找得到。
四层,miss 的是同一件事:一张”远端目标端可能对出向请求提出什么要求”的清单。
第三,它写”故意不做的事”。
修复清单里有 7 条行动项。其中最后一条是:给 replication-check 的探测 PUT 加上保留期头——故意不做(deliberately not done)。理由写得很清楚:一个带保留期的探测对象,在那些禁止 s3:BypassGovernanceRetention 的目标端上清理不掉,会留下锁死的残留物;所以改用矩阵来钉住这个契约,而不是塞一个跑完洗不掉的探针。
这一条比前面六条加起来更值钱。 因为它记录的不是”我们做了什么”,而是”我们考虑过、权衡过、然后决定不做什么,以及为什么”。这种信息在绝大多数团队里根本不会被写下来,于是半年后总会有人兴冲冲地再提一遍,然后被另一个还记得的人拦下来。
报告最后还有一份 SOP:以后任何改变出向客户端默认行为的改动,都必须先列出”当前默认值满足了哪些目标端规则”、跑一遍目标端矩阵、把新失败模式加进假目标端、把所有逃生开关写进文档、并把”验证过的目标端类别”和”没验证的”一起写进 PR。其中第 2 条的完成标准写得特别硬:当每个格子都符合预期,且没有任何一条预期被就地修改成能过。
5.6 把 AI 当同事:一份 183 行的 AGENTS.md#
最后一件事,可能对很多人来说是新的。
RustFS 仓库根目录有一份 AGENTS.md,183 行。它不是给人看的流程图,而是一份可执行的操作手册,给人看,也给编码 agent 看。它规定的东西细到什么程度:
-
优先级:系统指令 > 用户请求 > 就近的
AGENTS.md> 技能与参考文档; -
操作模型:查询、诊断、评审、规划任务默认只读;实现时”做能解决问题的最小改动”;不要预先加载所有技能;
-
验证分级:改文档和注释?跑
git diff --check就行,明确禁止去跑 Cargo 格式化、编译、Clippy、测试;改局部行为?跑最窄的那个测试;跨模块大改?默认也不跑全量 pre-pr,由你根据影响边界动态决定; -
对抗性验证:明确列出不触发的场景(普通提问、诊断、状态汇报、非对抗性的代码评审),并且写了一句我非常喜欢的话:
A review has no finding quota; No findings is a complete outcome. A request to find problems is not evidence that a defect exists.翻译过来:评审没有”必须找到几个问题”的配额,“没找到问题”是一个完整的结论;而”请你找找问题”这个请求本身,不等于”一定存在缺陷”。
它还要求:报告任何一个发现之前,先去看调用方、不变量和现有测试,找能否证伪它的证据;发现必须带
file:line和具体失败;缺测试算”验证缺口”,不算”运行时 bug 的证据”。这几句话几乎是在给”AI 评审输出一堆幻觉问题”这件事上药。它把评审的产出重新定义为”证据”,而不是”意见”。
-
禁止提交一次性计划文档:迁移清单、基准快照、agent 的草稿笔记都不许进仓库,而且有一个脚本 (
check_no_planning_docs.sh) 专门盯着这条——“耐久的架构放进docs/architecture/,运维放进docs/operations/,测试参考放进docs/testing/”。
写到这里,你应该能看出这六件事的共同形状了:它们都在把一个”人的判断”,变成一条”可验证的规则”;再把这条规则,变成一道”会自动变红的门禁”。
判断靠人,人会走、会累、会心软;规则不靠人,规则会红。
六、那它到底值不值得用?#
讲完了六件好事,得回到现实。
看一个项目值不值得上生产,不能只看它做对了什么,还要看它做错了什么、以及还没做什么。 我把 RustFS 自己写下的边界整理成一张清单:
它的长处(适合谁):
- 你要的是 Apache 2.0,而不是 AGPL。这一点对要闭源分发、或者要把存储嵌进商业产品的团队是决定性的;
- 你要跑在自己的硬件上,并且在意数据不出门;
- 你已经在跑 MinIO,想找一个迁移路径。注意前提:得用
rio-v2构建,且对象没有被 SSE 加密; - 你要对象存储 + 数据湖(S3 Tables / Iceberg REST),接受它目前是 Preview;
- 你要多协议(FTPS / WebDAV / SFTP / Swift API / Keystone / OIDC),这些大多已经有 CI 门禁覆盖。
它的边界(要谨慎的):
- 1.0.0 是 2026 年 9 月 16 日发布的。 仓库里的版本号已经是 1.0.1。也就是说,这是一个刚过 1.0 的年轻项目——它有 33k star,但”有没有在高强度场景里跑满两年”是另一回事;
- 单机单盘(SNSD)不能原地扩容,也不能作为一个 Pool 加进去;要迁移只能另起一套、走 S3 搬数据;
- 已有的多盘 Pool 不能改端点、不能改 Erasure Set 宽度,扩容方式是追加新 Pool;而且基于省略号的扩容语法要求每个 Pool 参数都包含省略号表达式、且至少展开成两个盘端点;
- MinIO 落盘兼容默认关闭,要单独编译
rio-v2构建变体; - MinIO 用 SSE 加密过的对象默认读不出来;而
rio-v2写出去的 SSE 对象,也应该视为”只有 RustFS 自己能读”; - 自动 parity(校验块数量)的选择方式与 MinIO 不同。README 专门提醒:扩容之前要先读 pool 布局兼容性文档和回归测试——这是个非常实在的警告,因为它意味着你不能拿”我们以前 MinIO 是这么扩的”当依据。
性能数字方面,README 给出的压测环境是:2 核 Intel Xeon Platinum 8475B、4GB 内存、15Gbps 网卡、4 块 40GB 盘(每块 3800 IOPS)。
我这里不做转述,因为它后面的对比结果是以图片形式给出的,转述容易失真。但我注意到一个比数字更有意思的细节:这台的配置实在很小。 一台 2 核 4GB 的机器去跑对象存储压测,说明作者想回答的问题不是”我能跑多快”,而是”我在很差的硬件上,能比对手快多少”。敢用小机器做基准的团队,通常对”开销”这件事有真实的敬畏。
所以我的结论是:
如果你现在要选一套生产对象存储,MinIO 依然是更稳妥的默认答案;RustFS 是一个理由充分、边界清楚、值得放进候选名单的新选项。
如果你只是想学东西——它可能是这两年最值得逐页读的开源存储项目之一。
七、六条你可以直接带走的#
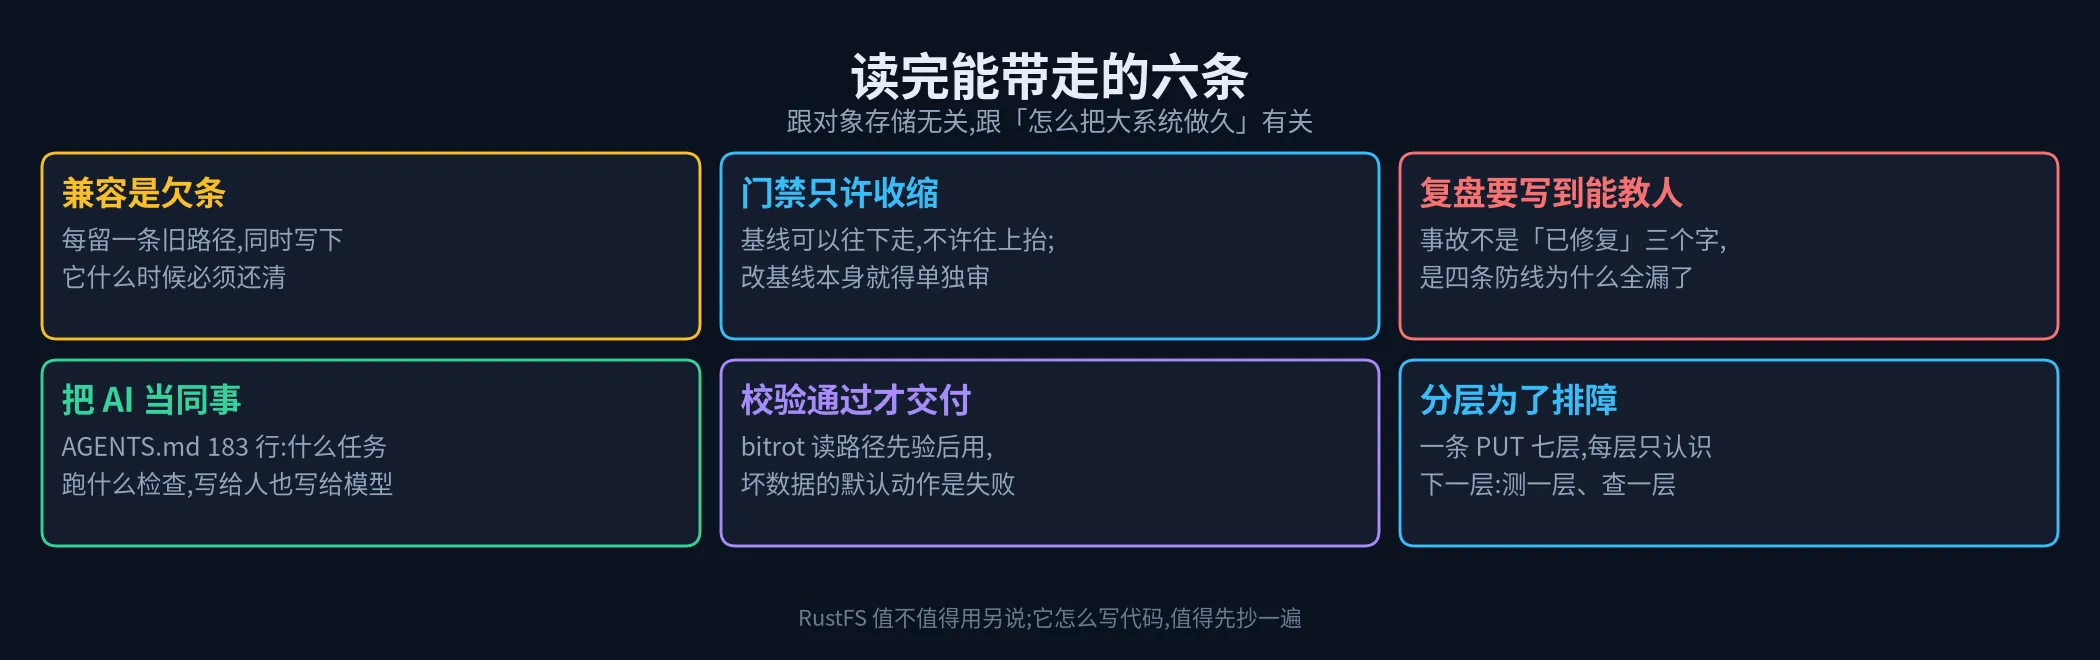
最后,把这一路读到的东西,压成六条跟对象存储无关、但跟”怎么把大系统做久”有关的经验:
① 兼容是欠条,要写还款条件。 每留一条旧路径,同时写下”它为什么存在”和”什么条件满足后必须删”。没有还款日期的兼容债,永远还不上。
② 门禁只许收缩,不许放宽。 把”现在的违规数量”写成一个基线文件,让它只减不增。改基线这个动作本身,得单独走一次评审。
③ 复盘要写到能教人。 “已修复”三个字不是复盘。复盘是:时间线、四层防御各自为什么没拦住、以及你考虑过但决定不做的事。
④ 把 AI 当同事,而不是当搜索引擎。
写一份 AGENTS.md:什么任务跑什么检查,什么算证据、什么只是意见,什么场景不触发对抗性评审。它对人有效,对模型同样有效。
⑤ 校验通过才交付。 读路径上”先验后用”,坏数据的默认动作是失败而不是糊过去。一个安静的错值,比一次响亮的失败危险得多。
⑥ 分层是为了排障。 一条 PUT 走七层,不是为了优雅,是为了把一次”偶发失败”的排查,拆成七个可以独立回答的小问题。
一些数字(统计于 2026-09-19)#
| 项目 | 数值 |
|---|---|
| Star / Fork / Contributor | 33.3k / 1,489 / 169 |
| 首次提交 | 2023-11-23 |
| v1.0.0 发布 | 2026-09-16(仓库内版本 1.0.1) |
| 许可 | Apache-2.0 |
| crates | 51 个 + 1 个主程序 crate |
| Rust 文件 / 行数 | 1,898 个 / 约 154 万行(含测试) |
| 设计文档 | 254 篇 Markdown(其中 docs/architecture/ 35 篇) |
| 脚本 / 门禁脚本 | 167 个 / 23 个 check_* |
| CI 流水线 | 54 条 workflow |
| 给 agent 的技能 | 13 个(.agents/skills/) |
| 遗留兼容条目 | 39 条(均有编号和删除条件) |
| 关键测试数地板 | 946(migration gate)/ 28(security smoke) |
参考#
- 仓库:github.com/rustfs/rustfs ↗
- ARCHITECTURE.md ↗ —— 架构不变量与已知违规
- docs/architecture/erasure-coding.md ↗ —— 纠删码与落盘兼容契约
- docs/architecture/compat-cleanup-register.md ↗ —— 兼容欠条登记簿
- docs/architecture/heal-concurrency-model.md ↗ —— 自愈的锁与提交模型
- docs/architecture/minio-file-format-compat.md ↗ —— MinIO 落盘兼容边界
- docs/postmortems/2026-09-03-replication-checksum-default-regression.md ↗ —— 本文引用的那份事故复盘
- AGENTS.md ↗ —— 183 行的仓库级操作手册
写到最后的最后。
这篇文章我最初的标题草稿是”一个更快的 MinIO”,后来改掉了。
因为读完之后,让我印象最深的不是它跑得多快,而是它对待自己缺陷的方式:违规挂在墙上,欠条写上去除条件,棘轮只许顺时针转,复盘写到能被后人当教材。
一个系统能走多远,当然取决于它一开始设计得多好。但十几年后回头看,更决定性的往往是:当它变旧、变脏、变成一坨没人敢动的东西时,还有没有人愿意诚实地把它写下来。
RustFS 至少现在,是愿意的。