[论文解读] Same Query, Different Answer:语义查询在重复执行之间为什么不稳
💬 评论arXiv 2610.13823 来自 IBM。1.2M 次模型调用证明 temperature 0 不等于确定性,item 翻动 0.07%~24%,plan 算子指数级放大,质量分藏住一半以上答案变化;附 7+5 条 benchmark 报告与引擎设计建议。
语义查询的”重复执行漂移”:为什么同一句 SQL,跑 5 次会拿到 5 个不同的答案#
论文来自 IBM Research 的 Oktie Hassanzadeh 和 Dharmashankar Subramanian,2026-10-09 上 arXiv(2610.13823 [cs.DB])。读完之后我最大的感受是:他们做的事情看起来很工程,但结论反直觉得很扎实——temperature 0 并不等于确定性,语义查询引擎在工程上几乎是”概率数据库”,只是大家一直假装它不是。下面把我读完代码、跑过脚本、记在笔记里的那些东西,按论文的逻辑重新讲一遍。
0. 先把场景摆出来#
“语义查询”(Semantic Query)就是给经典 SQL 加上一类新的算子:不再只对”行 = 列值”做判断,而是把行(或一对行)丢给大模型,让模型用自然语言判定要不要保留 / 怎么映射 / 怎么 join。LOTUS、Palimpzest、ThalamusDB、DocETL、FlockMTL、Snowflake Cortex 这一票 2024-2026 出来的新系统都是这个路数。
这一类算子有个共同的特点:模型的输出不是单纯由输入决定。一个 Boolean filter,prompt 没变、温度设成 0、同一行数据,理论上应该返回同一个 True / False。理论上。
这篇论文想问的核心问题就一个:“理论上” 到底成立吗? 不成立的话,不成立多少?哪个环节引入的?我们能修吗?
他们给出的实验规模回答:“不成立,在每一个层面都不成立,而且非常不成立。“
1. 论文要解决的真问题#
语义查询领域默认了一个隐含假设:一次执行 = 一个答案。从 benchmark 比较,到 optimizer 校准 proxy / cascade,到引擎存语义输出供后续复用,所有这些上层技术都把”模型在 item 维度的输出”当成数据库的”主键命中”——给一个 input,系统给一个确定的 output,然后把它存进表里。
但 LLM 端点不是这种 oracle。论文 §1 把现有的几条外部证据列得很清楚:
- 温度 0 下 LLM 输出仍会变 [3, 20, 38, 49, 54]
- 托管 API 不保证确定性 [37]
- 推理服务器 batching 改变浮点规约顺序,降低精度放大效应 [20, 54]
- 端点背后的部署会随时间变化(论文自己就踩到了:一个部署在两次实验之间变了)
这些证据在 LLM 评测圈是常识,但在数据库 / 语义查询圈很少有人正面讨论。论文的贡献不是新算法,是一份”端点假设到底能撑多远”的系统化报告,附带 7+5 条可落地的报告和工程建议。
整个故事我用一张图压成 30 秒:
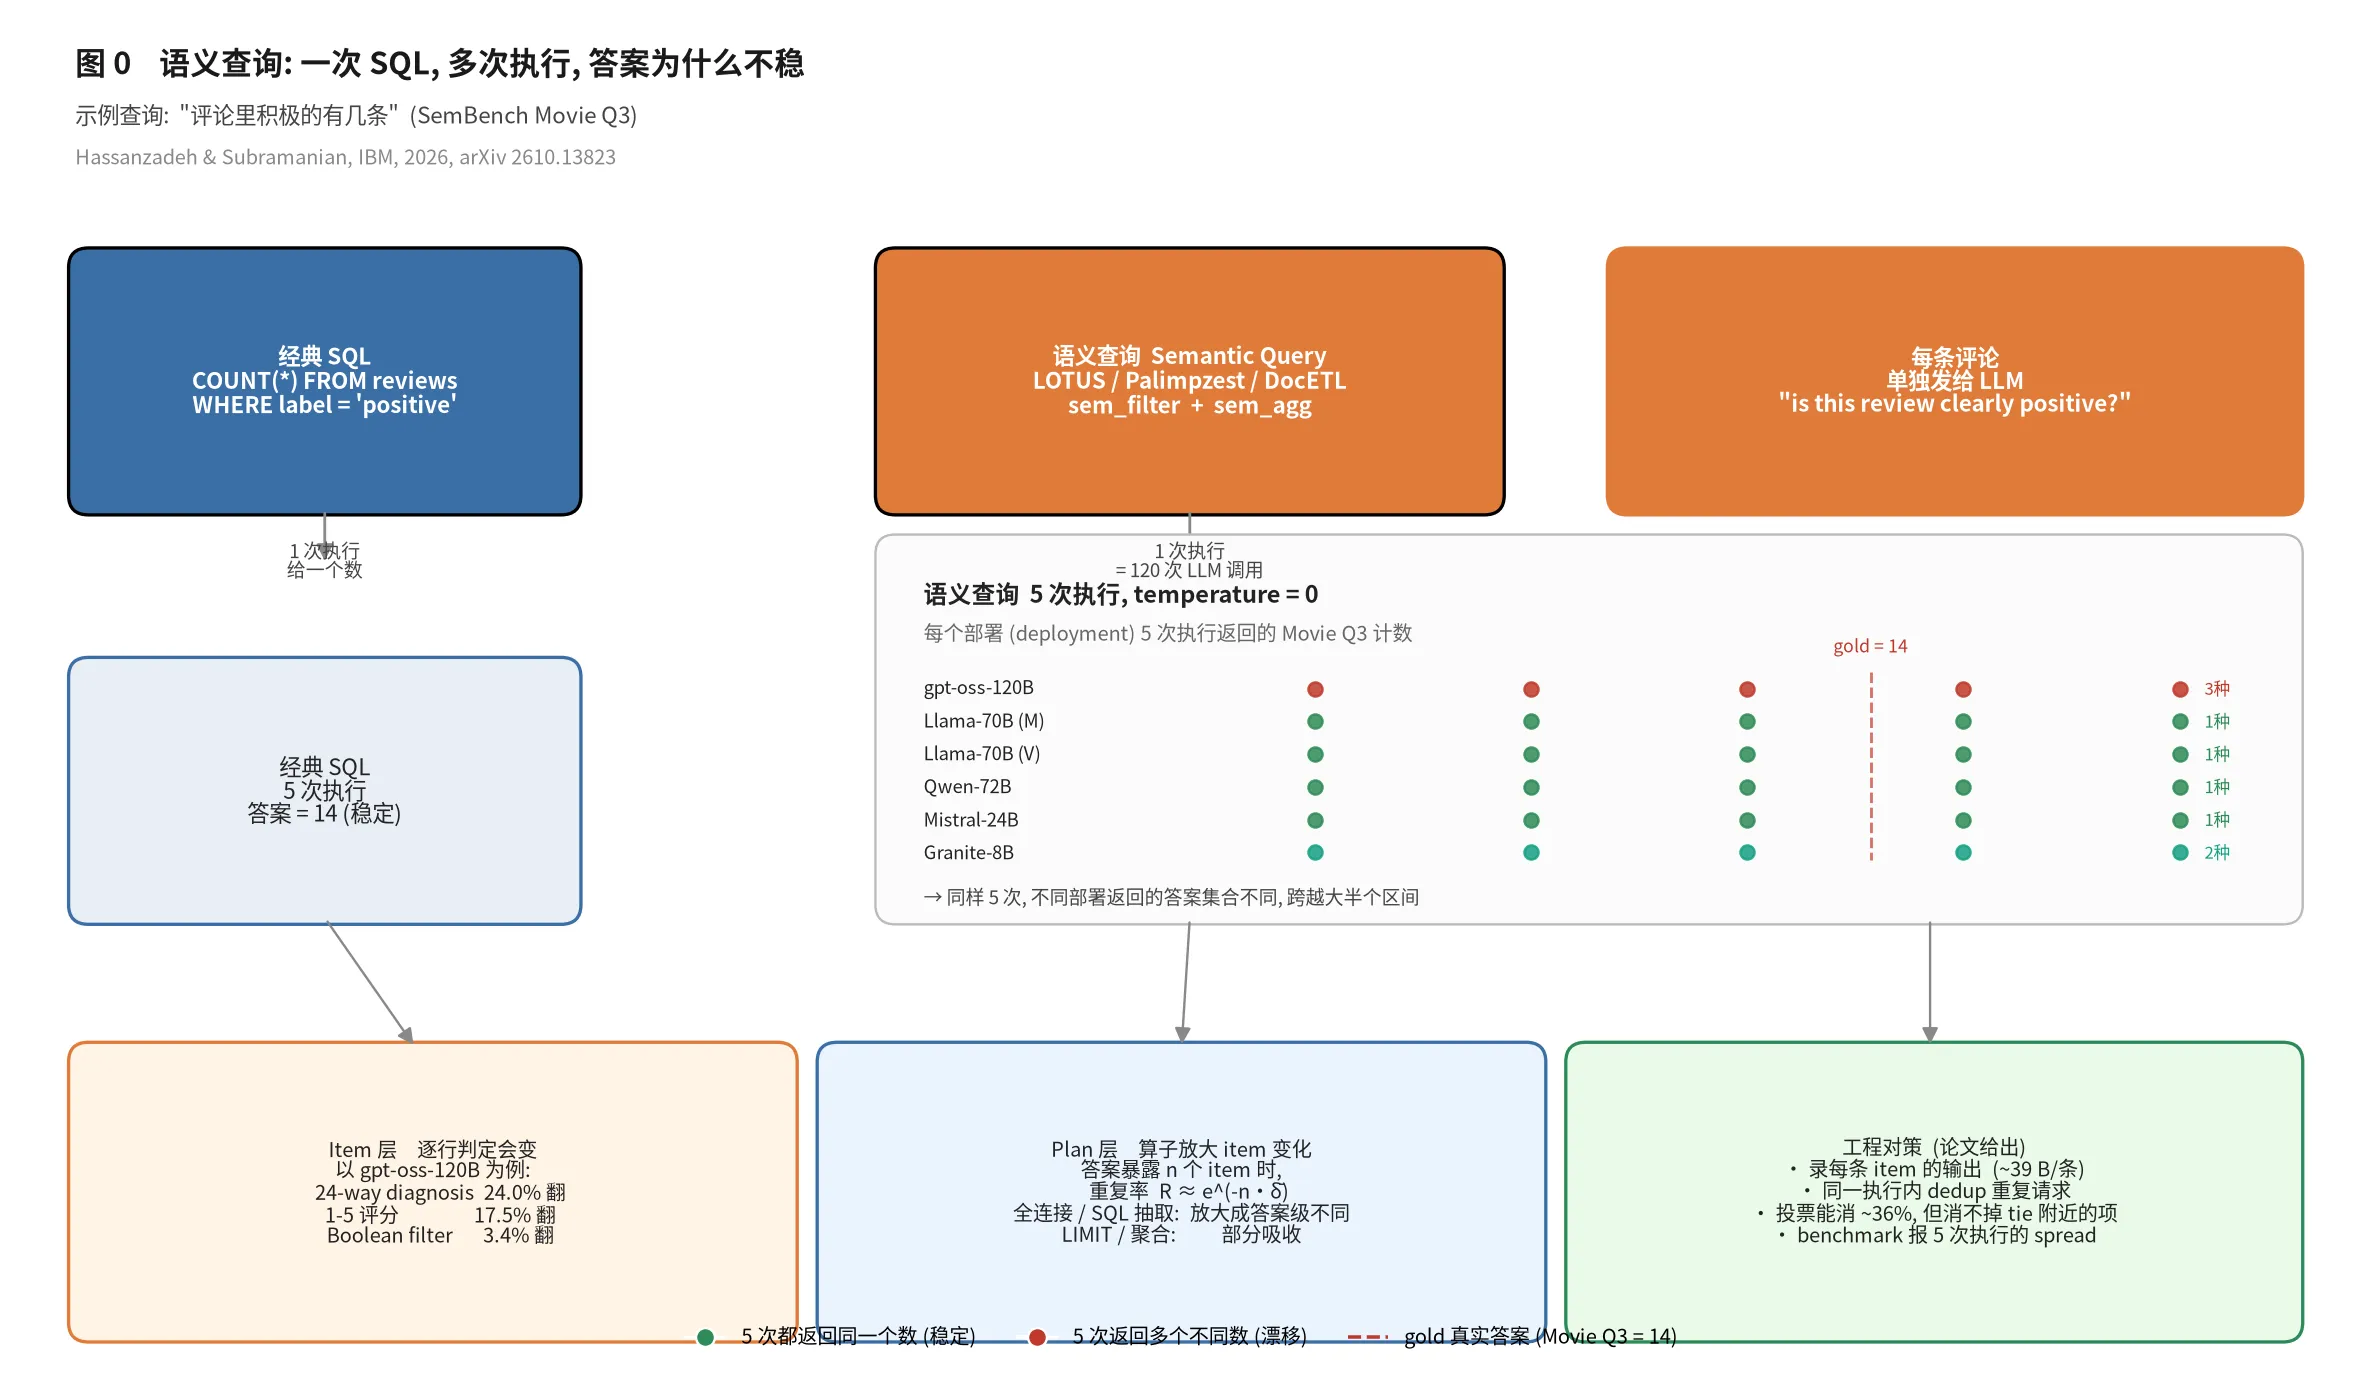
左边那条是经典 SQL,5 次执行都给 14;右边那一列是不同 deployment 在 temperature 0 下对同一句 SemBench Movie Q3(“评论里积极的有几条”)的 5 个答案。gpt-oss-120B 跨越大半个区间,Granite-8B 偏到另一头,Llama 和 Qwen / Mistral 紧贴一端。gold = 14。同样的查询,同样的 temperature,5 个不同的答案集。这张图本身就是论文的摘要。
2. 流水线:不改一行 prompt,只把 harness 包一层记录#
论文配套的 artifact 在 github.com/semviews/sqp-variance-study ↗,133MB 的 tarball 解开后 5 万个文件,核心是 scripts/ 下 52 个 Python 脚本和 experiments/raw/ 890MB 的逐次执行原始日志。读 docs/ARCHITECTURE.md 就明白整个工程思路:
benchmark harness (SemBench / LRO-Bench / UDA-Bench, unmodified)
        │  wrapped by a driver in scripts/ that logs each call
        ▼
experiments/raw/<suite>/<deployment>/<setting>/repeat-<r>/     one dir per execution
        │  analyze_*.py, score_*.py
        ▼
experiments/processed/                                          items.csv, queries.csv, *.json
        │  report_*.py, plot_*.py, and the analyses with a "macros" map
        ▼
outputs/tables/*.tex, outputs/figures/*.pdf, outputs/tables/macros.tex
        │  scripts/compare_reference.py
        ▼
reference/tables/ (the tables and macros as submitted)两条设计原则值得拎出来:
第一,faithful to the benchmark。prompt、query plan、output parser、evaluator 全是 benchmark 自己的,作者一行不改,只是把 model client 包一层 hook,把每一行调用记下来。scripts/sembench_repeats.py 把 LOTUS 的 _process_uncached_messages 替换成 wrapper,记录请求 hash、prompt excerpt、开始时间、输出、reasoning text、token 数、system fingerprint、可选的前 4 个 token + top-5 log-probabilities。LRO-Bench / UDA-Bench 走同样套路,只是 hook 的位置不同。
第二,failure ≠ answer。任何一次执行只要有一个调用失败,整次执行记成 failure,重试最多 3 次,3 次都失败就放弃。这个设计避免”重试到成功”悄悄掩盖不稳定性。
8 个 deployment(Llama-3.3-70B 在 managed service 和 vLLM 各算一个)跨三个 benchmark 跑了 1,219,338 次模型调用。主实验 2026-10-02 / 03 跑完,商业模型和温度对照实验 2026-10-09 补。
3. 一个 possible-worlds 模型,3 条公式#
读论文读到 §3 的时候,我的笔记里写了一行:“漂亮”。他们把语义算子的”输出分布”映射到概率数据库里的 tuple-independent 关系,然后给每个 plan operator 推一个 answer reproduction R 的闭式或可模拟公式。表 1 把 5 类算子压成五行:
| 算子 | 决定答案的 items | 公式 | SemBench 上预测 vs 实测的命中率 (within 0.15) |
|---|---|---|---|
| Map / set / join (全输出) | 全部 n 个 item | 闭式 R ≈ e^(-n·δ̄) | 23 / 24 |
| LIMIT k | 前 k 个匹配的位置 | 仿真 | 22 / 24 |
| COUNT / ratio | 计数分布 | 仿真 | 18 / 18 |
| AVG | 均值分布 | 仿真 | 6 / 6 |
| 按组均值的排序 | tie 附近的几组 | 仿真 | 6 / 6 |
| SQL over extractions | SQL 读到的所有 value | 闭式 R ≈ e^(-x) | 202 / 369 |
这套模型的关键洞察是:item 变化独立的话,答案的”重复率”按 item 数量指数衰减。δ̄ = 0.1%、n = 1,560 对,重复率就只有 0.21。这不是 LLM 的错,这是组合数学的必然。
UDA-Bench(LLM 抽取字段 + SQL 查询)那 369 个 case 里,202 个落在预测的 0.15 误差带内,差的那部分大多是 FILTER / AGG 把变化”吸收”掉了一部分——这是好事,也是 bad news:论文 §3.1 明确说,“the share of items whose output is not identical in k executions” 1 − Σᵢ Σₒ pᵢ(o)ᵏ 随 k 增长,只跑 5 次根本不知道真实的 item 变化率。gpt-oss-120B 的 Boolean 翻动 5 次 3.4%,但 2 次只有 ~1.5%,10 次能到 30%(见 §6 的图 4 左)。
4. Finding F1:公开 benchmark 的结果在重复执行之间也会变#
论文 §5 拿 SemBench 自己公开的 5 次执行(Gemini 2.5 Flash,LOTUS / Palimpzest / ThalamusDB / BigQuery 四套引擎)重新分析。“一个 system × 一个 query” 算一个 cell,文本查询共 101 个 cell。
| System | Cells | 5 次中至少一次质量不同的占比 | 范围 ≥ 0.1 | 最大范围 |
|---|---|---|---|---|
| LOTUS | 49 | 24% | 6% | 0.41 |
| Palimpzest | 64 | 16% | 5% | 0.30 |
| ThalamusDB | 47 | 19% | 9% | 0.97 |
| BigQuery | 64 | 27% | 8% | 1.00 |
| 文本合计 | 101 | 21% | 5% | 0.44 |
| 全部合计 | 224 | 21% | 7% | 1.00 |
21% 的 cell 在 5 次执行之间质量值不同——而且 BigQuery 的计划是确定的,LOTUS 出 join 外也确定。即便你”挑一个 deterministic plan”,重复执行也会给不同答案。
更扎心的是论文 §5 的图 2 右:5 次执行,不够。他们对 7 对”在 SemBench 文本查询上均值不同的系统”做 95% 区间分析,有的要 9 次,有的要超过 10 次,才能把系统差异和重复执行漂移分开。换句话说,SemBench 这种”5 次取均值”的报告方式,在某些 query 上其实没有 settle 真正的”哪个系统更好”。
但也有好消息:scenario-level 的排序是稳的。把所有 query 平均之后,4 个系统里 6 个 scenario 的冠军永远是同一个,29 个 single-execution 里有 26 个给出了跟均值一致的完整排序。结论:per-query 报告要看 spread,但 scenario 排名可以信。
5. Finding F2:item 层翻动 0.07% ~ 24%,看模型也看任务#
论文 §6 在 SemBench 自己 harness 下跑了 10 个 filter / map 查询、6 个 open-weight deployment + 2 个商业模型。下面这张论文原图把”按输出类型分组的 item flip rate” 摆出来,跨 4 个数量级:
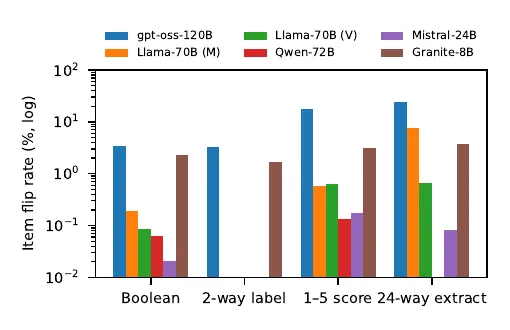
几个关键数字:
- Mistral-24B 的 Boolean filter 翻动率 0.07%,整个 SemBench 上最低
- gpt-oss-120B 的 24-way 疾病诊断翻动率 24.0%——5 次执行,每 4 个就有一个被改成另一个病
- 1-5 评分普遍比 Boolean filter 翻得厉害(Granite-8B:1.7% vs 0.7%)
- 商业模型 GPT-4o 在 1-5 评分上翻动 9.0%,跟开源 reasoning 模型一个量级
- 模型大小不是决定因素:Mistral-24B 比 Llama-70B 翻得还少
论文 §6 给出一个 “variance is a property of the call, not the execution” 的强证据:SemBench 输入里 533 行是重复行,LOTUS 把它们当成独立请求发出去。在 gpt-oss-120B 上,同一行在同一次执行里就给出不同输出的概率 6.0%,跨执行给的概率 6.1%——两个完全一样。所以”variance 不是 execution 持有的状态泄露出来的”。
Granite-8B 的重复行 1.1% / 1.3%,也是同一个量级。variance 在调用层,不在会话层。
6. Finding F3:plan 算子把 item 翻动指数级放大成答案翻动#
论文 §7 是工程上最值得抄的一段。Movie Q3 在 gpt-oss-120B 上 5 次返回的数(论文 Figure 1):
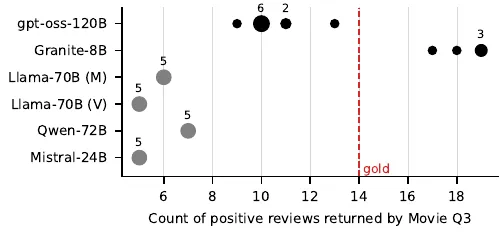
- gpt-oss-120B 给了 4 个不同的数 (10, 12, 11, 9),gold = 14
- Llama-70B (M) 每次都给 6,但 quality 0.43
- Llama-70B (V) 每次都给 5,quality 0.36——同一个模型,两个部署,稳定地返回两个不同的”稳定”答案
- Qwen-72B / Mistral-24B 也都稳定,但都在 5
- Granite-8B 给了 18 或 19(2 种),稳定地错
论文 §3 的 possible-worlds 模型预测:答案暴露的 item 越多,answer reproduction 越低。下面这张图是论文 Figure 4 的左 + 右拼起来,左是 gpt-oss-120B item 翻动随 execution 数的增长(还没收敛),右是 R 随 exposure x = Σδᵢ 的下降(符合 e^(-x)):
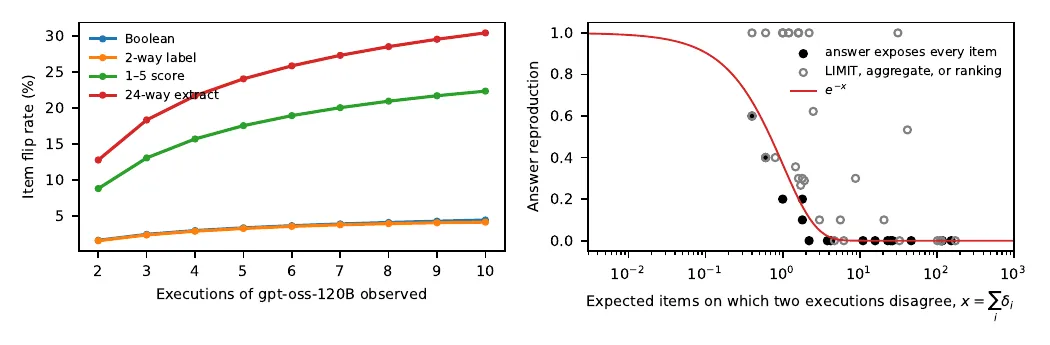
UDA-Bench 把这个放大效应演示到了极致:抽取阶段只翻 4-7% 的 value(已经是 item 层),但 SQL 阶段读这些 value 之后,123 个 query 里 67% 的最终答案会在不同执行之间不同。这是论文表 9 的数字。
LRO-Bench 那 28 条实现建议里有 16 条在它的 5 次执行下不能定论(论文表 10)。比如 “filter, rows: ONE > ALL” 95% 区间包含 0;“match, rows: SEMI ≥ ALL” 也是 0。在 6 条测试上,单次执行会颠倒推荐——你跑一次得到 A 比 B 好,跑一次又得到 B 比 A 好。
总结成一句话:item 翻动 1% × 全连接 / SQL 抽取 = 答案翻动过半。这是论文最反直觉、也最该被认真消化的发现。
7. Finding F4:变化不是均匀噪声,会聚在 tie 附近#
论文 §8 有一组特别漂亮的数据。Granite-8B / Llama-70B (V) 三个 deployment 返回 top-token 的 log-probabilities,作者能拿到”第一次决定答案那个 token 的两个最高概率的差”——即 decision margin(决策裕度)。他们做了两件事:
- 用 noise model 拟合:
λ + (1-λ) Φ(-m/σ),得到 Granite-8B 的 σ = 0.28 nats,Llama-70B (V) 的 σ = 0.37 nats - 把每个 item 按它”在第一次执行里被另一个 deployment 反对的数量”分组,看翻动率
下面这张图是论文 Figure 6 的左 + 右拼:
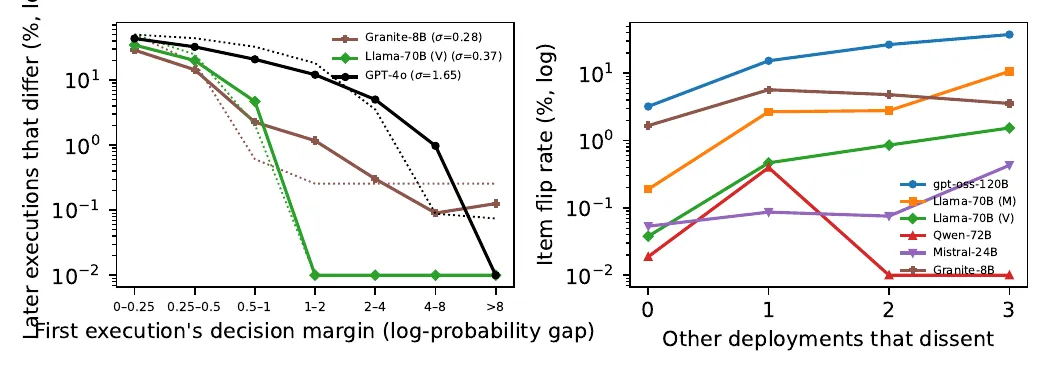
两条结论都很关键:
- AUC 0.93-1.00——单次执行的 decision margin 几乎能完美预测这个 item 在后续执行里会不会变。模型在”接近 tie”的 item 上才犹豫,犹豫的才会翻。
- tie 附近的 item,正是”其他模型也不同意”的 item。Granite-8B 在”所有其他 deployment 都同意”的 item 上翻 1.5%,在”3 个 deployment 反对”的 item 上翻 3.7%。
论文 §8 还有一个非常 striking 的对照:把 6 个 deployment 在 Movie Q3 / Q1 的 80 个 item(40 个变化、40 个不变)各发 20 次,温度 0 下翻动 2.5%,温度 1 下翻动 7.5%。在会变的那些 item 上,温度 0 给 12.1%,温度 1 给 41.1%。温度 0 不是没用,它把 41.1% 降到 12.1%,但距离 0% 还远。
至于 deployment 本身的差异:同一个 Llama-3.3-70B,managed 部署上稳定, vLLM 部署上也稳定,但 Movie Q3 上前者给 6,后者给 5。模型权重一样,prompt 一样,但两个栈 deterministically different。这是这一节里最让我沉默的一行。
8. Finding F5:投票能消一点,级联保函不保答案#
论文 §9 把 10 次 gpt-oss-120B 的执行结果在没新调用的前提下重放,做 vote of 3 / vote of 5。表 12 的核心数字:
- 投票 3 (前 2 次不一致时再调 1 次) 平均消除 36% 的 pairwise disagreement,平均每次调用 2.02 ~ 2.13 次
- 投票 5 消除 48%,但有 10 次执行的配对数天花板
- 在 Movie Q9 (1-5 评分)上,投票 5 之后仍有 5.5% 翻动——5.5% 不是噪声,是 tie 附近就是有这么多
- 没有任何一个 aggregate / ranking / Medical 答案在投票之后变得完全稳定——投票的输出分布解释了原因:48% 的变化 item,10 次里”少数派”出现 ≥ 3 次,所以 3 票根本定不下来
论文 §9 还有一个很优雅的实验:selective voting——只对 reasoning 长度最长的 20% item 投票,因为长度预测变化(论文 §8 已经证明)。结果:用 1.4 倍调用成本就拿到 64% 的消减,30% 上拿到 80%。re-asking 不需要 3 次,挑对 item 1 次就够。
Cascade 部分最有意思:统计保证能撑住,具体哪些行能撑住撑不住。Granite-8B 当 proxy、gpt-oss-120B 当 oracle,90% recall + 95% confidence 的 cascade 在 Medical Q1 上,calibration 时的 oracle 执行 vs 另一个 oracle 执行:返回的行 76% 不一样。但 violation 率从 1.0% 涨到 2.2%,没破 5% 的界——cascade 的统计保函活下来了,只是它”返回哪些行”完全是 calibration 时那次执行的快照。
9. 三个层面的可复现性:operator output / answer / quality#
论文 §7.5 给出整张 study 最值得抄的图表,也是工程上最该记住的:
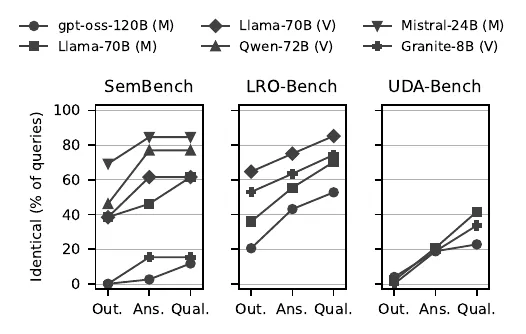
按 deployment 平均:
- operator output 全部一致:SemBench 32%, LRO-Bench 44%, UDA-Bench 2%
- final answer 全部一致:SemBench 48%, LRO-Bench 59%, UDA-Bench 19%
- quality 全部一致:SemBench 52%, LRO-Bench 71%, UDA-Bench 33%
每一层都把下一层的变化藏起来。UDA-Bench operator output 只有 2% 一致,但 quality 还有 33% 一致——质量分本身在偷偷吸收波动。而如果你只看 quality,你以为 benchmark 是 reproducible 的。
论文还注意到一个反直觉的细节:Llama-70B (M) 和 (V) 在 operator output 一致率上一样,但 (V) 的 answer 一致率比 (M) 高。同一个模型,不同 deployment,在不同 level 上排名不同。ranking 取决于你在哪一层看。
10. 论文的”7 + 5”条建议#
论文 §10 把结论压成可执行的清单。我把给 benchmark 设计师的 7 条和给引擎开发者的 5 条都列下来,这是全文最实用的部分:
对 benchmark 设计师(7 条):
- 报 per-query 质量 + 几次执行的 spread;按 observed variance 决定每个比较需要几次执行,5 次不够的就多说
- 同时报 answer reproduction,不要只报 quality
- 报 item flip rate at a stated k,或者用不依赖 k 的 pairwise disagreement
- 不要从几次执行里挑最好的;把失败执行也算成结果报出来,别 retry 到成功
- 记录 per-item outputs,这样别人可以 attribute variance、replay 修复,不用重跑
- 报每个 open-weight 模型的 deployment——同模型不同栈结果差太远
- 方法之间的推荐要跨 execution 都成立,单次执行成立的别写
对引擎开发者(5 条):
- 把存下来的 semantic column 当成一个样本,把 decision margin / reasoning length 一起存;同一执行内的重复请求要 dedup,不止跨执行
- 用 item disagreement + plan 形状估算 answer stability;暴露 n 个 item 的答案,重复率 ≈ e^(-n·δ̄),全连接 / per-row 输出需要比 LIMIT 查询低得多的 item 翻动率
- optimizers 在一次 oracle execution 上 calibration,会继承那次执行的 variance——保函可能活下来,但 plan 不会;把 calibration 时的 label 跟 plan 一起存
- 选 operator implementation 看 cost + 对 reply format 的鲁棒性,不要看 stability
- 要复现答案,reuse 录下来的 operator outputs(约 39 B / 条,gpt-oss-120B 跑 10 个 SemBench filter/map 一次执行 348 KB)。投票 3 次成本翻倍,只能消 36%,把重复执行花在 margin / reasoning length 标记的 item 上
第 5 条是论文 §9 的真正杀手锏:“录下来”比”再问一次”更便宜也更准。这个观察跟响应式缓存(response cache)的设计哲学一脉相承,但论文把它推到了”概率性输出”的场景里。
11. 我的几点观察#
读完代码和论文,想说几个不那么直接相关的观察:
“温度 0 等于确定性”是一个被广泛默认的错误假设。Hassanzadeh 和 Subramanian 不是第一个指出 temperature 0 不等于 deterministic 的人,但他们是第一个在”语义查询 = 数据库”这个具体场景里系统量化它的人。variance 不在模型那一层,在服务栈那一层,但模型把它放大成业务答案的差异。这个隔层关系,是数据库研究者要重新捡起来的问题。
possible-worlds 模型跟概率数据库的连接,是论文里最优雅的一段。元组独立 + plan 投影,这套语义在 [10, 11, 21, 23, 51] 那一票 probabilistic database 文献里早就成型。论文 §2 末尾那 6 条引用把这个传承写得很清楚:他们不是发明新理论,是把经典工具搬到 LLM-as-oracle 这个新场景。这比”再来一个新的”更重要——做评测的人不该再假装这个 oracle 是确定的。
论文对工程实践的影响是即时的。如果你用 LOTUS / Palimpzest 之类的引擎做生产:
- 缓存语义输出(不只是缓存 prompt)——一个 39 B 的存盘胜过 3 次 200-token 的重新调用
- 同一 execution 内 dedup——LOTUS 默认开 cache,但 cache key 是 prompt hash 不是 input row hash;533 行重复 → 6% 概率同 execution 给不同答案
- 引擎返回 “all possible answers” 而不是 “one answer”——论文 §9 试了 certain / possible 区间,结果不理想,但方向对:让上游决策,不要让 optimizer 替你做
对 benchmark 设计的影响也很大。我自己写 LLM 评测,经常偷懒”5 次取均值就完事”。论文告诉我:5 次取均值,在很多 query 上,根本不是 settle “A 比 B 好”。写 benchmark 报告,要报 spread 不只报 mean——这一条对所有用 LLM-as-judge / LLM-as-labeler 的研究都适用。
威胁与可推广性(论文 §11):他们没跑 Gemini 2.5 Flash 这一档最新的 reasoning 模型(因为这些 API 拒收 temperature = 0),所以”reasoning 模型的 variance”这一支没彻底覆盖;deployment effect 只有一个模型在两个 stack 上(only pair available to us),不能外推到所有模型 × 所有栈。所有数字,要在自己 workload 上重测才能拿来用。
12. 一句话总结#
对一个 LLM 算子来说,“reproducibility”不是”同样的输入给同样的输出”这么简单的承诺。它至少有 3 层(operator / answer / quality),每一层都把下一层藏起来;答案的稳定性由 plan 形状指数级放大,不是 item 翻动本身;而”录下来” 比”再问一次” 几乎总是更便宜也更准。
如果你正在做语义查询,先问自己一句:我的答案是 reproducible 的吗?答不上来,把它录下来。
论文信息
- arXiv: 2610.13823 ↗ [cs.DB]
- 标题: Same Query, Different Answer: Run-to-Run Variance in Semantic Query Processing
- 作者: Oktie Hassanzadeh, Dharmashankar Subramanian
- 单位: IBM Research, Yorktown Heights
- 提交: 2026-10-09 (v1)
- 主题: Databases (cs.DB); Artificial Intelligence (cs.AI)
- 代码与原始日志: github.com/semviews/sqp-variance-study ↗
- 引用:
Hassanzadeh, O. and Subramanian, D. (2026). Same Query, Different Answer. arXiv:2610.13823