TempoTrace 精读:时钟同步,是 AI 集群可观测性的隐形支柱
💬 评论arXiv 2609.23301。NTP 在 GPU 集群下会让 25 - 30% 的因果边反向,TempoTrace 用 PTP + GPUDirect + SVC + Hybrid SVD + Policy 五件套把这件事彻底讲明白。
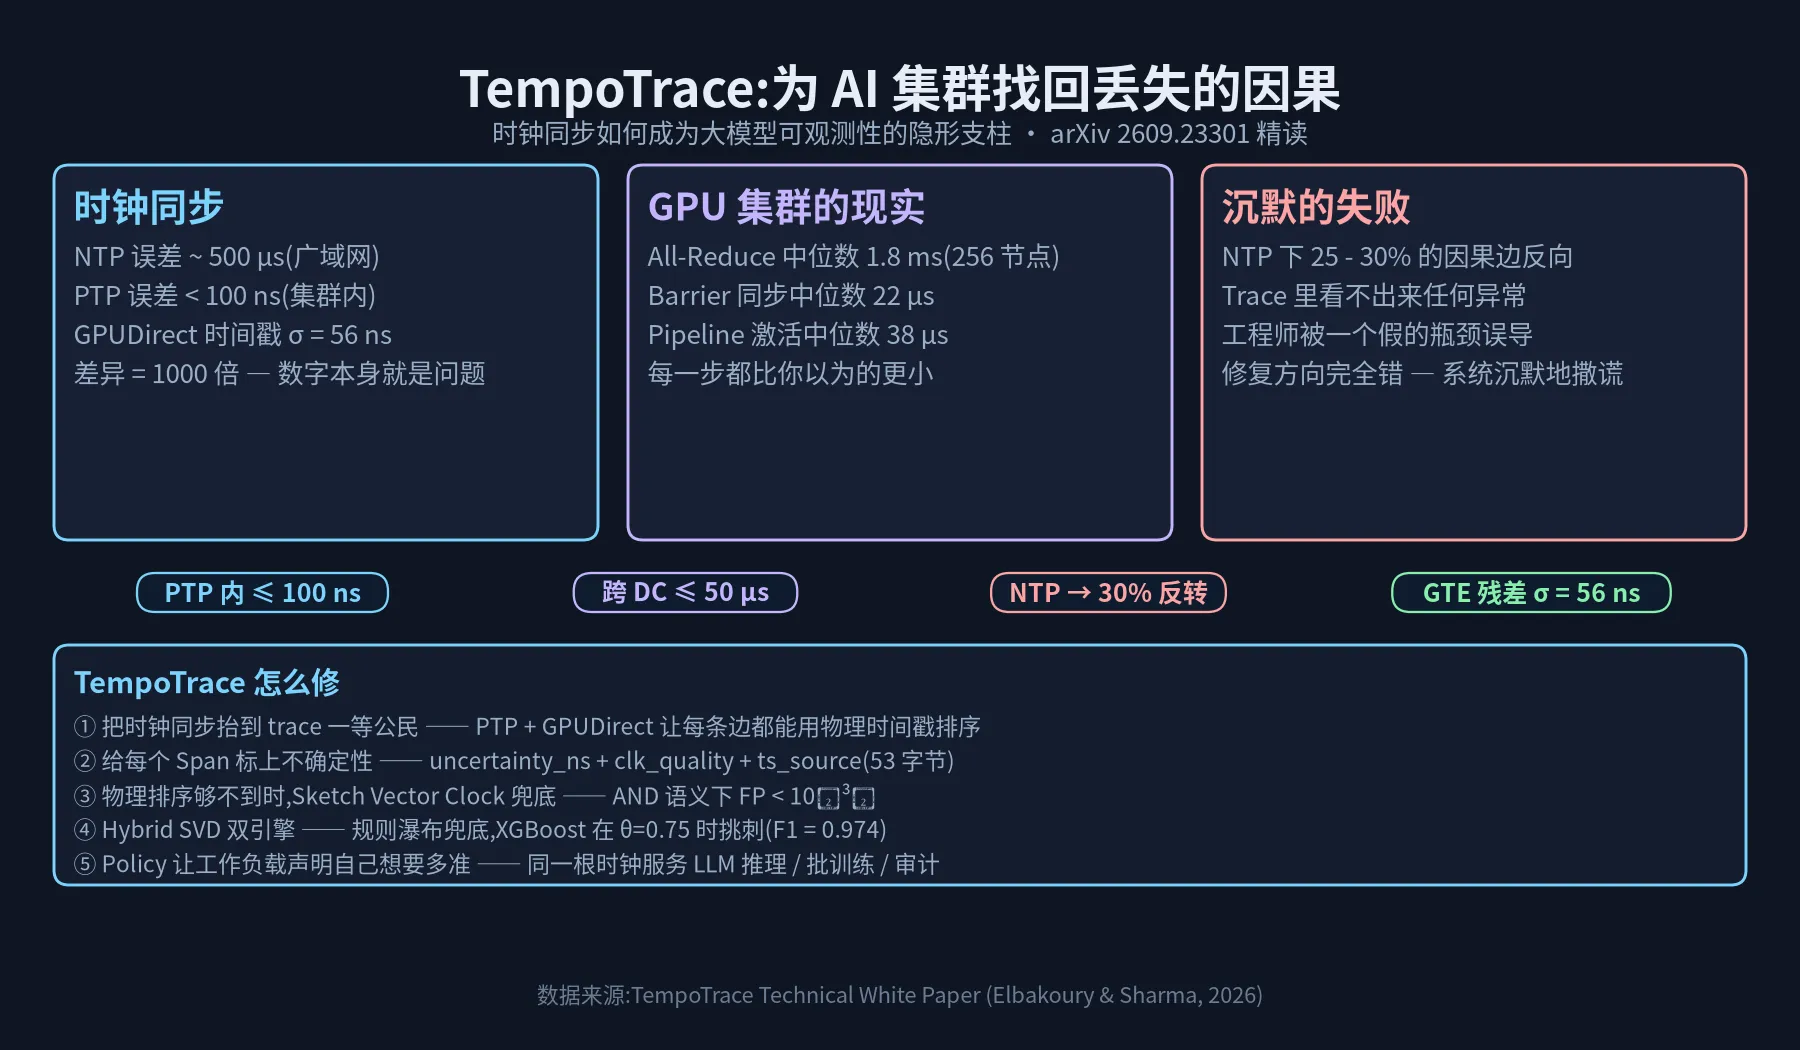
如果你正在调试一个训练任务,trace 里明明写着”GPU 0 在 14:23:01.182 完成 all-reduce,GPU 1 在 14:23:01.179 才发出来”,你大概会下意识地相信这个顺序 —— 然后去查 GPU 1 的网络。
但如果我告诉你,在万卡 GPU 集群里,这种顺序可能就是错的,而且 trace 不会给你任何告警,你信不信?
这就是 TempoTrace 这篇白皮书想正面回答的核心问题:大模型基础设施里的”分布式追踪”,到底架在一个多么脆弱的时间基础上。
这篇文章是 arXiv 2609.23301 的精读笔记。我会按下面的顺序展开:
- 第一部分先讲为什么时钟这件事这么要命 —— NTP 在 GPU 集群里的真实表现
- 第二节把 TempoTrace 的四层架构铺开看,理解它怎么系统性地补每一块缺口
- 第三节挑三个最有意思的组件拆:GTE、MRSH、Hybrid SVD
- 第四节是Application Confidence Policy —— 同一根时钟怎么服务三类迥异的工作负载
- 最后讲讲它的局限,以及这件事对我们做工程的人意味着什么
文章较长,大约 25 分钟读完。建议先在心里装一个具体的工作负载:一个 2,048 GPU 的训练 step,里面跑了 256 节点的 ring all-reduce,中间有一次 barrier。带着场景读,效果更好。
一、当 trace 在对你撒谎#
1.1 从一个故事开始#
我们先假想一个事故现场:
工程师小张在排查一个 2,048 GPU 的训练 step。他打开了 trace 后端,看到一条 causal edge:Node A 在 t = 1000 µs 给 Node B 发了一条消息,这条消息走了 50 µs 才到 B。
但 trace 后端显示,Node B 收到的这条消息,它的时间戳是 t = 800 µs —— 比发送者还要早 200 µs。
小张看了一眼就断定:B 是发送者,A 是接收者。于是他去排查 B 的网络。
但事实上这件事从未发生。因为在物理世界里,A 真的在 1000 µs 发出了消息,B 真的在 1050 µs 才收到。
为什么会倒过来? 因为 B 的时钟比真实时间慢了 250 µs。两台机器各自用 NTP 同步自己的钟,但 NTP 的精度大概在 500 微秒量级。两个 500 µs 误差相遇,250 µs 的反向就出现了。
而 trace 工具拿到的就是 800 和 1000 这两个整数 —— 它没有任何方式知道哪个是对的、哪个是错的。
这就是 TempoTrace 在白皮书 §2.6.1 里描述的”沉默失败”(silent failure)。
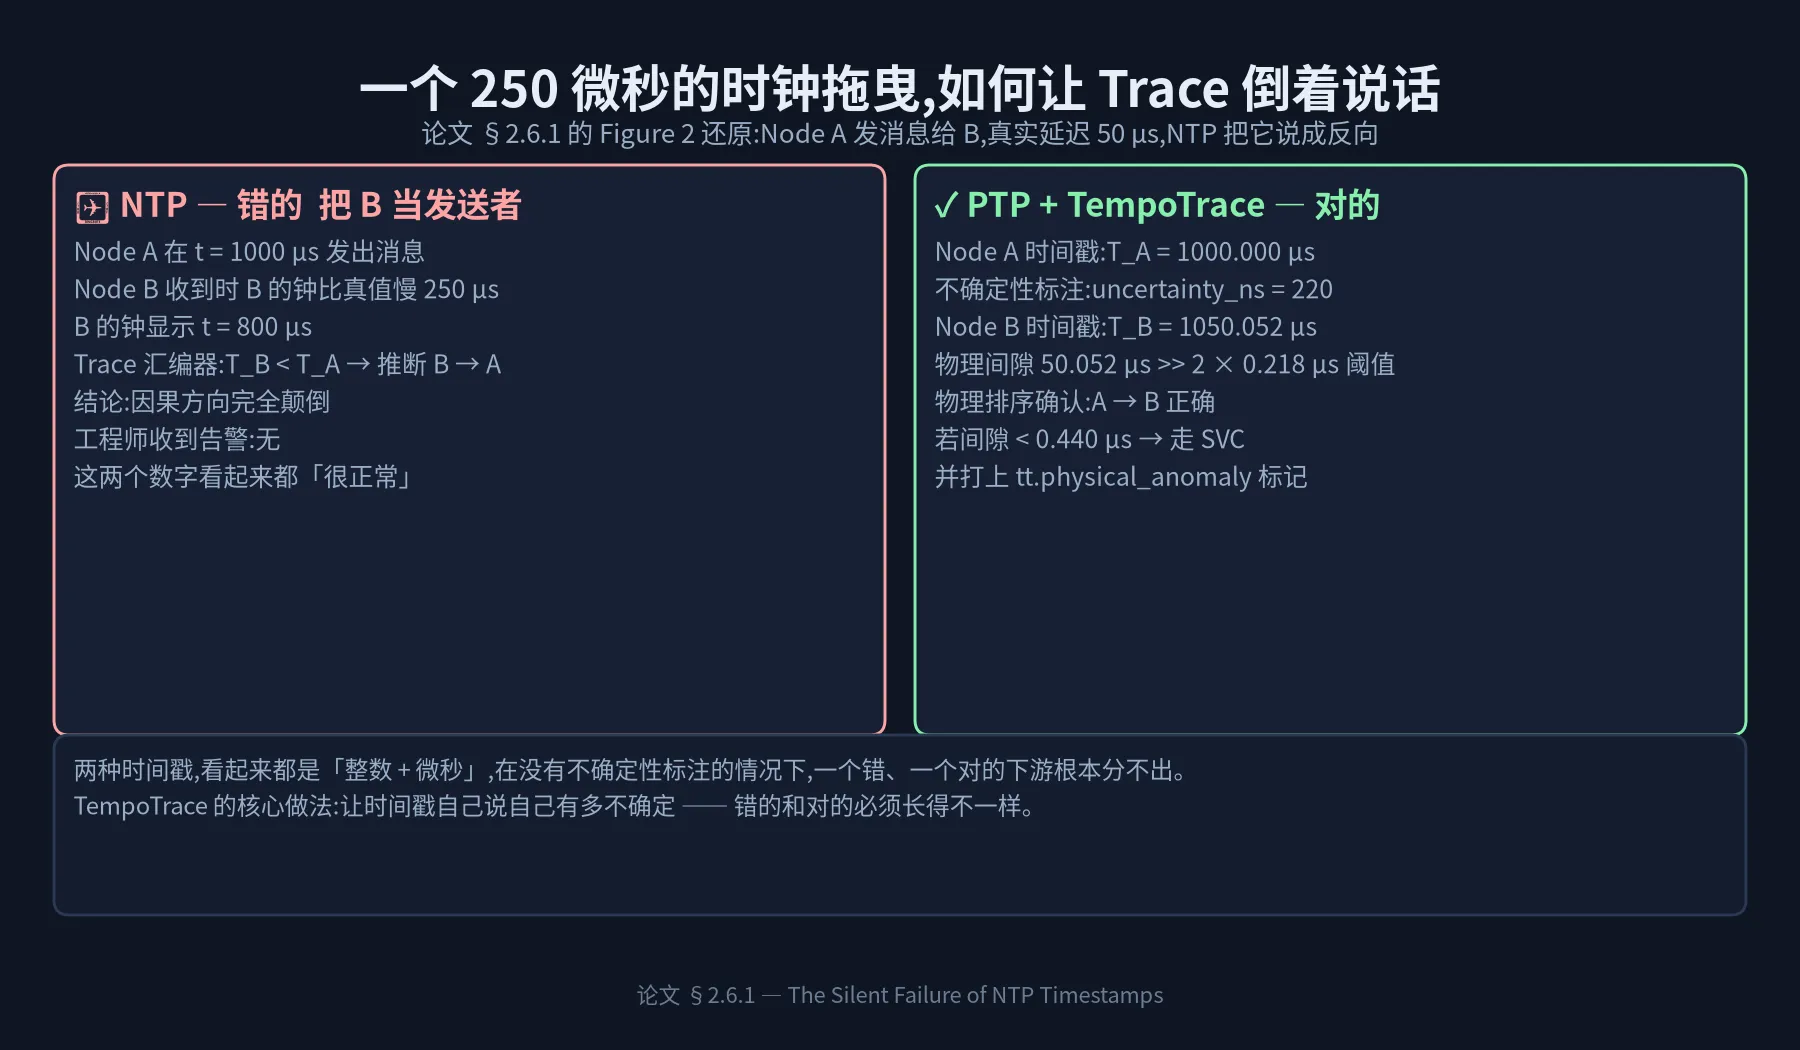
左边是 NTP 下的故事,因果被颠倒,系统沉默;右边是 PTP + TempoTrace 的故事,因果正确,而且每个时间戳都明确告诉你”我有多不确定”。
1.2 把这件事量化:反向到底多严重?#
“沉默失败”听起来吓人,但到底有多严重?白皮书用一整套形式化分析回答了这个问题(§3.2)。
核心思路很朴素:两台机器的时间戳之差服从一个随机变量 δ_ij = δ_i − δ_j。当真实传播延迟是 L,如果 |δ_ij| > L,那么物理顺序就看不出来了 —— 工具会得出相反的结论。
NTP 的 per-node 标准差 σ 大约是 500 µs(广域网/云),两台机器半方差叠加,成对标准差 σ_pair = σ√2 ≈ 707 µs。在这个假设下:
- 6 µs 的 Barrier 操作:49.7% 的有向因果对被颠倒
- 38 µs 的 Pipeline 激活:47.9% 反向
- 145 µs 的 All-to-All(MoE):37.4% 反向
- 1.82 ms 的 All-Reduce:1.3% 反向
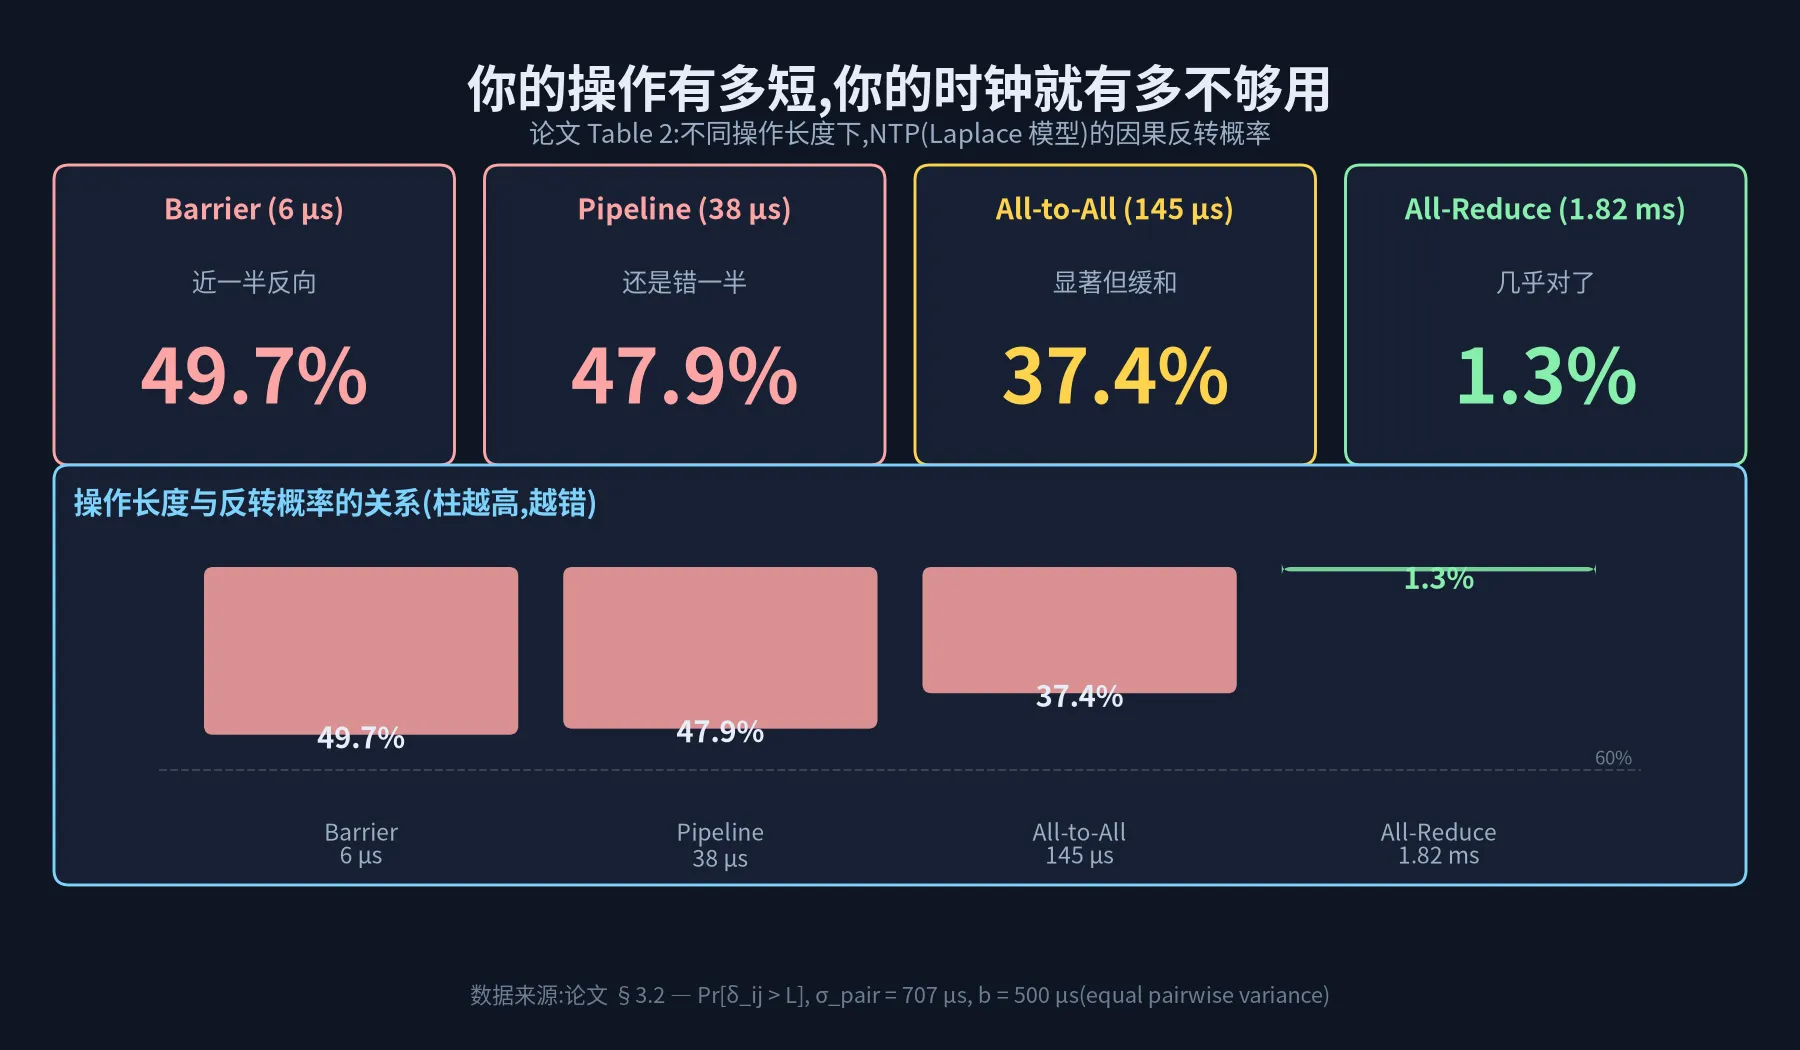
这是论文 Table 2 的内容。你注意看:操作越短,时钟越不够用。而现代 GPU 集群里,Barrier、Pipeline 激活、kernel 启动这种”快操作”恰恰是优化重点 —— 也是最容易被错误归因的。
论文还特别用了 Laplace 重尾模型而不是 Gaussian 来模拟网络拥塞下的误差分布,因为 GPU 集群在拥塞期的时钟误差尾巴比 Gaussian 假设的重很多。结果:Laplace 模型下期望反转率 27.76%,Gaussian 模型 29.37%,差不多,论文作者的结论是**“结论对尾巴形状不敏感,这是个好消息”**
1.3 一个让你立刻能感受的实验#
白皮书里还报告了一个 5 节点实测实验(Exp 2.1):用 100,000 次探针,直接测 NTP 下两节点的事件反向率。
实测结果:44.978%。
这跟理论估计(广域网场景 25 - 30%)偏多 —— 因为是 5 节点同一机柜内 + 高负载条件,实际时钟抖动比 σ = 500 µs 还要糟。这不是模型在讲童话,这是真实发生的。
1.4 整个行业都在用 NTP 同步的 trace#
读到这里你可能会问:既然这么严重,为什么大家还在用 NTP?
答案是因为大家一直用的是毫秒级精度的 trace:微服务调用、数据库查询、HTTP 请求 —— 这些都是几十毫秒到几秒的操作,NTP 的 500 µs 误差相对操作长度太小,可以忽略。
但大模型基础设施把这件事的尺度压到了几微秒。论文 Table 1 里的数据可以感受一下:
| 操作 | 中位延迟 |
|---|---|
| All-reduce(256 节点,2 GB) | 1,820 µs |
| Pipeline activation(P2P) | 38 µs |
| All-to-all(MoE, 64 节点) | 145 µs |
| Barrier synchronization | 22 µs |
| GPU kernel(transformer layer) | 62 µs |
| Inference decode(128 batch) | 720 µs |
也就是说,很多操作的延迟跟 NTP 的不确定性在同一量级。这时候 trace 不再是辅助工具,它要么给你正确的因果图,要么给你一张倒着的图 —— 没有中间地带。
二、TempoTrace 的整体思路:让时间戳自己说自己有多不确定#
2.1 一个核心洞见#
如果一个时间戳只告诉你”现在几点”,它就是不可信的。
一个温度传感器会告诉你”98.6°F ± 0.2°F”,一个 GPS 接收器会告诉你”位置 ± 3 米”。任何有用的测量都需要附带不确定性。但 NTP 给你的就是一个赤裸的整数。
TempoTrace 的核心做法,就是给每一个时间戳附加三个字段(白皮书 §2.6.4):
- uncertainty_ns:这个时间戳误差的 3σ 上界(纳秒)
- clk_quality:OK / DEGRADED / UNKNOWN 三档质量
- ts_source:GTE / SW_GCC / CPU 哪个时钟源
这样下游的工具拿到一个时间戳,它就知道:“这个时间戳说它自己对到 ±220 ns,质量是 OK,我可以信它的物理排序”。或者:“这个时间戳说它自己误差 ±15 µs(grandmaster failover 期间),我不能直接相信它的物理顺序,需要走 SVC 兜底”。
错的和对的必须长得不一样。这是整个 TempoTrace 的设计基线。
2.2 四层架构#
为了把这套”不确定性标注”贯彻到底,TempoTrace 加在现有 trace 系统上的不是单个点,而是四层结构(白皮书 §4.1):
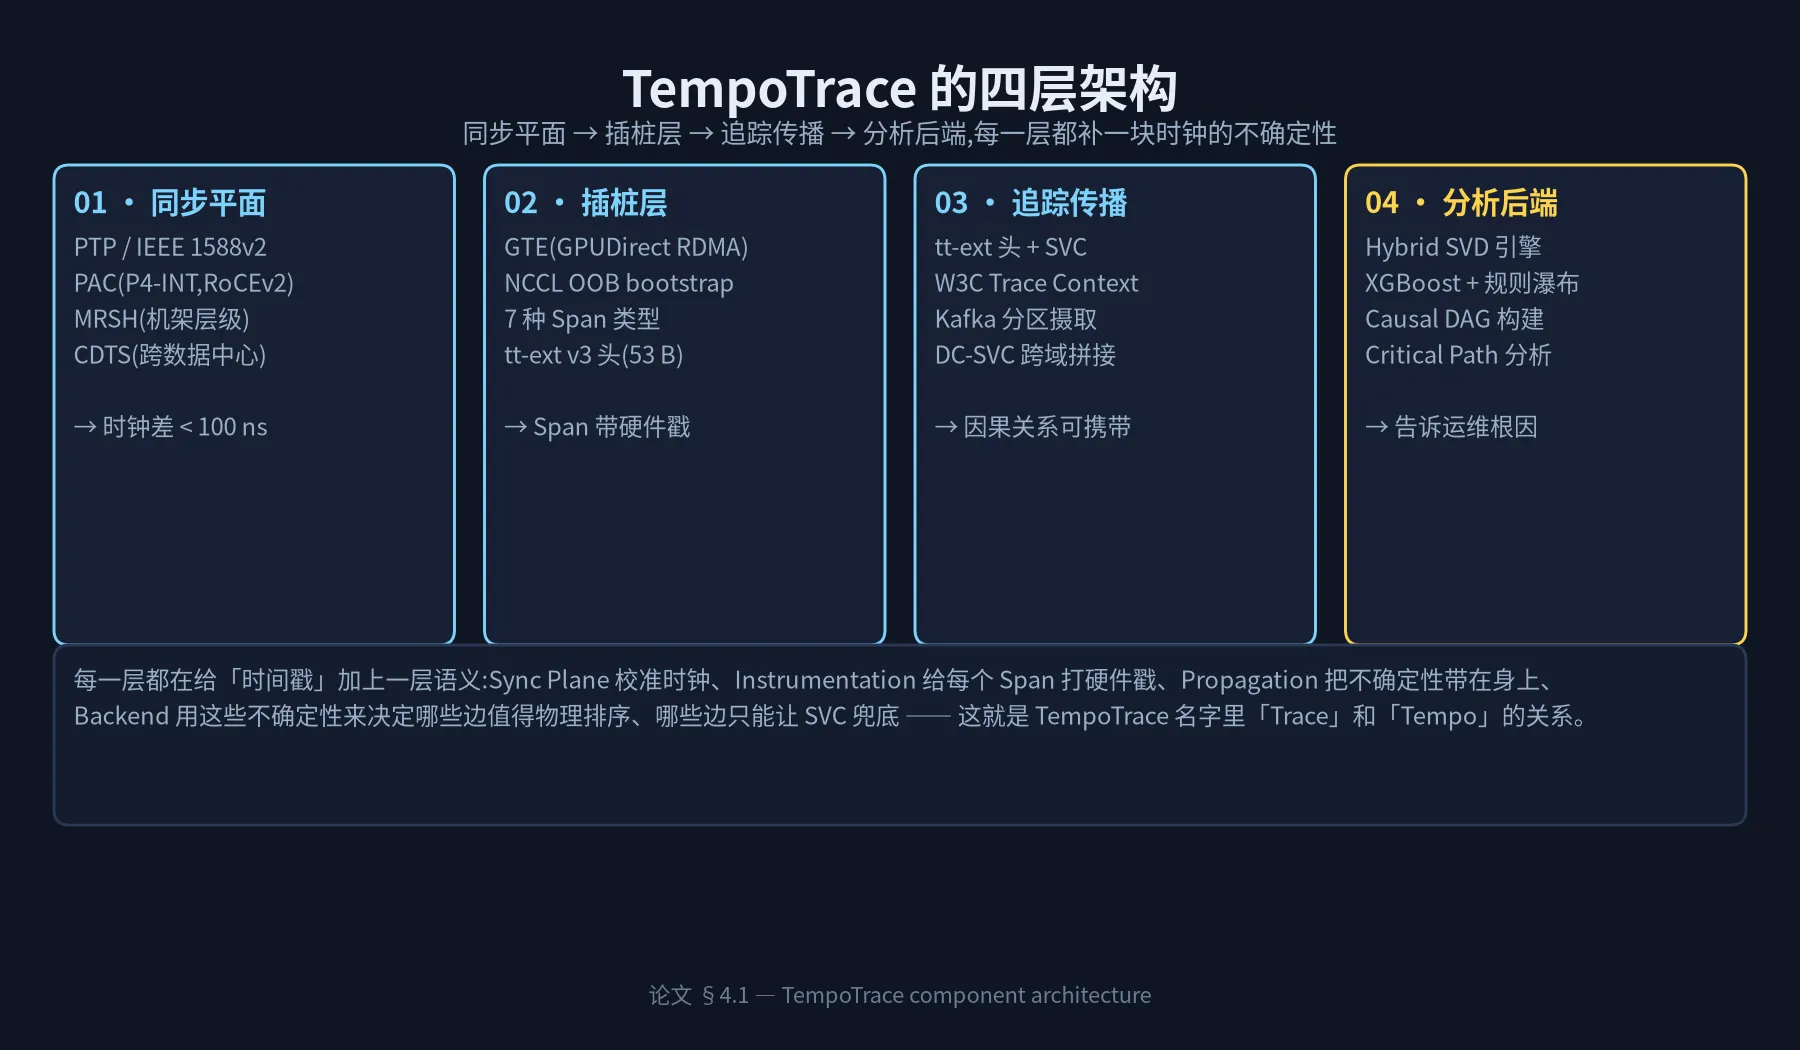
| 层 | 职责 | 关键组件 |
|---|---|---|
| Sync Plane(同步平面) | 校准所有节点时钟,让每对节点的物理时间差尽可能小 | PTP/IEEE 1588v2 + PAC(P4-INT) + MRSH(机架层级) + CDTS(跨数据中心) |
| Instrumentation(插桩层) | 给每一种工作负载事件打上硬件时间戳 | GTE(GPUDirect RDMA) + NCCL OOB bootstrap + 7 种 Span 类型 + tt-ext v3 头 |
| Trace Propagation(追踪传播) | 把不确定性带在身上穿过集群 | tt-ext 头 + SVC + W3C Trace Context + Kafka 分区摄取 + DC-SVC 跨域拼接 |
| Analysis Backend(分析后端) | 用不确定性决定每条边怎么排序、每个故障怎么归因 | Hybrid SVD 引擎 + XGBoost + 规则瀑布 + Causal DAG 构建 + Critical Path 分析 |
每一层都补一块时钟的不确定性。Sync Plane 把绝对误差变小;Instrumentation 给每个事件打上具体的硬件戳;Propagation 把这个误差带在身上;Backend 用它来决定信任等级。
我把它叫”四层”是因为它们作用对象不一样:①同步层是物理时钟,②插桩层是单个 Span,③传播层是 Span 之间的边,④后端是整个 trace 的拓扑结构。这四层是一个递进的语义封装,每一层都为上一层提供”我现在有多可信”这个问题的答案。
2.3 tt-ext v3 头:53 字节把不确定性装进口袋#
这套机制能落地的关键是头格式(白皮书 §4.5):
version_flags : uint8     [1 B]  [7:4] tenant_id (4-bit, 16 tenants);
                              [3:0] version = 3
ptp_ns          : int64   [8 B]  PTP CLOCK_TAI(GTE 或 CPU 路径)
ts_source       : uint8   [1 B]  {GTE=0, SW_GCC=1, CPU=2}
clk_quality     : uint8   [1 B]  {OK=0, DEGRADED=1, UNKNOWN=2}
uncertainty_ns  : uint16  [2 B]  α_span(Eq.10),纳秒
lts             : uint64  [8 B]  本地 Lamport 时间戳
svc_sketch      : uint8[] [32 B] SVC Bloom filter(m=256 bits)
// Total: 53 bytes(不依赖集合大小 N)53 字节,比 IPv4 头还小,每个 Span 都自带不确定性标注。NTP 下你只能靠钟表师傅讲良心,PTP 下你至少知道每个时间戳能信到 ±什么级别。
三、最值得拆的三个组件#
3.1 GTE:GPUDirect 时间戳引擎 —— 残差从 2.1 µs 砍到 56 ns#
问题: GPU 集群里每个 kernel 启动 / 通信完成都需要时间戳。原来怎么拿?靠软件轮询 CPU 端的 cudaEventRecord() 和 clock_gettime(CLOCK_TAI),做配对校准。
为什么不够: CPU 端的时钟有两个干扰:
- DVFS(动态电压频率调整)—— CPU 时钟频率随温度/功耗漂移,事后没法可靠校准
- 软件轮询本身有抖动,这个抖动和实际时钟误差耦合在一起
论文 §3.3 的实测:这个软件方案留下 2.1 µs 的残差。
而 Table 1 告诉我们很多 GPU 操作中位延迟就是几十微秒 —— 2.1 µs 的残差把整个 trace 的归因能力废掉了。
TempoTrace 的做法(GTE,白皮书 §4.2.1):
不读 CPU 时钟,直接读 NIC 硬件时钟。具体流程是这样的:
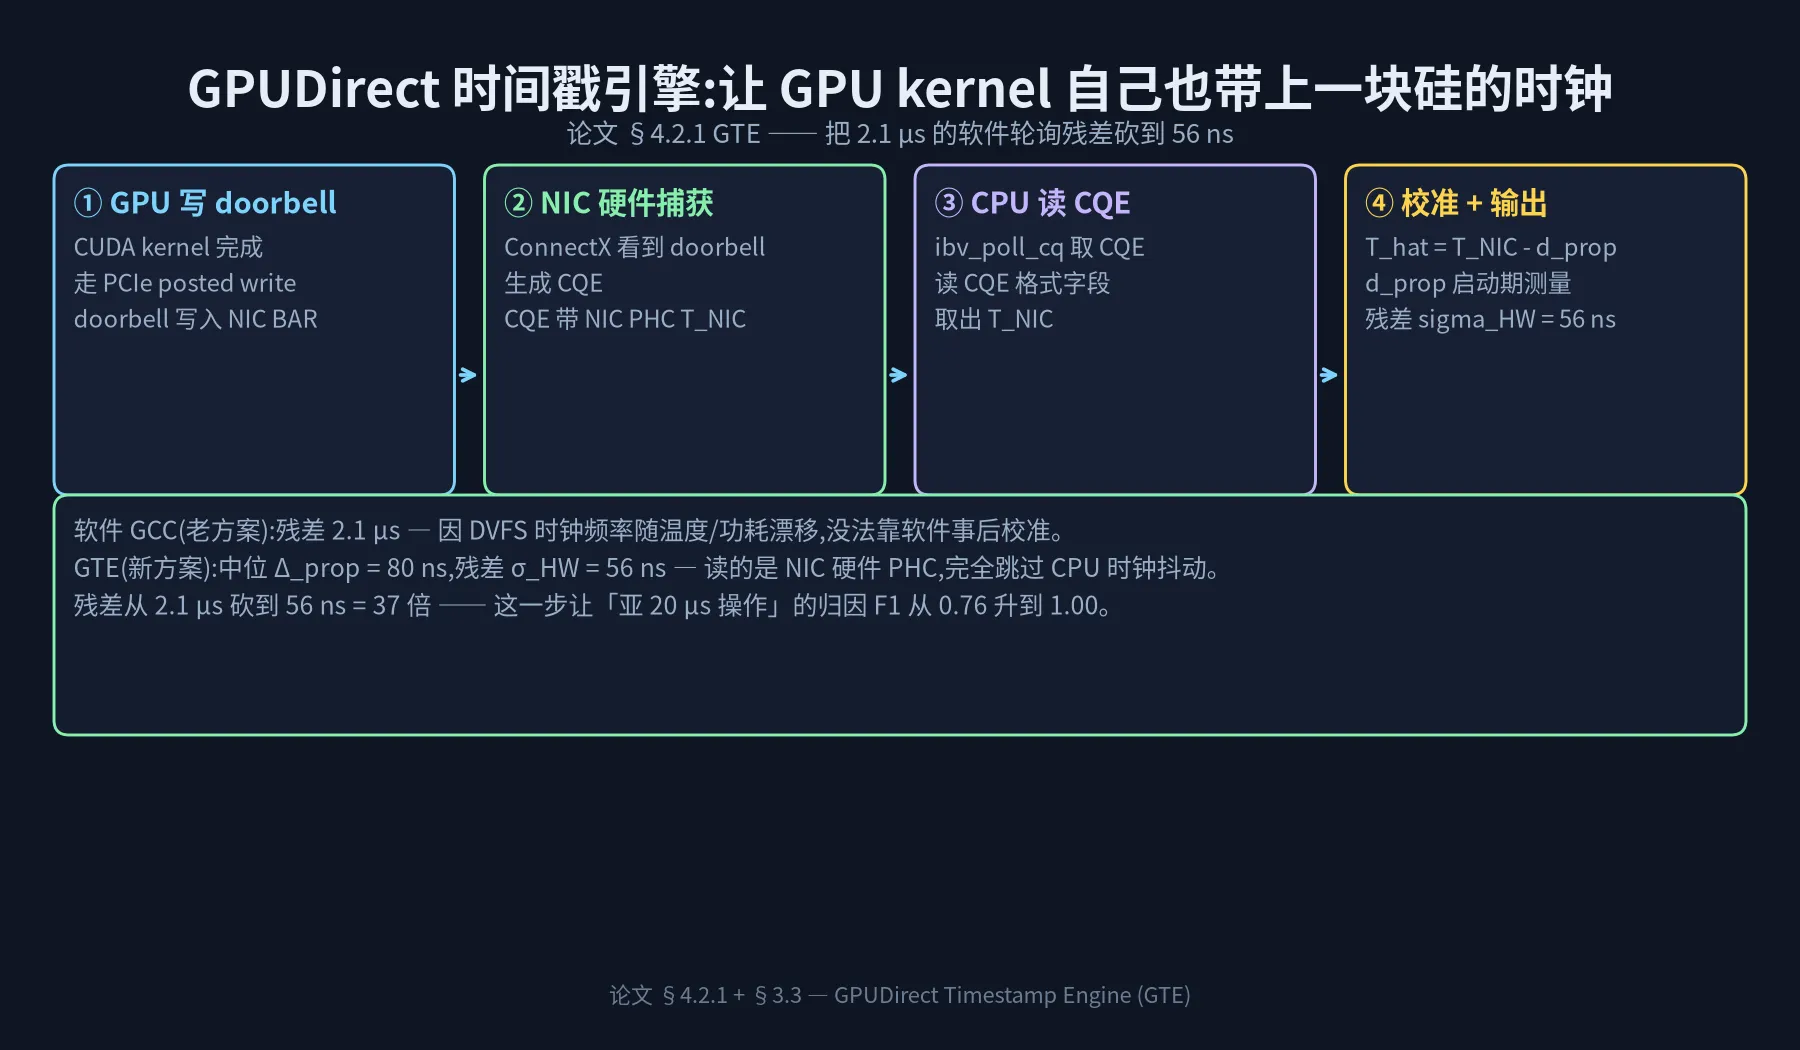
- GPU 写 doorbell:CUDA kernel 完成时,通过 PCIe posted write 把 doorbell 写入 NIC 的 BAR 寄存器。posted write 是 ordered + no-ACK,这一步的传播延迟固定。
- NIC 硬件捕获:ConnectX-6 Dx / ConnectX-7 NIC 看到 doorbell 后,生成 CQE(Completion Queue Entry),CQE 自带 NIC PHC 时间戳 T_NIC。论文特别强调 CQE coalescing 必须关掉(
CQ_ATTR_CQ_COUNT=1),否则一个 batch 里的多个 CQE 会共用一个时间戳,颗粒度就崩了。 - CPU 读 CQE:用
ibv_poll_cq把 CQE 取回来,从MLX5_CQE_FORMAT_TIMESTAMP字段拿到 T_NIC。 - 校准输出:T̂ = T_NIC − Δ_prop。Δ_prop 是启动期用 10,000 次配对测量得到的中位 PCIe 传播延迟,这个数字非常稳定(论文说 72 小时热浸泡后抖动 < 8 ns)。
实测结果:σ_HW = 56 ns 残差标准差,中位 Δ_prop = 80 ns(从 calibration 里减去),P99.5 残差 210 ns。
把 2.1 µs 砍到 56 ns —— 37 倍。这一步单独就让”亚 20 µs 操作的归因”从不可用变成 F1 = 1.00(白皮书 §6.4 Table 6)。
3.2 MRSH:把一万六千块 GPU 拉进同一根时间篱笆#
问题: 大模型集群不是 8 块 GPU 摆桌上,而是 256 个机架 × 64 GPU = 16,384 块 GPU。如果用一台 grandmaster 通过 PTP 一路同步到所有机架,最远的叶子同步延迟可以跨 4-6 跳透明时钟。
论文给了一个数:α ≤ 30 ns 只在”all transparent clock”小集群能成立。一旦集群到 2,048 节点以上,你必须用 BC(boundary clock)层级,精度立刻退化到 α ≤ 230 ns。再大到 16,384 节点,可能到 α ≤ 630 ns(白皮书 §4.2.3)。
而 α_rack ≤ 630 ns 的意思是你对一条跨机边的物理排序可靠度只有 50 - 60% —— 因为很多跨机操作的延迟就在 1 - 2 µs 这个区间。
TempoTrace 的做法(MRSH,Multi-Rack Synchronization Hierarchy):
两层 grandmaster 树:
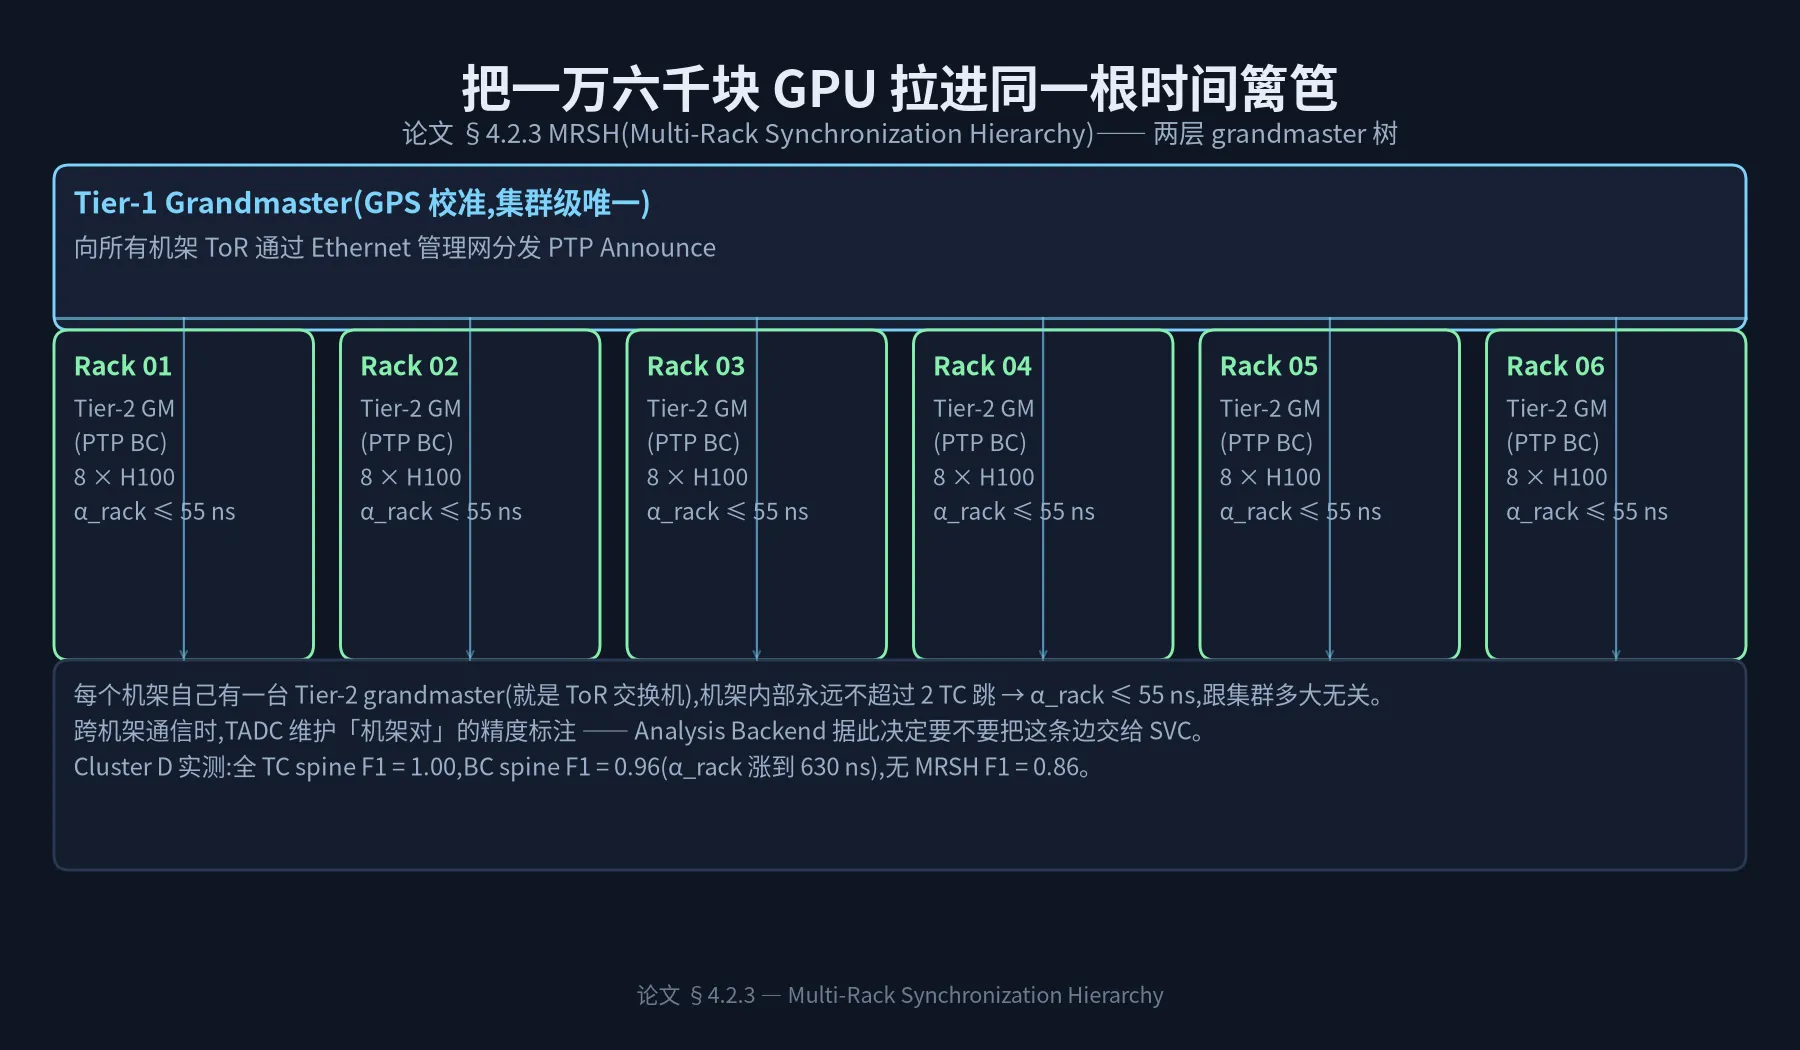
- Tier-1 grandmaster(集群级):一台 GPS 校准的主时钟,带 hot-standby 备份。它通过以太网管理网把 PTP Announce 发给所有机架的 ToR 交换机。
- Tier-2 grandmaster(机架级):每个机架的 ToR 交换机自己作为 PTP boundary clock,从 Tier-1 同步,然后给机架内所有节点当 grandmaster。
关键性质:每个机架内部永远不超过 2 TC 跳,所以机架内精度 α_rack ≤ 55 ns —— 跟集群多大无关。
跨机通信怎么办?TempoTrace 让 TADC(Topology-Aware Delay Compensator)维护一张「机架对」表,记录每一对机架的精度值,Analysis Backend 拿到跨机边时,先看精度是不是够 —— 够就物理排序,不够就丢给 SVC 兜底。
论文 §6.8 Table 10 的实测,MRSH + all-TC spine 在跨机归因上 F1 = 1.00(等于单机架性能);没有 MRSH 的退化集群 F1 降到 0.86。这就是分层结构的力量。
3.3 Hybrid SVD:规则和 XGBoost 谁也别一手遮天#
问题: SLO 违反归因(SVD,SLO Violation Decomposition)在 LLM 推理里有六个常见根因类:
- R1 Prefill 计算饱和
- R2 KV Cache 失效放大
- R3 投机解码失配
- R4 调度器抢占
- R5 网络引发阻塞
- R6 租户共调度干扰(多租户)
两条路可以走(白皮书 §5.3):
- 规则瀑布:写 6 个 if-else,按优先级硬排。优点:可解释、不需要训练数据;缺点:阈值定死了,捕捉不到特征之间的交互效应。
- XGBoost:用 14 维特征训一个分类器。优点:能学交互;缺点:低置信时不可靠,而且没训练数据就废了。
论文 §6.7 Table 9 在 412 起真实 SLO 事故上对比:规则 macro-F1 = 0.91,XGBoost 单独 macro-F1 = 0.93。XGBoost 略胜一筹,但差距不大。
TempoTrace 的做法:Hybrid SVD(置信门控融合)
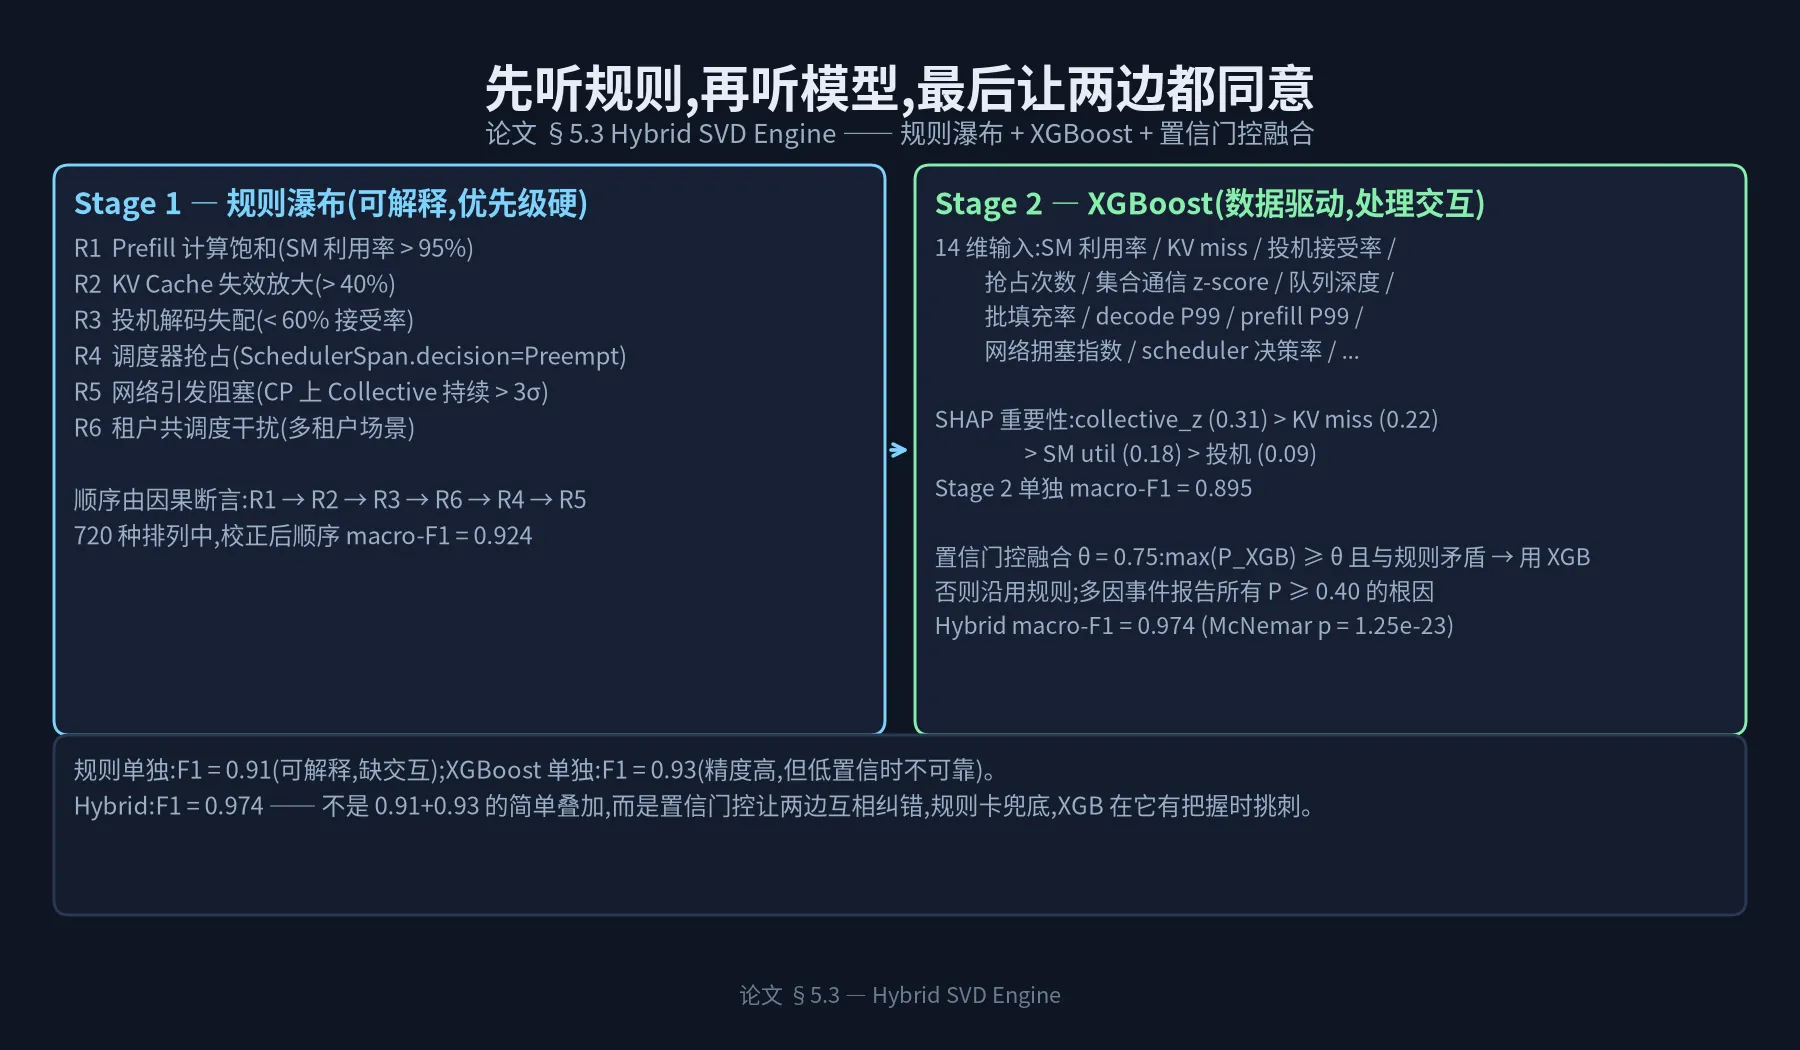
Stage 1 跑规则瀑布,得到 R_rule。 Stage 2 跑 XGBoost,得到概率分布 P_XGB。
然后用置信门控融合:
if max(P_XGB) ≥ θ = 0.75 且 argmax(P_XGB) ≠ R_rule:
    用 XGBoost 预测
else:
    用规则预测

对多因事件,报告所有 P_XGB(R_j) ≥ 0.40 的根因也就是说:XGBoost 推翻规则只有”它有 75% 以上把握、并且结论跟规则不同”的时候。否则规则兜底。
论文在 1,800-incident controlled corpus 上的结果:
- 规则单独(校正顺序):macro-F1 = 0.924
- XGBoost 单独:macro-F1 = 0.895
- Hybrid:macro-F1 = 0.974
- McNemar p = 1.25 × 10⁻²³(不是噪声)
注意 0.924 → 0.974 这个 5 个百分点的提升,在工业级监控系统里是质的差别 —— 它意味着从”工程师会怀疑工具的结论”变成”工程师会相信工具的结论”。
这也给出一个一般性的工程教训:别让规则和模型二选一。让规则卡兜底,让模型在它有把握时挑刺。两者在置信门控下互相纠错。
四、Policy —— 一个能力时钟,服务三类不同工作负载#
最后一个有意思的设计是Application Confidence Policy(白皮书 §10)。
现实里同一根 PTP 时钟上跑的工作负载,精度需求是不一样的:
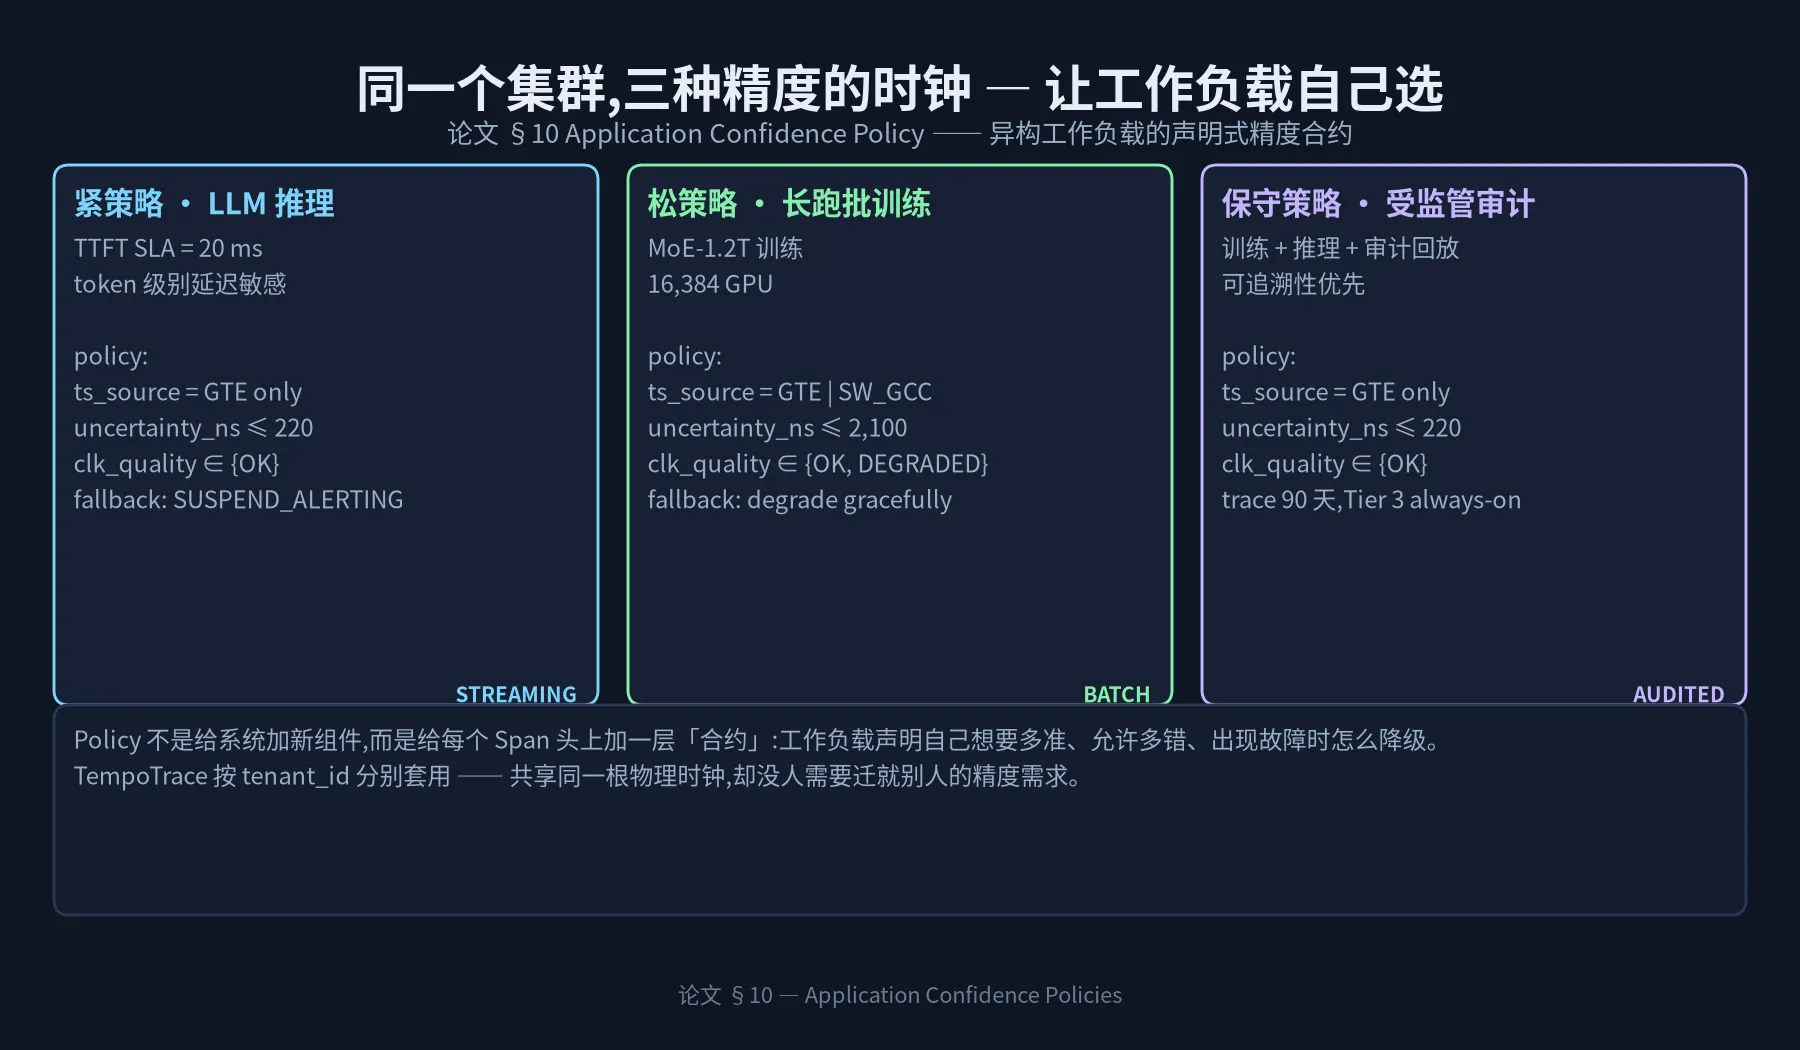
- LLM 推理(20 ms TTFT SLA):每个 token 都要快,对时间戳精度的需求是最高的,policy 必须
ts_source = GTE only,uncertainty_ns ≤ 220,clk_quality ∈ {OK},failover 时宁可 suspend alerting。 - 长跑批训练(MoE-1.2T,16,384 GPU):平均吞吐比单步延迟重要,可以接受更大的不确定性,policy
ts_source = GTE | SW_GCC,uncertainty_ns ≤ 2,100,failover 时优雅降级。 - 受监管审计:可追溯性优先,policy 要求
GTE only+ 90 天保留 + Tier 3 always-on。
TempoTrace 让每个工作负载声明自己想要的精度合约,然后系统按 tenant_id 分别套用。这不是给系统加新组件,而是给每个 Span 头上加一层「合约」。
我个人特别喜欢这个设计,因为它把”如何权衡精度和开销”这件事从底层搬到工作负载侧,每个租户自己选 —— 这跟 SaaS 时代的”你买什么套餐我给你什么 SLA”是同一套思路,只不过这里的 SLA 是纳秒级的。
五、局限和留给我们的启示#
TempoTrace 不是万能的(白皮书 §8 列了 5 条):
- GTE 依赖 ConnectX-6 Dx 或更新版 NIC。老 NIC 只能 fallback 到 DVFS-aware software GCC,残差 0.6 µs,够不上亚微秒需求。
- BC spine 比 TC spine 精度差一截。BC 边界让 α_rack ≤ 630 ns,跨机归因 F1 降到 0.96(全 TC 是 1.00)。
- 跨数据中心 GNSS failover 4 秒真空期。grandmaster 切换期间 α_DC 涨到 65 µs,这段时间跨 DC 归因 F1 掉到 0.86,直到 grandmaster 恢复。
- XGBoost 至少需要 50 起标注事故才能上线 override。低于这个数只能回退到纯规则。
- 超低延迟跨数据中心链路(L_WAN < 500 µs)SVC 兜底变得很频繁,α_DC 的安全裕度不足。
对工程实践的启示#
读完这篇白皮书,我提炼出三个我觉得特别值得记下的设计原则:
原则一:让不确定性的标注变成基础设施的一部分,不要让上游去猜
传统 trace 工具假设时间戳是可信的,这是工业上 20 年来的默认假设。当这个假设在大模型基础设施里失效时,正确的做法不是改分析后端的逻辑,而是回到时间戳的源头,把不确定性显式化。
这是 Dapper 之后整个 trace 行业都没有真正解决的事。TempoTrace 的 tt-ext v3 头(53 字节)是个可执行的方案。
原则二:分层结构是规模化的必要条件
把 16,384 块 GPU 拉进同一根时间篱笆,MRSH 的两层 grandmaster 不是设计癖好,是规模化强需求。一个 grandmaster + 全 transparent clock 的方案在 256 节点以下好用,到 2,048 就崩了。
任何基础设施做到一定规模,你都会看到这种”加一层”的设计 —— 操作系统加页表、文件系统加 journaling、trace 系统加 multi-DC。
原则三:让规则和模型互相纠错,而不是互相替代
Hybrid SVD 的设计提醒我们,规则(可解释、低风险)和模型(高表达、需要数据)是互补的,不是替代关系。置信门控融合是两者之间的桥。
这种”双系统”思路在工业 AI 系统里非常常见 —— 规则兜底 + 模型补强,置信门控做仲裁。TempoTrace 的具体数字(0.974 vs 0.924)给出了量化的证据。
写在最后#
我以前觉得”时钟同步”是个很无聊的话题 —— 服务器校时,准确到秒就好。
读完 TempoTrace 我意识到,在 AI 基础设施的尺度下,时钟同步是 trace 系统的物理可信层。它不再无聊,它是基础设施的地基。
TempoTrace 这篇白皮书的工程价值在于:它把”地基不稳”这件事从”我们都知道但没人系统解决”的状态,推进到”有完整方案、有实测数字、有失败兜底”的状态。这是 cs.DC 领域很少见的、把分布式系统、时间同步、可观测性、机器学习、形式化验证五件事拼到一篇文章里做的工作。
如果你正在做 GPU 集群的可观测性,或者你正在被一个”trace 不准但又说不清哪里错了”的问题困扰,建议从 §3.2 和 §4.2.1 开始读,这两节是 TempoTrace 的设计核心。其余章节可以按需取用。
参考与延伸阅读
- TempoTrace Technical White Paper, Elbakoury & Sharma, arXiv 2609.23301
- IEEE Std 1588-2019, Precision Time Protocol
- Dapper, Google’s Large-Scale Distributed Systems Tracing Infrastructure
- Spanner TrueTime, Google’s Globally Distributed Database
- Bloom Clocks, Logical Time for Distributed Systems
- OpenTelemetry Trace Context, W3C Recommendation