“Agents remember. Humans innovate.” —— TencentCloud/TencentDB-Agent-Memory ↗ README 副标题
一、从零搭一个能用 CLI,看到团队级记忆是怎么做出来的#
今天要拆的 TencentCloud/TencentDB-Agent-Memory ↗ 不是又一个向量数据库,它是腾讯云团队做的一套**把 Agent 上下文做成”团队资产”**的系统。
GitHub 仓库 19MB,单 git clone 偶尔被网络掐断,我用 codeload.github.com 拉了 34MB tarball 下来。解压开:
MemoryCore/      # 记忆核心引擎  (skill / scene / persona / chat memory)
MemoryKnowledge/ # 知识引擎      (Wiki + CodeGraph)
MemoryPanel/     # 控制台(Web UI + 后端)
MemoryProxy/     # 透明 LLM 代理
sdk/             # 多语言 SDK
deploy/          # Docker / K8s 部署
assets/          # README 图片
README.md四个独立 package.json、四个独立 pnpm-workspace.yaml,每块都是一个完整的 npm 包。版本号:v2.0.0-beta.1(生产稳定版 v2.0.0)。
主语言 TypeScript(Node.js ≥ 22.16),License MIT,23K stars。
README 第一句不是讲技术,而是讲问题:
“How do you reduce repetitive work when using Agents?”
这是腾讯云给我的命题作文。我读完后给的判断:这是一个”记忆的资产化”项目,不是”记忆的存储”项目。
二、四层渐进记忆:L0→L1→L2→L3#
从 README 的 flowchart5.png 可以看到一个金字塔:
L3 Core / Persona     ← 长期画像、稳定模式、高层认知
L2 Scenario           ← 围绕项目/场景的知识块
L1 Atom               ← 事实、偏好、约束、事件
L0 Conversation       ← 原始对话(完整上下文)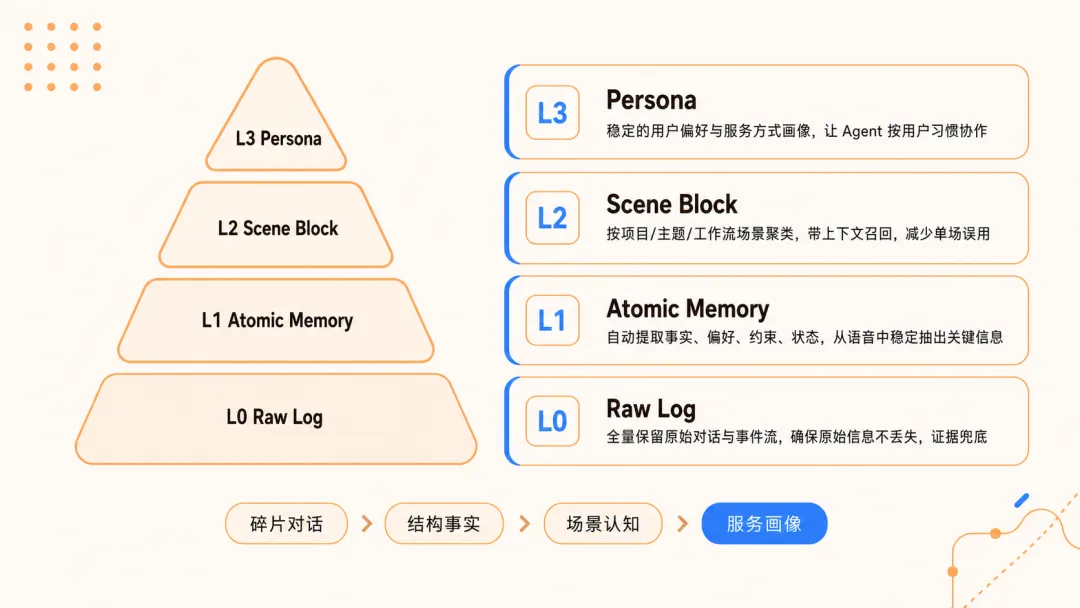
这是和 OpenViking 的 L0/L1/L2 完全不同的设计——OpenViking 是 文件目录视角(三层是抽象层),TencentDB Agent Memory 是 时间粒度视角(四层是蒸馏深度)。
| 层 | 存储 | 用途 |
|---|---|---|
| L0 | JSONL 日志(每天一个文件) | 校验原始措辞、时间戳、来源 |
| L1 | SQLite + 向量索引 | 精准召回可执行信息 |
| L2 | .md scene 块(带 wiki link) | 快速还原工作上下文 |
| L3 | persona.md(全局画像) | 让 Agent 快速进入用户上下文 |
源码里 MemoryCore/src/core/conversation/l0-recorder.ts 单独把这个层抽象出来:
~ / .openclaw / memory-tdai / conversations / YYYY - MM - DD .jsonlL0 用 JSONL、一天一个文件(不是一个 session 一个文件)。注释里写明:
“Design: one message per line; flat, easy to grep/stream.”
这是工程化细节——grep、jq、slice 都能直接处理。
L1 的抽取在 MemoryCore/src/core/skill/queue/types.ts 里定义为 ExtractedCandidate:
interface ExtractedCandidate {
  action: "create" | "patch" | "edit" | "update" | "write_file" | "files_write";
  name: string;
  description: string;
  content?: string;
  confidence?: number;
  reason?: string;
}注意到了吗?Skill 不是单独模块,是 L1 抽取的产物之一。这套系统把 skill / memory / scene 当成同质资源,都通过 LLM 抽取 + 摘要 + 蒸馏。
三、四大 Memory Asset:Chat Memory / Skill / Wiki / CodeGraph#
README 里写得很直白:
“Chat Memory, Skill, LLM-Wiki, Code-Graph — four reusable memory assets.”
四种资产的设计哲学是各有分工、各管一段:
3.1 Chat Memory(L0→L1→L2→L3 全链路)#
- L0:每次会话结束被
agent_endhook 捕获 - L1:LLM 抽取事实/偏好/约束
- L2:按项目/场景归并
- L3:长程画像(persona.md)
代码位置:MemoryCore/src/core/skill/queue/types.ts:78 定义 ISkillExtractor 接口。
MemoryCore/src/core/skills/queue/conversation-add/extract-worker.ts 是 EntryPoint。
3.2 Skill(带版本控制和 ACL)#
这一块代码量最大,整个 MemoryCore/src/core/skill/ 4347 行(19 个文件)。
最关键的 skill-core.ts 头部注释写得清清楚楚:
SkillCore — 6 个 manage action 的编排门面
  1. 解析 + 校验 SKILL.md(frontmatter)
  2. 取 head(如有)
  3. assertTeamMatch / assertOwner / assertVersionFresh
  4. 调 SkillVersioning.appendNextVersion / createNewSkill

6 个写动作: create / update / patch / delete / writeFiles / removeFiles
4 个读动作: get / list / search / listVersions / readFile所有 Skill 都是 SKILL.md 文件(注释里说”inspired by Anthropic Skills”),有完整 frontmatter 校验:
// skill-format.ts
NAME_MAX = 64
DESCRIPTION_MAX = 1024
BODY_MAX = 50_000
NAME_REGEX = /^[a-z0-9][a-z0-9-]*$/
RESOURCE_TYPES = { text, executable, binary }注意 BODY_MAX = 50_000——这是单 skill 上限,比常规 SKILL.md 多 10 倍。腾讯云显然想让 skill 能装下完整工作流。
版本控制是真版本——skill-versioning.ts 维护 appendNextVersion,每次更新都加版本号并保留历史(带 TTL 可配)。乐观锁用 expected_version 字段防并发覆盖。
3.3 Wiki(受 Karpathy LLM knowledge base 启发)#
仓库首页写明:
“Wiki turns product docs, design specs, and ops runbooks into structured pages with a link graph. (Inspired by Karpathy’s LLM knowledge base.)”
MemoryKnowledge/src/engines/wiki/ 实现,有几个亮点:
a. 用 SQLite 替代 MiniSearch
manager.ts 注释:
“索引存储(设计 006):BM25 全文检索、知识图谱、页元数据不再常驻内存,改存每个 wiki 私有的
index.db(SQLite:wiki_fts + page_meta + graph_edge)。写走独立事务连接(重建三表),读走 LRU 连接池;内存与 wiki 总数解耦,根治 MiniSearch 全量常驻的 OOM。”
b. 多跳图搜索
graph-search.ts 实现 BFS 多跳展开:
graphMultiHopSearch(graph, seeds, {
  hop: 3,        // 0-5 跳
  decay: 0.7,    // 每跳衰减
  minScore: 0.1,
  maxNodes: 200, // 硬上限防 DoS
});c. Graph + BM25 混合召回
SearchResult 类型里 hop 字段标记是 BM25 直达(hop=0)还是图扩展(hop>0)。
3.4 CodeGraph(基于 @colbymchenry/codegraph)#
这是腾讯云 ⼀个比较巧妙的设计——不自己写代码图谱,直接包了一层。
MemoryKnowledge/src/engines/code/bridge.ts 就 217 行,定义了 6 个方法:
openIndex / indexProject / syncIndex / executeTool / getStats / closeIndex底层全是 import("@colbymchenry/codegraph"),把 npm 包当依赖,不造轮子。这是工程师的成熟做法。
Wiki + CodeGraph 暴露为 MCP 工具集(/v3/tools/list + /v3/tools/call),Agent 能在工具列表里看到,按需调用。
四、Memory Hub:团队控制台(不是只看,是管)#
这是腾讯云和其它所有 RAG 项目最大的区别。
MemoryPanel/ 目录是完整的前后端实现(web/ + src/)。README 写得很明确:
“Memory Hub Is Not a Display Board — It’s a Control Panel.”
控制台能做什么?README 表格列出 5 大玩法:
| 玩法 | 干啥的 |
|---|---|
| Team Up | 建团队、加人、加 Agent、定义共享边界 |
| Asset Library | 浏览、搜索、审核、管理 4 种资产 |
| Agent Loadout | 把不同资产绑定到不同 Agent、调整优先级和调用模式 |
| Knowledge Workshop | 建 Wiki / CodeGraph、监控处理状态 |
| Access Control | 在 private / team / restricted 之间切换 |
Asset 关注的是”是谁的、哪个版本、谁在用、最近是否活跃”——这跟 ChatGPT 那套”对话历史”完全是两个产品。
权限系统是 4 档:
| Visibility | 语义 |
|---|---|
private | 只有 Owner 能读,团队 admin 也看不到 |
team | 团队成员能读,Owner/Admin 能管理 |
restricted | 按 User/Role/Agent ACL 精确授权 |
agent | 团队内特定 Agent 定向装备 |
这是 RAG 罕见的所有权/版本/状态/可见性/使用次数/Agent 绑定一站式的设计。
五、One Play Style:一人公司的多 Agent 团队#
README 里最戳我的不是技术,是这一段”一人公司”故事:
Tiny but Serious Inc.
├── 👤 You · Set goals / Make decisions
├── 🔭 Scout · Research / Find opportunities
├── 🛠 Builder · Write code / Build products
├── 🧪 Reviewer · Test / Find issues
└── 🧠 Agent Memory · Preserve the team's experience然后给每个角色配 loadout:
🔭 Scout
   ├── User interview Chat Memory
   ├── Market research Wiki
   └── Competitive analysis Skill

🛠 Builder
   ├── Product Wiki
   ├── Project CodeGraph
   └── Feature Delivery Skill

🧪 Reviewer
   ├── Historical incident Chat Memory
   ├── Project CodeGraph
└── Release Checklist Skill这不是”prompt 模板”,是”上下文资产配置”。Scout 不需要 procedural code Wiki,Builder 不需要 user interview 笔记。系统强制按角色喂数据。
README 结尾那句很打动人:
“The company can be tiny. Experience can compound forever.”
六、Proxy:透明 LLM 注入(不改 Agent)#
第二个工程创新点在 MemoryProxy/——任何 Coding Agent 都能零代码接入。
README 表(README.md 顶部署):
| Agent | 接入方式 |
|---|---|
| Claude Code | 设置 ANTHROPIC_BASE_URL=http://proxy:8096/claude-code/default |
| Codex | 同上 |
| CodeBuddy | 同上 |
| WorkBuddy | 同上 |
| Hermes | 同上 |
| DeepSeek Harness (DSH) | 同上 |
| OpenClaw | 同上 |
核心 idea:把 Client 的 base URL 指向 Proxy,Proxy 透明转请求 + 注入记忆 + 转发到上游 LLM。LLM 客户端零改动。
Proxy 的代码在 MemoryProxy/src/server.ts,用 Hono 框架(不是 Express),分 4 个处理器:
handleChatCompletions        // OpenAI 协议
handleAnthropicMessages      // Anthropic 协议
handleCodexEndpoint          // Codex 专属
handleWorkbuddyEndpoint // WorkBuddy 专属每个 Agent 客户端有专属适配器(MemoryProxy/src/agent-adapters/):
claude-code.ts  # CC reverse engineered: cache_control + tools/thinking 三分
codebuddy.ts    # CB stub
codex.ts        # Codex 协议适配
workbuddy.ts    # WorkBuddy 协议适配
dsh.ts          # DeepSeek Harness
default.ts # 兜底claude-code.ts 注释里直接写”逆向 CC 源码 forkedAgent.ts / sideQuery.ts + 抓包实证”——他们是抓包反推 client behavior 的,不是猜的。
代价是协议破碎时 adapter 会假阳性——但 agentSource 字段让每个请求都能追溯到具体客户端,方便排查。
Skill bridge 还有一个精妙设计:
// skill-bridge.ts 顶部注释
Why: the LLM uses Bash to curl skill operations (see <skill_tools> block in
system prompt). We do NOT want the bearer token to land in the prompt, and we
want to stamp (user_id, team_id, agent_id, task_id?) from the session into
outbound bodies so the LLM cannot fake identity.安全设计:LLM 永远拿不到 bearer token,所有身份信息由 proxy 注入 session 上下文。LLM 就算想发请求改别人的 skill,也改不了——身份字段是 proxy 强写的。
七、对比:它和 OpenViking 到底什么区别#
我昨天刚拆完 OpenViking ↗,这个项目天然要放在一起对比。
| 维度 | OpenViking | TencentDB Agent Memory |
|---|---|---|
| 核心理念 | Context 数据库(文件系统层) | 团队记忆资产化(资产层) |
| 抽象单位 | viking:// URI + 目录 | Chat Memory / Skill / Wiki / CodeGraph 4 asset |
| 层次 | L0/L1/L2(核密度) | L0/L1/L2/L3(蒸馏深度) |
| 部署 | 单进程 FastAPI + pyagfs | 4 服务(Core + Knowledge + Panel + Proxy) |
| 多 Agent | 11 个 integration 列举 | 不需要 integration,Proxy 0 改动接入 |
| 权限 | namespace + multi-tenant | 4 档 visibility + ACL |
| 状态管理 | 文件系统 | 显式 owner / version / status |
| 目标 | ”Data in, Context out" | "Agents remember. Humans innovate.” |
| License | AGPLv3 | MIT |
| 语言 | Python + Rust | TypeScript |
| Stars | 30K | 23K |
两者解决的不是同一个问题:
- OpenViking:把”上下文”做成”文件”——Agent 用
ls/find/read操作上下文 - TencentDB Agent Memory:把”记忆”做成”资产”——谁拥有、谁能用、谁在用,都是显式字段
如果 Agent 是个人助理,OpenViking 更顺手;如果 Agent 是团队协作,TencentDB Agent Memory 更合适。
八、Skill 流水线:LLM 写文件、版本、签出的工程化#
值得专门讲一下 MemoryCore/src/core/skill/skill-tools.ts——这是 LLM 真正操作 SKILL.md 的工具集。
工作流:
1. hook: agent_end
2. queue: skill-extract 任务入列
3. worker: 1 个进程 = 60 worker (concurrency default)
4. extract: SkillExtractor.run() / LLM 抽取
   - 调用 SkillToolsV2 (create/update/patch/delete/writeFiles/removeFiles)
   - 返回 ExtractedSkillCandidate[]
5. version: SkillVersioning.appendNextVersion
   - storage 拷贝 head 到新版本
   - apply 资源变更
   - skill-store.appendVersion 写 DB(事务内)
6. ACL: assertOwner + assertTeamMatch + assertVersionFresh
7. asset: onSkillCreated 钩子登记工程化细节:
- SkId 用 base62 12 字符(71 bit CSPRNG 真熵)——比 base36 安全
- 每个 skill 一行 SQLite row,主键
row_id物理主键,skill_id跨版本共享 - 乐观锁防并发覆盖:
expected_version字段,所有写动作必传 - TTL:旧版本默认 0(不清理),可配 7 天过期
- 资源校验:
maxResourceSizeBytes+allowExecutable双重门控 - Probe 维度:embedding 维度 0 = 不创建
skill_vec虚拟表(不依赖 VDB 也能跑)
最有意思的是 SkillVersioning 的失败回滚语义:
// skill-versioning.ts 顶部注释
一次完整的"加一版"动作:
  1. 取 head(如果有)
  2. 校验:owner / version / 内容是否变更
  3. storage 拷贝 head 的版本目录到新版本目录(如果有 head)
  4. 在新版本目录上 apply 本次资源变更(write/remove)
  5. store.appendVersion 写 DB(事务内)
6. 失败时尝试清理已写入的 storage 副本(best-effort)“事务内 + 失败时 best-effort 清理”——这是腾讯云在多次迭代后做的妥协:纯事务不可能(涉及 COS + SQLite 跨系统),但可以做到”DB 失败 → COS 副本回滚”。
九、Lifecycle:Cold Start + Continuous Loop#
README 给出两个流程图,flowchart3.png(cold start)和 flowchart4.png(continuous loop)。
Cold Start 直接 import 存量资产:
import existing:
  ├── Codebases →   CodeGraph 自动索引(symbols / files / call graph / impact path)
  ├── Documents →   Wiki 自动生成(结构化页面 + link graph)
└── Sessions → Skills + Chat Memory 自动抽取效果就是 README 里那句:
“Stop retraining every Agent. Give it the save file.”
Continuous Loop(README 核心叙事):
work produces assets
     ↓
assets circulate through the team
     ↓
new members can load the team's save file on day one具体实现:
- Wiki 异步摄取:构建期间
ready状态为 pending - CodeGraph 异步同步:git push 后自动 rebuild
- Skill 日常抽取:每次 agent_end hook 触发 LLM 抽取
- Chat Memory 自动 commit:每个 turn 写 L0
源文档里 MemoryKnowledge/src/engines/wiki/manager.ts 里 runIngestIncremental 是核心,增量摄取走 SQLite 事务。
十、部署:5 分钟跑起来#
INSTALL.md 写得很工程化:
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env
$EDITOR .env       # 填两组 LLM 参数(memory 组 + proxy 组)
./start-all.sh # 一键启动启动后控制台在 http://localhost:8125,输出到终端的 admin key 直接给 Claude Code 用:
export ANTHROPIC_BASE_URL=http://127.0.0.1:8096/claude-code/default
export ANTHROPIC_AUTH_TOKEN='sk-mem-<random 32 chars>'
claude --model <whatever PROXY_UPSTREAM_MODEL is set to>端口分配:
| 服务 | 端口 | 用途 |
|---|---|---|
| Memory Core | 8420 | 记忆读写、auth、skill/RAG 数据平面 |
| Panel UI | 8125 | 团队记忆控制台 |
| Knowledge | 8424 | Wiki / CodeGraph 服务 |
| Proxy | 8096 | LLM 透明代理 |
deploy/global-images/start-all.sh 还做了新手友好:
“On the first boot, calls init-admin to create the admin user, generates a random 32-char user_key and persists it to ./.admin-key (reused across restarts of the same volume).”
第一次启动自动生成 admin 密钥、持久化、跨重启复用——这是部署门槛最低的版本之一。
十一、性能数字与基准#
README.md 的 benchmark 表格:
| Benchmark | Without Memory | With Memory | 提升 |
|---|---|---|---|
| PersonaMem | 48% | 76% | +59% |
PersonaMem 测的是 Agent 在长程交互后能否正确理解用户偏好。 48% → 76%,相对提升 59%。
对比 OpenViking 的 LoCoMo 24% → 82%,提升幅度明显但位数不同。原因是 TencentDB 测的是团队记忆(用户偏好 profile),OpenViking 测的是个人记忆(对话内容)。两者不是同一个 benchmark。
但合起来看:有记忆的 Agent 比无记忆的 Agent 在长程任务上优秀 50%-60% 是有共识的。
十二、缺陷和需要注意的事#
- 复杂度高:4 个独立 npm 包 + 4 个独立服务 + 5 个数据库(SQLite、Redis、PostgreSQL、ClickHouse、COS)。个人开发者想跑通需要点耐心。
- 强依赖腾讯云生态:COS 对象存储(虽然可以本地化)、TDSQL(如需云版)、LVS(可选)。纯本地化部署需要看代码绕过。
- LLM 抽取耗时:每次 agent_end 都会触发 LLM 抽取,频繁长任务会被这个调用拖慢。
- CodeGraph 限制:README 写明”目前优先 public HTTPS 仓库,私有仓库 / SSH 凭证 还在打磨”。
- Skill 抽取设计假设:必须出现
tool_call数量 >= 阈值(默认 1)—— 纯对话型 Agent 不会触发 Skill 抽取。 - frontmatter 严格:SKILL.md 必须严格匹配
^[a-z0-9][a-z0-9-]*$的 name 规则,从 Anthropic Skills 改过来的会报错。 - MEMORY 抽取是异步:Memory commit 后立刻 fetch 可能看不到——需要
wait_processed/ 轮询。 - CC 抓包信用:原代码注释明确”逆向 CC 源码 + 抓包实证”—— Claude Code 协议升级会破。
十三、读完之后我换了一个角度想”Agent 记忆”#
我之前做 Agent 记忆默认思路是:
episodic memory + semantic memory + procedural memoryTencentDB Agent Memory 让我看到另一种思路:
memory asset = 资产 → 谁拥有、谁能用、谁在用、是否有版本把它当 “资产” 而不是 “记忆” 来设计,带来的变化是:
- 可签出 — Scout 装备自己需要的,Builder 装备自己需要的
- 可转让 — Owner 把 Skill 从私提升到 Team
- 可归档 — Skill 没用了 status 改成 archived
- 可失效 — Wiki 老版本 7 天过期
- 可路由 — Chat Memory 写入时按 role / topic 路由
这是数据库设计的”行级”,不是应用层的”日志式”。
我下一篇博客应该会写怎么用 TencentDB Agent Memory 给一个一人公司搭一个 4 Agent 团队。如果你想先动手,最短路径:
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env && $EDITOR .env
./start-all.sh
# 然后照 README 走 admin → team → agent → asset loadout或者 0 安装跑 demo:直接打开腾讯云官方托管版 TencentDB Agent Memory Cloud。
附录:关键源码定位速查#
| 模块 | 路径 |
|---|---|
| README 核心叙事 | README.md:194-243 |
| 四层金字塔 | README.md:103-118 |
| Skill 编排门面 | MemoryCore/src/core/skill/skill-core.ts |
| SKILL.md 解析 | MemoryCore/src/core/skill/skill-format.ts |
| Skill 存储 | MemoryCore/src/core/skill/skill-store.ts(733 行) |
| Skill 版本 | MemoryCore/src/core/skill/skill-versioning.ts |
| Skill 权限 | MemoryCore/src/core/skill/skill-permission.ts |
| 技能抽取 | MemoryCore/src/core/skill/skill-extractor.ts |
| 队列契约 | MemoryCore/src/core/skill/queue/types.ts |
| L0 记录 | MemoryCore/src/core/conversation/l0-recorder.ts |
| L2 场景抽取 | MemoryCore/src/core/scene/scene-extractor.ts |
| L3 Persona 生成 | MemoryCore/src/core/persona/persona-generator.ts |
| 存储抽象 | MemoryCore/src/core/storage/types.ts |
| 存储后端 | MemoryCore/src/core/storage/local-backend.ts |
| Worker 池 | MemoryCore/src/services/worker-permit-pool.ts |
| Pipeline runner | MemoryCore/src/services/pipeline-worker.ts |
| Gateway 路由 | MemoryCore/src/gateway/v2-router.ts |
| OpenClaw 适配 | MemoryCore/src/adapters/openclaw/host-adapter.ts |
| Wiki Manager | MemoryKnowledge/src/engines/wiki/manager.ts |
| 多跳图搜索 | MemoryKnowledge/src/engines/wiki/graph-search.ts |
| Wiki 索引实现 | MemoryKnowledge/src/engines/wiki/index-db.ts |
| CodeGraph Bridge | MemoryKnowledge/src/engines/code/bridge.ts |
| CodeGraph URL 解析 | MemoryKnowledge/src/engines/code/normalize.ts |
| Proxy 入口 | MemoryProxy/src/server.ts |
| Anthropic 协议 | MemoryProxy/src/anthropicHandler.ts |
| OpenAI 协议 | MemoryProxy/src/handler.ts |
| Agent 适配器 | MemoryProxy/src/agent-adapters/index.ts |
| CC 适配 | MemoryProxy/src/agent-adapters/claude-code.ts |
| Skill 桥 | MemoryProxy/src/skill/skill-bridge.ts |
| Memory 桥 | MemoryProxy/src/memory/memory-bridge.ts |
| 身份识别 | MemoryProxy/src/identity.ts |
| 安装 | INSTALL.md |
| 部署 | deploy/global-images/start-all.sh |
| 安装 Skill 文档 | MemoryCore/SKILL.md |
| 数据迁移 | MemoryCore/scripts/migrate-v2-to-v3/README.md |
📘 项目信息
- 仓库:TencentCloud/TencentDB-Agent-Memory ↗
- 作者:腾讯云(Tencent Cloud)
- License:MIT
- 版本:v2.0.0-beta.1(生产稳定 v2.0.0)
- Star 趋势:https://trendshift.io/repositories/29310 ↗
- 官方文档:https://github.com/TencentCloud/TencentDB-Agent-Memory/blob/main/INSTALL.md ↗
- OpenClaw 集成:https://github.com/opensclaw/openclaw-agent-memory-plugin ↗