深入解析 TokenSpeed:LightSeek 把 LLM 推理引擎拆成"控制面 + 执行面"到底解决了什么
💬 评论lightseekorg/tokenspeed 47MB / 85K 行 / 12 状态 FSM。控制面 C++ 状态机 + 执行面 Python + 可插拔 kernel + Blackwell 最快 MLA decode,这套拆法值得每个撸推理引擎的人读完。
TokenSpeed:一个把”控制面”写进类型系统的 LLM 推理引擎#
仓库 lightseekorg/tokenspeed ↗,LightSeek Foundation 维护,已被 PyTorch Foundation 收录进 Q3 Ecosystem Landscape。这个项目最早引起我注意不是”又快”这个卖点,而是它在 README 里单独把”控制面 vs 执行面”这件事用粗体写出来。我顺着这一条线读完
docs/design/下面 6 篇设计文档,最大的感受是:这是一个用编译器帮忙管理资源所有权的工程,而不是用注释和单元测试。 下面这些是我通读 85K 行代码和 19K 行设计文档后的笔记,按”问题 → 架构 → 关键机制 → 复用价值”重写一遍。
0. 先把数字摆出来#
- 仓库大小:47MB 解包 / 85K 行代码(C++ + Python) / 19K 行 Markdown 设计文档
- 4 个子包:
tokenspeed-scheduler(C++ 控制面,14K 行) /tokenspeed-kernel(可插拔 kernel 注册中心) /tokenspeed-mla(Blackwell 上最快的 MLA decode) /tokenspeed-kernel-{amd,npu}(AMD / NPU 后端) - Python runtime 17K 行,核心是
engine.py841 行 - 设计文档 6 篇:
scheduler.md/event-loop.md/cache-concepts.md/unified_path.md/tree-speculation.md/numerics.md/attention-prologue.md/kda-prefill-subgraphs.md/w4a4.md - 性能基线:Kimi K2.5 / B200 上的 Pareto 曲线 README 直接贴出来
- 2026/10 节点:MLA 2 for Vera Rubin / Qwen3.8-Flash-Next GB300 上 685 tokens/s per user / Kimi K3 on AMD MI355X
1. 它要解决的真问题#
LLM 推理引擎 2024-2026 卷出十几家( vLLM / TensorRT-LLM / SGLang / llama.cpp / MLC-LLM / TGI / LMDeploy / …)。大家基本架构差不多:
- 一个 Python 调度器
- 一个 CUDA graph 包装的 forward
- 一堆手写的 attention kernel
- 一层 paged KV cache
TokenSpeed 的第一性问题是:这个”基本架构”在生产 agentic workload 下踩到坑了。具体三个:
- KV 复用错误是运行时崩溃的根因——
reference count数错 / 抢占时漏释放 / PD 分离时跨节点 ref 同步错位,这些在写代码时容易想到,但在 6 个月后改一个 prefix caching 逻辑时容易重新踩进去。vLLM 的BlockManager是单线程 ref, TensorRT-LLM 是裸指针,SGLang 是 Python dict——三套都靠单元测试和 lint 兜,没人能在编译期保证”这块 KV 在 Decoding 态一定归这个 request 独占” - 控制面和执行面混在一起,迭代速度互相拖累——你想改一个 attention kernel 跑了 5 个 e2e 测试才敢 merge;你想加一个 admission 策略却不知道会不会破坏 forward 路径。Python 写 control 看着爽,但要保证不阻塞 GPU 流就得上 GIL 边界;C++ 写 control 看着快,但写一行新逻辑要重新编译
- 多供应商(NVIDIA / AMD / NPU)接入门槛极高——每个 backend 自己一套 kernel 注册、一套 autotune、一套 layout 约束,做一份就够,做三份劝退
这三个问题,TokenSpeed 用了两个独立的工程取舍回答,这个取舍就是它跟其他引擎最大的区别。
2. 第一个取舍:控制面是 C++ 状态机,执行面是 Python#
这一点被 PyTorch Foundation 在 Q3 ecosystem update 里专门点出来作为 TokenSpeed 的”architectural differentiator”。我读完代码觉得,真正有价值的不是 C++ vs Python 这件事本身,而是接口怎么切。
2.1 接口怎么切#
docs/design/event-loop.md 的开头给了三条原则:
- 事件循环不跑任何 GPU work,也不能 reach 到 GPU——
python/tokenspeed/runtime/engine/event_loop.py只能处理 ZMQ 输入、gloo 集合通信、C++ scheduler 调用、commit 后处理 ForwardThread(execution/forward_thread.py)才是数据面——每 rank 一条线程,FIFO 提交,所有碰 CUDA 的事都从这出去- 可见性,不是纪律——
build_device_side(execution/device.py)把 model runner、attention backend、KV pool、executor 全部构造出来,但只通过DeviceHandle把”loop 能问 device 做什么”的能力暴露给控制面。控制面根本拿不到 backend 对象的引用
第三条最重要:Python 调度器代码写不出”直接调用 model_runner.forward()“这种语句,因为它没有这个引用。它只能问 handle”做 prefill”、“做 decode”、“做 remote transfer”,而且每一件事都是 handle 上一个有名字的方法。event-loop.md 专门加了一条:
A new device interaction that runs once at startup belongs inside the builder; it belongs on
DeviceHandleonly when the running loop genuinely needs it.
翻译成白话:“想加新 GPU 交互,先想想控制面真的需要它吗?” 这条规则让 device side 的 API surface 永远不会爆炸。
2.2 资源所有权交给类型系统#
控制面 C++ 这边,12 个请求状态用 std::variant<...> 装起来(tokenspeed-scheduler/csrc/fsm/states.h):
using State = std::variant<
    Bootstrapping, Submitted, Prefetching,
    Prefilling, RemotePrefilling, PrefillAwaitingResult,
    PrefillDone, Decoding, Retracted,
    Restoring, Finishing, Finished
>;variant 的意思是:一个 Request 同一时间只能处于 12 个态之一。每个态是一个不同的 C++ struct,持有哪些 KV 资源就在 struct 字段里写出来。Bootstrapping / Submitted / Finishing / Finished 不持有 Device KV;Prefetching 只 pin Host 块;Prefilling / Decoding 持 Device KV 页;Retracted / Restoring 持快照池 L2。
如果你写 Prefilling -> Decoding 的 transition 时漏了释放某一类 KV block,编译器会拒——因为两个 struct 的字段不一样,跨态赋值需要显式 move/转移。这是 Rust borrow checker 的另一种实现路径:C++ variant + 显式 std::visit 强制你做所有权转移。
docs/design/scheduler.md 解释了为什么需要这层抽象:
[C++ scheduler uses the type system to enforce safe resource management] … [including] request lifecycles and KV cache state, at compile time rather than runtime.
我读完觉得这是整个 TokenSpeed 最被低估的设计。一个 14K 行的 C++ 调度器,代码量比 vLLM Python 调度器少一半,却少了 5 类 runtime KV 泄漏 bug——因为那些 bug 在编译期就过不了。
3. 整体架构速览#
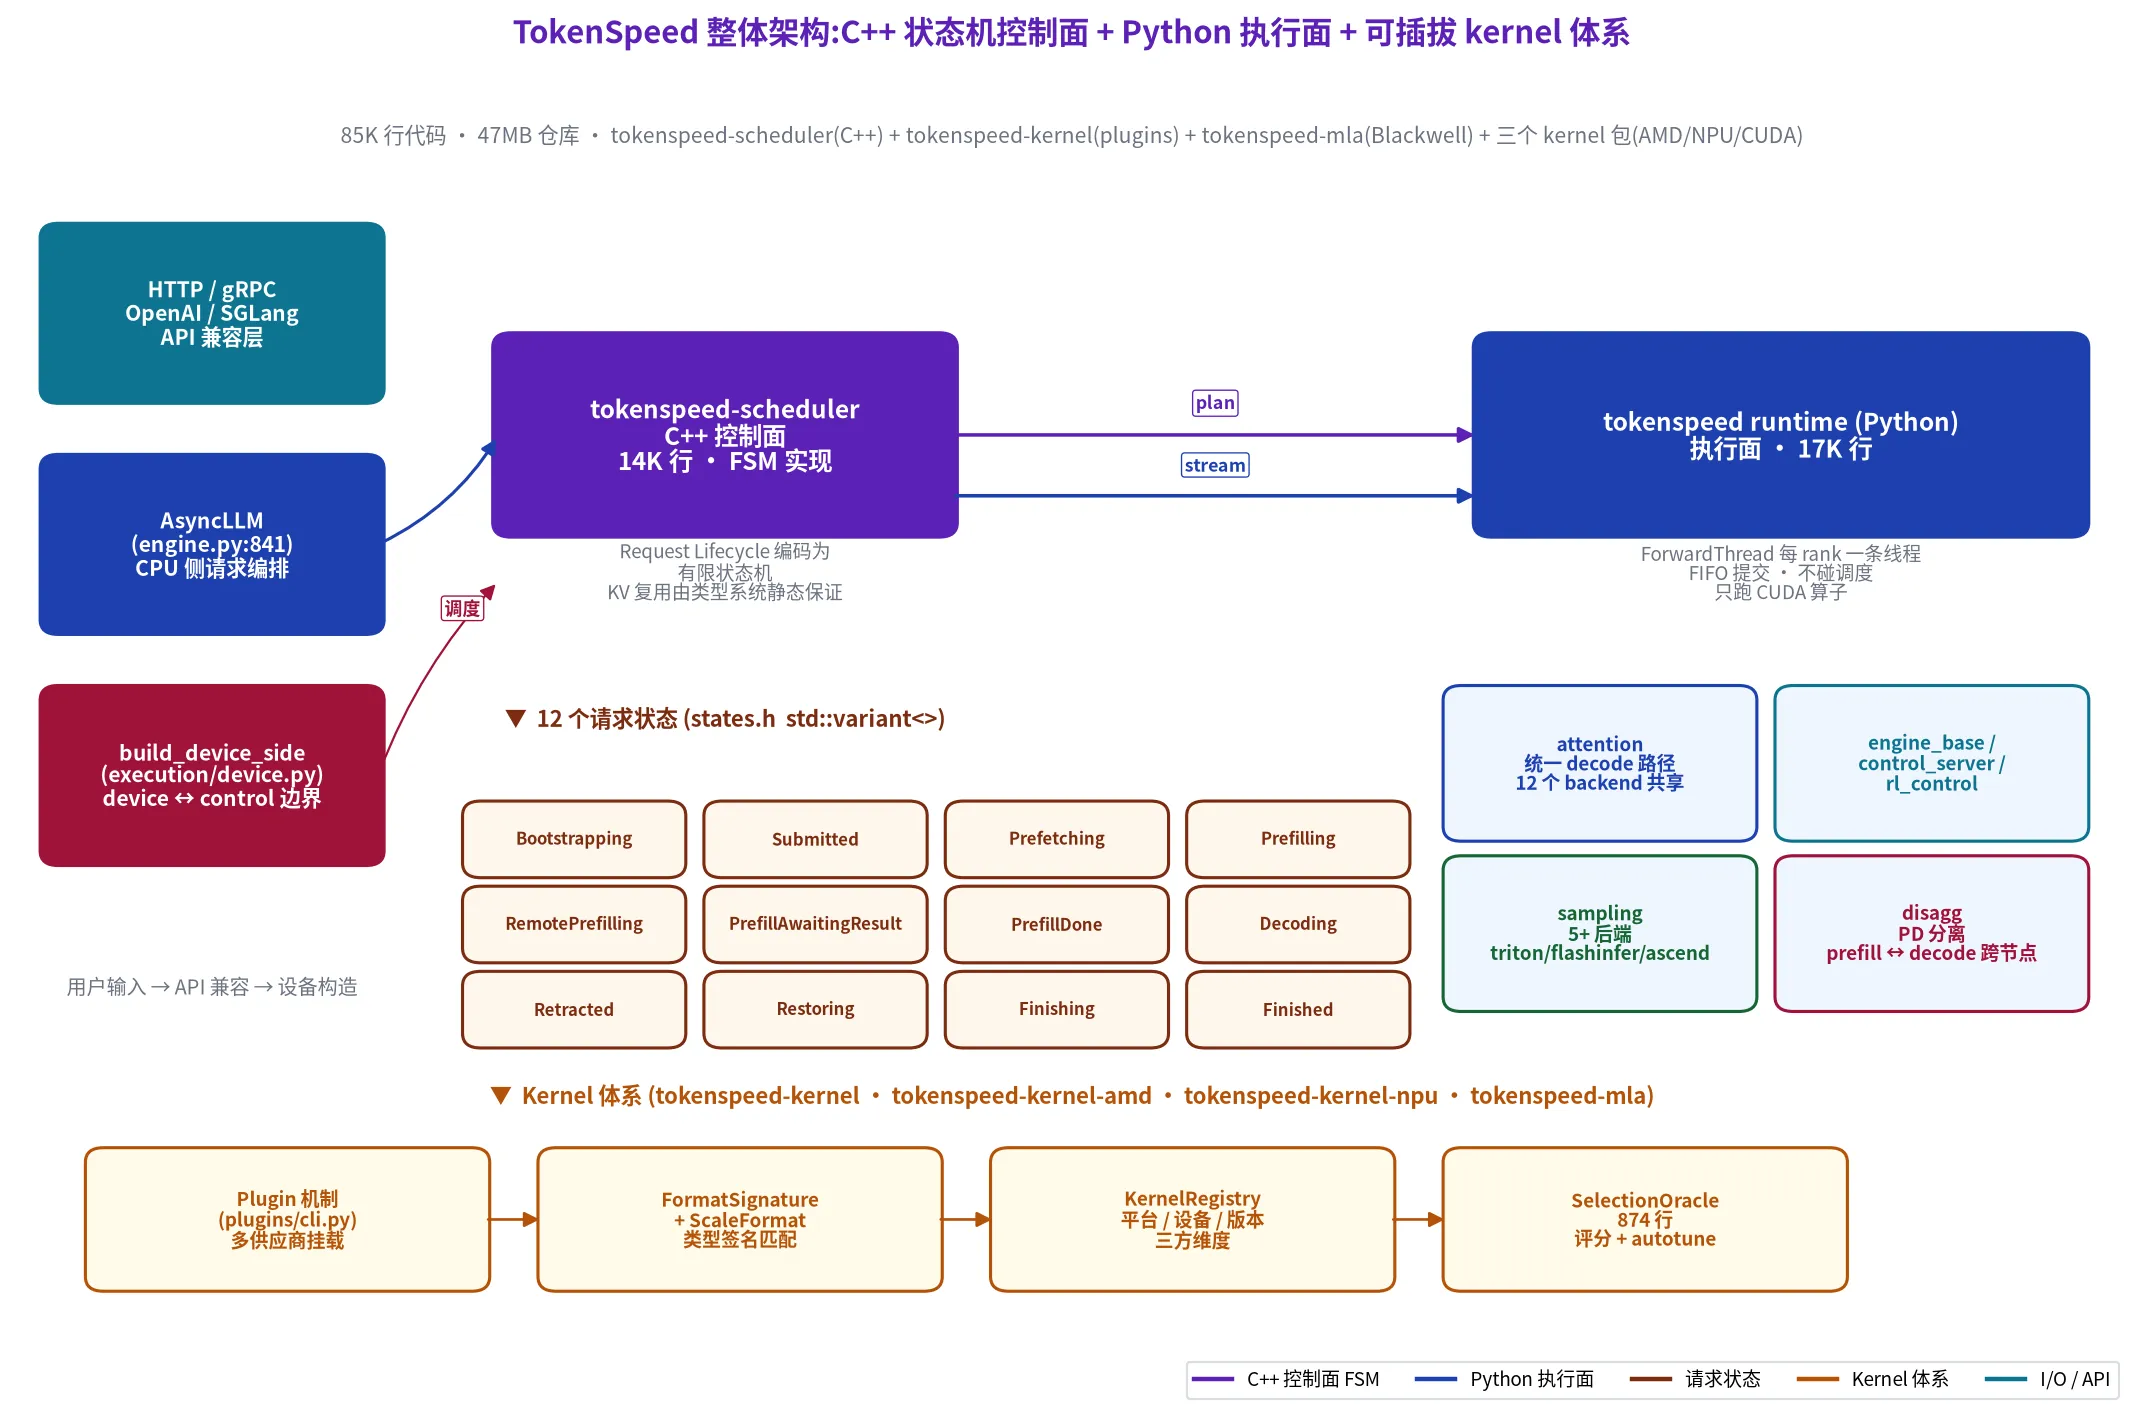
(图 0:整体架构。左边 HTTP/SGLang API 兼容层进入 AsyncLLM 编排;build_device_side 在启动时把 device 全部构造好,只通过 DeviceHandle 暴露给控制面;中间是 C++ 状态机 12 个态;右边 Python runtime 跑 attention / sampling / disagg / engine_base;最下面 kernel 体系按 plugin → signature → registry → oracle → autotune 五层流水线选 kernel。)
四个核心组件一句话总结:
- C++ 调度器(
tokenspeed-scheduler/,14K 行)—— 负责”什么时候、给哪个请求、什么资源”。输出Admitplan,里面是GroupDemand/RequestProgress/ReservePrefillDemands等等 - Python runtime(
python/tokenspeed/,17K 行)—— 负责”拿到 plan 之后怎么跑 forward”。每个 rank 一条ForwardThreadFIFO 提交,绝不碰调度 - Kernel 注册中心(
tokenspeed-kernel/)—— 平台无关的签名匹配 + 评分 + autotune,plugin 机制挂 NVIDIA/AMD/NPU 后端 - MLA decode kernel(
tokenspeed-mla/)—— SM100/103/107 上专攻 agentic workload 的低延迟 decode。bf16 / fp16 / fp8 三个输入路径,split-KV + reduce 双 kernel 流水线
4. 第二个取舍:把 KV 概念”逻辑世界”和”物理世界”分得干干净净#
docs/design/cache-concepts.md第一段就写:“Every*_granularityquantity andpage_sizeis measured in logical tokens.” 这条规则定了 19K 行文档的命名,让 85K 行代码不会因为混用”行 / 块 / 字节”而出 bug。
4.1 逻辑世界 — 只用 token 计数#
3 个核心量:
prefix_granularity—— 前缀哈希粒度,一个 chain hash 对应这么多 tokenblock_granularity—— 一个CacheBlock覆盖的 token 数,history 组的最小调度单位page_size—— history 组的rows_per_page × entry_stride_tokens
类型系统再分 3 类 KV 组的 attention kind:
| kind | 例子 | 字段规则 |
|---|---|---|
full_history (kFull) | 标准 KV cache | 声明 rows_per_page、entry_stride_tokens |
sliding_window (kSliding) | DeepSeek V4 的 SWA、compressor tails | 额外声明 sliding_window_tokens |
state (kState) | Mamba / KDA 状态 | 不能声明 row geometry,block_granularity 是 TypeError |
为什么 state 不能有 row geometry?因为 state 表只关心”走到 token X 时的状态”,它不关心 X 是怎么算出来的,更不关心”几行几页”。state 不是路由标签,是”这个 KV 表根本没有 page 概念”的物理事实。
CacheGroupSpec.__post_init__ 在 dataclass 构造期就拦住这类类型错误——又一个”编译期保证”的工程示范。
4.2 物理世界 — LCM block + BlockPool#
物理这边词汇更朴素:
CacheBlock—— 一个物理存储单元,attention-agnosticLCM block——CacheBlock的聚合,parent + child slotsBlockPool—— 持 FIFO 空块队列、per-bucket free-slot 计数、per-bucket 部分填充块 ordered set
一个 CacheBlock 可以被 KV-cache 注意力视图化,也可以被 state 注意力视图化。视图由消费者定义,不由 block 定义。这条规则让同一份物理存储能服务不同 backend,BlockPool 不用知道 backend 是什么。
BlockPool 还有一个反直觉的设计:per-group 几何在第一次使用时固定,之后不能改。包括”释放所有 block 再用”也不行。这避免了一个隐蔽的 bug 类:block_granularity 改了但某个调度的 block 还按旧尺寸引用,导致 page 错位。
4.3 kernel_page_size 是 kernel 私事,不是调度器的事#
docs/design/cache-concepts.md 明确点出来:
kernel_page_size— the token span of one attention-kernel page, a property of the kernel implementation, not of the scheduler.
为什么这条规则重要?因为 attention kernel(FlashMLA = 64、trtllm-mla ∈ {32, 64}、flexible kernels 选默认)的 page 跟调度器 page 经常不一样。如果你让两者共用一个量,要么 kernel 被绑死(无法选不同 page),要么调度器错位(算 prefix hit 时算错边界)。
所有 kernel page 几何集中在一个文件里:runtime/layers/attention/kernel_page_sizes.py。调度器需要时显式调这个 registry 拿,不会从 prefix_granularity “推导”。docs/design/cache-concepts.md 把这种”推导”明确定性为 category error。
5. 调度器:一个 FSM 走完 12 个态#
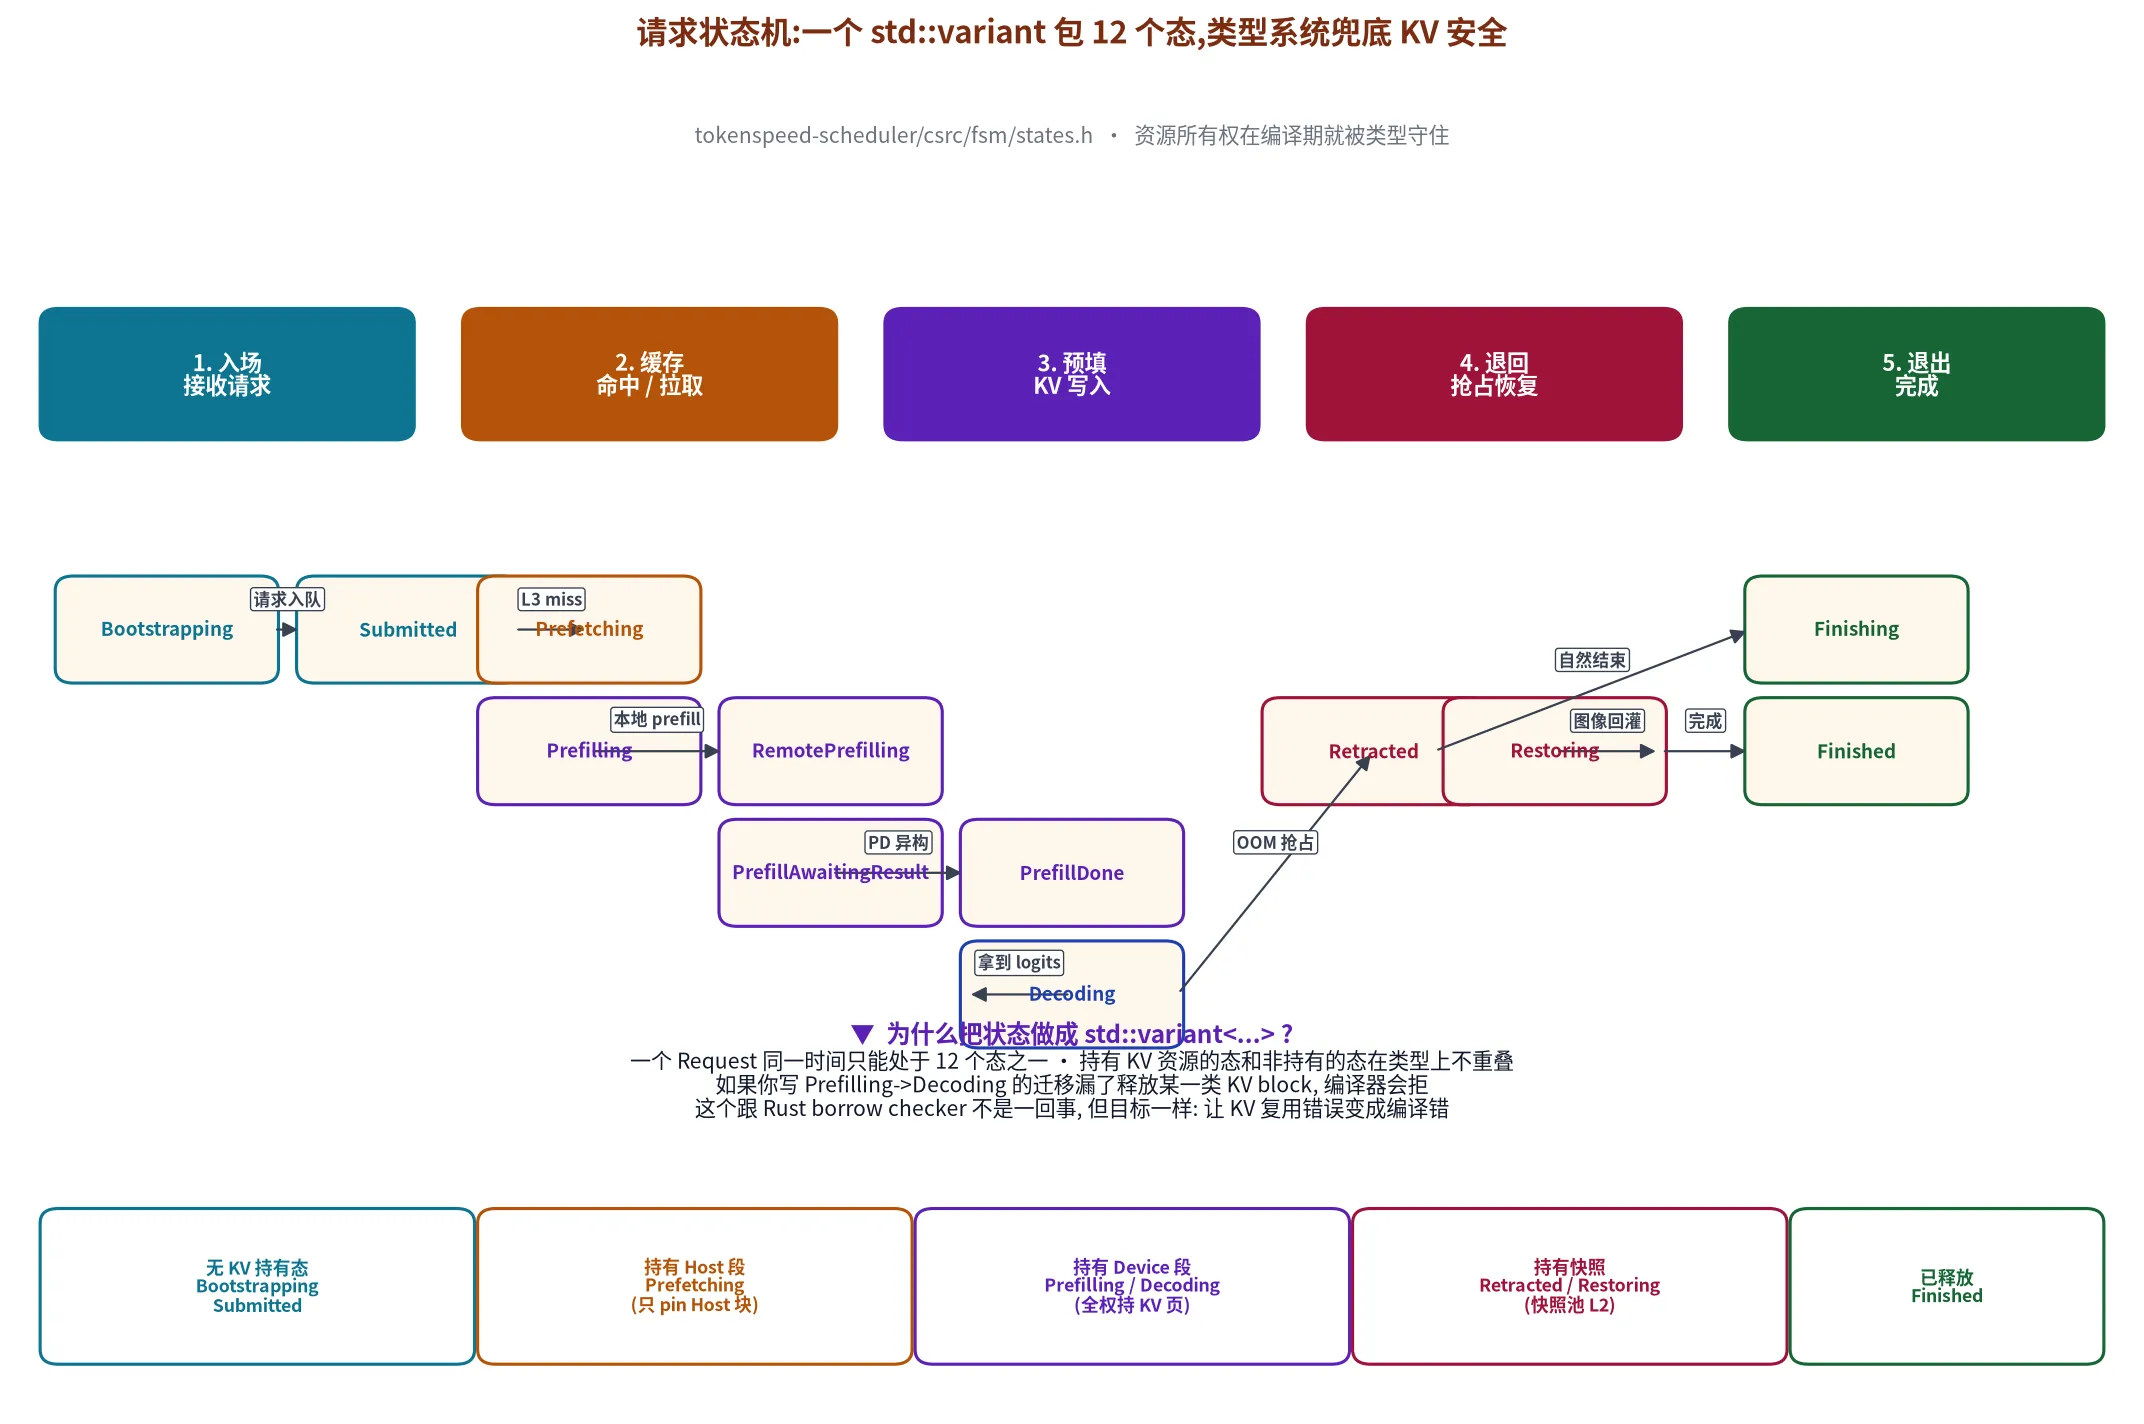
(图 1:12 个请求态。横轴是生命周期 5 阶段:入场 / 缓存命中 / 预填 / 退回 / 退出。每个态按”持有哪种资源”分到一档——无 KV 持有、只 pin Host、持 Device 全权、持 L2 快照、已释放。transition 边上写了触发原因:L3 miss / 本地 prefill / PD 异构 / OOM 抢占 / 拿到 logits / 图像回灌 / 自然结束。)
5.1 admission 是按 chunk 算的,不是按整 prompt#
scheduler.md 第一段是这个项目最反直觉的设计:
The scheduler schedules a prompt’s prefill in chunks bounded by
max_scheduled_tokens(--chunked-prefill-size). It admits capacity for the chunk being scheduled, never for the whole prompt.
为什么这么干?因为 agentic workload 经常 100K token 上下文,如果 admission 一次性预留整段,新进请求根本挤不进来(新进请求要等老请求把 prompt 全部算完才能开始)。按 chunk 算让 admission 永远只占”下一步要算的那一段”,其它请求有机会穿插。
代价是 KV ownership 变复杂:chunk 算到一半要中途换页(因为下一段要 publish 自己的 tail),这就引出了”junction cut”。
5.2 junction cut:跨 cache group 的”接缝”#
scheduler.md 讲了 junction 的精确语义:当 KV group 的命中 T 超过最长 state checkpoint T_s 时,第一个跨越 T_s 的 chunk 必须正好在 T 结束——这样它在那个位置留的 checkpoint 跟已经被 cache 的 KV 完全重合,下一个共享 prefix 的请求从 T 开始算起,所有 group 都能”自然对齐”。
这种”算到一半切一刀”的语义,普通 model 不会有——它只在”prefix 命中 + state 压缩 + 多 KV group 异构”这种混合场景下出现。读 scheduler.md 这一段,你会意识到:这不是代码写出来的,是对”为什么这里要切”的物理直觉写出来的。
5.3 OOM 抢占 + 快照恢复#
如果一个请求的 chunk 算完发现整个 system 容不下后面的 decode,该谁让位?TokenSpeed 用 retract-restore:
Retracted:把请求当前所有 KV page 写一份到 snapshot pool(L2 host memory)Restoring:有空间时,从 snapshot 读回 KV 重新算- 整个过程不重新算 logits——只搬运 KV,token 本身不动
这个设计的好处是:恢复时不浪费已算过的算力,代价是 snapshot pool 要占 host memory。对 agentic workload 这种”长 prompt 经常要等”是值得的。
6. Kernel 体系:一个签名匹配 + 评分 + autotune 的流水线#
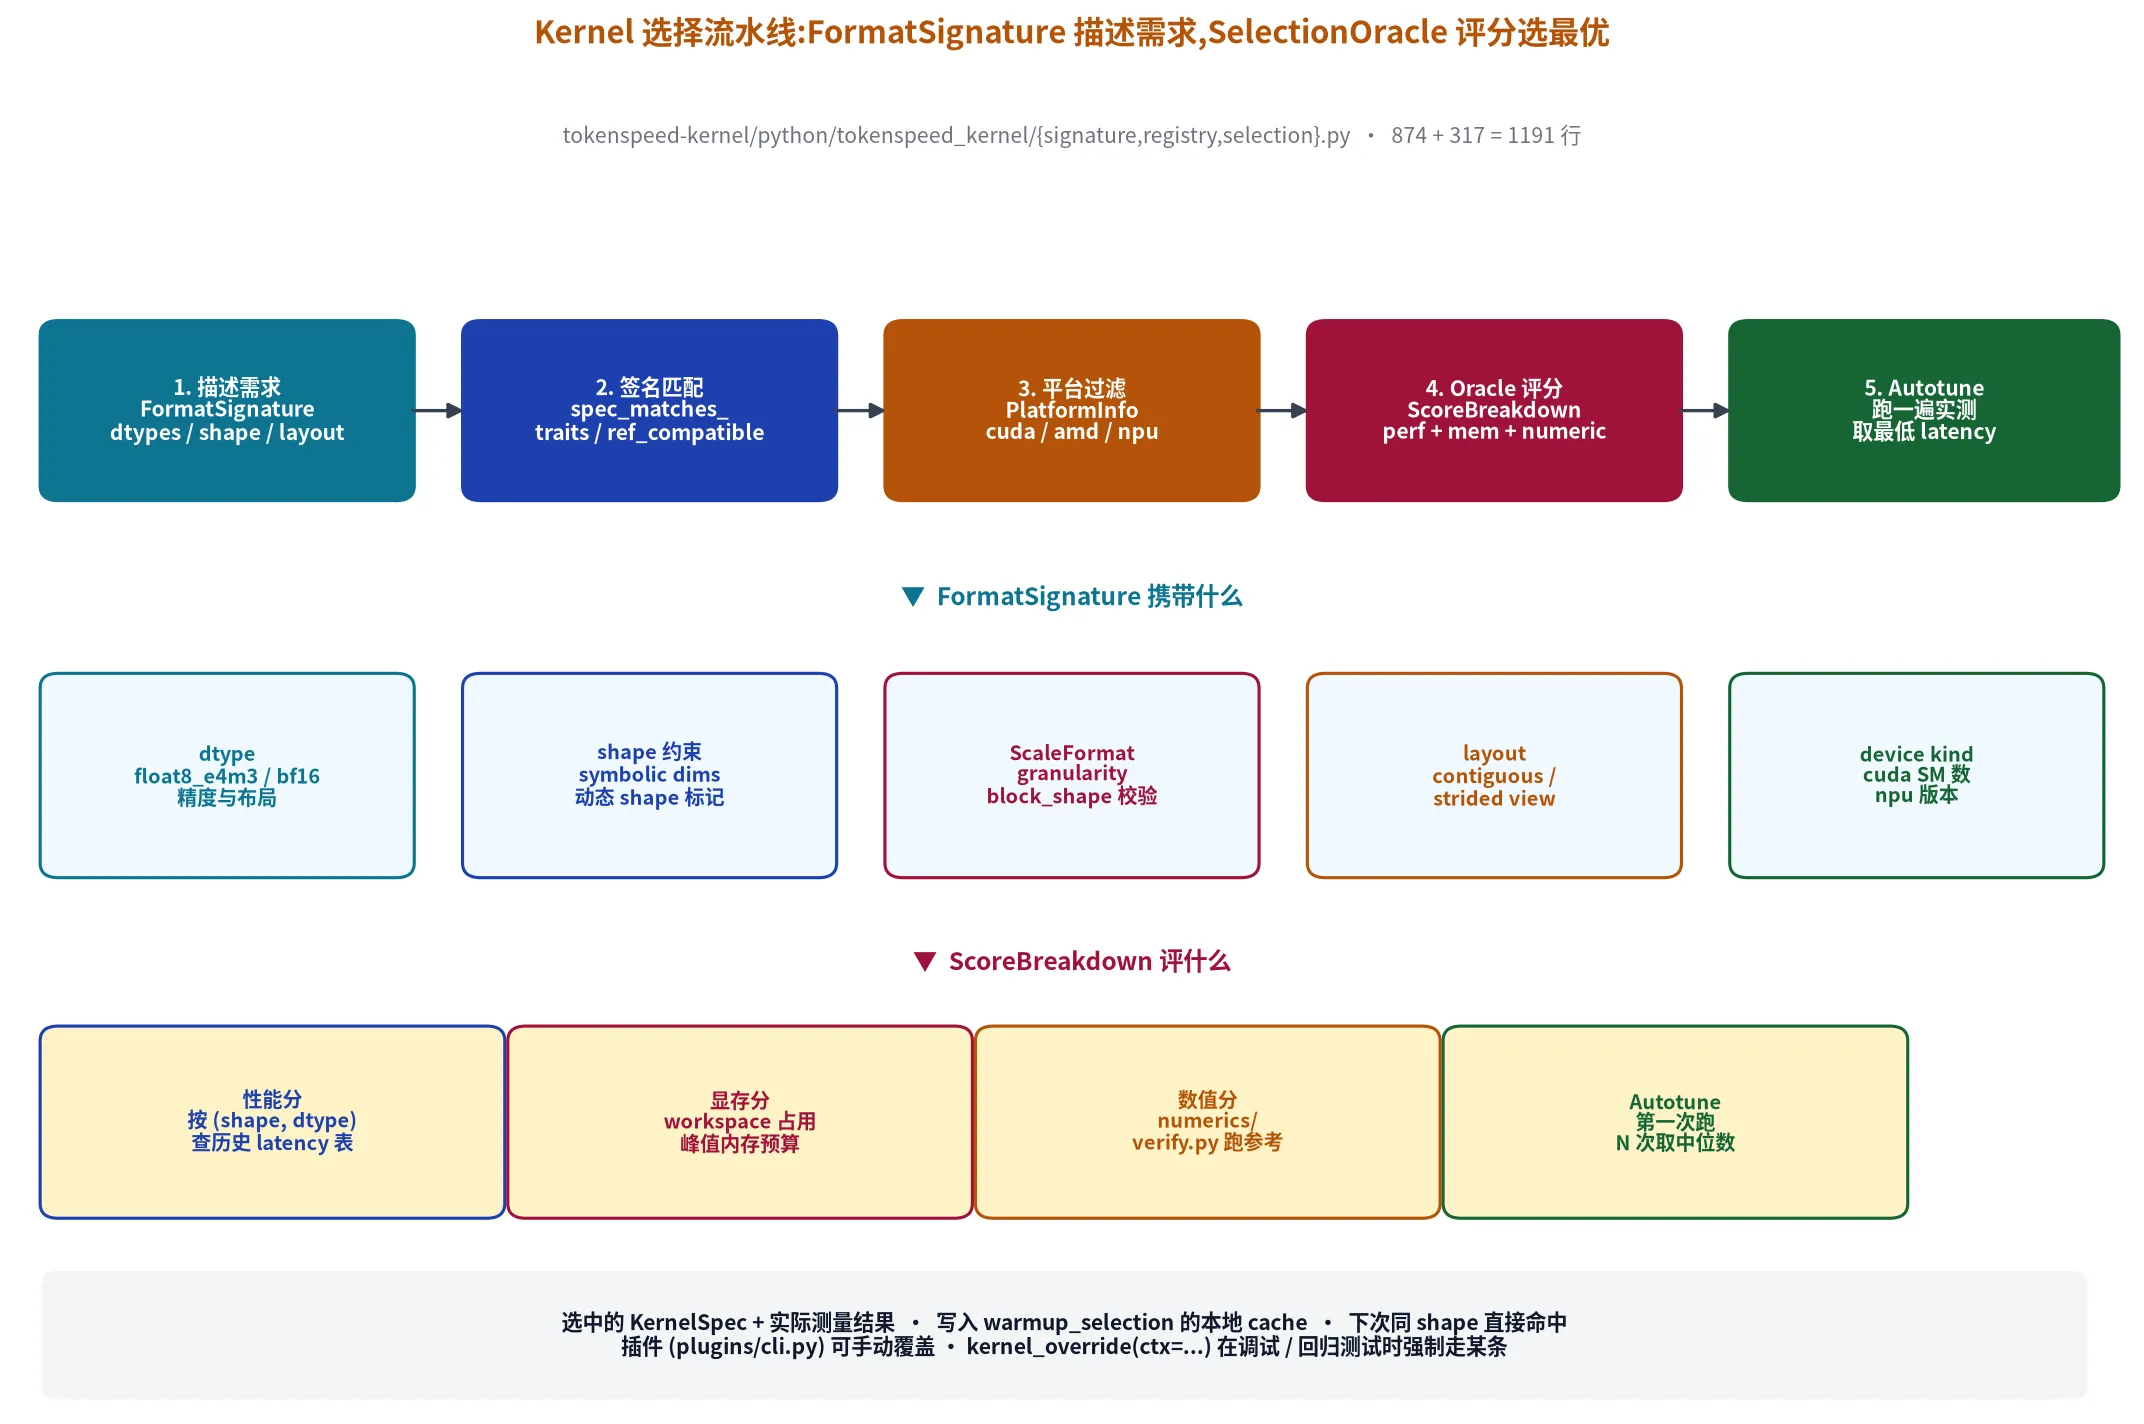
(图 2:kernel 选择流水线。FormatSignature 描述”我需要什么样的 kernel”;签名匹配阶段过滤出”spec compatible”的候选;平台过滤根据 CUDA SM 数 / AMD GPU 类型 / NPU 版本再筛;Oracle 评分按性能 / 显存 / 数值三个维度打分;最后 autotune 跑 N 次取中位数,写入 warmup cache。)
6.1 FormatSignature:把”我需要什么”形式化#
tokenspeed-kernel/python/tokenspeed_kernel/signature.py 317 行,核心是三个 dataclass:
ScaleFormat—— 描述 scale 侧的物理 metadata(存储 dtype / 粒度 / block_shape)TensorFormat—— 描述张量本身的物理属性FormatSignature—— 把张量 + 它的 scale 拼起来
ScaleFormat.__post_init__ 又一次把”不合法组合”挡在构造期:
if self.granularity == "block":
    if self.block_shape is not None and self.dynamic_block_shape:
        raise ValueError("block_shape and dynamic_block_shape are mutually exclusive")
    if self.block_shape is None and not self.dynamic_block_shape:
raise ValueError("block scale format requires block_shape or dynamic_block_shape=True")把”block scale 必须有 block_shape”这种约束用代码写出来,等于把文档里的”应该”变成编译期的”必须”。后续 selection 阶段拿到的 signature 都是合法的,不会出现”半填的 block scale”在 autotune 时崩。
6.2 SelectionOracle:874 行,值最高的一段#
selection.py 874 行,做的事情分四步:
- 平台过滤——用
current_platform(platform.py)拿当前设备 SM 数 / GPU 类型 / driver 版本,只保留这个平台能跑的 kernel - spec 匹配——
spec_matches_traits/ref_compatible_with_spec跑两轮过滤,第一轮按”我能处理的 shape”过,第二轮按”我能处理的 layout”过 - Oracle 评分——
ScoreBreakdown把候选 kernel 按”性能 + 显存 + 数值稳定性”三个维度打分,每个维度查历史 latency 表 + 算 workspace 占用 + 跑 numerics 验证 - Autotune——第一次跑这个 (shape, dtype) 组合时,实际跑 N 次,取中位数,写进 warmup cache,下次直接命中
一个看似”全自动化”的 system,真正的核心其实是
ScoreBreakdown的历史 latency 表怎么维护——docs/design/numerics.md讲了这个表怎么跟numerics/verify.py配合,以及为什么不能完全信 autotune(autotune 只能告诉你”这个 kernel 在这台机器上多快”,不能告诉你”这个 kernel 的输出对不对”)。
6.3 plugin 机制:多供应商零代码#
plugins/cli.py 让你写 tokenspeed-kernel --register ./my_backend 就能挂一个后端。这个设计在 vLLM / TRT-LLM 都不存在——它们都是 fork + PR 模式加新后端。plugin 不只是写代码方便,更是给商业公司用闭源后端留的接口(NVIDIA / AMD 自己写闭源 kernel 卖,下游不 fork 也能用)。
7. MLA decode:一个跟 TRT-LLM 反着来的设计#
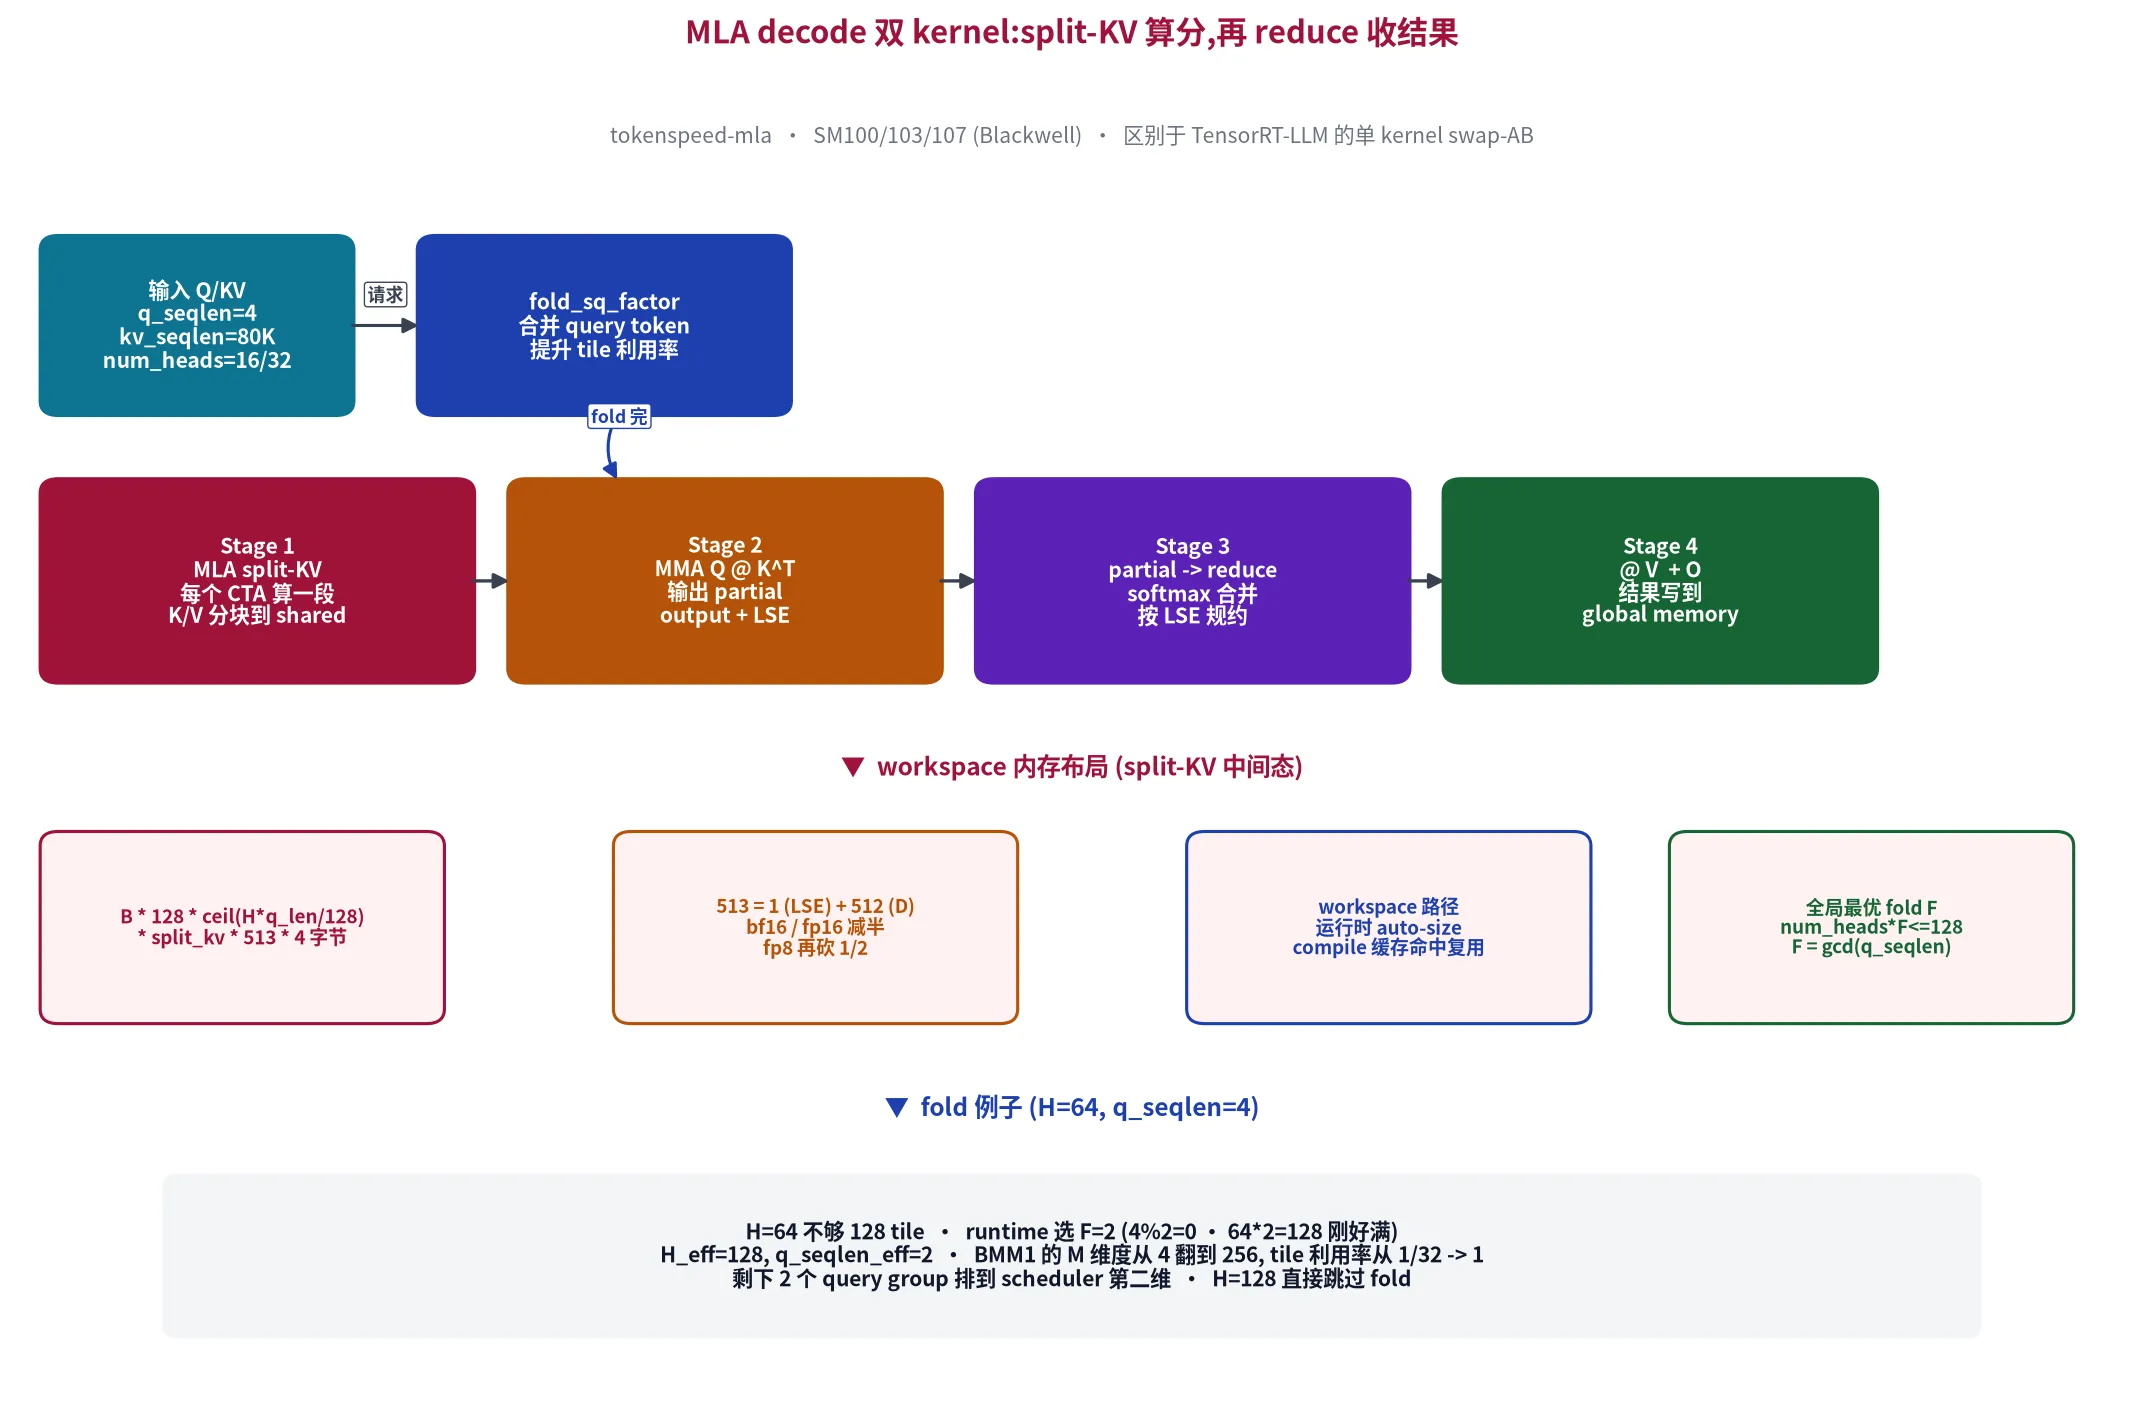
(图 3:MLA decode 双 kernel 流水线。Stage 1 把 K/V 沿 split_kv 维度分块;Stage 2 每个 CTA 算自己的 partial output + LSE;Stage 3 按 LSE 规约合并 partial;Stage 4 乘 V 写回。中间 workspace 内存布局按 B * 128 * ceil(H*q_len/128) * split_kv * 513 * 4 算。底部 fold 例子:H=64 + q_seqlen=4 → F=2 → H_eff=128 + q_seqlen_eff=2,BMM1 的 M 维度从 4 翻到 256。)
7.1 双 kernel vs 单 kernel swap-AB#
tokenspeed-mla/README.md 直说:
TensorRT-LLM uses a single kernel for MLA decode, which appears to adopt a swap-AB strategy in the tested cases. In contrast, TokenSpeed’s MLA decode kernel uses a two-kernel implementation: one kernel computes the MLA decode with split-KV, and a second kernel performs the reduction of the split-KV partial results.
swap-AB 的思路是:decode 的 Q 小 K/V 大,如果把 Q 转置,可以让 QK^T 变 K^T Q,矩阵规模更适合 GEMM。问题是 swap-AB 只对”Q 极小”的情况划算,而且要重新排布 layout,小 batch 时反而慢。
TokenSpeed 走的是 split-KV:把 K/V 沿 split 维度切,每个 CTA 算一段,partial 结果 + LSE 写 workspace,第二个 kernel 拿所有 partial 按 LSE 规约。这个套路 cublas / cutlass 早就在用,但 TokenSpeed 的差异是——auto split-KV:ceil(H * q_len / 128) 自动算 split 数,workspace 内存按这个算下来,完全跟着 query tile 数走。
7.2 fold_sq_factor:小 head 的妙手#
如果 num_heads=64(MLA 常见),Q 的 head 维只有 64,凑不满 128 的 tile,BMM1 浪费一半。这个问题别的项目一般用”虚拟 head”补 0 解决,TokenSpeed 用了一个更狠的招:fold query token 进 head 维。
F = largest factor such that q_seqlen % F == 0 and num_heads * F <= 128
H_eff = num_heads * F
q_seqlen_eff = q_seqlen / F例子:H=64, q_seqlen=4,选 F=2(因为 4%2==0 且 64*2=128 刚好满),把 2 个 query token 折进 head 维,H_eff=128, q_seqlen_eff=2。BMM1 的 M 维度从 4 翻到 256,利用率从 1/32 -> 1。
这种”runtime 算 fold 因子”的思路很 ugly 但很有效——它把”head 太少”这个数学硬伤用 fold 暂时解决,代价是 layout 多一步 tensor view(不算真正的 packing kernel,所以没额外开销)。
7.3 SM107 / Blackwell 上的 PDL#
Prefill kernel 支持 PDL(Programmatic Dependent Launch,Hopper 引入,Blackwell 完善):第一个 kernel 启动第二个 kernel 之前不阻塞,让第二个 kernel 在第一个还没完全结束时就 preload 指令。PDL 对 decode 这种”每个 step 都重新启动 kernel”的场景特别有用——省下 2-5μs 的 launch overhead,听起来小,agentic workload 每秒要触发几十次。
tokenspeed-mla 在 SM100 / SM103 / SM107 三档都支持,需要 CuTe DSL 4.8+。decode 编译 + GPU 回归测试会拒绝 CuTe DSL warning——这种”编译器警告当错误”是 k8s 社区 / nvidia 工程团队都强调的纪律,TokenSpeed 直接落到了 CI。
8. 一些让我印象深的”不漂亮但对”的设计#
8.1 unified decode path:12 个 backend 共享 1 套 metadata 路径#
docs/design/unified_path.md 讲了 TokenSpeed 早年的痛:每个 attention backend 自己有 eager / capture / replay 三套 decode metadata 实现,12 个 backend × 2 个路径 = 24 套,drift 永远修不完。统一后只剩一个 AttentionBackend.refresh_decode_metadata(),capture / replay / eager 三种调用都走它,差别只在 for_graph_replay=True/False 和 actual_bs。
The eager arm inside
init_forward_metadatathat built fresh tensors per step, a capture arm that allocated persistent buffers, and a replay arm that refreshed them in place. Twelve backends times two live decode paths drifted continuously
12 个 backend × 2 个路径 → drift continuously 五个字,说出了所有写过”多 backend 兼容代码”的人的心声。
8.2 关键 extend 输入无默认值#
extend_seq_lens, extend_seq_lens_cpu,
extend_prefix_lens, extend_prefix_lens_cpu,
extend_with_prefix: bool,
query_shard: QueryShardPlan | None,unified_path.md 明文写:No default values,runner 在 idle replay 时也要传 [:0] 的空 slice。这条规则是为了防止”= False 默认值吞掉 extend_with_prefix”——docs/design/unified_path.md 提到这是个真实发生过的 bug:一个 composite 用 **kwargs 收参数,默认值把 extend_with_prefix 吞了,FlashMLA 拿到一个被截断的 batch 还按 ragged prefill 算——结果是错的。默认值是隐式的协议,显式传是显式的协议。
8.3 capacity vs performance 分开#
max_capture_bs(max_cudagraph_capture_size 上限)和 max_decode_bs(max_num_seqs // dp_size)是两个不同的量。max_capture_bs 是 capture ladder 的最大 batch,max_decode_bs 是持久 buffer 的容量。TokenSpeed 明确说:ladder 是 performance subset,不是 capacity limit。
这条规则防止一个常见的设计错误:有人把 max_cudagraph_capture_size 当成”batch 上限”,结果 batch 大于 capture 上限时降级到 eager,但 eager 的 buffer 又只够 capture batch,直接 OOM。
9. 跟同类对比#
读到这你可能想问,TokenSpeed 跟 vLLM / TRT-LLM 比,到底快多少、值不值得用?
- 性能 —— 同一张 B200,TokenSpeed vs TRT-LLM 的 Pareto 曲线 README 里贴了。结论是agentic workload 下 TokenSpeed 略胜(尤其高并发 + 短 decode 场景),非 agentic 长 context 上两者差距很小
- 易用性 —— OpenAI / SGLang API 兼容,启动命令
tokenspeed serve model/ --port 8000就跑。模型支持列表(README + recipes/)有 Qwen3.8 / Kimi K3 / GLM 5.3 / Inkling / DeepSeek V4,基本覆盖 2026 主流 frontier - 跨平台 —— 三个 kernel 包(NVIDIA / AMD / NPU)分开发布,可单独 pip install。NVIDIA 上默认 CUDA 13 + CuTe DSL 4.8+
- 治理 —— LightSeek Foundation(非营利)+ PyTorch Foundation 收录,代码许可 Apache 2.0 + MIT 双重,商业公司可控(没 GPL 污染)
最大的 trade-off:学习曲线陡。C++ 调度器 + Python runtime + kernel 注册三套都要懂,新加一个模型支持可能要改三个地方。SGLang / vLLM 改一个 attention 改 Python 文件就够,TokenSpeed 要重编 C++。
10. 复用价值最高的 5 条#
读完 19K 行设计文档 + 85K 行代码,我觉得这 5 条经验放之四海而皆准:
- 控制面 / 执行面分离,并且只在 device handle 暴露”能力”——vLLM / SGLang 都有 Python 调度器,但它们把 backend 对象直接暴露给调度器,导致 device API surface 跟着改。TokenSpeed 通过
DeviceHandle把”能问 device 做什么”做成显式 named methods,API surface 永远受控 - 状态机 + 类型系统承担资源所有权——C++ variant 12 个态、Python dataclass
__post_init__验合法组合,用编译期替代单元测试去抓”忘了释放 KV”。这条对所有”长生命周期 + 资源复用”的 system 适用(cache server / message queue / DB connection pool) - 逻辑世界 / 物理世界分词——
prefix_granularity/block_granularity/page_size都用 token,CacheBlock/LCM block用物理存储。两层词汇绝对不混用。文档里明文写”派生是 category error”,然后代码里写 compiler check - kernel 注册走”签名 + 评分 + autotune”流水线——新加一个 backend 不要 fork + PR,写一个 plugin 挂上,签名匹配 + 评分 + 跑一遍就完事。这条对所有”多供应商适配”的 system 适用(数据库 driver / GPU kernel / NPU operator)
- 关键协议字段不要默认值——
extend_with_prefix: bool这种,= False默认值能吞掉 bug,显式传[:0]slice 反而更安全。这条对所有”控制面 ↔ 数据面”接口适用
11. 写在最后#
读 TokenSpeed 之前,我对”LLM 推理引擎”的认知停留在”PyTorch + paged attention + CUDA graph”。
读完我才意识到:当你的 workload 从”batch inference”变成”agentic / interactive”时,调度器的复杂度会上一个数量级——preempt 频率、KV 复用率、PD 异构、长 prompt prefix hit、tree speculation,每多一个就多一类 bug。TokenSpeed 的解法不是”写更多测试去抓 bug”,而是用类型系统让那些 bug 在编译期就过不了。
如果你正在写自己的推理引擎 / 调度器 / cache server,强烈建议读两遍 docs/design/event-loop.md 和 docs/design/cache-concepts.md,然后动手画一遍 12 个态 + 资源所有权表。你会发现很多”为什么这个 bug 修不完”的问题,本质上是”控制面和执行面没分开”或者”逻辑词汇和物理词汇混用”。
12. 仓库信息(可一键复现)#
# 仓库
https://github.com/lightseekorg/tokenspeed
git clone https://github.com/lightseekorg/tokenspeed.git

# 子包分别安装
pip install tokenspeed-kernel
pip install tokenspeed-kernel-amd    # AMD GPU
pip install tokenspeed-kernel-npu    # NPU
pip install tokenspeed-mla           # Blackwell MLA kernels
pip install tokenspeed               # 整个推理引擎(包含 C++ scheduler wheel)

# 启动服务
tokenspeed serve /path/to/Qwen3.8 --port 8000# 关键路径
tokenspeed-scheduler/ # C++ 控制面,14K 行
csrc/fsm/ # 12 状态 variant
csrc/scheduler/ # 调度逻辑
python/tokenspeed/ # Python runtime,17K 行
runtime/entrypoints/engine.py # AsyncLLM 主入口,841 行
runtime/attention/backends/ # 12 个 attention backend
runtime/sampling/backends/ # 5+ sampling 后端
tokenspeed-kernel/ # kernel 注册中心
python/tokenspeed_kernel/
signature.py # 317 行 FormatSignature
registry.py # KernelRegistry
selection.py # 874 行 SelectionOracle
tokenspeed-mla/ # Blackwell MLA decode
README.md # 双 kernel 设计 + fold_sq_factor
docs/design/ # 6 篇设计文档,19K 行参考:
- TokenSpeed README ↗ —— 68KB
- PyTorch Foundation Q3 Ecosystem ↗ —— 点名提到 control plane / execution plane 拆法
- LightSeek Blog: TokenSpeed-MLA 2 ↗ —— Vera Rubin MLA 2 数据
- LightSeek Blog: 685 TPS Qwen3.8-Flash-Next ↗ —— GB300 性能
- AMD Blog: Kimi K3 on MI355X ↗ —— AMD 视角的拆解
- PyTorch Blog: TokenSpeed-Kernel Deep Dive ↗ —— kernel 注册中心的设计动机