异构 LLM 推理流水线:GPipe 公式为什么总是把吞吐算高两倍#
论文 arXiv:2610.21815 ↗ · Zhu Wenbo (烟台文化旅游职业学院) 配套实现 ytidb6688/heteropipe ↗ ·
pip install heteropipe· 纯标准库、零依赖、132 行测试 2026-10-15 提交 v1,515 KB,18 页正文 + 6 张图 + 7 段可复现脚本
这篇不是又一篇”我们搭了个新推理引擎”的工程文。Zhu Wenbo 一个人做的是一件更朴素也更扎实的事:把 micro-batch 流水线在三种通信范式下的 makespan 一次性给出精确的 closed form,然后用这把尺子回头量 GPipe 那条用了七年的 T = S + M − 1 公式,严格证明它在异构集群下会系统性地把吞吐算高两倍,并把这个偏置拆成”同质高估”与”通信低估”两项可以分别对待的部分,最后给出一道不等式决定你该不该继续调链路。
我读完之后留下的最深印象是:这个工作的贡献不在于”新下界”,而在于”那串 classical critical-path 不等式,落到 LLM 异构推理上到底意味着什么”。下面按”真问题 → 严格结果 → 工程含义 → 还能做什么”重新写一遍,所有公式数字都能在 heteropipe 这个 14 个函数的小库里现成跑出来对得上。
0. 先把数字摆出来#
- 论文主线:3 个定理 + 5 个推论 + 2 个命题 + 1 个 crossover,覆盖 communication-free / asynchronous / blocking 三种通信范式
- 验证强度:11 个手工配置 + 1.6 × 10⁵ 次随机 fuzz,所有点相对递推式最大相对误差 < 10⁻⁹,零反例
- 真实数据:论文作者维护的 LLM 推理网关 UIG,2026-09-03 → 2026-10-04 共 8,571 条完成请求,每条带 host / model / compute duration / end-to-end 时长,数据在 GitHub repo 的
data/real_vs_formula.csv里以 CC-BY-4.0 发布 - 实测集群:RTX 5090 Laptop (Blackwell, 24GB GDDR7) / 双 RTX 3090 (Ampere, 24GB GDDR6X) / GTX 1070 (Pascal, 8GB GDDR5, 无 tensor core) —— 三代同堂,其中 GTX 1070 没有 tensor core,compute-bound 时跟 3090 差出 3 个数量级
- 配套实现:14 个 closed-form 函数、纯标准库、132 行测试自带轻量 runner、CLI + JSON、附两个 dependency-free 浏览器计算器
- 本文论点一句话版:在异构集群下,经典 GPipe 公式对 makespan 的偏置在 M=1 时可以到 166.7%;这个偏置跟 batch 大小 M 无关,只是 fill 阶段的一笔常数开销;通信能不能再优化,则取决于一道
d_s > τ_max − τ_s的不等式,过了这个阈值,链路延迟就从加性常数变成吞吐量瓶颈
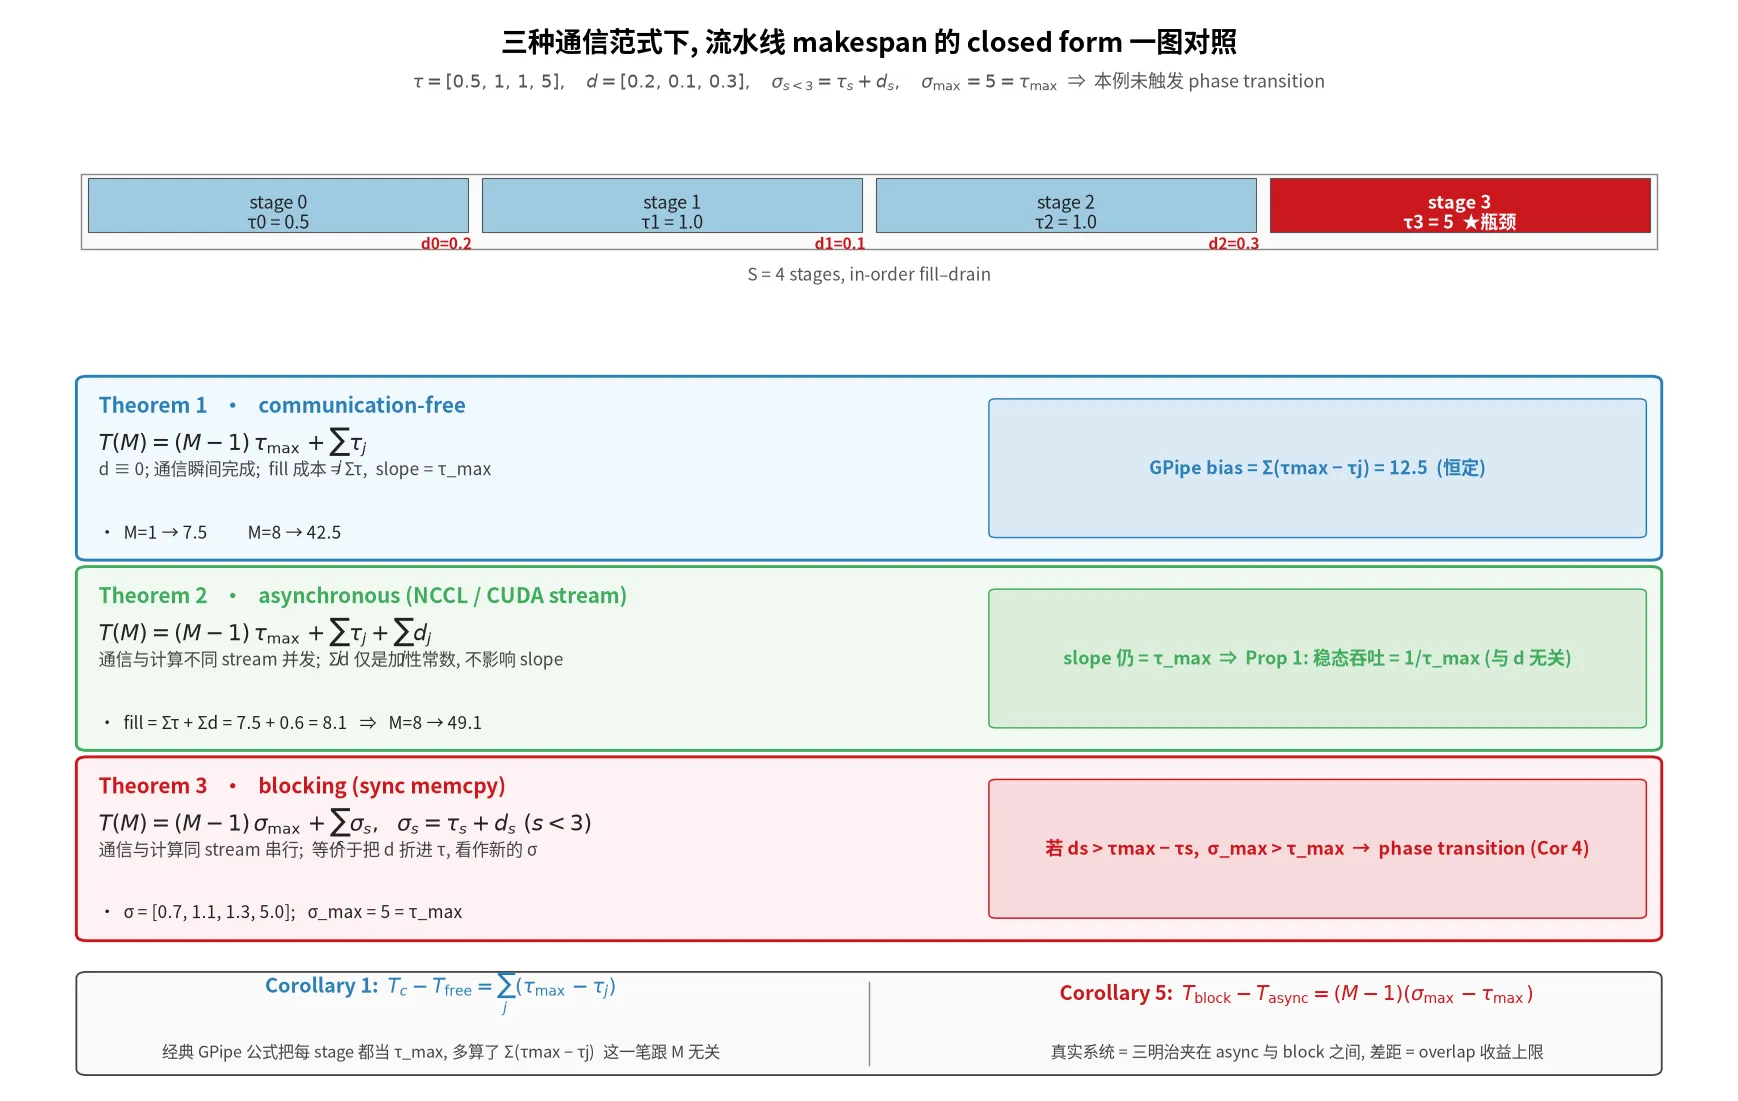
fig0 · 三种通信范式与 closed-form makespan 一图对照
1. 它要解决的真问题#
Pipeline parallelism (PP) 是 LLM 推理的事实标准 —— 模型权重装不下单卡显存,就沿层切成多个 stage,每张卡吃一段,前后接力。当前几乎所有系统(vLLM / SGLang / TensorRT-LLM / TGI / DeepSpeed-Inference / DistServe)背后的 mental model 都来自 GPipe 2019 那条公式:
S 个 stage 每个 stage 处理一个 micro-batch 用时都是 τ(同质假设),M 个 micro-batch 跑下来的总时长。这条公式加上 (S-1)/(S+M-1) 的 bubble ratio,过去七年是分析 PP 系统吞吐的默认语言。
现实里这条公式的两个前提几乎从不成立:
第一,集群是异构的。 一台 cluster 里塞 RTX 5090 / 3090 / GTX 1070 是常见操作,尤其单机推理代理网关。异构的程度取决于哪个资源被 bound:
- memory-bound 的 decode:差异由带宽决定 —— 5090 是 896 GB/s, 3090 是 936 GB/s,1070 是 256 GB/s,大约 3.5× 倍率
- compute-bound 的 prefill:差异由 tensor core 决定 —— 没有 tensor core 的 GTX 1070 FP16 只有 0.1 TFLOPS,RTX 3090 是 142 TFLOPS,差出三个数量级
不同 stage 拿到不同卡,τⱼ 之间可以差一个数量级甚至更多。GPipe 公式假设所有 τ 相等,这一条就不成立。
第二,通信不是零开销也不是必然阻塞。 Stage 之间需要传 activation / KV cache,这条链路可以是:
- synchronous blocking:旧式
cudaMemcpy,stage 必须等传输完才能算下一个 batch,等价于把 d 折进 τ - asynchronous:现代 NCCL /
cudaMemcpyAsync/ CUDA stream 风格,通信在另一条 stream 上跟计算并发,d 与 τ 在时间轴上重叠
这两种行为在 makespan 上是质差,不是量差。GPipe 公式完全没考虑通信,默认 d ≡ 0,这是第二处不成立。
实际系统的 makespan 是上面这种 schedule 的关键路径长度 —— 一个在 flow-shop scheduling 里被研究透了 70 年的量 [2,3,4]。但 LLM 推理系统的论文大多用渐近或启发式处理它,把精确的 closed form 留在经典教科书里没有具体落到 PP 推理场景。
Zhu Wenbo 这篇的工作就做这一件事:把那个经典 critical-path 公式针对异构 LLM 推理实例化一次,用 sandwich 证明给出 matching 上界下界,然后回头量 GPipe 公式的偏置、给出偏置分解、给出相变条件、给出真实系统的可计算 sandwich。
2. 三个定理(Theorem 1 / 2 / 3)#
系统模型:S 个 stage 沿一条链串行处理 M 个 micro-batch,fill–drain 顺序入场,buffer 无限大,无 backward 依赖(A1–A5 五条假设在论文 §2 写明)。stage j 处理一个 micro-batch 用时 τⱼ,stage j → j+1 之间传送用时 dⱼ。
2.1 Theorem 1:communication-free 下的精确 makespan#
把这条跟 GPipe 的 (S + M − 1) τ_max 摆一起看:GPipe 把所有 τⱼ 都当 τ_max,因此多算了 S · τ_max − Στⱼ = Σ(τ_max − τⱼ) =: B,这就是后文的 homogeneity bias。
证明是 sandwich:下界看关键路径必须经过瓶颈 stage j* 串行处理 M 个 batch 的 M · τ_max,加上第一个 batch 走完上游 i<j* τᵢ 与最后一个 batch 走完下游 i>j* τᵢ 这两段;上界给出一个 ASAP 调度,强归纳证明下界可达。两个方向严格贴齐,公式精确成立。
2.2 Theorem 2:异步通信下的精确 makespan#
异步下通信与计算在不同 CUDA stream 上并发,Σd 只作为加性常数进入 makespan,slope 仍然是 τ_max,跟 d 无关。
这意味着 Proposition 1 的事情:稳态吞吐 M/T(M) → 1/τ_max 是 set by 瓶颈 stage 单决定的,跟链路多快慢半毛钱关系没有。这是一个对工程优化顺序的强约束 —— 调链路带宽在稳态吞吐上无效。
2.3 Theorem 3:阻塞通信下的精确 makespan#
定义 σₛ = τₛ + dₛ (s < S−1) 和 σ_{S−1} = τ_{S−1}(末 stage 不发),有:
阻塞通信把 d 折进 τ,等价于把 stage 时间换成新的 σₛ,递归式跟 Theorem 1 同构,所以 Theorem 1 的 closed form 逐字适用。
阻塞的特殊性是:Σd 现在可能进入稳态斜率。Corollary 4 给出相变条件:
这道不等式的右边 τ_max − τ_s 叫做 stage s 的 compute slack。一旦某条链路 d_s 超过它所在 stage 的 compute slack,通信就从加性常数升格成 throughput bottleneck。slack 最小的 stage 是瓶颈 stage 的紧邻下家,所以”瓶颈 stage 之后那条慢链路”是第一个出事的点。
3. 经典 GPipe 公式到底偏了多少(Corollary 1 + 3)#
回到第一性原理:GPipe 公式假设所有 τ 相等,还假设 d = 0。把它跟 Theorem 2 一减:
偏置被严格拆成两项,符号可以相反。无通信的纯异构情况下,只有 homogeneity 一项,GPipe 永远高估 makespan;引入通信以后,如果 Σd 超过 Σ(τ_max − τⱼ),GPipe 反而低估 makespan(同质乐观覆盖了通信忽略)。
最反直觉的一点:homogeneity overestimate 跟 M 无关。把它写成 B = Σ(τ_max − τⱼ),这是常数。在 M=1 时它对相对误差的放大最严重 —— 论文 §3.1 那个 illustrative 例子:
τ = [0.5, 1, 1, 5] (RTX 5090 / 3090 / 3090 / GTX 1070, 10× 不平衡) M=1: T_real = 7.5, T_GPipe = 20, GPipe 高估 166.7% M=8: T_real = 42.5, T_GPipe = 55, GPipe 高估 29.4% 绝对差 = 12.5,恒定
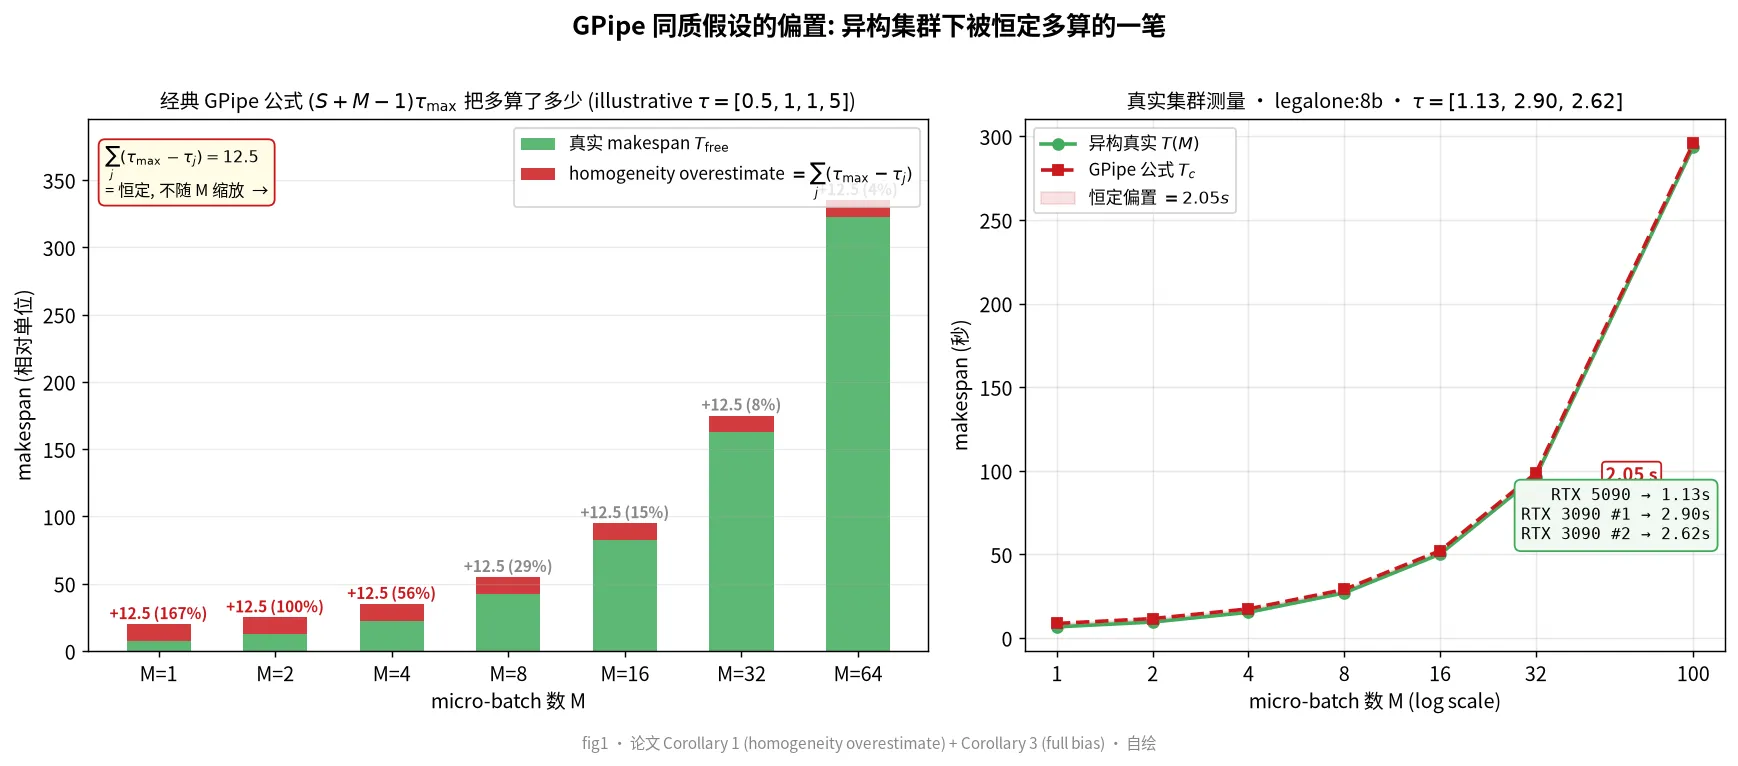
fig1 · 经典 GPipe 公式与真实异构 makespan 的偏置分解(左:illustrative;右:真实集群)
论文 §7.2 把同样的测量搬到生产集群 legalone:8b 上用三块卡(5090 + 双 3090),得到的 τ = (1.13, 2.90, 2.62) 来自 8,571 条请求里同 (model, host) 最小 compute duration 作为下界估计,算出来 bias = 2.05 s。在 M=1 时高估 30.8%,M=100 时降到 0.7%,但绝对 2.05 s 的过配容量恒在。换 qwen2.5:7b 引入一块 Turing 卡 τ_max=30.1 s,这个常数偏置直接膨胀到 119.8 s。
这件事的工程后果:任何按”经典 GPipe 公式 + 安全裕量”做容量规划的推理网关,只要集群是异构的,就一直在按”实际上不需要的 τ_max”付账。这个账是 fill 阶段的一笔开销,跟 batch 大小无关 —— 加大 batch 不会让这笔账消失,只会让相对比例缩小。
4. 一道不等式决定该不该继续调链路(Corollary 4)#
第二个核心贡献是 Theorem 3 派生出的相变条件。Theorem 2 告诉我们:异步下通信永远只是加性常数,优化链路不改变稳态斜率。Theorem 3 告诉我们:阻塞下通信可能进入稳态斜率,但只有当某条 d_s 超过它所在 stage 的 compute slack 时才会。
把这道 d_s > τ_max − τ_s 的不等式画在 d_0 的轴上(Config 8:τ = [0.5, 1, 1, 5],d = [d_0, 0.1, 0.1]):
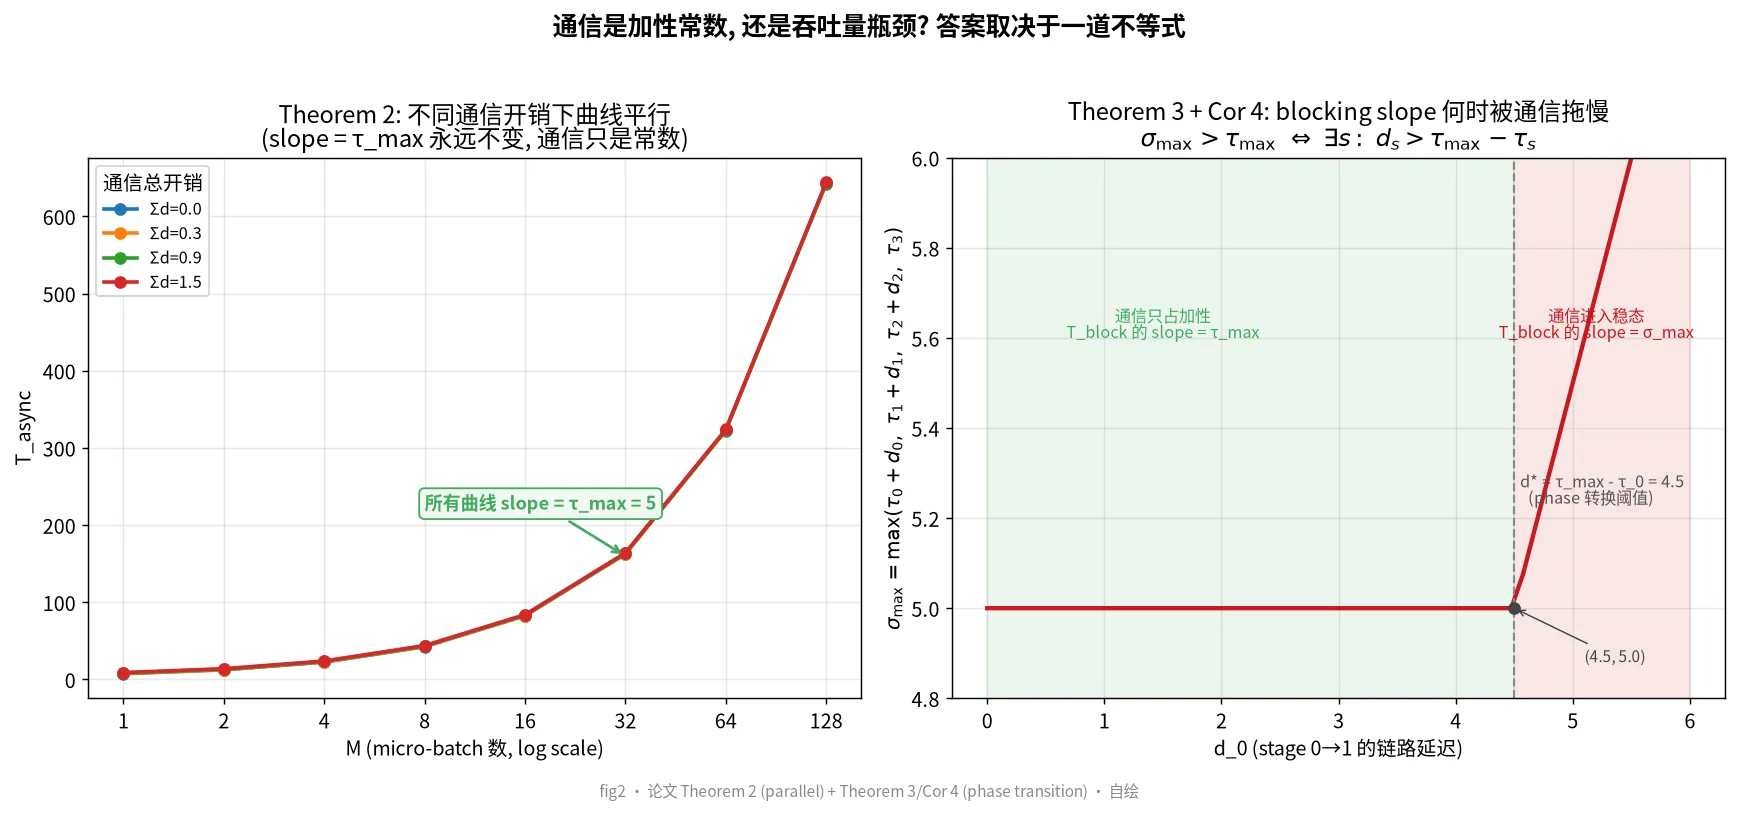
fig2 · 左:Theorem 2 不同通信开销下曲线平行(slope 永远 = τ_max);右:Theorem 3 在 d₀ > 4.5 处出现 σ_max 的相变
右图的横轴是 d₀,纵轴是 σ_max:
- d₀ ∈ [0, 4.5]:σ_max = 5 = τ_max,没出事,通信只占加性常数
- d₀ > 4.5:σ_max = 5 + (d₀ − 4.5) 线性涨,稳态斜率被通信拖慢
这个阈值只跟 τ_max − τ₀ 有关,跟其他 stage 无关。换句话说,在不重新切分 stage 的前提下,你只能优化那一条最慢的链路 —— 优化其他链路的 d 对 σ_max 没影响,只让加性常数 Σd 小一点点。
优化顺序的硬性结论:先做 layer-to-GPU 分区,把 τ_max 拉下来;然后只对 d_s > τ_max − τ_s 的那些 stage 链路做加速;其他链路再怎么调,稳态吞吐都不会变。
5. 真实系统的三明治界(Corollary 5)#
Theorem 2 和 Theorem 3 在工程上最有用的一招是 sandwich:真实系统既不是纯异步也不是纯阻塞,它的 makespan 严格夹在两者之间:
上限和下限之差正好等于 overlap gain 的天花板:
进一步定义一个可测的 overlap 比例:
然后 effective steady-state slope 是:
ρ = 1 拿回纯异步的 τ_max;ρ = 0 落到阻塞的 σ_max。
这个 ρ 可以从日志里量出来:你只要知道分区的 τⱼ 和 dⱼ(profiler 拿到),在两个不同 M 上做两次 makespan 测量,联立就能 pin down ρ 的具体值。得到 ρ 之后:
- 如果 ρ 已经接近 1,继续优化 overlap 没什么赚头 —— 收益被
(1-ρ)(σ_max − τ_max)锁死,转去 rebalance 算 partition - 如果 ρ 还很低,说明 NCCL stream barrier / kernel launch 的同步点开销大,优化通信栈
论文 §9 用这招回头看自己的生产集群,测出来 ρ 已经接近 1(NCCL async over PCIe,单 stage 时间远长于传输),于是结论是”先把重心从链路调优转到 partition 平衡” —— 跟 Proposition 1 的稳态吞吐结论方向一致。
6. Proposition 2:瓶颈在哪儿无所谓,瓶颈多大才重要#
最后一个值得专门讲一下的命题。Theorem 1 / 2 的 closed form 里,瓶颈 stage j 只通过 τ_max 进入,跟它的位置无关*:
τ_max 一样,无论 j* = 0 还是 j* = S−1,Στ 和 Σd 都是相同值。所以重新排序 stage、把瓶颈挪到中段或末尾,不会改变稳态吞吐。这跟阻塞 regime 不一样 —— 阻塞下 σ_max = max(τ_s + d_s) 跟位置有关。
工程含义:你不要去重新排 stage 顺序来”平衡 bubble”,这种优化对稳态吞吐无效。你应该把最慢那台卡上的层拆出来重新分配到更快的卡上,把 τ_max 本身往下降 —— 这才是真正能拉高吞吐的动作。优化阶段排序只是改 first-micro-batch 的 latency,跟吞吐无关。
7. 那个 14 个函数的实现长什么样#
论文配套的 heteropipe 库(Apache-2.0,零依赖)只有 14 个纯函数:
from heteropipe import Pipeline

# §3.1 illustrative 例子
p = Pipeline(tau=[0.5, 1.0, 1.0, 5.0])
p.bias()        # 12.5  — Cor 1, 跟 M 无关的恒定偏置
p.async_(M=8)   # 42.5  — Theorem 2 在 M=8
p.gpipe(M=8)    # 55.0  — 经典公式
p.crossover()   # 2.5   — fill 跟稳态打平的那个 M*

# 真实集群 (legalone:8b)
p2 = Pipeline(tau=[1.13, 2.90, 2.62])
p2.bias()       # 2.05 s, 跟论文 §7.2 严丝合缝

# 通信范式 + phase transition
p3 = Pipeline(tau=[0.5, 1, 1, 5], d=[4.6, 0.1, 0.1])
p3.phase()      # True  — d_0 越过 τ_max - τ_0 = 4.5
p3.async_(M=8)  # 47.3
p3.block(M=8) # 48.0 — 阻塞比异步大 0.7, 即 overlap 收益上限core.py 一共 175 行,每个定理 / 推论 / 命题对应 1 个函数;pipeline.py 73 行把它包成一个 dataclass;tests/test_core.py 132 行用论文自己的数值做点检;CLI 直接 heteropipe --tau 0.5,1,1,5 --M 8 打表或 --json 出 dict。
值得专门说一下的是设计上的”无运行时依赖”:
- 不依赖 numpy / scipy —— 14 个函数全用 stdlib
- CLI 走纯 argparse
- 计算器是 9KB 的单文件 HTML,数学用纯 JS,双击就能在浏览器里算
- 数据集(8,571 条请求,de-identified)是 CSV,Apache-2.0 + CC-BY-4.0 双 license
整套东西的”工程哲学”跟它要表达的”理论干净”是同一种:每一行都只做一件事,没有 decorator,没有 metaclass,没有 plugin。
8. 这件事的边界 —— 论文自己也写明的 5 个开放问题#
Lin’s sandwich proof 严格成立的代价是 §2 那五条假设 (A1–A5),每一条对应一个”打破它就 open”的延伸:
- 带宽限制的通信:多条 micro-batch 共享同一条 link 时,单次传输时间随并发增长,产生一项
(M−1) d_max的项,Theorem 2/3 的常数 d 假设失效。这是高竞争 Ethernet 骨干网的现实场景 - 有界 buffer:ASAP 调度不再最优,backpressure 可能让瓶颈从下游被反向饿死
- prefill–decode 交错:prefill 引入类似 backward 的依赖,两个 phase 的 τⱼ 分布不一样
- backward 依赖(训练):训练里 backward 走一遍,跟 forward 共用 link
- 时间相关 / 状态相关的 τⱼ:thermal throttling / prefix cache 命中率 / 变长输出,都让 τⱼ 不再是常数
每一条都直接改写推理引擎的设计 —— 比如 (3) 的 prefill–decode 异质 τ 分布是 DistServe / Splitwise 这类系统存在的根据;(5) 的变长输出是 vLLM PagedAttention 想要解决的。论文把这些 老实 标为 open,没有装作定理覆盖得了。
9. 复用价值最高的几条#
这一节是写给我自己的笔记 —— 哪些结论将来在别处会用到:
1. 任何 LLM-as-oracle 系统都该有”3 层复现性阶梯”。上一篇讲 SQP-Variance 时,IBM 的论文用的是 operator output / answer / quality 三层复现;这一篇用的是 output / 偏置 / 相变 三层分析。两者方法论同源:先证下界、再证上界,然后 sandwich。这套路在 scheduler、cache、queuing 都能套。
2. GPipe 那条 T = S + M − 1 公式的”大数假设”应该被替换成 (M−1) τ_max + Στ + Σd 三件套。任何分区器、调度器、自动并行系统,如果只 hash prompt 当 cache key (LOTUS 那篇踩过),或者只校准 τ_max 当目标(忽略 Σd),都会复现论文 §3.1 那个 166.7% 的过配。
3. 加性常数 vs 瓶颈的相变条件是写系统时的关键 sanity check。σ_max > τ_max ⇔ ∃s: d_s > τ_max − τ_s 这种形式的不等式,几乎所有”两类资源互相等价的系统”都有对应 —— 内存带宽 vs 计算吞吐、KV cache 命中 vs decode 时延、I/O vs 网络。先写出来这道不等式,就能立刻知道优化预算该往哪边投。
4. overlap ratio ρ 是个可测、可优化的标量。Corollary 5 那条 (M-1)(σ_max − τ_max) 的上限,把”通信–计算 overlap 到底有多少油水”从一个软指标换成一个可计算的硬天花板。这个思路对所有”两类动作部分串行、部分并行”的系统都成立 —— 推理引擎的 prefill-decode overlap、KV cache 的写后即读、数据中心的存算分离都是同一类问题。
5. §7.2 的数据集值得单独去看。8,571 条真实请求,带 host / model / compute duration / end-to-end / 排队等待时间,脱敏但保留了时间序列。它说明了一件事:同一种硬件,τⱼ 在 exclusive 用 vs 排队用之间可以差 7.6× —— 1.13 s vs 8.57 s 都在 RTX 5090 上。这是对 §10(v) “τⱼ 不是常数”那条限制的活生生证据,也直接指出”加排队论 / 随机过程进来”是这个框架最自然的下一个工作。
10. 复现一遍#
git clone https://github.com/ytidb6688/heteropipe
cd heteropipe
pip install -e .        # 零运行时依赖,只有这一句
heteropipe --tau 0.5,1,1,5 --M 8
#  S=4 stages, M=8 micro-batches
#    tau      = [0.5, 1.0, 1.0, 5.0]
#    d        = []
#    tau_max  = 5.000
#    sigma_max= 5.000
#  ------------------------------------------------------------
#    T_free   (Theorem 1) = 42.500
#    T_async  (Theorem 2) = 42.500
#    T_block  (Theorem 3) = 42.500
#    T_gpipe  (classic)   = 55.000
#  ------------------------------------------------------------
#    homogeneity bias (Cor 1)  = 12.500
#    full bias        (Cor 3)  = 12.500
#    phase transition (Cor 4)  = False
#    overlap gap      (Cor 5)  = 0.000
#    effective slope  (rho)    = 5.000
#    throughput async          = 0.200
#    throughput blocking       = 0.200
# crossover batches M* = 2.500加通信看一下 phase transition:
heteropipe --tau 0.5,1,1,5 --d 4.6,0.1,0.1 --M 8
#    phase transition (Cor 4)  = True
#    overlap gap      (Cor 5)  = 0.700
# T_block(8) = 48.0, T_async(8) = 47.3数据文件 data/real_vs_formula.csv 可以直接用 pandas 复现论文 Figure 5:
import pandas as pd
df = pd.read_csv("data/real_vs_formula.csv")
# 论文里 legalone:8b 在 RTX 5090 / 3090-97 / 3090-98 上的 τ 下界
# (1.13, 2.90, 2.62) 来自同 (model, host) 最小 compute duration11. 小结#
Zhu Wenbo 这篇工作的真正贡献,是把”GPipe 公式在异构集群下到底偏多少”这件事,从一行 LLM 推理从业者的直觉(“大概要打折”)换成了可计算、可测量、可优化的精确式:
- Theorem 1/2/3 把三种通信范式下的 makespan 都给了 matching 上下界的 closed form
- Corollary 1 把 GPipe 偏置拆成
Σ(τ_max − τⱼ),跟 M 无关的常数,在 M=1 时可以放大到 166.7% - Corollary 4 给出相变条件
d_s > τ_max − τ_s,决定链路延迟是加性常数还是吞吐量瓶颈 - Corollary 5 把真实系统夹在 async 和 block 之间,差值
(M-1)(σ_max − τ_max)是 overlap 收益的硬天花板
附带的 heteropipe 库用 175 行 + 132 行测试 + 14 个 closed-form 函数把这一套复现了一遍,纯标准库、零依赖、CLI / Python / 浏览器三套接口都能用。配上 8,571 条真实请求的公开数据集,这件事就从”一篇 preprint”变成”一个可以拿来当 partitioner 目标的工具”。
对从业者最有用的一句话:优化顺序是 先降 τ_max → 再处理 d_s > τ_max − τ_s 的那几条链路 → 其他优化全部给 rebalance 算 partition 让位。GPipe 那条 S + M − 1 的 mental model 在异构集群上不再是 upper bound,只是一个填了一笔常数过配费的起点。
参考资料
- [1] Huang Y, Cheng H, Bapna A, et al. GPipe: Efficient training of giant neural networks using pipeline parallelism. NeurIPS 2019.
- [2] Graham R L. Bounds on multiprocessing timing anomalies. SIAM J. Appl. Math. 17(2):416–429, 1969.
- [3] Johnson S M. Optimal two- and three-stage production schedules with setup times included. Naval Research Logistics Quarterly 1(1):61–68, 1954.
- [4] Kelley J E, Walker M R. Critical-path planning and scheduling. IRE-AIEE-ACM Eastern Joint Computer Conference, 1959.
- [5] Topcuoglu H, Hariri S, Wu M-Y. Performance-effective and low-complexity task scheduling for heterogeneous computing. IEEE TPDS 13(3):260–274, 2002.
- [6–32] 论文 §8 列出的 pipeline / serving / heterogeneous / auto-parallelism 系列工作对照